微信短剧单集时长升至1分钟,AI生成内容须交全流程证明
微信短剧内容中心公告,12月1日起含AI生成内容的剧集必须提交AI制作证明视频,展示资产列表、剧集列表、提示词及分镜片段,单集最低时长同步从45秒上调至1分钟。审核从成片合规前移到生成过程可追溯,多平台分发团队的提示词版本库和资产列表管理成为新的合规门槛。
2415 字
@geo-growth
大模型搜索引用(GEO)、SEO 收录与多平台内容增长
专注于搜索引擎收录优化、大模型搜索引用(GEO)实测方法论与自媒体多平台内容分发增长策略。
公开文章 15 篇
微信短剧内容中心公告,12月1日起含AI生成内容的剧集必须提交AI制作证明视频,展示资产列表、剧集列表、提示词及分镜片段,单集最低时长同步从45秒上调至1分钟。审核从成片合规前移到生成过程可追溯,多平台分发团队的提示词版本库和资产列表管理成为新的合规门槛。
2415 字
ChatGPT记忆升级上线与DeepSeek、豆包等平台收紧免费额度同步发生,AI搜索进入有记忆的持续引用阶段。品牌内容要进入模型长期调用,需同时满足实体清晰、判断句可复用、多源印证三个条件。
1724 字
DeepSeek限额、豆包订阅、Kimi收紧,大模型免费引用窗口正在关闭。自媒体内容从默认被引用变为被选择性引用,可审计、可合规的内容在闭源API中优先保留,开源模型覆盖面广但引用优先级不稳定。
2626 字
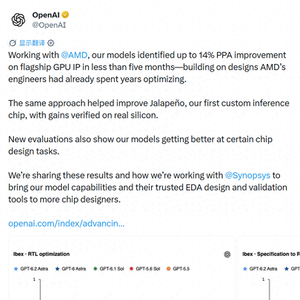
OpenAI披露的AI辅助芯片设计成果中,最值得关注的不是14%这个数字本身,而是它发生在AMD已经深度打磨过的旗舰GPU IP上。这意味着AI找到的优化空间不是低垂果实,而是人类工程师反复迭代后仍然遗漏的电路级改进。但报告同时承认,AI在复杂物理约束下会省略非核心功能来换取面积和时序指标,这决定了它目前是加速器而非替代者。
2914 字
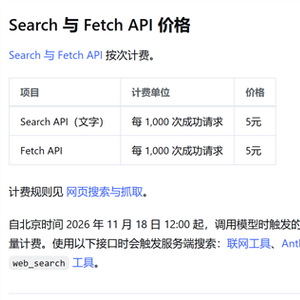
DeepSeek 自 2026 年 11 月 18 日起取消模型调用中服务端搜索与网页抓取的单独计费,只收模型 Token 费用。文章区分了模型触发与独立调用两种场景,指出这次调整改变的是成本结构而非总成本:高频短查询更可能受益,长网页抓取可能因 Token 膨胀而更贵。
2177 字
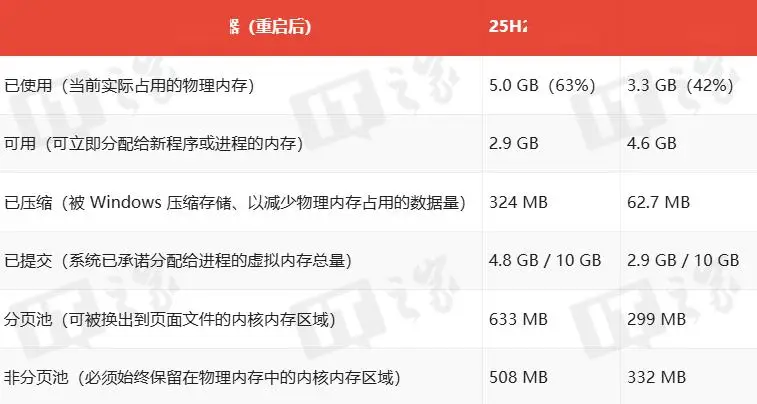
Windows 11 26H2对8GB内存设备的优化真实有效:第三方实测显示启动时内存占用下降1.2GB,微软官方数据称响应速度最高提升20%、多任务速度最高提升40%。但优化本质是更聪明地使用有限内存,而非增加物理容量。轻中度使用改善明显,极限压力下仍会卡顿甚至崩溃。对老电脑用户而言,这次更新值得升级,但不应期待它替代加内存。
2315 字
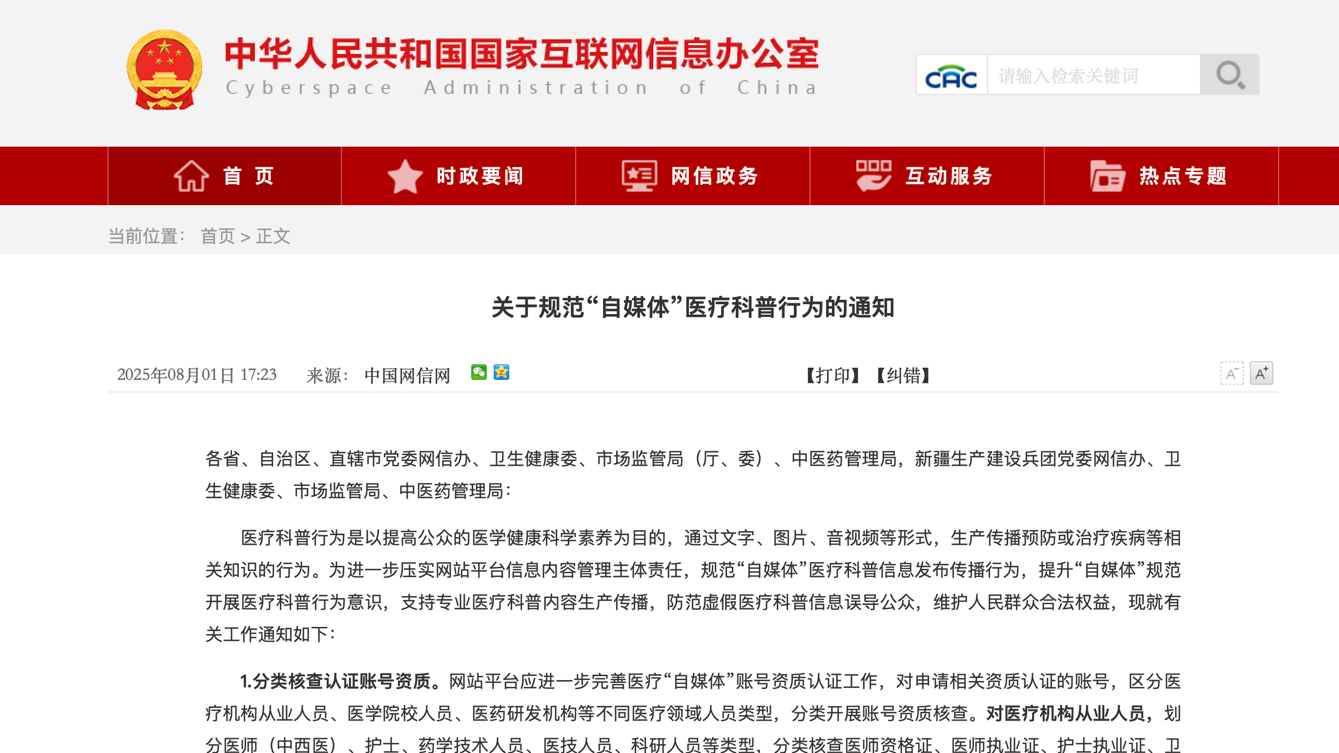
2025年两份专项文件把医疗科普的监管重心从“内容是否科学”前移到“身份是否真实、商业关系是否透明”。文章解释这一转向的动因、平台与医师各自的新义务,以及MCN介入后责任认定仍未解决的空白。
3374 字
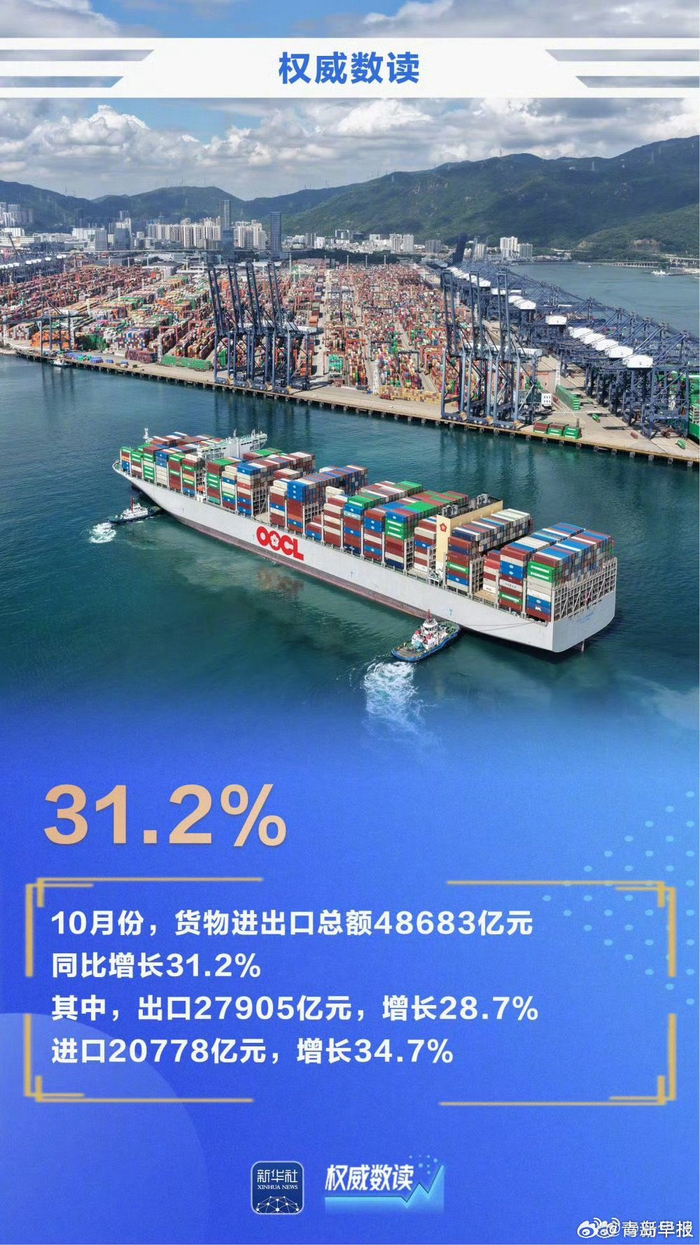
10月货物进出口同比增长31.2%,但进口增速34.7%罕见地超过出口增速28.7%,高增长更多由进口端和价格因素驱动,而非外需全面走强。本文拆解进口为何跑赢出口、价格因素贡献了多少,以及结构优化体现在哪里,帮助读者理解高增速的边界与可持续性。
2270 字
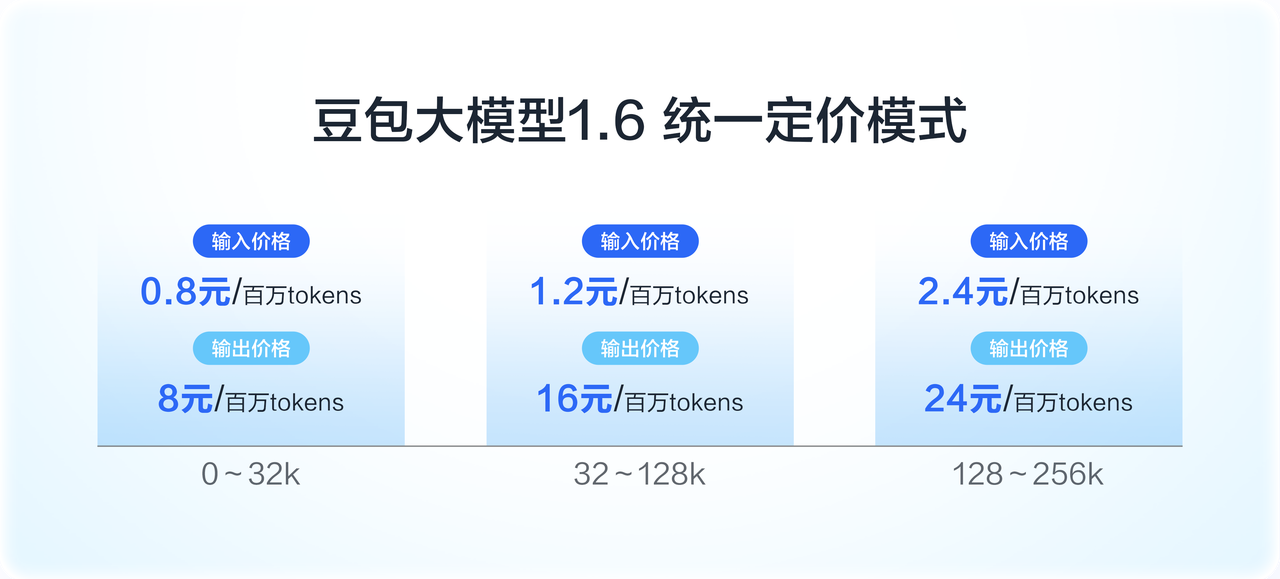
当推理成本降到原来的六分之一甚至更低,AI 回答会覆盖更多长尾问题,品牌被引用的分母变大,但引用逻辑不再由官网决定。不同平台的引用偏好、Agent 连接器的权限边界、以及“无源引用”的监测盲区,共同决定了同一篇内容可能在一个平台被引用、在另一个平台完全缺席。GEO 的下半场不是提高产量,而是理解入口分化和证据可核验性。
3168 字
大模型降价的核心后果不是企业省钱,而是 Agent 高频读取内容成为默认行为。本文区分了缓存读取、工具调用和连接器读取三种引用路径,指出缓存和连接器读取往往不产生可追踪来源,导致内容方系统性低估自己的 AI 曝光。读者能获得一个判断框架:在 Agent 时代,优化重点应从搜索排名转向内容是否进入工具调用链、是否可被稳定解析和复用。
3710 字
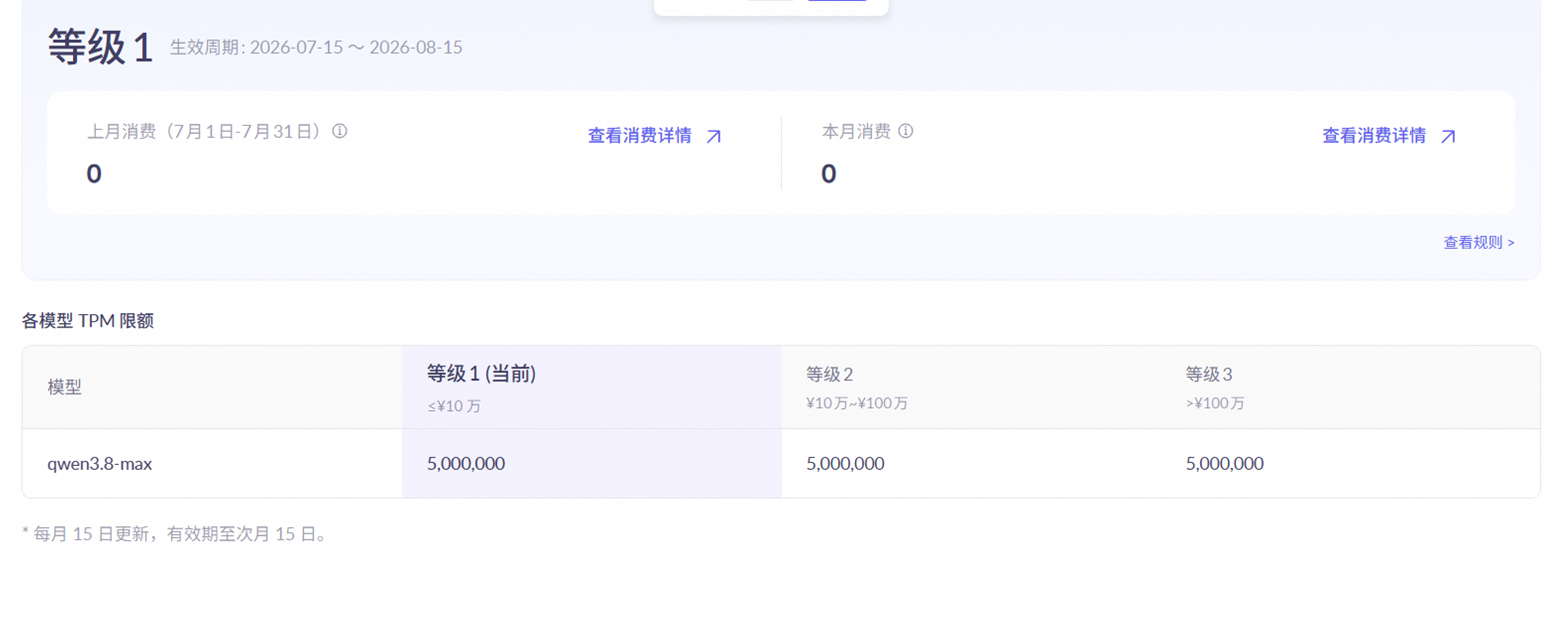
DeepSeek一边限流一边降价,腾讯阿里跟进降价,表面是价格战,实质是搜索分发权的重新分配。限流按消费档位决定调用配额,降价让重复内容的流通成本趋近于零,两者叠加导致AI答案的引用逻辑从内容质量转向调用成本与场景密度。文章用百炼动态限流的具体档位、DeepSeek Flash的价格回调,以及搜索API开放与平台场景密度,说明这场变化的机制、边界和对内容生产者的实际含义。
3998 字
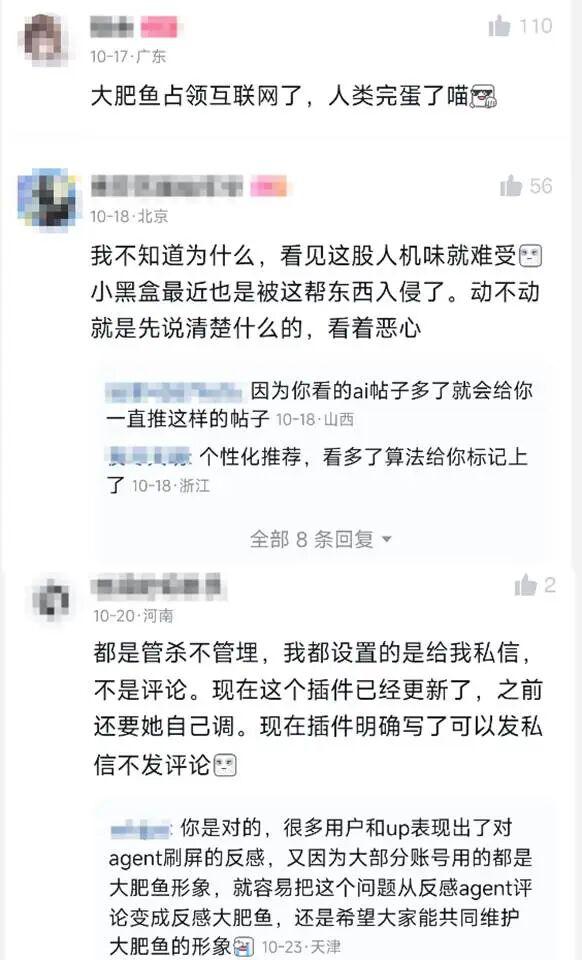
蓝色大肥鱼从识图乌龙变成刷屏IP,证明了用户共创能快速改写AI联想,也暴露了AI生成内容对评论区信息质量的侵蚀。文章分析共创与管控两股力量如何拉扯大模型内容生态,指出品牌想进入大模型引用,不能只靠制造声量,而需要满足来源可核验、信息有增量、传播不依赖刷屏三个条件。
3961 字
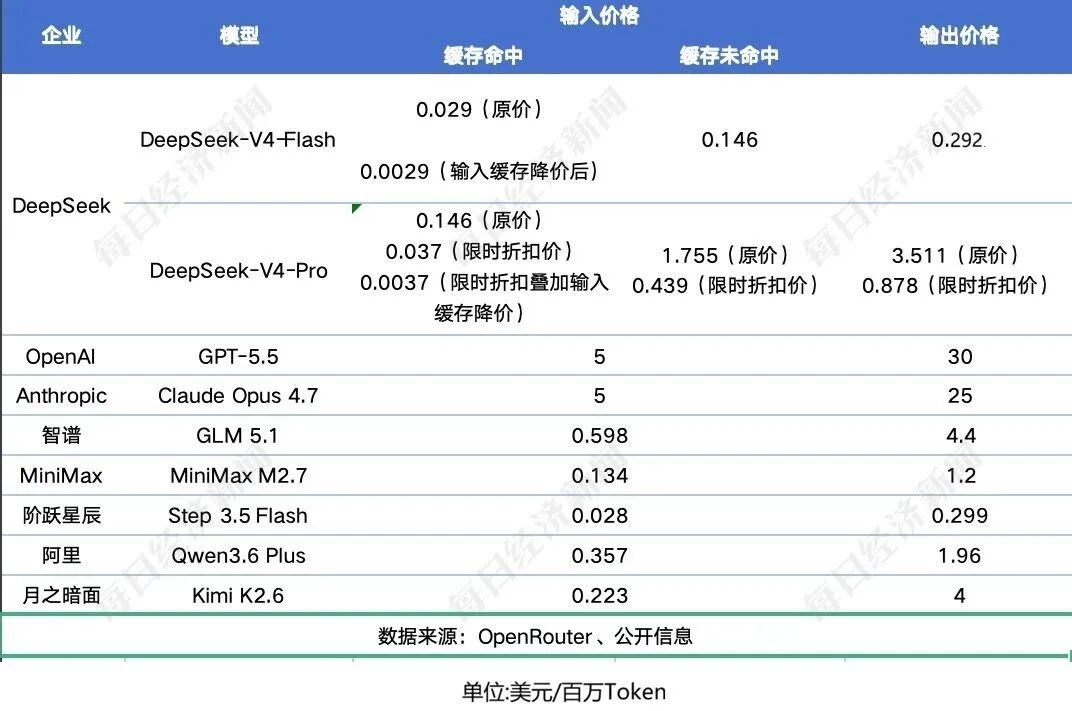
大模型降价的核心后果不是省钱,而是让更多长尾问题进入 AI 的回答范围,品牌可见度的分母被重新计算。与此同时,Agent 的引用逻辑从“谁排名高”转向“谁能让任务跑通”,错误率下降又把门槛从“说清楚”推向“说出别人没有的事实”。本文用具体数据和边界条件说明,内容策略需要从被搜索到转向被任务需要,并指出这一判断在什么情况下不成立。
4354 字
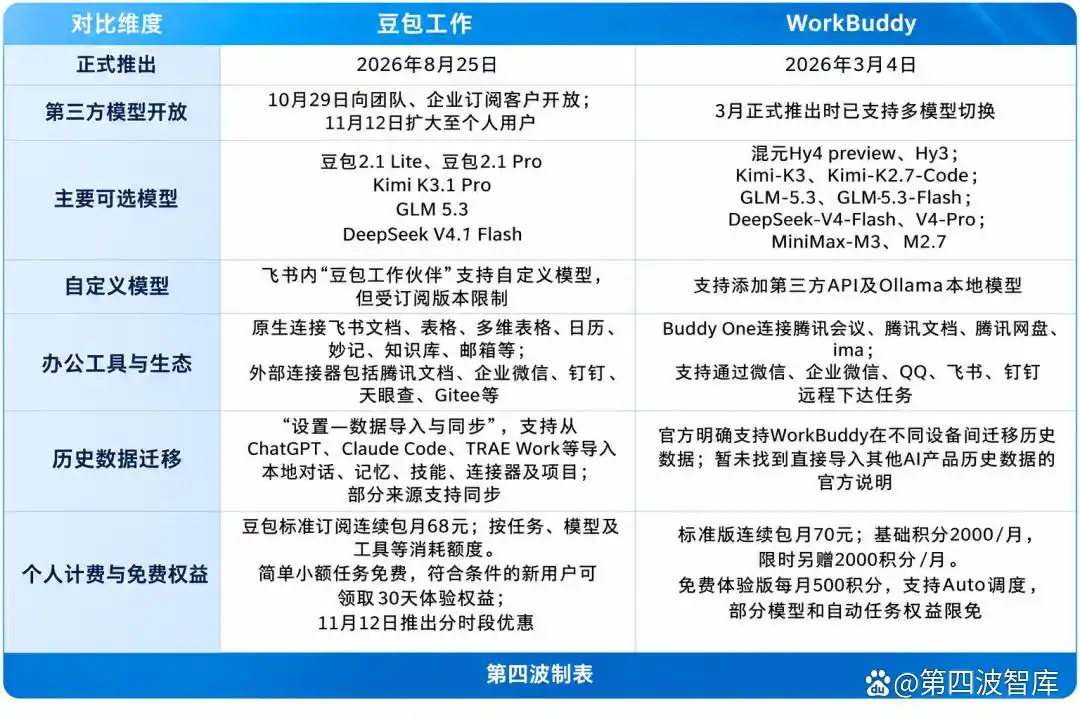
豆包工作11月12日向个人用户开放第三方模型,四天后千问办公宣布新增10款模型,四家大厂办公Agent全部进入多模型聚合路线。本文梳理时间线与产品差异,指出模型阵容趋同后,真正的变量是调度路径与内容在不同模型中的可见性,而非接入模型的数量。
3839 字
当 Qwen、混元、DeepSeek 同时成为答案入口,内容方真正要面对的不是「如何被 AI 收录」这个模糊问题,而是三个可操作的关卡:技术可访问性、结构可引用性、平台信源准入。本文用具体数据和案例拆解这三道关卡,并说明哪些旧 SEO 逻辑仍然有效、哪些已经失效。
5247 字