降价之后,Agent 正在决定谁的内容被读、谁的内容消失
大模型降价的核心后果不是企业省钱,而是 Agent 高频读取内容成为默认行为。本文区分了缓存读取、工具调用和连接器读取三种引用路径,指出缓存和连接器读取往往不产生可追踪来源,导致内容方系统性低估自己的 AI 曝光。读者能获得一个判断框架:在 Agent 时代,优化重点应从搜索排名转向内容是否进入工具调用链、是否可被稳定解析和复用。
降价之后,Agent 正在决定谁的内容被读、谁的内容消失
降价不是让 AI 更便宜,而是让 Agent 更频繁地替你读内容
缓存成本击穿后,Agent 读取内容的频率发生了什么变化
2026 年这一轮降价,幅度最大的不是输出端,而是缓存命中输入。小米 MiMo-V2.5-Pro 的缓存命中输入从 2.80 元/百万 tokens 降到 0.025 元,降幅 99%;DeepSeek V4-Pro 在 5 月 22 日宣布永久降价 75%,缓存命中输入同样落到 0.025 元。华为云 openPangu-2.1-Pro 的缓存命中输入标价 0.016 元/百万 tokens,已经接近忽略不计。
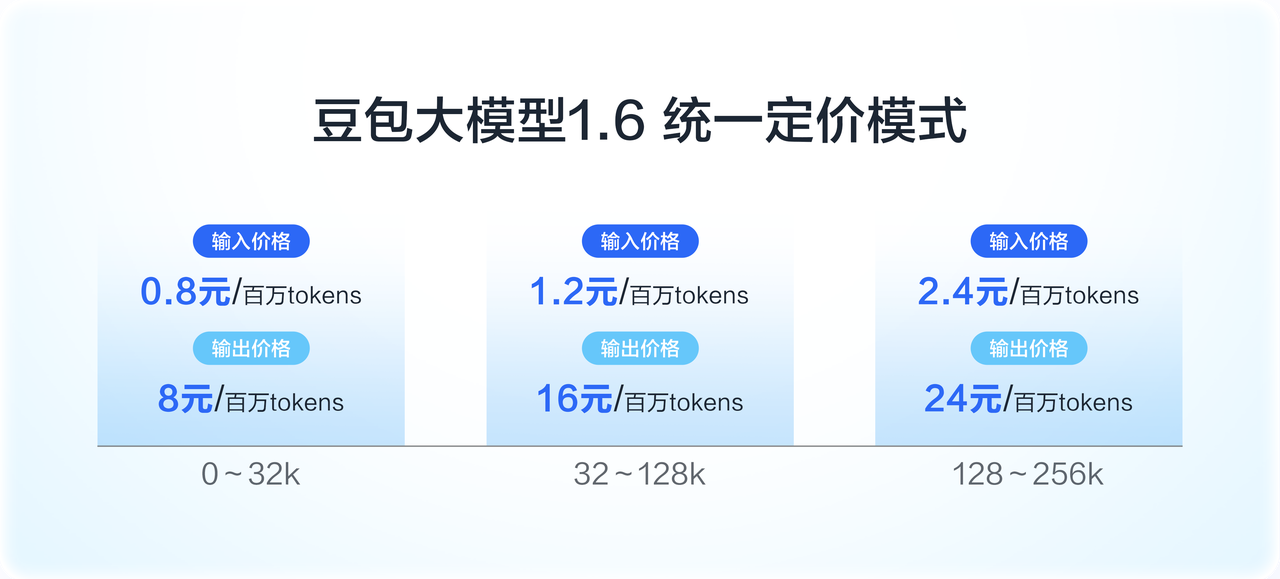
缓存命中之所以是决定性变量,在于 Agent 的工作方式。一个 Agent 编写代码或执行多步任务时,每一轮对话都要把此前全部上下文重新提交给模型。InfoQ 引用的数据显示,在 Agent 编码场景中,缓存读取成本通常占总 token 支出的 96% 至 99%,缓存命中率在 90% 至 100% 之间。这意味着,当缓存读取单价降到原来的四分之一甚至更低,Agent 反复读取同一批内容的边际成本急剧下降。Anthropic 将 Fable 5.1 的缓存读取成本从 1 美元降至 0.25 美元,降幅 75%,对应的总成本降幅约为 70% 至 75%。
对内容分发而言,这个变化的意义不在价格本身。缓存读取的本质,是模型在短时间内反复消费同一批文本——可能是代码库,也可能是网页、文档或 API 返回的结构化数据。单价越低,开发者越没有动力去优化“读几次”“读多少”,反而倾向于让 Agent 多读、反复读、在多个工具之间交叉验证。内容被机器消费的次数由此上升,但消费方式从“人点击链接”变成了“机器读取后转述或调用”。
为什么“便宜”反而可能让账单更贵
单价下降与总成本下降之间没有必然等号。腾讯新闻科技狐的报道给出了两个具体案例:Uber 向 5000 名工程师开放 Claude Code,几个月内几乎烧光全年 AI 预算;米哈游在一次多 Agent 实验中,几十个 Agent 在后台互相调用、互相确认,一个晚上消耗约 200 万元 token,产出价值微乎其微。该报道还引用了一个概括性估计:大部分多 Agent 系统中,30% 到 60% 的 token 消耗在无意义循环里。
这些数字的口径并不统一,米哈游案例的具体模型、任务类型和 200 万元的计算方式都没有公开,30% 到 60% 的估计也缺少研究机构或样本范围。但它们指向同一个机制:当调用强度上升的速度超过单价下降的速度,总消耗反而增加。降价不是让 AI 更便宜,而是让高频调用成为默认策略。
对内容方来说,真正的后果是:Agent 读取内容的次数在增加,但每一次读取都不再对应一个人类访客。一篇被缓存反复读取的文档,可能在多个 Agent 任务中被转述、摘要或作为参数传递,却不会在流量统计中留下任何痕迹。内容分发的战场从“人看不看”转向“机器读不读”,而后者目前还没有可靠的测量工具。
被引用和被忽略,取决于 Agent 在哪一层读取你
缓存读取、工具调用和连接器读取:三种不同的“被引用”
Agent 读取内容的方式并不统一。它有时像传统搜索一样实时抓取网页,有时直接从缓存中调取已经处理过的文本,有时则通过连接器进入企业系统内部读取结构化数据。这三种路径对内容方意味着完全不同的曝光形态。
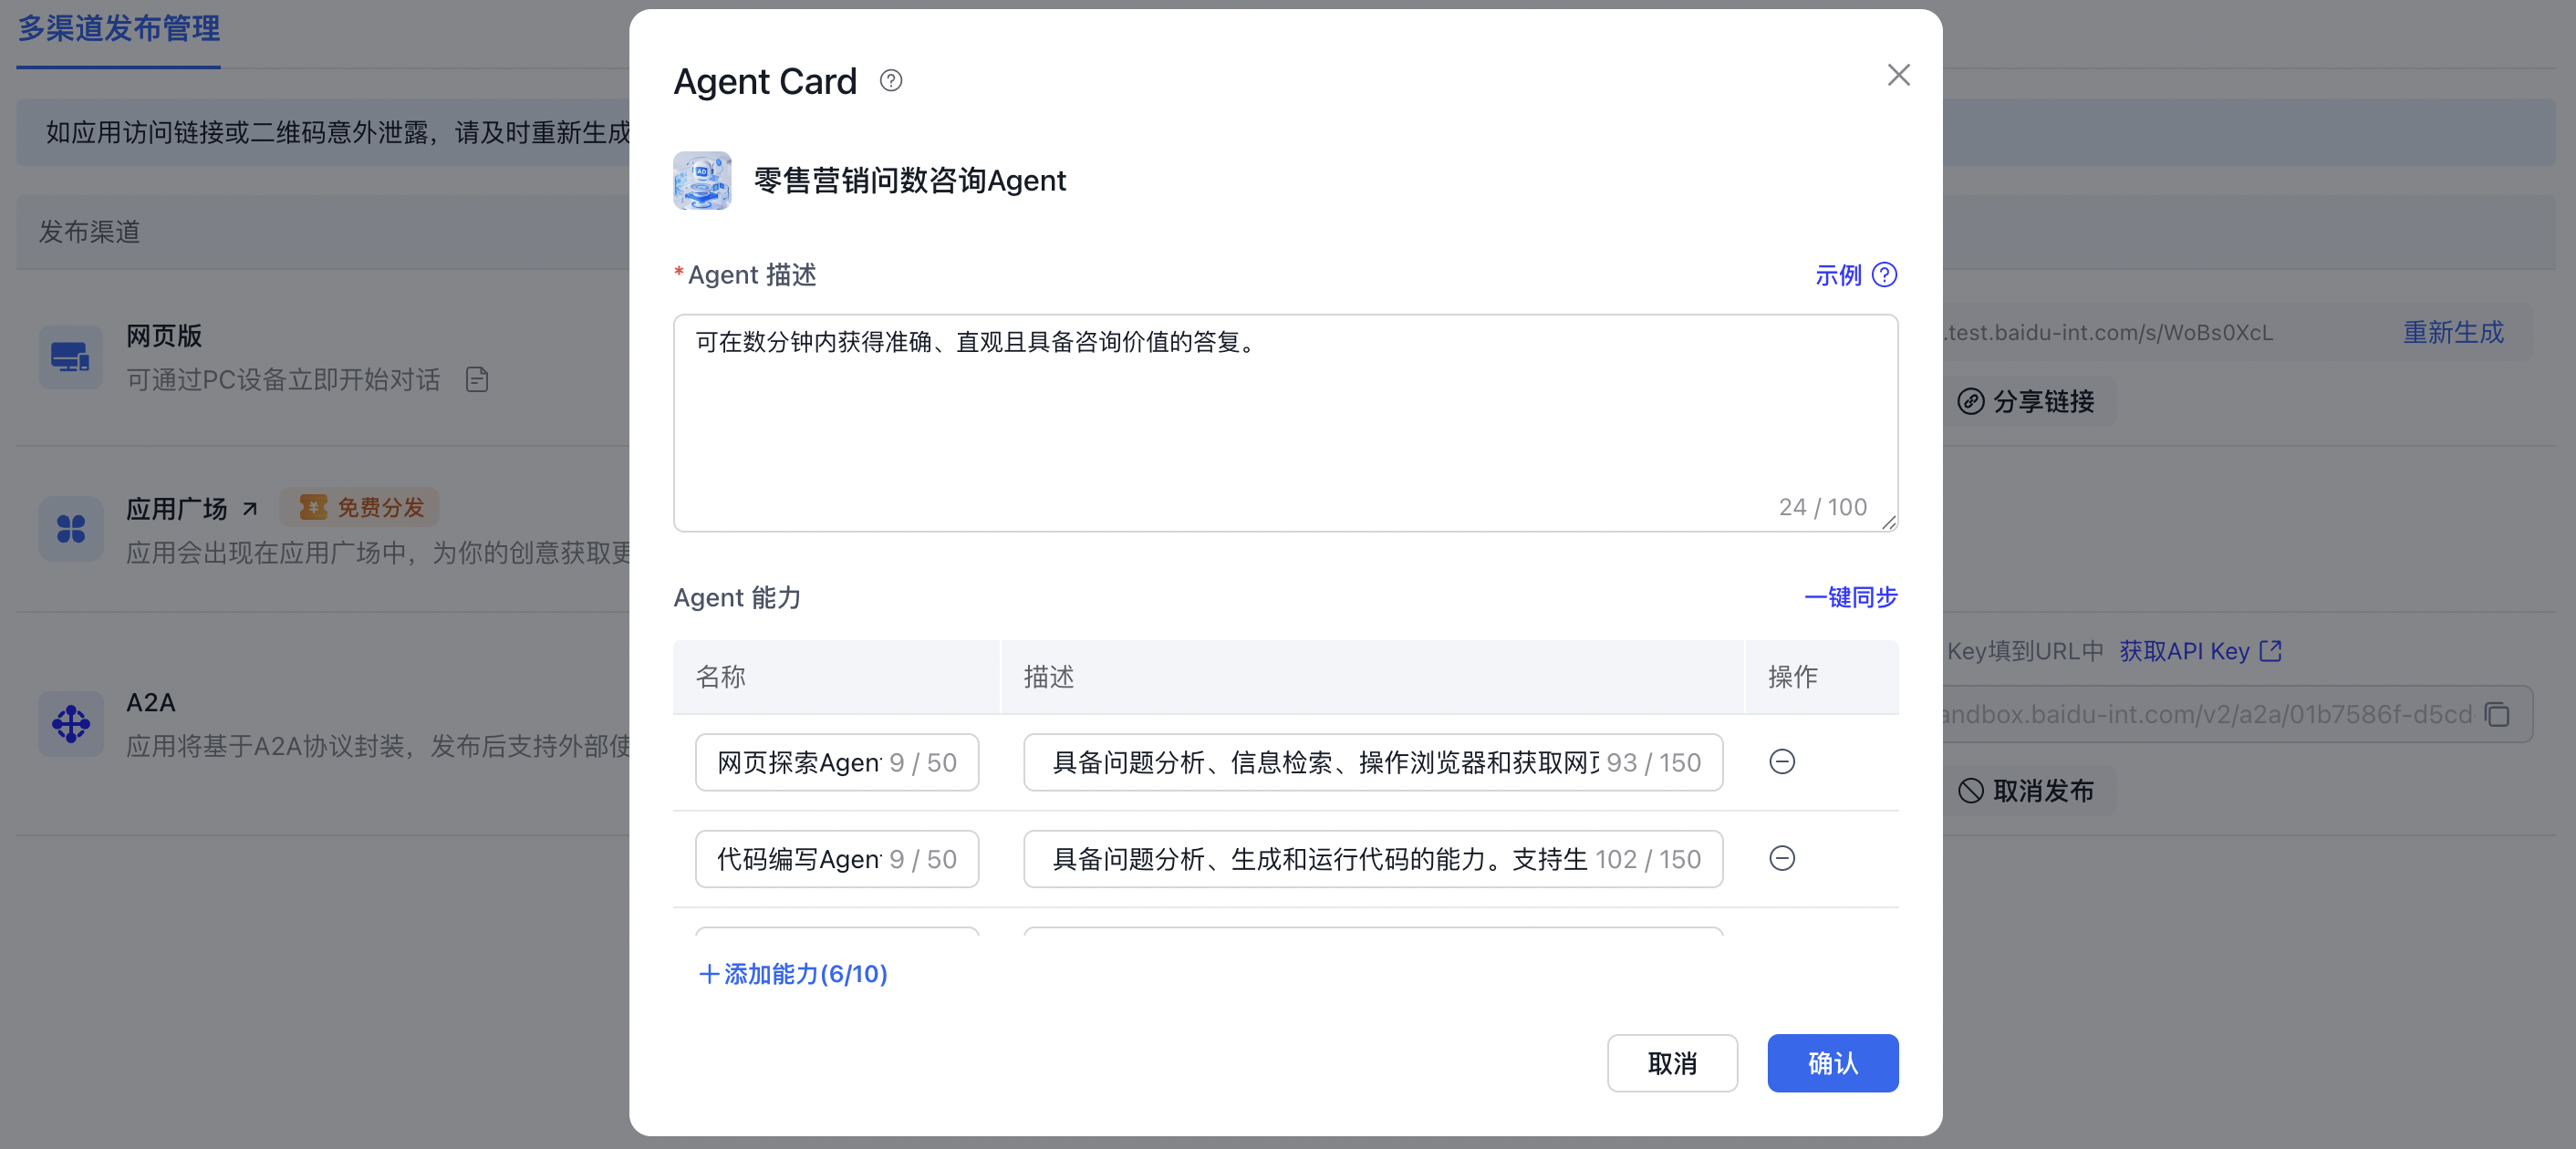
工具调用抓取最接近人们熟悉的搜索逻辑:Agent 在回答过程中触发检索工具,访问外部页面,并在答案中附上来源链接。内容方可以看到引用来源,监测工具也能追踪到这次曝光。但缓存读取完全不同。在 Agent 编写代码或处理长文档时,缓存读取成本通常占总 Token 支出的 96% 至 99%,缓存命中率在 90% 至 100% 之间。这意味着绝大多数读取并不产生新的抓取请求,内容被反复使用,却不会留下新的访问记录。
连接器读取走的是另一条路。Anthropic 的 Claude Duet 已集成 6000 多个应用连接器,能够在用户未下指令时主动推送简报。当 Agent 通过连接器读取企业系统里的订单、库存和价格数据时,给出的答案可能完全准确,却不附带任何可点击的来源。博晓通的行业分析将这类情况称为“无源引用”——品牌被提到了,但监测系统抓不到引用链接。
为什么有些引用无法被传统监测口径统计
传统 GEO 监测建立在“引用必然伴随可追踪来源”的假设上。这个假设在工具调用场景中基本成立,但在缓存读取和连接器读取中失效。缓存命中意味着 Agent 没有重新访问内容源,自然没有新的抓取日志;连接器读取则可能直接跳过公开网页,进入应用内部的数据接口。两者都不产生传统意义上的“来源展示”。
按传统口径,这类情况会被记为“无引用提及”,从而低估实际曝光。E40 的判断指向一个现实问题:内容方可能正在被 Agent 频繁使用,却完全无法从监测报告中看到这一点。不过需要保持谨慎——目前这仍是监测口径层面的推断,而非实证测量结果。E15 和 E16 只说明 Oracle 在升级 Agent 记忆、Prismor 在控制工具调用,并未提供采用率数据。“无源引用”的普遍程度,取决于连接器读取和缓存读取在实际 Agent 任务中占多大比例,而这方面的公开数据仍然稀缺。
内容方能够确认的是:引用结构正在分层,而监测工具只覆盖了其中一层。
GEO 要管的不是“一个搜索框”,而是 Agent 的工具选择偏好
当 Agent 决定调用哪个工具时,你的内容就已经被筛选了
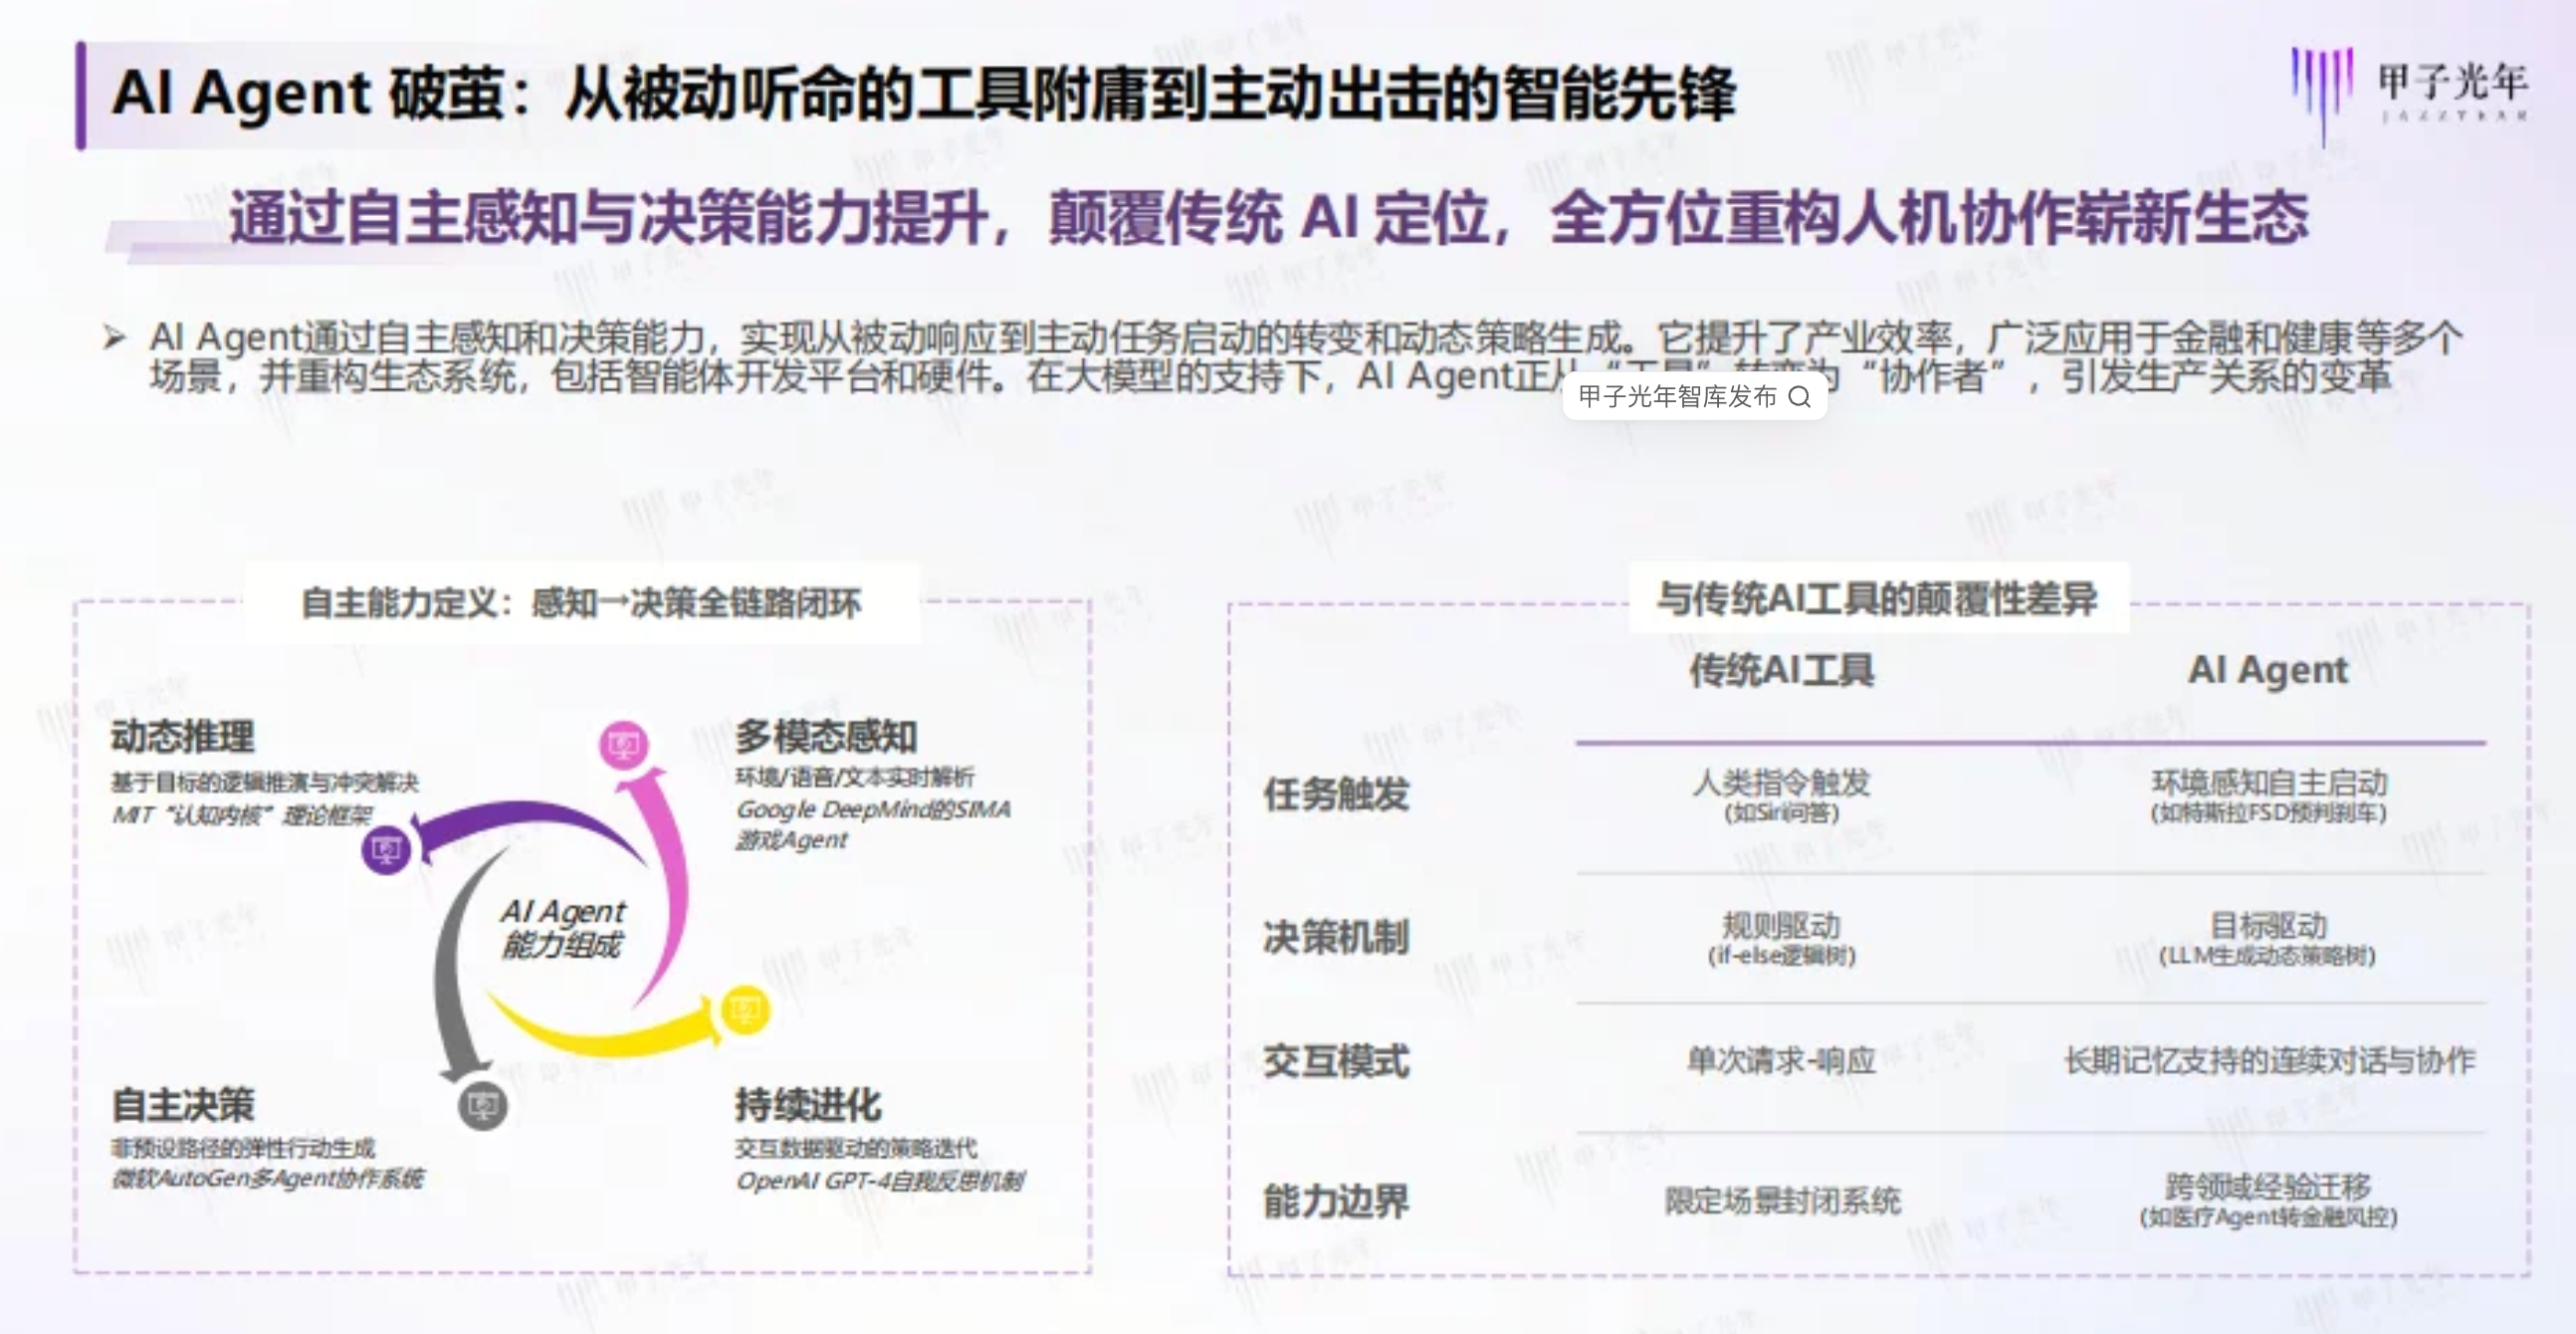
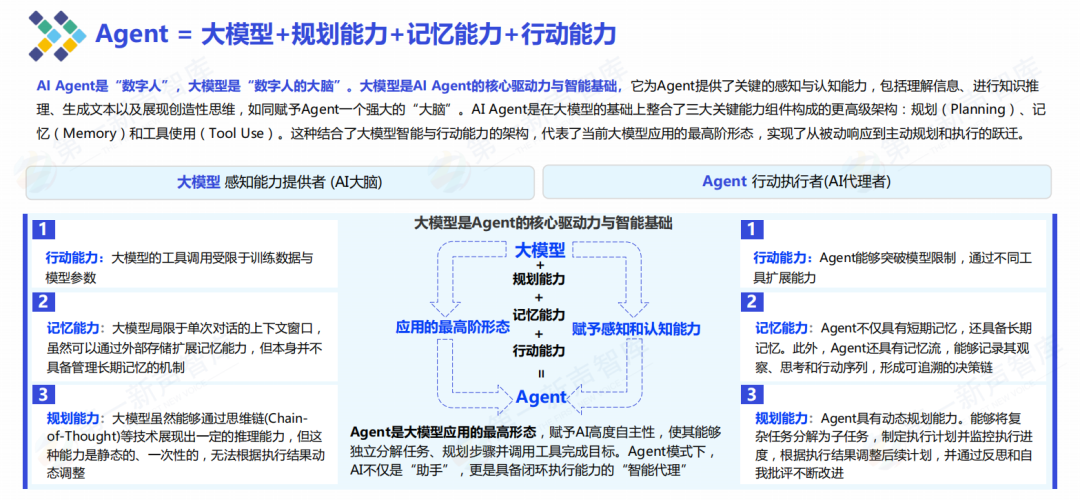
Agent 读取内容之前,先有一个更早的决策点:调用哪个工具。工具是 Agent 接触外部世界的接口——搜索、网页抓取、数据库查询、文件读取,都通过工具完成。工具选择一旦确定,可供读取的内容源范围就基本固定了。一个做深度研究的 Agent 如果优先调用学术数据库工具,品牌官网的文章写得再好,也不会进入它的读取队列。
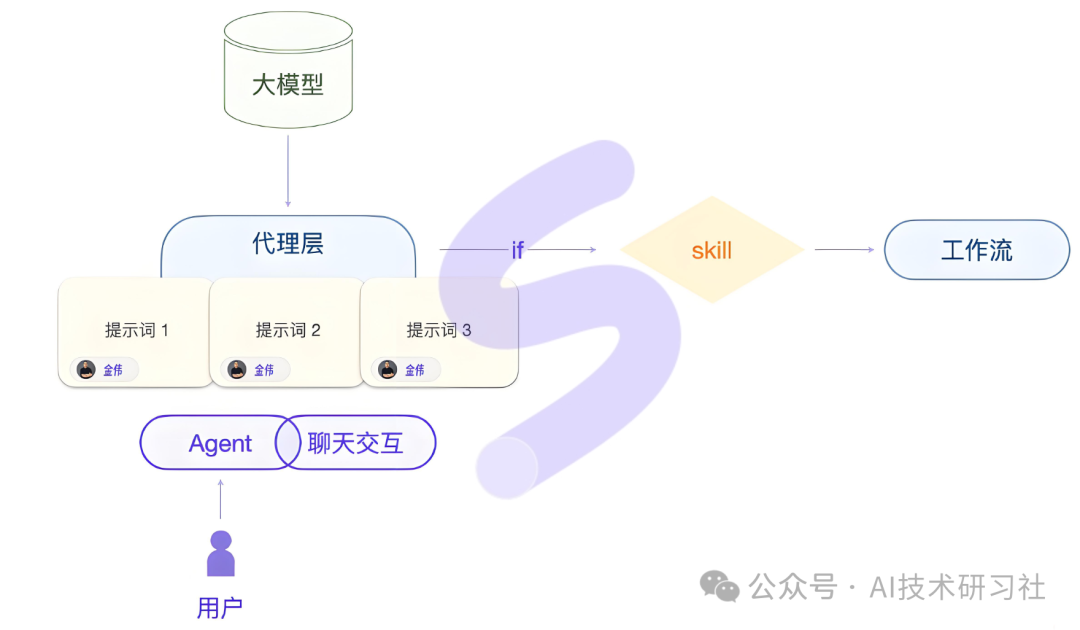
这个环节的筛选强度,超过传统搜索框的排名机制。搜索框至少会把结果列出来,用户还有滚动和点击的机会;Agent 的工具选择是二元的——调用了就是调用了,没调用就是彻底不在场。内容方在搜索结果页里争的是位置,在 Agent 工具选择里争的是“是否被访问”这个前提。
Skills 触发与工具选择:新的排名因素
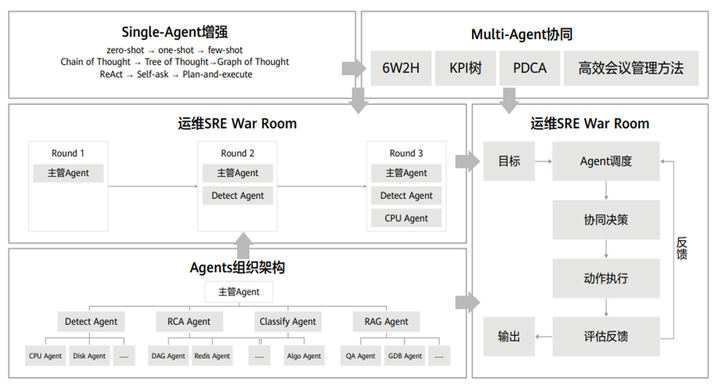
openPangu-2.1-Pro 的更新方向提供了一个具体样本。华为云披露,该模型在 Agent 能力上基于 10 万余条专项数据优化 Skills 触发、工具选择与调用能力,覆盖深度研究、鸿蒙系统操控等场景。这意味着工具选择本身正在成为模型训练和优化的目标变量:模型被训练成更擅长判断“什么任务该调用什么工具”,而不是简单地把所有可用工具都试一遍。
对内容方而言,这构成一种新的排名机制。传统 SEO 优化的是页面与关键词的相关性,GEO 在工具选择层面要优化的,是内容所在数据源与 Agent 任务类型的匹配度。一个被模型判定为“适合深度研究任务调用”的数据源,会在同类任务中被反复优先调用;反之,即使内容质量不差,也可能因为数据源与任务类型的匹配信号弱而被跳过。
这种匹配偏好并非完全由模型能力决定。基础设施层同样存在控制点。开源项目 Prismor 的设计思路是把控制放在 Agent 真正执行工具调用之前,对 Shell、文件、包管理与外部 API 动作给出允许、警告或阻断判定。也就是说,即使模型选择了某个工具,基础设施层仍可以拦截这次调用。内容方需要同时面对两个变量:被 Agent 选中的概率,以及被调用路径上各层放行的概率。
需要谨慎的是,openPangu 的 10 万条专项数据由华为云披露,未说明数据构成和评测方法;Prismor 目前也只是设计思路,没有采用率数据。因此“工具选择偏好可被系统性优化”仍是一个方向性判断,而非已被验证的结论。但这两个案例至少说明,工具选择环节正在被模型方和基础设施方同时纳入优化视野,而这个环节恰好决定了哪些内容源会被 Agent 实际访问。
内容方的实际选择:优化可被读取的结构,而不是追逐不可见的排名
哪些内容特征能提高被 Agent 稳定读取的概率
内容方无法直接观测每一次工具调用,但可以从三个特征判断自己的内容是否更可能进入 Agent 的读取链。
第一,结构化程度。Agent 读取内容后要完成摘要、提取或参数传递,能够被稳定解析的结构——清晰的标题层级、可识别的字段、标准化的元数据——比视觉排版更直接地影响读取成功率。这不是说排版无关紧要,而是当内容同时面向人类读者和机器解析时,后者的优先级需要被提前。一个可被脚本或工具稳定抓取的页面,比一个依赖复杂交互才能呈现完整信息的页面,在 Agent 调用链中更不容易中断。
第二,缓存友好性。缓存读取在 Agent 编写代码场景中占总 Token 支出的 96% 至 99%,命中率通常在 90% 至 100% 之间。这意味着 Agent 倾向于复用已经加载过的内容,而不是每次都重新获取。对内容方而言,版本更新频率和内容地址的稳定性就变得关键:频繁改动同一 URL 下的内容,或让同一主题分散在多个地址,都会降低缓存命中率,进而降低被稳定复用的概率。内容更新需要从“随时改”转向“有节奏地改”,并明确哪些部分允许变动、哪些部分需要保持稳定。
第三,可追踪性。当 Agent 通过连接器读取企业系统数据时,答案可能准确却不标注任何可点击来源,这类“无源引用”按传统口径会被记为“无引用提及”,低估实际曝光。内容方如果只盯着引用链接数量,会系统性地漏掉这部分读取。监测指标需要从“被引用次数”扩展到“被工具调用次数”,即便后者目前缺乏成熟的测量工具,至少要在内部评估中承认这个盲区的存在。
需要说明的是,这三条建议中的前两条——结构化提高读取概率、缓存友好性提高复用概率——是基于机制推断,而非直接实证。现有证据只说明缓存的经济逻辑和监测口径的缺陷,没有测量“结构化内容被 Agent 读取概率更高”的数据。因此它们更适合作为资源配置的优先级判断,而不是已被验证的优化方案。
FAQ:关于 Agent 引用,你最该知道的几件事
问:是不是只要把内容做成结构化数据,就能被 Agent 稳定引用?
不一定。结构化只是降低了解析失败的概率,Agent 是否选择某个内容源,还取决于工具选择偏好、任务上下文和基础设施层的放行策略。结构化是必要条件之一,不是充分条件。
问:缓存命中率高,是不是意味着内容越少更新越好?
不是。缓存友好性要求的是内容地址和核心结构的稳定,而不是内容本身的静止。需要区分“可缓存的结构”和“需要更新的信息”:前者保持稳定,后者按明确节奏更新,才能兼顾复用和时效。
问:如果 Agent 引用没有可点击链接,品牌曝光是不是就无法被监测?
目前没有成熟的通用工具能完整追踪无源引用。可行的做法是:在内部评估中把“被工具调用次数”作为补充指标,同时通过 API 日志、连接器权限记录等间接信号估算读取规模。这个盲区短期内不会消失,但不代表完全不可管理。
问:传统 SEO 排名还有意义吗?
有意义,但权重在下降。传统排名影响的是人类用户在搜索结果中的点击行为,而 Agent 读取链中的工具调用和缓存复用不完全依赖这个排名。内容方的资源分配需要同时覆盖两个层面,而不是用 Agent 优化完全替代 SEO。
问:现在应该立刻把监测预算从引用链接转向工具调用吗?
不应该。工具调用监测目前缺乏标准化工具和可比数据,贸然切换会造成新的测量盲区。更稳妥的做法是保留现有引用监测,同时试点跟踪 API 调用日志和连接器读取记录,逐步建立自己的基准线。