大模型搜索不是新搜索引擎,而是一套新的收录规则
当 Qwen、混元、DeepSeek 同时成为答案入口,内容方真正要面对的不是「如何被 AI 收录」这个模糊问题,而是三个可操作的关卡:技术可访问性、结构可引用性、平台信源准入。本文用具体数据和案例拆解这三道关卡,并说明哪些旧 SEO 逻辑仍然有效、哪些已经失效。
大模型搜索不是新搜索引擎,而是一套新的收录规则
先回答:你的内容能不能被大模型「看到」,取决于三道关卡
第一道关卡:爬虫是否被允许进入
内容能否被大模型引用,起点不在内容质量,而在一个更早的技术决定:爬虫是否被放行。如果 robots.txt 明确阻止了某个 AI 爬虫,该模型对网站内容的访问就是零,后续的解析、索引、引用都不会发生。被阻止的爬虫产生零引用,这是当前 AI 搜索可见性中最容易确认的失败点。
AI 爬虫的行为与传统搜索引擎爬虫并不完全一致。许多 AI 爬虫不执行 JavaScript,只在脚本运行后才出现的内容对它们不可见。这意味着依赖客户端渲染的页面,在模型眼中可能是一张空壳。服务端渲染因此从性能优化手段变成了可访问性的前提。
第二道关卡:内容是否以段落为单位可检索
通过爬虫之后,内容面临的是完全不同于传统索引的存储方式。AI 搜索把传统搜索的“排名”阶段替换为“生成”,系统不再返回链接列表,而是合成答案。支撑这种合成的是段落级检索:内容被切分、存储、按语义匹配,而不是以整页为单位参与排序。
这解释了为什么结构清晰的文章更容易被引用。带有明确小节、FAQ 块和语义标题的页面,能产生更多可被单独提取的段落候选;而大段无区隔的正文,即使信息完整,也容易在检索阶段落空。腾讯元宝搜索的入库流程印证了这一点:内容入库前由大模型解析网页并保留标题、表格等结构,再从站点、账号、页面三个层面评估质量。
第三道关卡:平台是否把你的信源纳入索引
前两关都通过,仍不保证内容会被引用。最后一个变量是平台自身的信源准入。元宝搜索的案例显示,平台在入库前会从站点、账号、页面三个层面筛选,优先选择权威来源并过滤低质内容。这意味着“可访问”和“可检索”只是必要条件,平台是否认为某个信源值得纳入索引,决定了内容能否进入最终的生成候选池。
不同平台的关卡权重并不相同。文心一言对百度收录的依赖远高于对段落结构的依赖,因为其信源体系与百度搜索深度绑定;ChatGPT 对 Bing 索引的依赖则让爬虫策略成为优先级更高的一环。因此,判断自己的内容卡在哪一步,需要先明确目标模型依赖哪套索引,而不是套用同一套优化清单。
三道关卡中,第一道最容易被忽视,因为它发生在内容被读取之前。
爬虫准入:robots.txt 是 AI 搜索的第一道闸门
为什么被 robots.txt 阻止的爬虫不会产生任何引用
robots.txt 是 AI 搜索可见性的第一道硬性闸门。它的作用机制与搜索引擎时代并无本质区别:爬虫到达站点后首先读取该文件,若发现自己的用户代理被列入禁止名单,就会直接离开,不抓取任何页面。对传统搜索而言,这种阻止意味着网页不会出现在搜索结果中;对 AI 搜索而言,后果更彻底——模型无法从你的内容中提取任何片段,也就不可能产生引用。
Aeolens 对 AI 搜索工作流的分析给出了一个明确的判断:如果 robots.txt 阻止了某个 AI 爬虫,该模型对网站内容的访问为零,被阻止的爬虫不会产生任何引用。这里的因果链是直接的:阻止发生在抓取之前,而抓取是后续索引、检索和生成的前提。没有抓取,就没有内容进入候选池,后续环节全部失效。
这一判断的重要性在于,它把“收录”问题从算法层面拉回到了配置层面。很多站点在传统搜索时代对 Googlebot 保持开放,却对新兴 AI 爬虫缺乏感知,或者沿用旧有的 robots.txt 规则,无意中把 GPTBot、ClaudeBot、Bytespider 等一并拦在门外。内容本身的质量此时无关紧要——它根本没有进入系统。
JavaScript 渲染:AI 爬虫的盲区
即使 robots.txt 放行了爬虫,还存在第二层技术门槛:爬虫能否读取页面上的实际内容。许多 AI 爬虫不执行 JavaScript,这意味着那些依赖客户端渲染的页面——例如通过 React、Vue 等框架在浏览器中动态生成正文的站点——对爬虫而言可能只是一个空壳。爬虫看到的 HTML 里没有正文文本,只有加载脚本的容器。
Aeolens 的分析明确指出这一点:仅在 JavaScript 运行后才出现的内容对许多 AI 爬虫不可见,服务端渲染因此成为 AI 搜索可见性的关键条件。这里的机制与传统搜索时代的“动态渲染问题”相似,但后果被放大。传统搜索引擎至少会尝试执行 JavaScript 或提供渲染队列,而许多 AI 爬虫出于成本和效率考虑,选择了更轻量的抓取方式。
需要诚实处理的反例是:并非所有 AI 爬虫都不执行 JavaScript。部分平台的爬虫具备渲染能力,具体行为因模型而异。但“许多不执行”这一事实本身已经构成了默认劣势。对于依赖客户端渲染的站点,除非确认目标平台爬虫确实能够渲染,否则内容在 AI 搜索中处于事实上的不可见状态。
| 技术条件 | 对 AI 搜索可见性的影响 | 性质 |
|---|---|---|
| robots.txt 阻止 AI 爬虫 | 零访问,零引用可能 | 硬性排除 |
| robots.txt 放行但依赖 JavaScript 渲染 | 爬虫可能只看到空壳页面 | 软性排除 |
| robots.txt 放行且服务端渲染 | 内容可被抓取,进入后续检索环节 | 技术准入通过 |
两道门槛的叠加效应在于:它们都发生在内容被“阅读”之前。robots.txt 决定了爬虫是否进门,渲染方式决定了爬虫进门后能否看到东西。任何一个环节失效,后续的段落化检索和信源准入都无从谈起。
段落级检索:AI 搜索不收录「页面」,只收录「可引用的片段」
为什么结构清晰的页面能产生更多可检索段落
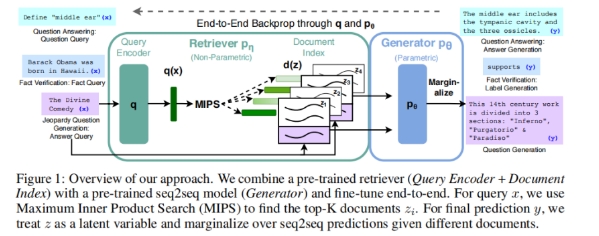
AI 搜索对内容的理解单位不是页面,而是段落。抓取完成后,系统会把页面拆解成若干候选片段,分别存储并建立索引。查询到来时,算法按语义相关性调取最匹配的片段,再由模型将这些片段合成为答案。用户看到的引用,指向的是某个具体段落,而不是整篇文章。这意味着,一篇内容能否被 AI 搜索引用,取决于它能否在拆解后留下足够多独立、清晰、语义完整的片段。
传统 SEO 的整页优化思路在这里部分失效。过去,一个页面可以通过标题、关键词密度、外链和整体权重获得排名,哪怕正文中存在大量铺垫和冗余,也不妨碍页面进入搜索结果前列。但在段落级检索中,冗长的背景介绍、连续多段的观点铺垫、缺少明确边界的论述,都会在拆解后变成语义模糊的碎片。这些碎片单独看时无法回答任何具体问题,自然难以被检索系统选中。
结构清晰的页面则相反。每个小节围绕一个独立信息点展开,段落的语义边界明确,拆解后仍能保持自足性。这样的页面会产生更多高质量的段落候选,在查询匹配时拥有更高的命中概率。来源资料对此有直接描述:内容以段落级别而非页面级别被存储和检索,结构良好、包含 FAQ 块和语义标题的页面,能比整页无差别散文产生更多可检索的段落候选。
FAQ 块和语义标题的实际作用
FAQ 块是段落级检索中最典型的友好结构。每个问答天然构成一个自足单元:问题本身提供了查询匹配的语义锚点,答案则直接对应一个可引用的段落。当用户的提问与 FAQ 中的问题在语义上接近时,这个问答块被调取的概率显著高于一段连续论述中的某句话。语义标题的作用类似。标题为后续段落划定了语义范围,使系统在拆解时更容易识别段落的主题边界,而不是将整页视为一个无差别的文本流。
这一机制也解释了为什么某些页面整体权重不高,却仍能在 AI 回答中被引用。只要页面中某个段落恰好完整回答了一个具体问题,且结构上允许系统将其作为独立片段提取,它就有机会进入候选池。段落级检索削弱了页面整体权重对引用结果的决定性作用,转而奖励那些在片段层面就能提供完整信息的内容。
需要注意的是,这一描述来自对 AI 搜索流程的一般性技术说明,不同平台在拆解粒度、索引方式和片段排序上存在差异。但段落级检索作为整体趋势,已经足以改变内容组织的优先级:与其追求整页的权威性和覆盖广度,不如先保证每个小节都能独立成立。
平台信源准入:你的内容在不在它的「可信名单」里
元宝搜索的 157 个权威信源说明了什么
腾讯元宝搜索在 2026 年 10 月通过腾讯云对外开放时,公布了一个具体数字:157 个权威信源,覆盖金融、医疗、法律、出行等 13 个垂直行业,包括申万宏源、携程、飞常准、腾讯医典、腾讯地图等。这个数字之所以值得单独拿出来看,是因为它把「信源准入」从模糊的技术讨论变成了一个可以核对的名单。
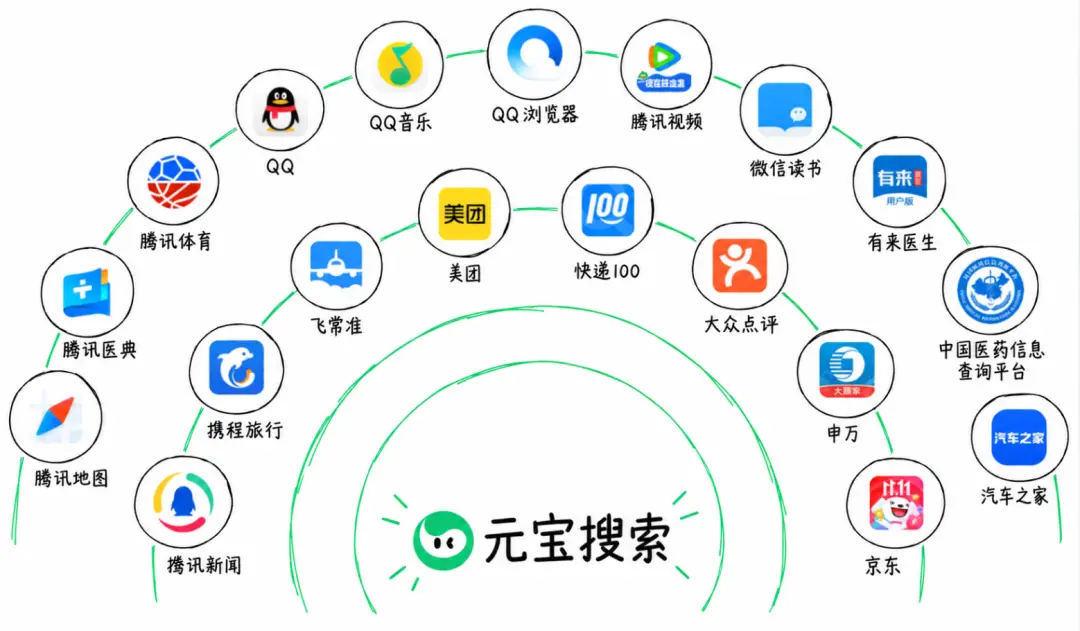
元宝搜索的官方说明描述了它的筛选流程:内容入库前,大模型会解析网页并保留标题、表格等结构,然后从站点、账号、页面三个层面评估质量,优先选择权威来源,过滤低质内容。这意味着筛选发生在检索之前。一个页面即使被爬虫抓取、段落结构清晰,如果站点本身不在评估体系的优先范围内,它进入候选池的概率会显著降低。157 个信源是官方宣传口径,未经第三方独立验证,但它至少表明:平台在索引阶段就预设了信任边界,而不是在回答生成时才对所有内容一视同仁。
对内容生产者来说,这个机制的约束是硬的。你可以优化页面结构,可以调整 robots.txt,可以改善段落化检索的适配度,但如果你的站点不在平台预设的权威来源范围内,这些努力都发生在候选池之外。信源准入不是技术可访问性的问题,而是平台对内容来源的预先排序。
文心一言与豆包的生态绑定
不同平台对信源准入的执行方式并不相同。元宝搜索通过一份相对明确的权威信源列表来体现偏好,文心一言和豆包则更依赖各自的生态体系。
文心一言深度绑定百度搜索,百度收录是内容进入其回答候选池的基本门槛。百家号等百度系内容在权重上仍然占据优势。这意味着在文心一言的语境下,信源准入的第一道筛选实际上是百度搜索的收录逻辑:你的内容是否被百度索引、是否在百度生态内有存在感,比页面本身的结构优化更直接地决定了被引用的可能。
豆包的情况类似,但生态边界不同。豆包依赖字节系的内容沉淀,今日头条和抖音上的内容被豆包引用的概率会明显增加。一个独立站点即使技术完全开放、内容质量不低,如果缺乏字节系生态内的分发记录,它在豆包的候选池中可能处于边缘位置。
这种生态绑定揭示了一个更普遍的事实:国内主流大模型搜索产品的信源准入,很大程度上不是开放互联网的公平竞争,而是各自平台既有内容生态的延伸。元宝搜索虽然以「搜索引擎」的名义对外开放,但其 157 个权威信源中包含了腾讯医典、腾讯地图等自有资产,说明它同样在整合腾讯内容生态。
需要避免的误解是:信源准入不等于内容必然被引用。进入 157 个信源名单,或者被百度收录、在头条有沉淀,只是获得了进入候选池的资格。最终是否被引用,还取决于具体问题的匹配度、段落能否被独立提取、以及多源交叉验证的结果。但对于不在名单内的内容,这个资格本身就已经被剥夺了。
所以,旧 SEO 逻辑哪些还活着,哪些已经死了
关键词排名正在失效,但「被收录」仍然是前提
旧 SEO 的核心是排名:给定一个查询词,内容在搜索结果页上排第几,直接决定流量分配。大模型搜索把这个逻辑拆解了。用户看到的不再是链接列表,而是一段被重新组织过的答案,其中引用了若干来源。排名消失了,但一个更基础的条件被保留下来:内容必须先进入平台的候选池。没有被收录,就没有被引用的可能。
这个变化意味着优化对象发生了转移。传统 SEO 优化的是页面与查询词之间的相关性,目的是提升在搜索结果页中的位置;GEO 优化的是内容能否被模型识别为某个问题的高质量答案来源,目的是进入生成结果中的引用列表。前者是排序竞争,后者是准入竞争加片段竞争。关键词在后者中仍然存在,但作用从「匹配查询」变成了「匹配问题意图」,且不再由页面标题和 meta 标签主导,而是取决于正文中是否有清晰、完整、可独立理解的段落。
「被收录」的具体含义也变了。在传统搜索中,被收录指的是页面进入搜索引擎的索引库;在 AI 搜索中,它至少涉及两层:底层搜索引擎的索引,以及 AI 平台自身的信源体系。前者决定了内容能否被抓取和检索,后者决定了检索结果能否进入生成候选池。两层都通过,内容才具备被引用的资格。
一张表看懂不同平台的优化优先级
不同平台对这两层的依赖程度差异很大,这直接决定了资源应该投向哪里。
| 平台 | 核心依赖 | 优化重点 | 类型 |
|---|---|---|---|
| ChatGPT | Bing 索引 | 确保被 Bing 收录,使用 Bing Webmaster Tools | 开放爬虫型 |
| Gemini | Google 索引 | 延续传统 Google SEO,利用搜索锚定机制 | 开放爬虫型 |
| Grok | Bing 索引 | 与 ChatGPT 类似,Bing 收录是前提 | 开放爬虫型 |
| 文心一言 | 百度搜索 | 百度收录是门槛,百度系内容权重高 | 生态绑定型 |
| 豆包 | 字节生态 | 在今日头条、抖音有内容沉淀 | 生态绑定型 |
| 元宝搜索 | 腾讯信源体系 | 进入腾讯云开放信源或腾讯内容生态 | 生态绑定型 |
这张表揭示了一个反直觉的结论:对于开放爬虫型平台,技术可访问性几乎是最重要的一环。ChatGPT 和 Grok 都依赖 Bing 索引,如果网站没有被 Bing 抓取,后续所有优化都无从谈起。对于生态绑定型平台,信源准入的权重则远高于段落结构优化。文心一言深度绑定百度搜索,百度收录本身就是门槛;豆包依赖字节系生态,内容在今日头条或抖音上的沉淀比页面结构更重要。
这意味着「一刀切」的 GEO 建议基本不成立。一个面向豆包优化的内容策略,如果照搬到 ChatGPT 上,可能完全无效,因为两者的准入门槛不在同一层。资源有限的内容方需要先判断目标平台属于哪一类,再决定优先解决什么问题。
需要说明的是,七个主要 AI 搜索引擎的列举来自 LumenGEO 的编辑判断,可能不包含所有区域性平台;各平台对底层搜索引擎的依赖关系也可能随产品更新而变化。但平台类型的区分——开放爬虫型与生态绑定型——作为一个分析框架,比具体某个平台当前使用哪个搜索引擎更稳定。
常见问答
问:关键词排名完全没用了吗?
不是完全没用,而是作用方式变了。关键词仍然是内容与问题之间的连接点,但它不再通过页面标题和 meta 标签直接决定排名,而是体现在正文段落能否清晰回答包含该关键词的问题。关键词研究仍然有价值,但产出物从「目标关键词列表」变成了「目标问题列表」。
问:我应该优先优化哪个平台?
取决于你的内容面向谁。如果目标用户在中文互联网,文心一言、豆包、元宝搜索的优先级更高,且各自有明确的生态绑定特征。如果面向英文或全球用户,ChatGPT、Gemini、Grok 的覆盖面更广,但都依赖 Bing 或 Google 的索引。资源有限时,先判断目标平台属于开放爬虫型还是生态绑定型,比盲目铺开更实际。
问:被 Bing 收录了,ChatGPT 就一定会引用我吗?
不会。被 Bing 收录只是进入候选池的必要条件,不是充分条件。ChatGPT 的引用还取决于内容与问题的匹配度、段落能否被独立提取、以及多源交叉验证的结果。但如果不被 Bing 收录,ChatGPT 基本看不到你,后续环节都没有机会发生。
问:生态绑定型平台是不是只引用自家内容?
不是只引用,而是自家生态内容在候选池中占据更有利的位置。文心一言会引用百度体系外的网页,但百度收录是前提,百家号等百度系内容权重更高。豆包同样会引用站外内容,但字节生态内的内容沉淀会显著提高被引用的概率。生态绑定影响的是优先级,不是排他性。
问:段落化检索意味着我应该把文章拆碎吗?
不是拆碎,而是让每个小节都能独立成立。段落化检索奖励的是那些在片段层面就能提供完整信息的内容。一个段落如果脱离上下文仍然能回答一个具体问题,它被提取和引用的概率就更高。这不需要牺牲文章的整体性,但要求每个小节都有自己的信息完整性,而不是依赖前后文才能理解。