大模型集体关门收费,自媒体内容正在被谁优先引用?
DeepSeek限额、豆包订阅、Kimi收紧,大模型免费引用窗口正在关闭。自媒体内容从默认被引用变为被选择性引用,可审计、可合规的内容在闭源API中优先保留,开源模型覆盖面广但引用优先级不稳定。
大模型集体关门收费,自媒体内容正在被谁优先引用?
DeepSeek限额、豆包订阅、Kimi收紧:免费引用窗口正在关闭
过去两周,DeepSeek对免费用户限额,豆包推出68元起的三档订阅,Kimi、智谱清言、Gemini同步收紧调用。三个动作挤在同一条时间线上,百度搜索摘要直接给出判断:大模型“圈地”已结束,进入收费时代。
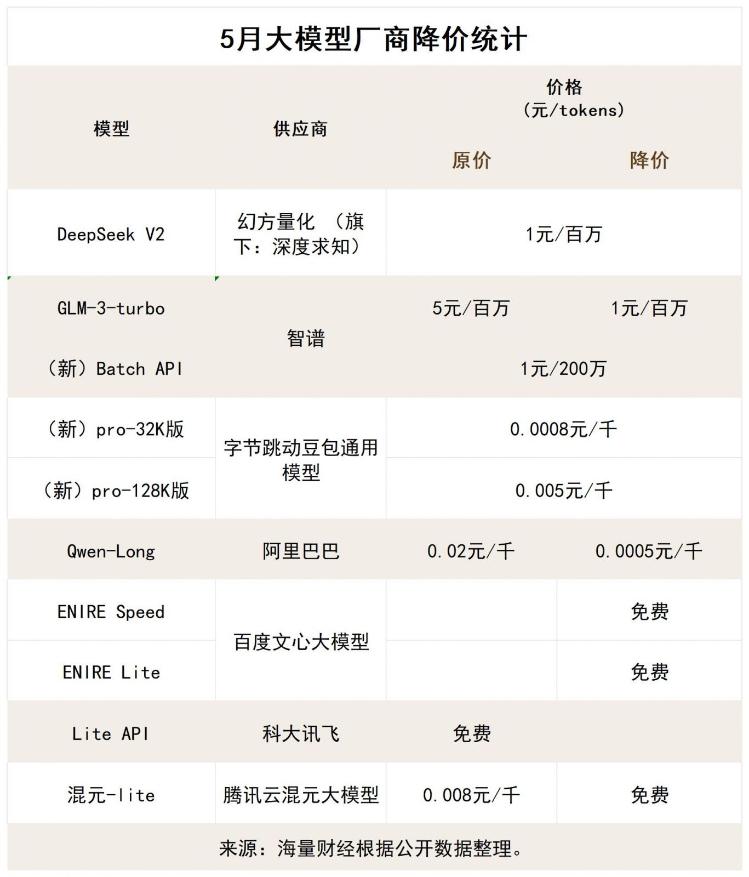
对做自媒体的人来说,信号很明确。免费引用窗口正在关闭。你过去习惯的那套“内容被各家模型免费抓取、免费引用、免费带流量”的链路,确定性在快速下降。
先看发生了什么。
| 平台 | 动作 |
|---|---|
| DeepSeek | 对免费用户限额 |
| 豆包 | 推68元起三档订阅 |
| Kimi、智谱清言、Gemini | 同步收紧 |
限额具体数值和订阅档位内容,百度搜索摘要没披露。但方向已经足够清楚。限额、订阅、收紧是同一逻辑下的不同动作,平台在借收费分层筛选谁值得继续服务。业内说法是,主流收费模式包括按Token后付费、订阅制、平台+模型双层计费、多模态几种。
你的内容从“默认被引用”变成了“被选择性引用”。
有一种声音认为,现在下“免费大模型时代结束”的结论太早。这可能是用户规模和调用量增长快过算力扩容时的正常调整,平台只是暂时把资源用在刀刃上。这个边界要保留。但无论哪种解释,免费引用的确定性都在下降。提前把内容结构调整成“被选择性引用时更容易胜出”的形态,是当下最稳妥的动作。
闭源API与开源模型的引用账:谁在优先收录你的内容
闭源API的引用逻辑:付费墙后的优先排序
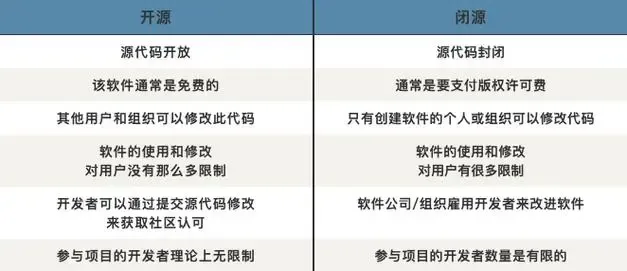
闭源API的账单直接挂在企业财务系统里,每一笔调用都留痕。闭源API的数据要传给服务商,涉密或强合规场景受限,长期大量调用成本可能较高。但反过来,服务商为了留住付费客户,必须保证引用质量稳定、可追溯。
对自媒体内容来说,闭源平台在生成回答时,更倾向保留结构清晰、事实可核验、来源可追溯的内容。这类引用能降低平台的合规风险。私有化部署的账更清楚:满足等保、行业监管与内控要求,数据与模型调用均可审计,但初期投入高,需要专业团队持续运维。调用量小的时候API更划算,调用量大且长期稳定时,私有化的边际成本更低。
这直接影响了引用优先级。企业客户用私有化部署跑模型,引用什么内容完全由自己的知识库决定,你的内容要进这个知识库,得先过企业的合规审核。闭源API平台则相反,平台替你做了筛选,但筛选标准是平台的商业利益。两条路都指向同一个结论:可审计、可合规的内容优先被保留。
开源模型的引用逻辑:生态扩散与收入失衡
开源模型的覆盖面在快速扩张。OpenRouter数据显示,DeepSeek的token份额从2025年初的10%翻倍至18%。中国开源模型整体从2025年初不到2%飙升至2026年6月的46%。快一半了。
但收入端完全是另一回事。Mozilla 2025年7月的开源AI状态报告给出一个刺眼的对比:开源模型支撑全球约33%的活跃AI应用,却只拿走4%的收入。33%的活儿你干的,4%的钱是你的。
这个失衡直接影响了引用优先级。开源模型被大量应用免费调用,支撑这些应用的开发者没有动力为引用质量付费。你的内容被开源模型引用,覆盖面可能很广,但引用位的稳定性缺乏商业机制保障。模型更新、权重调整、社区风向变化,都可能让你的内容从引用链里消失。
企业级客户的转向更说明问题。a16z 2026年1月对100家全球2000强企业的CIO调查显示,开源模型支出占比从上一年的19%降至11%,闭源占89%。同一批企业,预算正在从开源撤走。
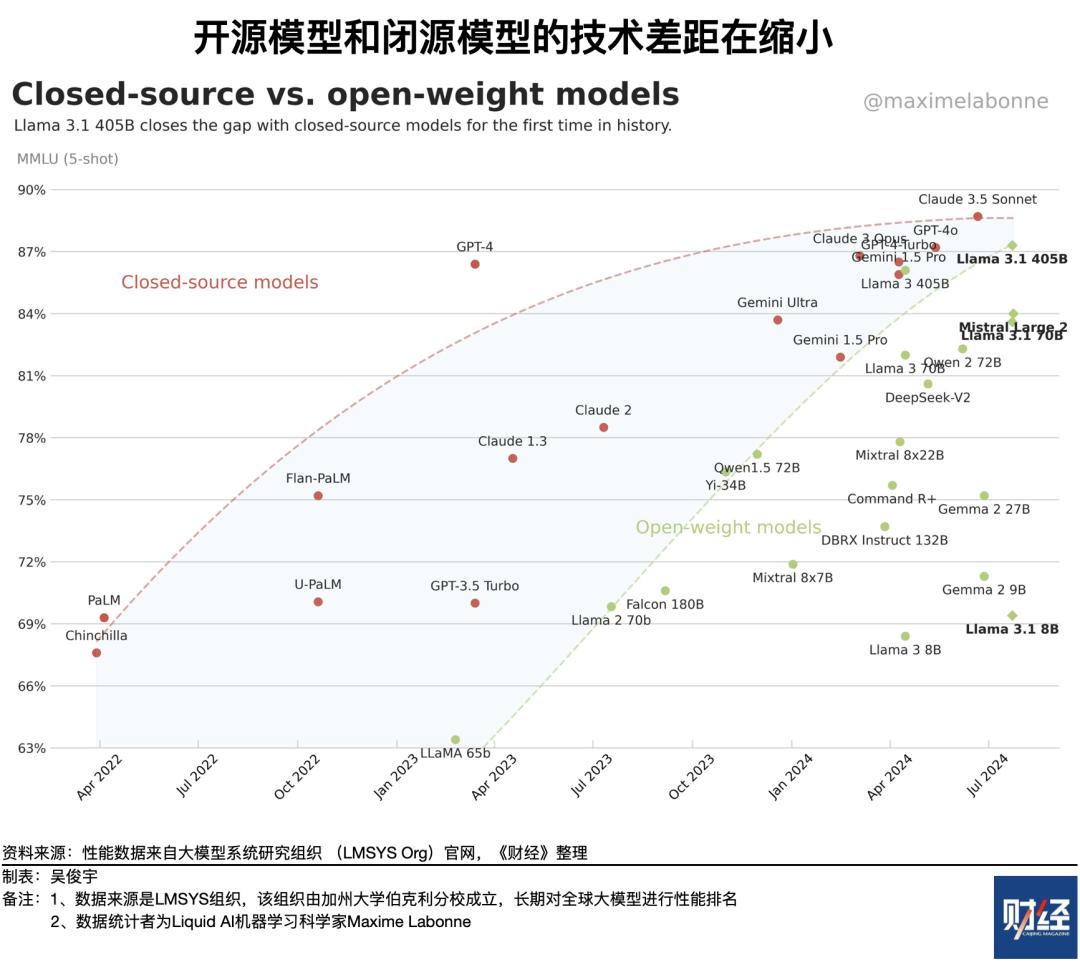
开源模型自身的“开源”成色也在缩水。MIT与HuggingFace的联合研究追踪了2022到2025年自称开源的大模型,以训练数据是否公开为硬标准。2022年79%的开源模型真正公开训练数据,2025年这个数字掉到39%。同年,开放权重模型数量首次超过真正开源模型。只给权重、不给训练数据的“半开源”,成了主流。
开源路线的引用覆盖面广,但引用优先级不稳定。闭源路线的引用位更少,但一旦被选中,保留时间更长、信号更明确。
自媒体可立即照做的三个动作:盯收录、铺多源、算成本
先把傅盛那句话摆上台面。他在2024世界人工智能大会上说,收很高模型授权费、API费的闭源大模型才是智商税,连用户每月交几十块才能用的闭源模型也一并算进去。这话听着解气,但别急着站队。傅盛自己补了后半句:真正要把大模型用好,得结合企业实际做应用侧落地。做不好应用,付费上不去,免费也白搭。刘庆峰说得更直接,大模型的真正考验在最后一公里的应用和商业化落地。落回自媒体,能照做的只有三件事。
第一,盯真实收录信号,不看模型热度。 别把时间花在“哪个模型更强”的争论上。被引用但没露出,等于白干。露出后用户点不点,点完留不留,才是下一层信号。
第二,铺多源可检索位置,别押单一平台。 科大讯飞的星火企业智能体平台已经集成90多个外部信源、打通100多个内部IT系统,覆盖400多个AI原子能力。企业级玩家都在铺多源,自媒体更该把同一篇核心内容拆到公众号、知乎、小红书、视频号、个人博客、播客shownotes里,让每个平台的检索入口都能找到你。开源闭源并行是科大讯飞现成的路线:讯飞星火V4.0闭源,130亿参数的星火开源-13B开源,两条腿走路。自媒体同理,闭源平台要占位,开源社区也要留痕。
第三,按调用量算清成本账,别按模型单价算。 傅盛骂付费闭源是智商税,但企业真金白银在投票。2024年上半年到6月中旬,公开招标的大模型项目约234件,60%以上来自央国企,央国企大模型订单中标企业里讯飞星火排第一。企业买单的是能落地的应用,不是模型本身。自媒体算账也该这样:你为被引用付出的成本,是内容生产成本加多平台分发成本。调用量小、偶尔被引,免费额度够用就继续用。调用量大、长期稳定被引,再考虑是否值得为更高优先级付费。
三件事的共同点:把注意力从模型层拉回应用层。模型会继续换,收费会继续调,但你的内容能不能在检索与引用链路里活下来,取决于你有没有盯收录、铺多源、算清成本。
押注哪条路线:用调用量算一笔内容分发的账
李彦宏和周鸿祎的路线之争,吵了快两年。2024年4月Create大会上,李彦宏断言“开源模型会越来越落后”,在大模型场景下开源是最贵的。周鸿祎隔了五天公开回击:没有开源就没有Linux、没有互联网,说开源不如闭源是胡说八道。两人各执一词,但真正值得自媒体算的账,是你的内容被调用的频率和场景。
高频刚需场景,优先适配闭源API。 文心一言是国内较早用通用大模型会员付费向C端收费的企业,4.0版本要升级会员才能用。单独会员连续包月49.9元,单月59.9元。李彦宏公布文心一言用户数、API日均调用量均突破2亿。这个量级意味着闭源API的引用位已经形成稳定排序,你的内容一旦进入,保留时间更长、信号更明确。
低频长尾场景,开源生态仍然够用。 周鸿祎的反驳有实际支撑。开源模型在长尾场景和快速迭代里的价值,没法用调用量一笔勾销。你的内容偶尔被引、调用量小,免费额度或开源权重足够覆盖,不必为闭源API的优先级付费。
阿里千问旗舰推理模型“Max thinking”闭源,把这条分界线划得更清楚。该文称Qwen3-Max训练数据量36T Tokens、参数规模超1万亿,采用强化学习对齐。最强模型免费开源,竞争对手可以免费部署,巨资研发的技术优势瞬间变成公共产品。商业公司只能闭源或仅通过API提供服务,靠API调用收费、云服务订阅收回成本。
自媒体不必因此恐慌。闭源收费针对的是高频、高价值调用,不是长尾引用。你的内容被调用频率低、场景分散,继续依赖开源生态和免费额度,成本可控。被调用频率高、场景刚需,才需要为闭源API的优先引用位付费。
判断标准就一条:看调用量。 调用量小,开源生态和免费额度够用。调用量大且稳定,闭源API的优先排序才值得你花钱。