DeepSeek 搜索不再单独收费,但成本没有消失,只是进了 Token 账单
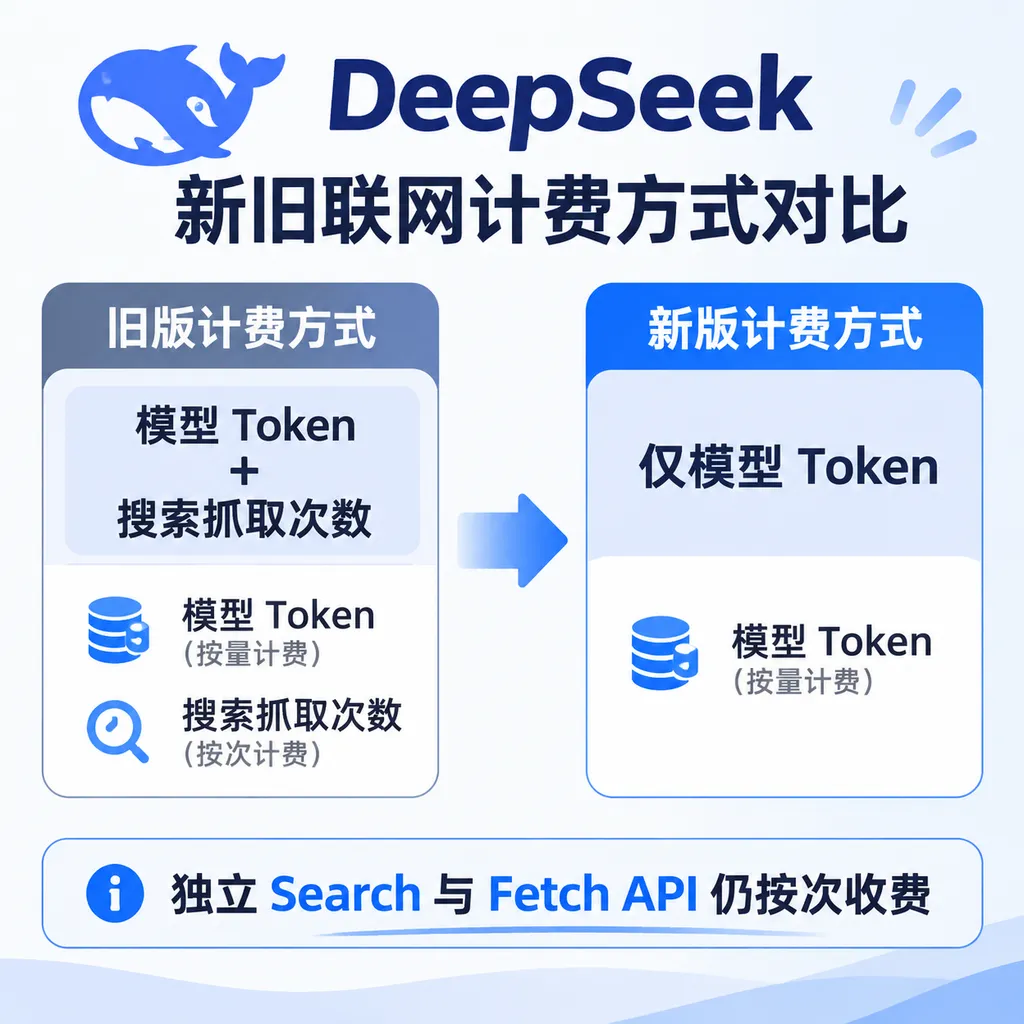
DeepSeek 自 2026 年 11 月 18 日起取消模型调用中服务端搜索与网页抓取的单独计费,只收模型 Token 费用。文章区分了模型触发与独立调用两种场景,指出这次调整改变的是成本结构而非总成本:高频短查询更可能受益,长网页抓取可能因 Token 膨胀而更贵。
DeepSeek 搜索不再单独收费,但成本没有消失,只是进了 Token 账单
免费的不是搜索,是搜索的单独账单
DeepSeek 这次调整的是搜索的计费方式。自北京时间 2026 年 11 月 18 日 12:00 起,调用模型时触发的服务端搜索与网页抓取不再单独计费,只按模型 Token 用量收费。搜索返回的网页内容会进入上下文,变成输入 Token。成本并未消失,只是从一张独立的账单转移到了 Token 账单里。对开发者而言,这是一次计费结构的变化,不是一次简单的降价。
旧口径下,一次带搜索的模型调用需要同时承担两笔费用:模型本身的 Token 消耗,以及搜索或抓取动作产生的独立费用。新口径把前者保留,后者取消,但搜索获取的文本会作为上下文的一部分计入输入 Token。判断这次调整是否划算,不能只看“搜索不再收费”这句话,而要看搜索行为最终在 Token 账单上留下了多少痕迹。
如果一次搜索只返回少量文本,Token 增量有限,实际成本确实接近免费。但网页抓取往往带回的是长文本,尤其是需要整页解析的场景,输入 Token 的膨胀可能相当可观。此时,原先按次收取的抓取费用被替换为按 Token 计费的上下文成本,孰高孰低取决于抓取内容的长度和模型对上下文的使用方式。公开资料未披露 DeepSeek 内部对搜索结果的截断或压缩策略,因此无法给出统一的成本换算公式。
这次调整覆盖的范围包括联网工具、Anthropic API 的 web_search 工具,以及 Responses API 的 web_search 工具。主动调用独立的 Search API 或 Fetch API 并不在本次调整范围内,那些接口仍按其原有规则计费。只有模型调用过程中由服务端触发的搜索与抓取,才适用“仅按 Token 计费”的新口径。
模型触发的搜索与独立 Search/Fetch API 是两套账
这次调整的边界比表面看起来更窄。官方说明中“不再计费”的对象,仅限于调用模型时由服务端触发的搜索与网页抓取。当开发者使用联网工具、Anthropic API 的 web_search 工具或 Responses API 的 web_search 工具时,模型在回答过程中自行发起的搜索请求不再单独计费,相关成本被并入模型的 Token 用量。
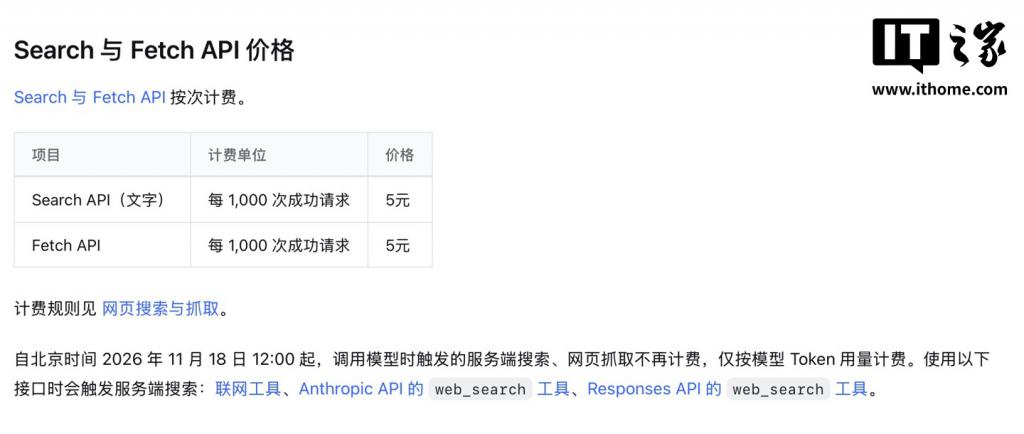
但主动调用独立的 Search API 或 Fetch API 并不在此列。根据 DeepSeek 官方文档,Search API(文字)与 Fetch API 仍按成功请求次数计费,价格均为每 1,000 次成功请求 5 元。白鲸出海的报道也明确提示:此次免费范围限于模型调用过程中触发的服务端工具,独立使用搜索和抓取接口仍有费用。
两种路径的计费逻辑存在实质性差异。模型触发的搜索发生在一次模型调用的内部,开发者无法单独控制搜索次数、抓取页面数量或结果长度,最终费用取决于模型返回的 Token 总量。独立 Search/Fetch API 则是开发者主动发起的请求,计费依据清晰:只有返回 HTTP 200 且产生结果时才计费,Search 的 results 必须非空,Fetch 必须返回网页正文。请求失败、搜索无结果或超时均不计费。
如果开发者此前通过独立 Search API 获取搜索结果、再自行拼接上下文交给模型处理,本次调整不会改变这部分成本。5 元/千次的按次收费依然存在。只有把搜索能力交给模型内部工具链、让服务端自动完成检索与整合的场景,才会从按次计费转为纯 Token 计费。
一个需要留意的细节是,官方对触发服务端搜索的接口列举存在一处缺失:IT之家引用的官方说明中,第一个工具名称在原文中显示不完整。公开资料未能补全该名称,因此服务端工具的确切覆盖范围仍需以 DeepSeek 后续文档为准。
判断自己是否受惠于本次调整,关键看搜索是模型自己发起的,还是代码主动调用的。前者进入新的 Token 计费口径,后者继续沿用按次计费。两条路径在账单上并不互通。
成本没有消失,只是从按次变成了按 Token
取消按次计费并不意味着搜索成本消失。搜索和抓取返回的网页内容会作为模型输入的一部分进入上下文,这部分内容同样按 Token 计费。Search 接口按 query 返回结构化结果,Fetch 接口抓取单个网页并以 Markdown 文本返回标题与正文。模型调用中触发的服务端搜索,其返回结果若被拼入上下文,输入 Token 用量会随之上升。搜索越频繁、抓取页面越长,Token 增量越大。
模型本身继续按输入、输出 Token 计算费用,单价随模型、缓存命中情况及使用时段而不同。原本按次收取的搜索费用,现在体现在输入 Token 的账单里。一个长网页抓取后以 Markdown 全文返回,其文本量可能远超一次搜索查询本身。如果模型需要多次搜索、反复抓取不同页面,并将这些内容全部纳入上下文,输入 Token 的膨胀会相当明显。
成本是否下降,取决于 Token 增量与原先按次费用的对比。高频但每次返回内容简短的搜索,按次费用取消后可能明显受益。低频但抓取长网页的场景,Token 增量带来的模型费用可能超过原先的抓取费用。公开资料未披露 DeepSeek 对搜索结果在进入上下文前是否做截断或压缩处理,因此无法给出统一的换算公式。
高频短查询受益,长网页抓取要重新算账
判断自己属于哪一类,可以先算一笔简单的账。按次计费时代,1,000 次成功搜索或抓取固定收 5 元。切换到纯 Token 计费后,这 5 元预算能买多少输入 Token,取决于所选模型和时段。DeepSeek-Flash 空闲时段的输入单价为每百万 tokens 1 元,DeepSeek-V4-Pro 高峰时段为每百万 tokens 9 元。同样 5 元,在 Flash 空闲时段对应的输入 Token 数量远高于 V4-Pro 高峰时段,差距接近一个数量级。
模型选择本身就在改变盈亏平衡点。高频短查询场景中,单次搜索返回的文本量通常有限,即使叠加多次搜索,累计 Token 增量也较难触及按次计费时代的固定支出。这类应用在取消按次收费后,账单更可能下降。
长网页抓取则相反。Fetch 抓取一个页面后以 Markdown 全文返回,网页正文的文本量可能相当可观。如果一次任务抓取多个长页面,Token 增量会迅速放大。在 Flash 空闲时段,5 元对应的输入 Token 数量或许还能覆盖相当数量的抓取;但在 V4-Pro 高峰时段,同样 5 元能买到的输入 Token 大幅缩水,长网页抓取的成本压力会明显上升。
公开资料未披露搜索返回内容的平均 Token 量,也没有说明 DeepSeek 是否在内容进入上下文前做截断或压缩,因此无法给出精确的盈亏平衡公式。但判断方向是清楚的:高频、短查询、低单价模型、空闲时段,受益概率更高;低频、长网页、高单价模型、高峰时段,成本上升的风险更大。
另一个需要纳入计算的是缓存命中情况。DeepSeek 的 Token 单价随缓存命中与否而变化,缓存命中时输入价格显著低于未命中。若搜索返回内容能够被缓存复用,实际成本会低于按未命中价格估算的结果;反之,若每次搜索都产生新的未命中输入,账单会更接近上限。