降价之后,AI 引用你的方式正在分裂
当推理成本降到原来的六分之一甚至更低,AI 回答会覆盖更多长尾问题,品牌被引用的分母变大,但引用逻辑不再由官网决定。不同平台的引用偏好、Agent 连接器的权限边界、以及“无源引用”的监测盲区,共同决定了同一篇内容可能在一个平台被引用、在另一个平台完全缺席。GEO 的下半场不是提高产量,而是理解入口分化和证据可核验性。
降价之后,AI 引用你的方式正在分裂
成本降了 83%,被引用的难度反而先升后分
为什么更便宜的推理不等于更便宜的可见度
模型降价的消息正在被当成品牌可见度的利好来读。逻辑似乎很直接:调用成本下降,AI 回答覆盖更多问题,品牌内容被引用的机会随之增加。但这条链只对了一半。成本下降确实扩大了回答范围,却同时拉高了竞争基数。过去因成本被跳过的长尾问题重新进入回答范围,意味着更多信源进入同一个候选池。被收录的绝对机会在增加,被选中的相对概率却在被稀释。
OpenAI 于 10 月 27 日推出的 GPT-6.1 Terra 提供了一个价格锚点:标准 API 定价为每百万输入 token 1 美元、输出 5 美元,输入价格较上一代减半,输出降幅接近六成。这不是孤例。前沿推理成本已经连续两年下降,市场结构中没有迹象表明这一趋势会停止。当推理便宜到可以批量处理更多问题,AI 回答覆盖的长尾场景会持续扩张。品牌可见度的分母不是固定值,而是随调用成本反向变动。
因此,更便宜的推理不等于更便宜的可见度。它首先改变的是可见度的计算方式:过去品牌只需要在一组高频问题中保持靠前,现在必须在一个不断扩大的问题空间里重新确认自己的位置。这个变化不是理论推演,而是调用成本下降后回答覆盖范围扩张的直接结果。
PilotDeck 2.0 的 83% 降幅说明了什么
PilotDeck 2.0 的数据常被用来证明智能体成本下降的速度。清华 THUNLP 实验室联合面壁智能、OpenBMB 开源的这套编排系统,在同样 7 个高难度任务中,将成本从单跑 Claude Sonnet 4.6 的 18.36 美元降至 3.15 美元,降幅约 83%,得分从 69.1 提升至 70.6。成本降到原来的六分之一,性能还略有上升。
这个数字对品牌内容场景的适用性需要谨慎。测试任务是否覆盖品牌可见度场景,公开细节未证实。83% 的降幅来自特定任务集,不能直接外推为所有 AI 引用场景的成本变化。但它揭示了一个结构性信号:当编排层把单次任务成本压到原先的六分之一,批量生成和批量检索的门槛同时下降。内容供给端和 AI 检索端都在加速。品牌面对的不仅是更多同行内容,还有更多被 AI 主动拉入回答范围的次级信源。
成本降幅的真正含义不在省钱,而在竞争结构的改变。当推理成本低到可以覆盖大量长尾问题,AI 回答的候选池会持续膨胀。品牌被引用的难度先上升,再在入口和生态层面出现分化。这个判断来自对调用成本与可见度关系的分析,而非实测结论。但方向是清楚的:降价让 AI 引用内容的总量增加,也让单个品牌被选中的条件变得更加苛刻。
引用权从官网转移到了入口和连接器
Claude Duet 的 6000 个连接器改变了什么
引用权的转移首先发生在入口层。当 Claude Duet 集成超过 6000 个应用连接器,AI 获取信息的路径就不再依赖用户访问某个网站。连接器直接读取企业系统里的订单、库存、价格数据,回答可以在不经过官网、不产生点击的情况下生成。博晓通在分析 10 月 27 日行业周报时指出,这种能力让智能体能在用户未下指令时主动推送简报。这里的关键不是模型更聪明,而是数据获取方式变了:过去 AI 搜索需要从公开网页抓取内容,现在连接器把私有系统数据变成了可直接调用的信源。
对品牌而言,这意味着被引用的前提发生了变化。传统 GEO 的逻辑是优化官网内容,让搜索引擎和 AI 爬虫更容易收录。连接器绕开了这一步。企业系统里的结构化数据可以直接成为答案素材,官网是否被收录、页面是否被点击,都不再是必要条件。博晓通的分析结论是,品牌在 AI 回答中的曝光与引用来源不再由自己的官网决定,而由入口、接口与生态权限共同决定。这个判断尚未经过系统测试验证,但它准确描述了入口分化的方向。
当 Agent 读你的数据却不给你链接
连接器带来的另一个后果是监测口径的失效。当智能体通过连接器读取企业系统数据时,答案可能完全准确,却不标注任何可点击来源。博晓通把这种现象称为“无源引用”:品牌被提到了,但监测系统抓不到引用链接,按传统口径会被记为“无引用提及”,从而低估实际曝光。
这解释了为什么很多品牌会困惑:官网内容在 AI 回答里消失了,但 AI 又似乎知道自己的信息。数据没有被收录进公开索引,而是通过接口被临时调用。传统 SEO 工具统计的是链接和提及,无法捕捉这种短暂、无链接的数据调用。监测体系需要从“抓取链接”转向“识别数据调用痕迹”,但这个转变目前缺乏统一的测量标准。
需要警惕的是,“无源引用”目前仍是方法论层面的观察,没有系统的对比测试证明其规模。连接器读取数据的权限边界、数据是否被存储、调用后是否留下可审计记录,这些关键问题在公开资料中尚未得到证实。从业者的反馈指向同一个方向:真正卡住生产部署的不是模型能力,而是计费、归因和发布者关系等商业基础设施。这提醒我们,引用权的转移不仅是技术问题,更是一套尚未成型的商业规则正在取代旧的链接逻辑。
同一篇内容,在一个平台被引用,在另一个平台完全缺席
ChatGPT、DeepSeek、豆包、元宝的引用偏好为什么不同
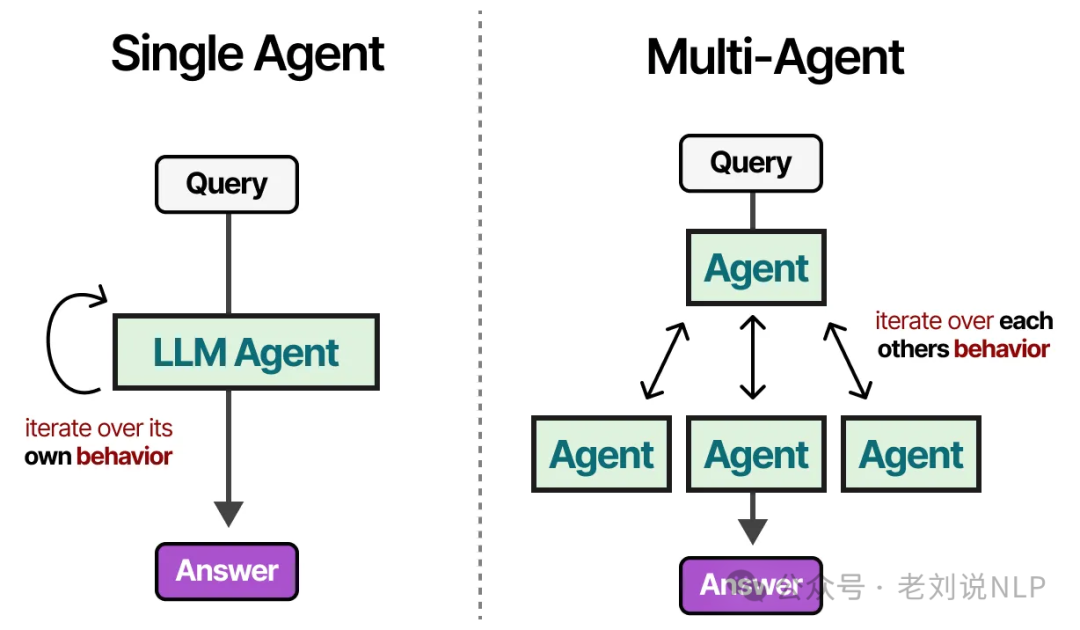
同一篇内容在一个平台被引用、在另一个平台完全缺席,是当前 AI 搜索的常态而非异常。ChatGPT、DeepSeek、豆包、元宝、通义千问、Kimi、Perplexity 抓取的信源结构和排序逻辑各有差异。这种差异首先来自技术路径:有的平台优先检索实时网页,有的更依赖自身索引库,还有的通过连接器直接调用特定数据源。其次来自产品定位:面向通用问答的产品倾向于引用权威百科和新闻站点,面向办公场景的产品更偏好结构化数据和可验证的官方文档。
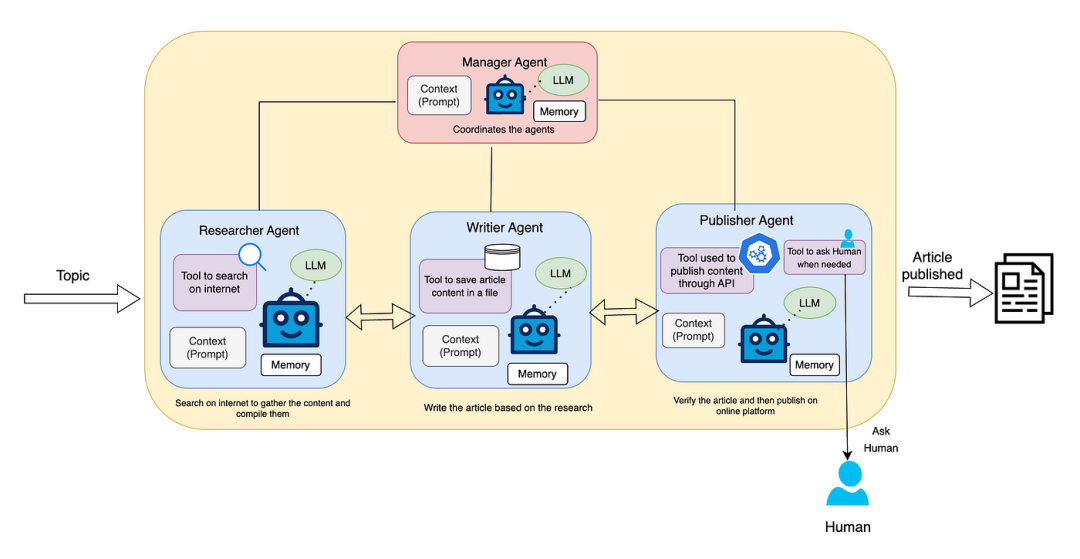
这意味着不存在一个统一的“AI 引用标准”。品牌如果只盯着某一个平台的引用表现,很容易得出偏颇结论。一篇在豆包中被引用的内容,可能在 ChatGPT 的回答里完全不被提及;反过来,在 Perplexity 中表现良好的页面,未必能进入元宝的信源列表。平台偏好分化的直接后果是:单一内容策略无法通吃所有入口。
可核验性比产量更接近引用权的核心
在平台引用结构不一致的条件下,什么内容更可能跨平台被选中?行业观察给出的答案是可核验性。大模型在生成回答时倾向选择实体信息明确、数据可回溯、结论有边界的内容。含糊的营销表述即使产量再高,也很难在多个平台同时获得引用。实体明确意味着品牌、产品、机构名称清晰可辨;数据可回溯意味着关键数字能指向原始来源;结论有边界意味着内容不夸大、不模糊适用条件。
这个判断需要限定边界。目前没有系统测试证明可核验性在所有平台上的权重一致,它来自对主流 AI 引用行为的观察性总结。但逻辑方向是明确的:当 AI 需要在多个候选信源之间做筛选时,可验证的信息降低了模型的引用风险。粗糙内容以前只是没人读,现在会被 AI 系统拉出来用于判断品牌材料。真正变便宜的是算力调用,不是品牌被正确理解的成本。
GEO 能做的是提高被引用和被正确描述的概率,不能控制 AI 回答的具体措辞。任何承诺可以操控 AI 回答的说法都不可信。品牌能操作的变量不是让所有平台都引用自己,而是让自己的内容在更多平台的筛选逻辑中存活下来。可核验性是目前最接近这个目标的通用条件。
生态方不开放,模型能力再强也拿不到数据
亚马逊拦截 Muse、百款应用拒绝 AI 手机说明了什么
模型能力不是引用权的充分条件。亚马逊以违反使用条款为由拦截了 Muse 的代购功能,国内首款备案 AI 手机开售即遭超百款应用拒绝,微信、淘宝等超级应用始终未开放自动化接口。三件事指向同一结论:智能体能否拿到交易与内容数据,最终取决于生态方的开放意愿,而不是模型本身的推理或检索能力。
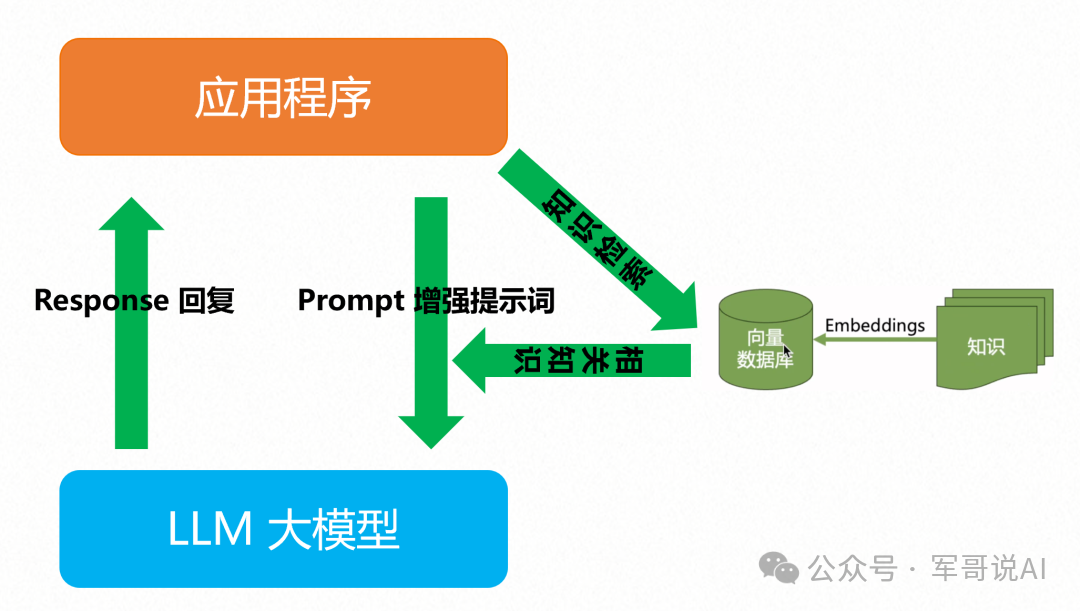
这意味着一个被忽略的边界。模型可以在公开网页上自由爬取内容,但一旦涉及登录态、交易流程、用户关系链或平台内闭环数据,访问权限就完全由生态方决定。Muse 的案例尤其典型:代购功能技术上并不复杂,真正卡住它的是亚马逊对自动化行为的条款限制。技术能力再强,也无法越过商业权限。
对品牌而言,这个边界直接改变了引用权的性质。过去在搜索引擎时代,收录与否主要取决于技术规范——robots.txt、站点结构、内容质量。现在,引用权更像一种商业准入。平台可以选择让某些 Agent 读取数据,也可以随时关闭接口;品牌被谁引用,部分取决于它与生态方的关系,而非单纯的内容优化。
GEO 的边界:提高概率,不控制措辞
反向案例同时划定了 GEO 的能力边界。GEO 能做的是提高被引用和被正确描述的概率,不能控制 AI 回答的具体措辞。任何承诺可以操控 AI 回答的说法都不可信。
这个边界在操作上很具体。品牌可以通过结构化数据、可核验事实和清晰的来源标注,降低模型引用时的风险;但模型最终如何组织语言、把品牌放在什么位置、是否附带限定条件,都不在品牌控制范围内。GEO 优化的是被选中的概率,不是被呈现的方式。
生态权限与措辞失控是两个不同层面的问题。前者决定品牌能否进入候选池,后者决定品牌进入候选池之后被如何描述。两者叠加,解释了为什么品牌在 AI 引用中的位置比在传统搜索中更难稳定维持。引用权不再是一个可以靠技术规范锁定的结果,而是一个持续受商业权限和模型行为双重影响的动态状态。