OpenAI研究员日烧2400美元算力,效率账按任务重算
OpenAI 2026年10月内部数据显示,中位数研究员每天在Agent上的API折算花费达2400美元,等效价值已是研究员非股权薪酬的两倍。这笔高成本主要买的是低成功率、高干预率的并行试错,效率账必须按任务类型和单位有效产出重新计算。
OpenAI研究员日烧2400美元算力,效率账按任务重算
OpenAI研究员日均2400美元Agent开销:一笔被误读的账
2026年10月,OpenAI首次在官方博客披露一组内部预算数字。研究组织中位数研究员每天在智能体工具上的API开销约为2400美元,第90百分位研究员约23000美元。按API标价折算,这笔AI使用量的等效价值已达到研究员非股权薪酬的两倍。消息经36氪等媒体转述后,舆论焦点迅速落在“AI比人贵”上。
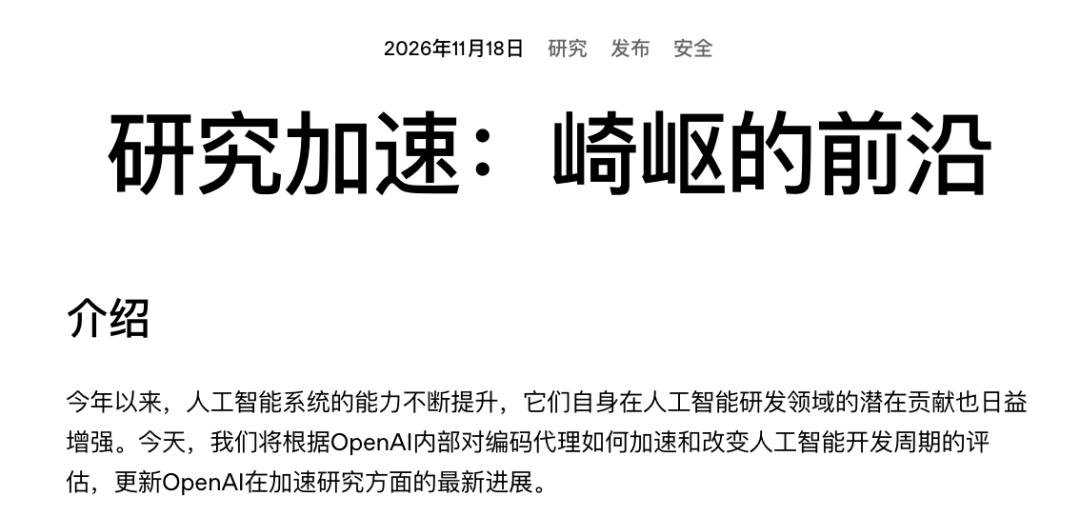
2400美元与两倍薪酬并置,真正暴露的是研发组织的成本计量单位正在换轨:从按人时计薪,转向按算力计件。传统降本增效的框架在这里第一次失效。
先看会计含义。Agent开销的“两倍薪酬”口径是非股权薪酬,不含股权。这笔2400美元的日均API开销,对应的是现金薪酬部分的两倍,而非总人力成本的两倍。媒体标题里“已达薪酬两倍”的冲击力,部分来自口径选择。
但口径修正不改变实质。一个中位数研究员每天烧掉2400美元算力,90分位研究员烧掉23000美元,较9月分别上涨62%和105%。这个增速本身说明,Agent使用量在OpenAI研究组织内部正在快速铺开,成为默认工作方式。当AI的API折算价值在账面上超过人类现金薪酬时,企业实际上是在用算力购买一种新的劳动形态。
这笔账不能按替代逻辑算。传统降本增效的问题是:AI替代了多少人力、省了多少工资。OpenAI的数据指向另一件事——Agent成为研究员调用的一种生产资源。研究员花2400美元买Agent算力,产出的是实验设计、代码审查、数据清洗或文献梳理。这些产出以前靠研究员自己花时间做,现在靠算力买。成本从“人时工资”变成了“算力计件”,产出归属仍然挂在研究员名下。
这就解释了为什么“两倍薪酬”不等于“AI比人贵”。它衡量的是AI劳动投入的账面规模,而非AI替代人类的净收益。关键变量不在总开销,而在单位有效产出的边际成本与任务边界。OpenAI没有披露Agent具体完成了什么、失败率多高、有多少算力花在了无效重试上。这些数据缺失,使得“2400美元值不值”目前无法从外部严格判断。但有一件事是确定的:当一家研发组织的核心研究员日均调用算力价值超过自身现金薪酬时,管理层的决策框架必须从“控人头”转向“控算力效率”。
这个转向的阵痛会最先出现在预算审批环节。以前问的是“这个项目要加几个人”,现在要问的是“这个项目的Agent预算上限设多少、哪些任务允许无限调用、哪些任务必须人工把关”。OpenAI自己在博客里提到,预训练和后训练环节的Agent开销比率高于研究组织其他部分。算力密集的研发环节,成本结构变化更快,对任务边界的划分需求也更迫切。
46%自主成功率背后的真实成本结构:买的是并行探索,不是稳定替代
衡量这笔开销值不值,得先看Agent到底交出了什么。OpenAI官方博客给了一组按任务时长拆分的自主成功率:预计需2至4小时人类工作的任务,成功率从2026年3月的23%升到10月的46%;预计需4至8小时的任务,同期从13%升到35%。翻倍发生在短任务上。长任务即便最终成功,超过一半至少发生过一次人工干预。
Agent的高成本主要流向低成功率、高干预率的探索性任务。任务类型一拆,差距更刺眼。
| 任务类型 | 自主成功率 |
|---|---|
| 监控训练运行 | 79% |
| 沟通类任务 | 69% |
| 分析类任务 | 58% |
| 启动训练运行 | 35% |
| 写推理与服务栈代码 | 25% |
监控训练运行这类稳态、规则明确的工作,Agent已经能扛近八成。让Agent从零搭建复杂系统,成功率直接掉到四分之一。构建类任务整体只有43%。
这里的经济含义很直接:花出去的2400美元,大部分没有买到“交付”。买到的是并行试错。一个研究员可以同时铺开几十个Agent去撞任务空间,撞通了省下自己半天时间,撞不通就重来。长任务过半需要人工介入,研究员的时间从“写代码”变成了“盯Agent、纠Agent、给Agent补位”。
OpenAI自己在博客里承认,实验数量上升与Codex采用率提高同时发生,但同期可用算力也显著增加。所以实验变多不能全算在Agent头上。用“成功率翻倍”来证明Agent值回票价,证据链并不闭合。
真正该盯的,是单位有效产出的边际成本。短任务Agent成功一次,API开销有限;长任务算上失败重试和人工干预的时间,等效成本可能远超研究员自己上手。任务边界划在哪里,决定了这笔账是赚是亏。
研究员日均驱动5.7个Agent工作日:人机配比正在改变岗位实质
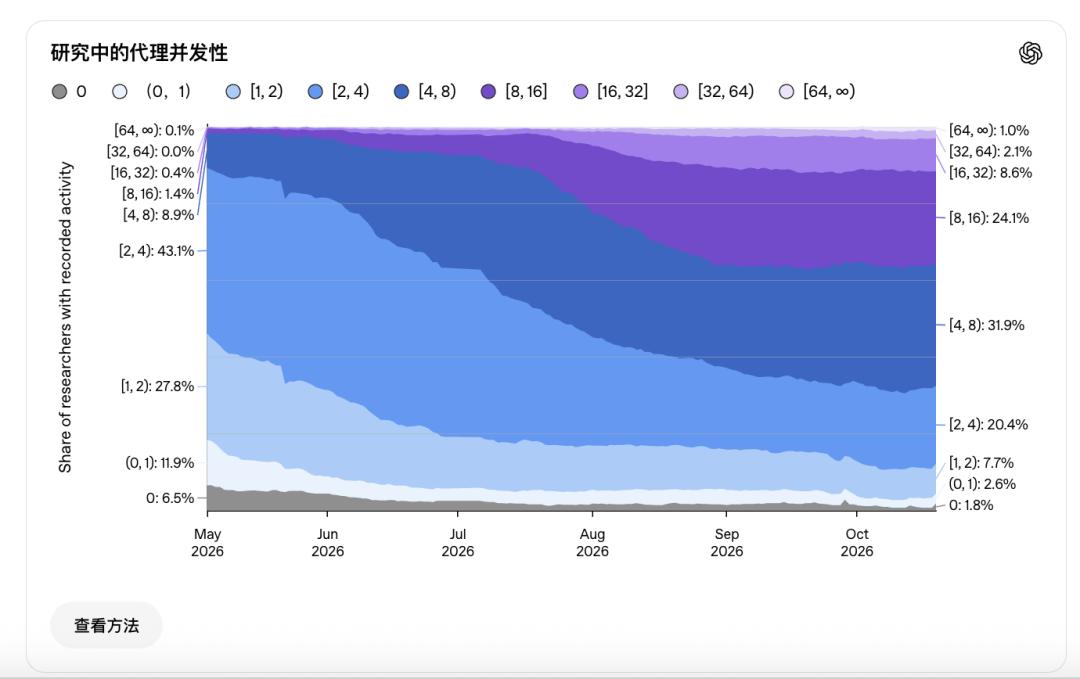
研究员手里的活儿已经变了。OpenAI官方博客给出一组行为数据:每位研究员日均驱动的智能体工作时长,从0.5个Agent工作日涨到5.7个,增长约11倍。预训练和后训练团队更夸张,人均每天烧掉约8个Agent工作日。超过三分之二的研究员每天至少同时跑4个Agent,超过10%同时跑至少16个。
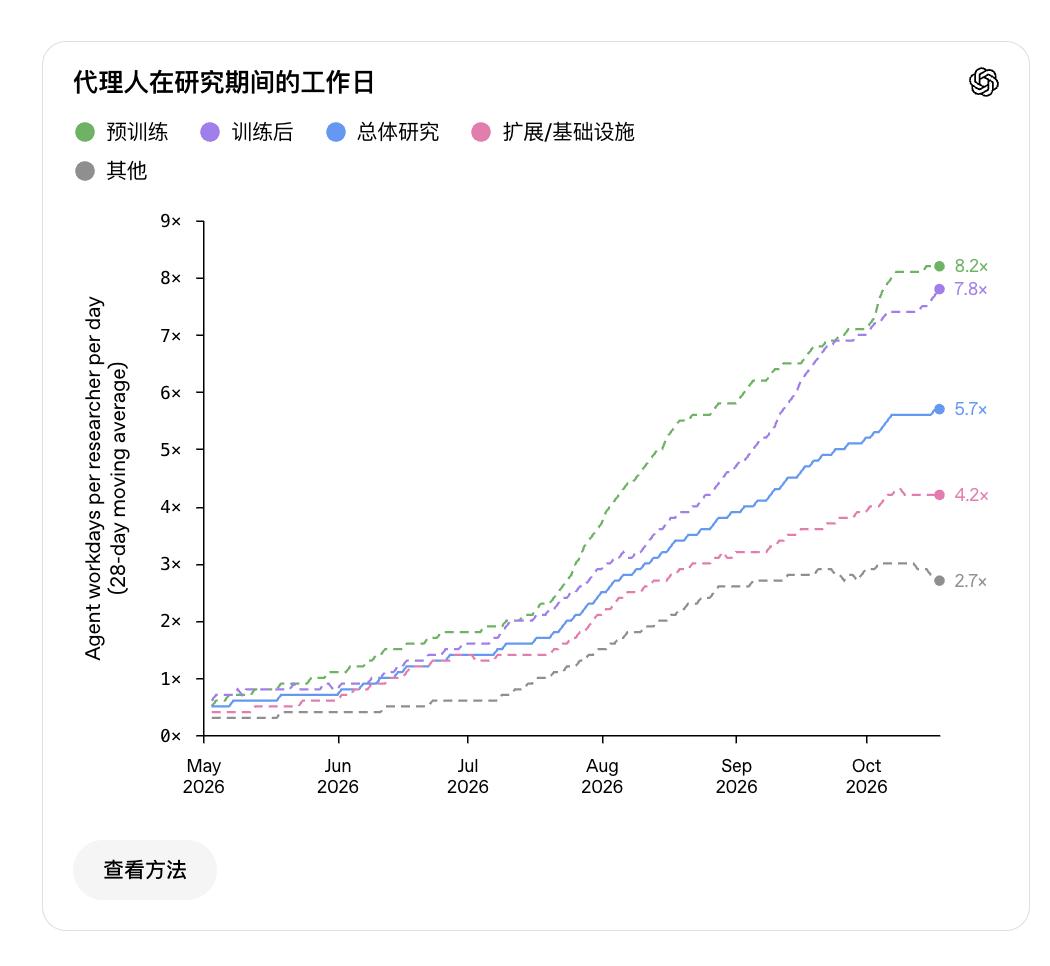
5.7个Agent工作日意味着,研究员的大部分时间不再花在亲手写代码、跑实验、调参数上,而是花在给Agent派活、盯进度、判断输出靠不靠谱上。岗位实质从执行者变成了调度者。
但调度这件事,Agent暂时干不了。OpenAI内部研究员的反馈很直接:Agent是实现代码和调试的绝佳工具,可它自己提不出好问题,分不清代码的好坏,也看不出数据的优劣。任务可以外包,判断不能外包。
更关键的数据在高层研究规划。OpenAI对2026年1月至8月Coding Agent的Token使用分析显示,高层研究规划仍只占Agent输出Token的极小部分。决定研究什么、往哪个方向走,依然主要是人的工作。Agent承接的是“怎么做”,不是“做什么”。
这划出了当前人机分工的硬边界。研究员的核心价值从执行上移到规划与判断,但Agent缺乏研究品味,提不出值得做的选题,也分不清产出的优劣。只要这两件事还得靠人,研究员的岗位就不会被Agent吃掉,只会被Agent重新定价。
效率提升的账必须按任务类型重算:三条可执行取舍
把OpenAI的内部账本放到行业里看,成本结构没有变好,反而更扎眼。斯坦福、密歇根等机构2026年4月的研究显示,编码Agent在真实软件工程任务中消耗的Token约为普通代码问答的1000倍。康考迪亚大学的实验进一步拆开了这笔开销:输入Token占53.9%,输出占24.4%,思考推理占21.6%。真正吃算力的环节不在写代码——代码审查阶段独占59.4%的Token,写代码本身仅占8.6%,架构设计占2.4%。
这个分布对预算审批有直接含义。按任务阶段拆,Agent的高成本集中在验证与推理,而非生成。企业如果按“写了多少行代码”来评估Agent产出,会系统性低估真实消耗。审查加上代码补全吃掉超过86%的算力,Agent的边际成本大头在“判断代码对不对”,不在“把代码敲出来”。
评估Agent投入产出,得放弃人均成本这个单一指标,改用三条标准:
- 按任务类型拆成功率:监控类79%、分析类58%可以上Agent,构建类43%先别急着全量铺开。
- 按阶段拆Token消耗:代码审查占59.4%,写代码仅8.6%。预算要往验证环节倾斜,别按生成量拨款。
- 按干预率折算真实人力成本:长任务即便最终成功,过半至少发生一次人工干预。把研究员接管时间折进去,等效时薪经常超过自己上手。
Gartner的预测把这笔账推向更远的时间线:到2028年,AI编码成本可能超过开发者平均薪资。该预测基于全球程序员月均约2000美元的平均基准,不适用于高薪资深研发,但成本抬升趋势明确。OpenAI的2400美元日均开销按API零售价折算,不是真实边际成本;即便如此,方向已经清楚。
后续盯两个数:一是OpenAI下季度是否公布分任务类型的Agent干预率,二是Gartner 2027年是否上调AI编码成本预测基准。