机器人数据1000元/小时,具身智能最隐秘的“卖铲”生意
机器人数据1000元/小时,具身智能最隐秘的“卖铲”生意
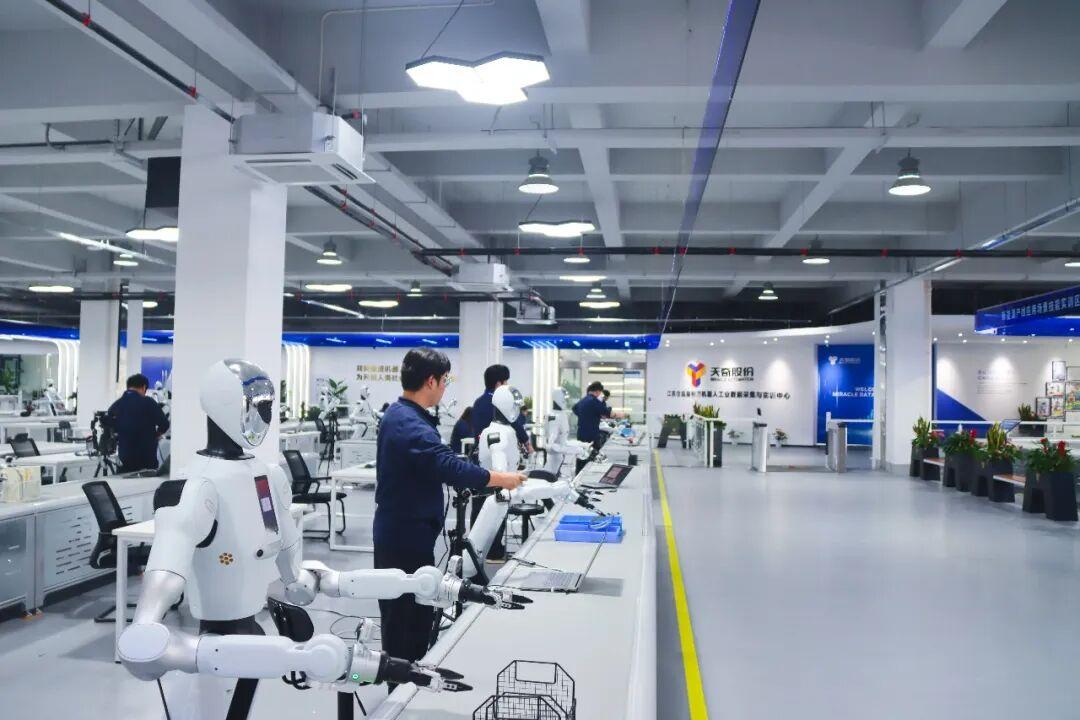
去年拜访一家人形机器人初创公司,他们正在教机器人叠衣服。工程师告诉我,为了采集一段30秒的“拿起T恤-对齐领口-对折”动作数据,团队花了一整个下午,机械臂还报废了两个关节。
这就是具身智能数据采集的现实——贵到离谱,却不得不买。
目前,真机数据的市场价格已飙升至500-1000元/小时。乍看之下似乎不算夸张,但要知道,大语言模型训练可以从互联网上近乎零成本地抓取海量语料,而机器人需要的,是真实物理世界中“拿、放、走、抓、避障”等三维动作数据。这些数据无法从网页爬取,必须通过真实的机械臂、在真实的场景中、一遍遍地实际操作才能获得。
两者的获取难度,根本不在一个量级。
行业内部将这种困境戏称为“十万年难题”——要训练一个能应对复杂物理世界的通用机器人,理论上需要的数据量级,以当前采集效率计算,意味着天价投入。为了弥补这个巨大缺口,具身智能的数据来源形成了一座清晰的三层金字塔:最底层是互联网视频和人类行为数据,来源广泛但精度粗糙,几乎免费;中间层是仿真合成数据,成本低、可规模化,但始终存在“仿真与现实之间的物理裂缝”——再精妙的数字孪生也复现不了螺丝胶圈的弹性老化、纸箱受潮后的摩擦系数;金字塔顶端,则是真机数据,质量最精准,成本也最贵,却是人形机器人落地的绝对关键。
深圳人机沙龙上有一段精准总结:互联网语料只能让模型“看得见”,人类视频让它“看得懂”,唯有真机数据能让机器人“做得到”。 这解释了为什么即便价格高昂,真机数据依然供不应求——它不是锦上添花,而是从0到1的必需品。
那么,谁在为这些天价数据买单?
答案比想象中更狂热。觅蜂科技CEO姚卯青透露,当前需求方普遍处于“你有多少我就买多少,什么时候有马上要”的状态。买方主要分三类:一是大模型团队和头部机器人初创公司,他们需要高质量真机数据来训练落地模型,这是技术竞赛的核心弹药;二是在智能化转型中落后的传统工业机器人厂商,他们正通过购买数据服务试图弯道超车,避免被新浪潮彻底甩开;三是地方政府和产业园区,他们希望将手中的真实生产数据转化为可交易、可训练的数据资产,避免在产业链议价中处于弱势。
这是一场典型的“卖铲子”生意——在人形机器人真正大规模商业化之前,数据作为基础设施,正比终端应用更早地形成商业回报。 但这场狂欢背后,一个更尖锐的问题正在浮现:高价买来的数据,真的有用吗?

二、狂欢下的隐忧:定价乱局、质量陷阱与评价真空
当市场还在为每小时千元的真机数据买单时,一个更根本的问题正在浮出水面:数据量并非万能解药。
大语言模型的成功建立在相对清晰的Scaling Law之上——数据越多,模型越强。但在具身智能领域,这条定律的边界变得模糊。“数据是否越多就越好”本身,就是一个难以验证的命题。
Scaling Law失灵:为什么百万小时数据可能只是“数据废料”

极佳视界联合创始人朱政指出了一个被市场忽略的真相:当前行业使用的大多数数据,是在实验室或人工场景采集的,缺乏工业、家庭等真实场景的复杂性。更致命的是,标注过于简略。
在多模态时代,一张图可以有几千字标注,描述背景、前景和意图。但现在的视频数据,往往只有简单的动作标注,环境和任务描述严重不足。这意味着,即使积累百万小时数据,如果它们记录的只是“实验室里的完美操作”,而非“真实世界的混乱交互”,这些数据在训练中的价值将大打折扣。
它石智航的相关负责人进一步强调,数据生意的核心壁垒不是“采了多少小时”,而是数据是否真实、干净、可对齐,能否适配具体模型和本体。只看采集时间,不看效率和纯净度,没有任何意义。
百万小时级数据如果不够真实、不够干净,或者不能适配具体模型和本体,仍然难以直接转化为机器人能力。
缺乏统一“标尺”:数据纯净度、场景适配性与变现困境

定价乱局的背后,是整个行业缺乏统一的评价体系。
当前市场上,仿真数据与真实数据服务并存,定价从200元到1000元/小时不等,但价格并不能反映数据的真实价值。光轮智能CEO谢晨在智元合作伙伴大会上直言:数据的核心问题,不在数据本身,而在模型评价上。
没有足够开放、真实且可规模化落地的具身模型评价方式,企业就不知道用什么样的数据能够训练出好的模型。这形成了一个恶性循环:数据供应商不知道什么样的数据值得采集,需求方不知道如何评估数据的价值,交易只能在模糊的标准下进行。
这种评价真空也直接导致变现困难。创业团队不仅要承担高昂的采集成本,还需提前垫付清洗、脱敏、格式转换的“厨房租金”。一旦数据不符合甲方的隐形标准,整批数据可能直接报废——亿元投入瞬间沉没,成为行业最残酷的门槛。
三、从孤岛到资产:重复建设困局的破局之道
北京石景山、四川自贡、江苏无锡……具身智能数据中心在全国遍地开花,企业也在自建采集场。但全国政协委员赵晓光一针见血地指出:重复建设的隐患不可忽视。
各家为训练模型独立采集高度相似的数据,真实场景下一条高质量数据虽仅几十秒,却可能耗费数小时采集、清洗与标注。这种各自为战的投入模式,缺乏基本的经济性。
数据共享悖论:企业护城河与跨本体数据无法复用的双重阻碍
共享本是最优解,但现实存在商业与技术双重阻碍。
商业壁垒是明线。 数据是具身智能公司的核心护城河,开源意味着让竞争对手“吃到免费午餐”。尤其在工业场景,机器人在汽车工厂产线积累的数据涉及场景方的商业秘密,对外共享“等于把自己的生命线拿出来”。
技术壁垒是暗线,更为棘手。 即使企业愿意共享,跨本体数据也难以复用。不同构型机器人采集的数据,在传感器配置、控制模态上千差万别——同一场景的数据换一个机器人本体就可能失效。
这导致行业陷入“数据孤岛”困境:不共享则重复投入,想共享又面临商业与技术双重阻碍。赵晓光提出的解决思路是通过顶层设计推动数据交易流通,同时对涉及商业秘密的部分进行脱敏或加密处理。这需要建立数据产权与流通交易规则,让数据从封闭的私有资产变为可流通的生产要素。
激活“沉睡成本”:影子模式、产线日志与数据资产化的未来
更根本的破局之道,在于改变数据采集的成本结构。
当前“纯采集”模式难以持续——机器人保有量突破千台后,继续派工程师逐台采集会把现金流拖垮。深圳人机沙龙上提出的影子模式提供了新思路:让设备在正常服务中“边干活边回传”,通过轻量级SDK自动切片上传每次抓取、行走的传感器流。边际成本趋近于零,数据规模随保有量线性扩张。
另一个被低估的捷径是激活制造业的“沉睡金矿”。十年累积的质检图像、故障代码里隐藏着数百万条“动作—结果—奖惩”闭环,只需用时间对齐就能生成真机级轨迹与标签。谁先打通OT与IT的数据协议,谁就拥有降维打击级的先发优势。
千元级轻量采集套件的出现,更让分布式众包成为可能——维修工在工厂、农户在田间即可一键录制数据,平台按有效时长回购,把采集成本压到传统方式的百分之一。
但数据资产化的最后一公里仍待打通。尽管国家允许数据入表,银行却不敢接受“机器人抓取数据集”作为抵押。只有建立数据资产评级标准与保险兜底机制,让数据集拥有可量化公允价值,数据才能从硬盘里沉睡的成本,变成可流动、可增值的生产要素。