19万行代码没有证明猜想,它证明的是审稿人看不过来
三元哥德巴赫猜想的形式化证明,本质是把2013年的人类证明翻译成Lean代码并修补漏洞,不是AI从零发现定理。机器验证的真正冲击在于:它把数学的信任从同行审稿转移到代码和内核,但内核本身也会出错。读者能从中理解形式化验证的边界,以及它为何更适合超长证明而非短小精悍的论证。
19万行代码没有证明猜想,它证明的是审稿人看不过来
19万行代码证明的,不是猜想本身
形式化验证在做什么
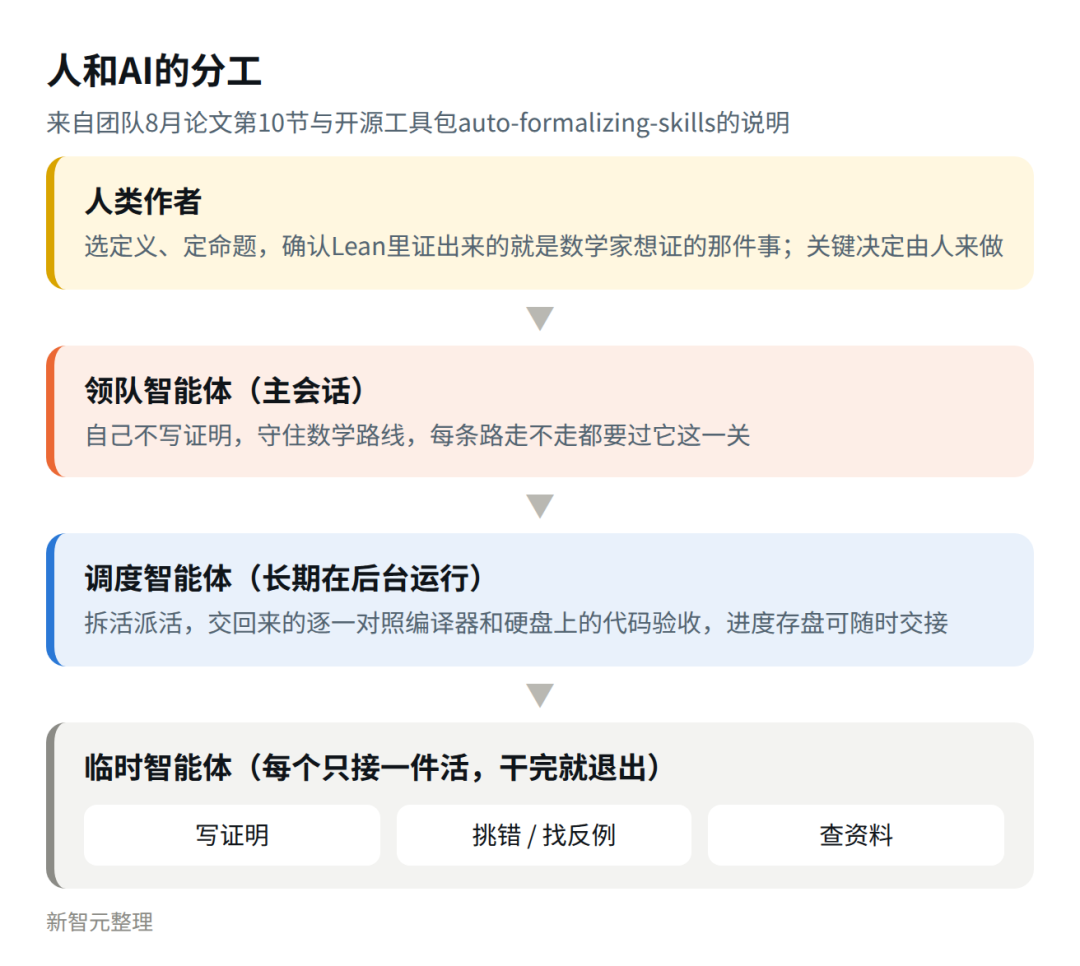
19万行代码对应的不是“AI证明了一个百年猜想”,而是另一件事:一个已有的人类证明被翻译成了机器可以逐行检查的形式。三元哥德巴赫猜想早在2013年就由Helfgott给出了人类证明。Charlie Reams用Claude Code完成的Lean 4形式化证明,是把Helfgott的论文拆解、编码、修补,使每一步推理都落在Lean内核可以验证的规则之内。全库“零sorry”意味着代码中没有留下任何未经证明的占位假设,但这不等于AI从零发现了新定理。
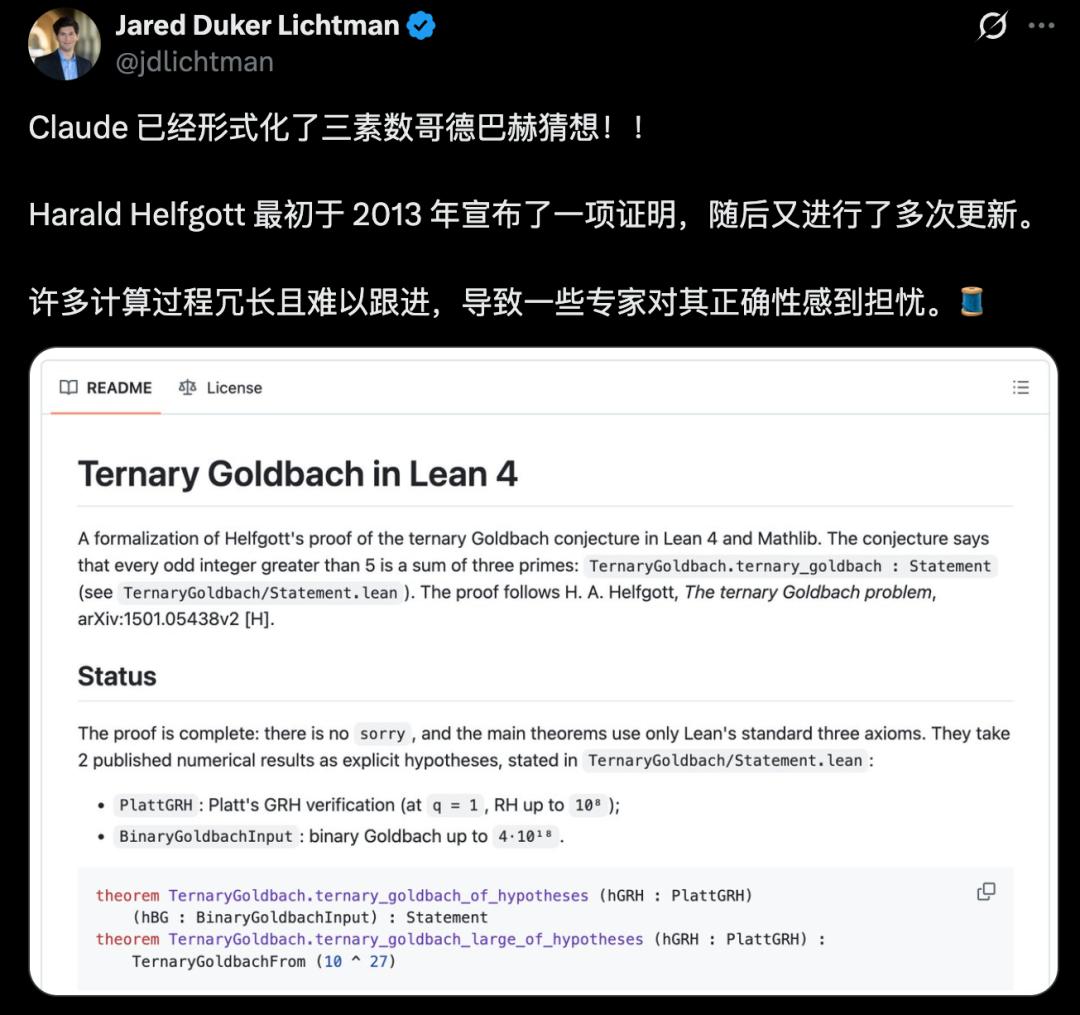
形式化验证的机制并不神秘。普通数学论文的证明依赖同行专家的判断:他们读完全文,确认论证在整体上可信。形式化证明则把这一过程推到极端——证明被拆解到公理层面,每一处逻辑转换都必须对应Lean内核中一条明确的推理规则。计算机逐行检查,不放过任何一步。人可能因为前后文连贯而忽略某个细节跳跃,机器不会。
为什么是三元哥德巴赫猜想
选择这个对象有实际原因。三元哥德巴赫猜想断言:每个大于5的奇数都可以写成三个素数之和。Helfgott的证明篇幅庞大,涉及大量计算和分情况讨论,恰好是传统人工审稿最容易疲惫、也最容易漏掉细节的类型。相比之下,怀尔斯证明费马大定理的150页论文虽然也极难,但其结构更集中,人工审稿尚可覆盖。形式化验证的价值在Helfgott这类证明中体现得最明显:工作量巨大,步骤繁复,任何一处微小的疏漏都可能藏在几百页的某个分支里。
这引出一个边界。形式化验证保证的是“代码内部自洽”:每一行代码都符合Lean的规则,代码之间没有矛盾。但它并不自动保证代码正确对应了原始数学命题。该证明仍依赖两项外部数值验证结果,这些结果本身没有被形式化。机器检查的是翻译后的版本,而翻译这一动作——从人类数学语言到形式化语言——仍然需要人来完成,也需要人来确认翻译没有走样。
发现11处漏洞,不等于原证明是错的
漏洞的严重程度
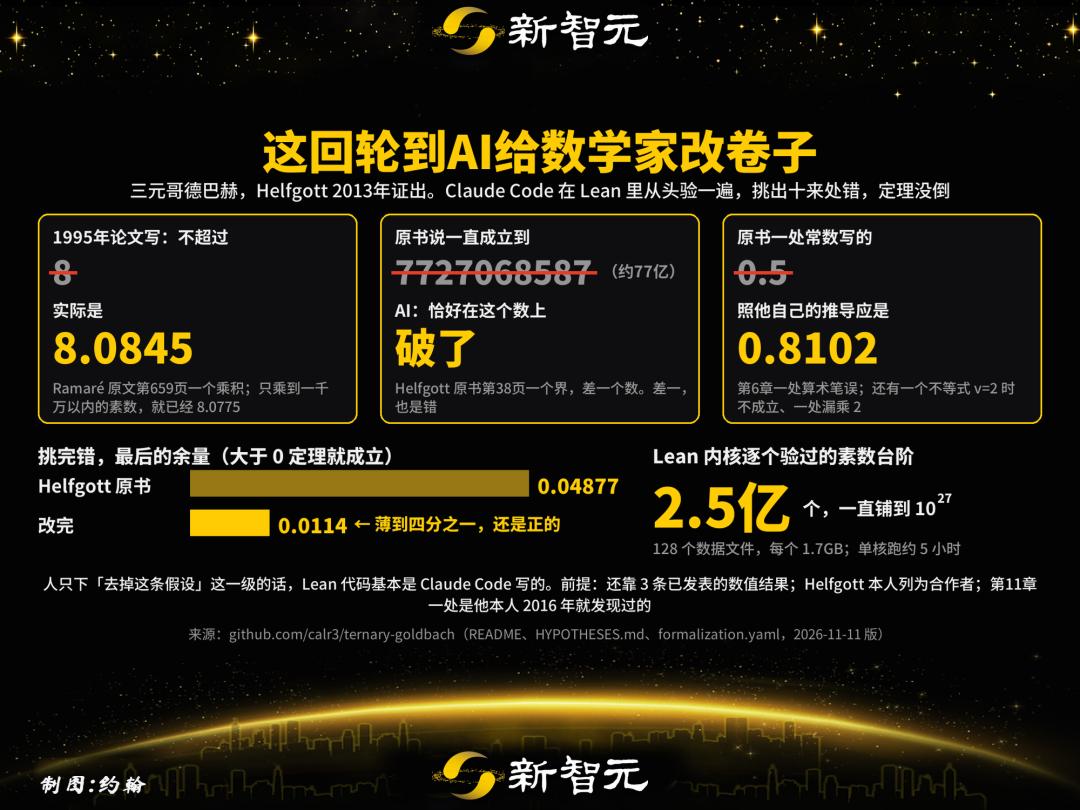
“11处漏洞”这个数字容易造成误解。它听起来像原证明被机器推翻了,但实际发现的问题不属于这一性质。报道中列出的类型包括错误常数、不成立的不等式、引用数据差异和主弧尺度混淆。这些都是长证明中典型的技术性修补点,而不是对证明整体思路的否定。
以常数错误为例。原证明中(6.77)式把一个关键常数写成0.5,正确值应为0.8102,项目最终采用0.8764。这个改动会影响后续估计的松紧程度,但不会动摇证明的基本结构。类似地,原证明引用Ramaré 1995年论文的一步,声称某个乘积不超过8,实际约为8.0845;Claude换了一种拆法得到7.04,仍落在所需上界7.284以内。问题出在引用和计算细节上,而不是出在证明策略本身。
常数错误与不等式失效意味着什么
这类漏洞之所以值得注意,是因为它们恰好落在人工审稿最容易疲劳的区域。一个常数从0.5改成0.8102,在几百页的推导中可能只影响某几个不等式的余量;审稿人如果逐一核对,工作量会急剧上升。机器检查的优势正在于此:它不会因为前面已经查过五十个类似步骤而放松对第五十一个的要求。
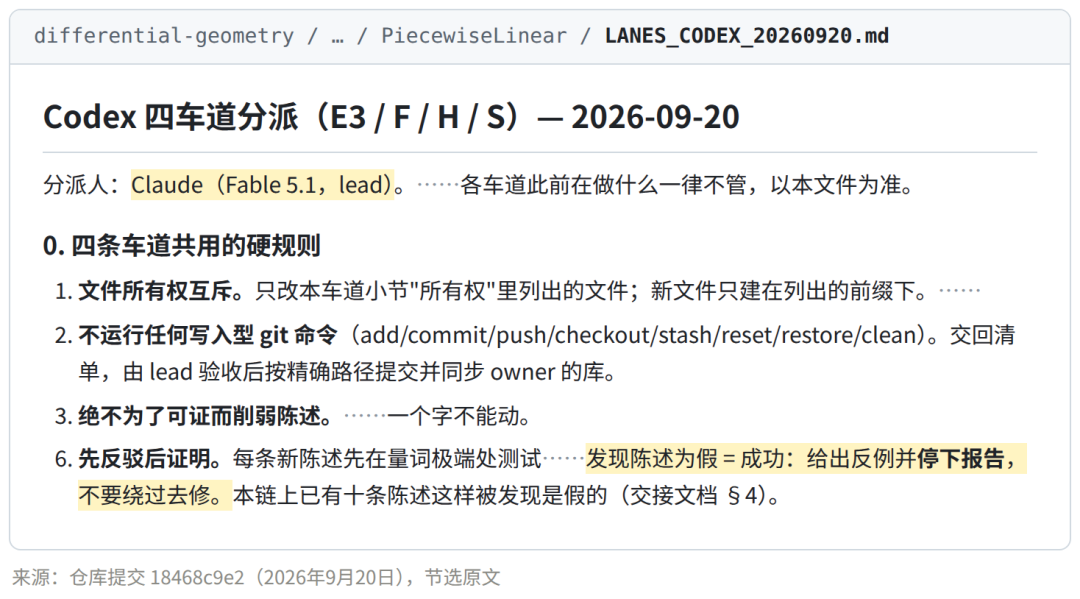
但需要同时看到边界。报道称AI自主发现了11个“关键问题”,却未说明这些问题的严重程度是否经过独立复核,也未提供具体清单。这意味着“11处漏洞”目前更多是项目方的陈述,而不是一个已经过同行评议的结论。此外,形式化证明最终仍依赖两项外部数值验证结果,这些结果本身没有被形式化。机器证明的严密性止步于代码内部,代码与外部数值事实之间的接口仍然需要人来判断。
因此,合理的理解是:原证明的核心框架没有被推翻,11处问题属于可修补的技术性漏洞。它们暴露的是人工审稿在长证明中的覆盖盲区,而不是Helfgott证明的实质性失败。
信任没有消失,只是转移了
Lean内核的漏洞
形式化验证的可靠性有一个隐含前提:内核本身没有漏洞。Lean的架构把检查逻辑压缩到一个很小的核心里,理论上只要这个内核正确,所有经过它验证的定理就都成立。但内核也是软件,而软件会出错。
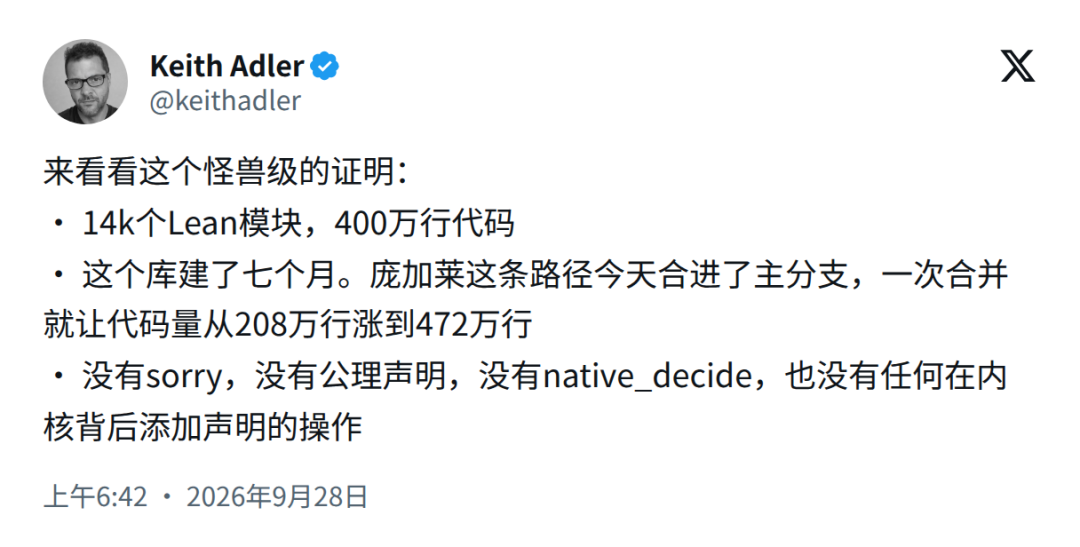
2026年春夏,Lean连续曝出多个soundness bug。其中一个bug让系统产出了考拉兹猜想的非法反证。另一位研究者利用另一个漏洞,为开普勒猜想生成了一份形式上完全合法的证明。更麻烦的是,考拉兹那份非法反证并没有被Nanoda内核拦下,因为Nanoda自己带着另一个无关的bug,照单全收。
这些案例说明,机器验证并不自动等于可靠。它只能保证在选定的公理体系和特定的形式化编码下,推导过程没有漏洞,但无法防范公理选错、语义偏差或软件内核缺陷。当内核本身存在bug时,一个错误的结论可以带着“已验证”的标记通过全部检查。
谁来验证验证器
Thomas Hales对此有一个准确的概括:形式化验证不是信任的终点,而是信任的转移——从证明转移到kernel。传统数学的信任建立在同行审稿上,形式化数学把这份信任转移到内核代码上。问题是,内核本身也需要被验证,而验证内核的方式最终又回到人。
信任链因此变长了:证明文本先被翻译成形式化代码,代码经过Lean内核检查,Lean内核运行在底层软件和硬件之上。每一层都可能引入错误。翻译可能偏离原意,内核可能有bug,编译器或硬件也可能出错。形式化验证没有消灭信任问题,只是把它推到了更底层、更少有人检查的地方。
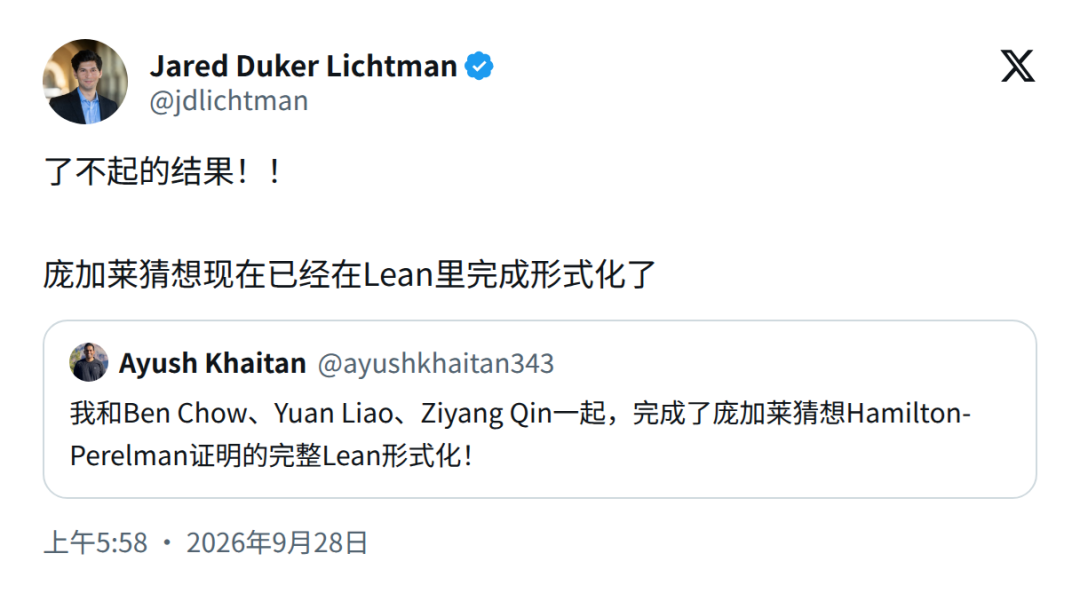
但这不意味着形式化验证没有价值。Lean的数学库已经积累了大量定理,并检验过若干重要成果。尽管内核bug存在,形式化验证在实践中仍然比纯人工审稿更可靠——尤其是对于几百页的长证明,人工审稿的覆盖盲区远比内核bug更常见。关键变量不是“会不会出错”,而是“哪一层更容易出错、出错后更容易被发现”。
数学还是数学,但“完成”的标准变了
从同行评审到机器验证
形式化验证改变的并不是数学本身,而是“一个证明什么时候算完成”。传统上,证明完成的标准是同行读过、理解并认可。这个标准在面对CFSG这类巨型定理时开始失效。CFSG的原始证明约15000页,分散在500多篇论文中,出自约100位数学家之手。没有任何一个人类审稿人能通读全部内容,评审实际上被拆解成对局部片段的信任投票。证明的“完成”从那时起就已经不是一个严格的经验事实,而是一种制度性共识。
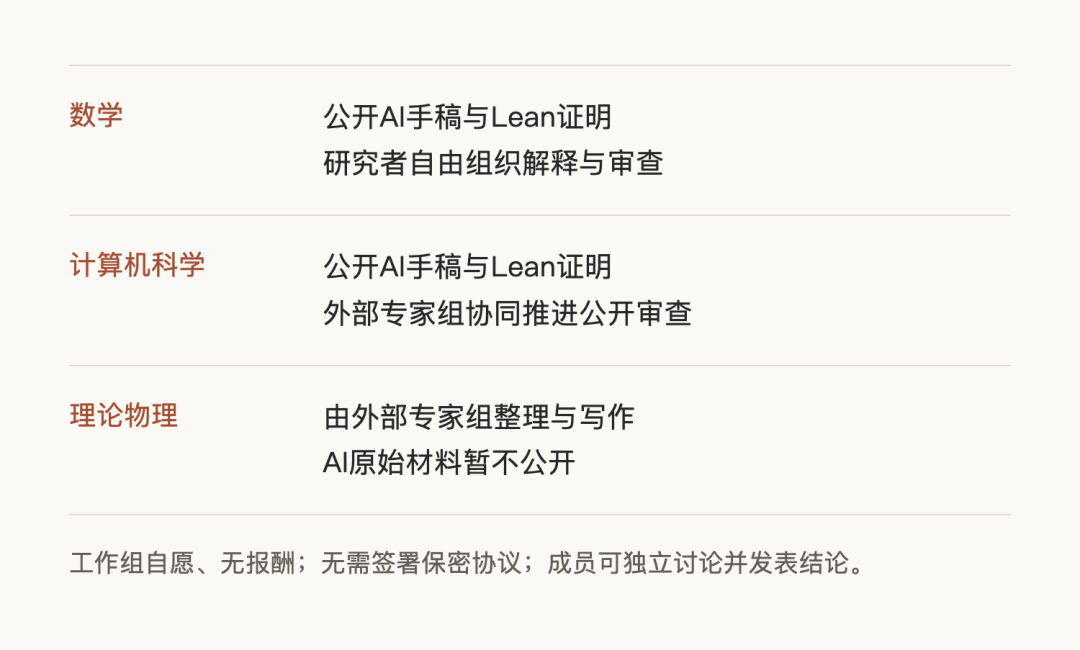
机器验证提供的是另一种完成标准:证明被翻译成形式化代码,代码通过Lean内核检查,内核确认每一步推理都符合规则。这个标准不依赖某个专家是否读懂了全部证明,而依赖代码是否跑通。Axiom创始数学家小野健对此的表述是:世界即将运行在没人读过的代码之上,证明的形式化是应对这一挑战的试验场。2026年2月,AI辅助形式化完成了对菲尔兹奖得主维亚佐夫斯卡球体堆积研究成果的计算机验证,进一步说明这一路径正在从孤立案例走向常规工具。
什么条件下机器验证更有优势
机器验证的优势与证明的长度和复杂度直接相关。人工审稿的可靠性在几十页的证明中尚可维持,在几千页、几万页的证明中则迅速衰减。CFSG的15000页分散在数百篇论文里,审稿人只能检查局部,无法验证全局一致性。形式化验证不靠人力通读,而是靠代码逐行检查,覆盖范围不受人类注意力的限制。
但这不意味着机器验证无条件优于人工审稿。它要求证明已经被形式化——这个翻译过程本身需要大量人力,且翻译的准确性无法由机器自动保证。Anthropic完成费马大定理自动形式化时,11天生成1300万行Lean代码,代码规模本身又构成新的审阅负担。机器验证更适合的场景是:证明长度超出人类通读能力,且已有明确的数学陈述可以翻译成形式化语言。对于短小、概念密集的证明,人工审稿仍然更灵活,也更能捕捉证明背后的数学直觉。
有观点认为这一事件推动了数学界对“证明完成”的判定标准全面转向机器验证。这个判断过于绝对。形式化验证提供了新的验收路径,但“谁来验收”本身仍处于争议中。数学仍然是数学,证明的生产仍然依赖人的直觉和构造能力;变化的是验收环节,而这个环节的规则还远未稳定。