AI能证明定理,但“证明”正在变成两种东西
从Claude完成费马大定理形式化到智能体88小时冲击千禧年难题,AI在数学证明上的能力已不容置疑。但多位数学家的判断指向同一个关键区分:AI擅长在已知框架内做广度搜索和验证,人类的价值在于提出新问题、引入新概念、判断什么值得证明。证明正在分裂为“机器可验证的证明”和“人类可理解的证明”,而科学进步依赖的恰恰是后者。
AI能证明定理,但“证明”正在变成两种东西
证明的“结果”正在与“过程”脱钩
从19万行到1300万行:机器证明的规模跃迁
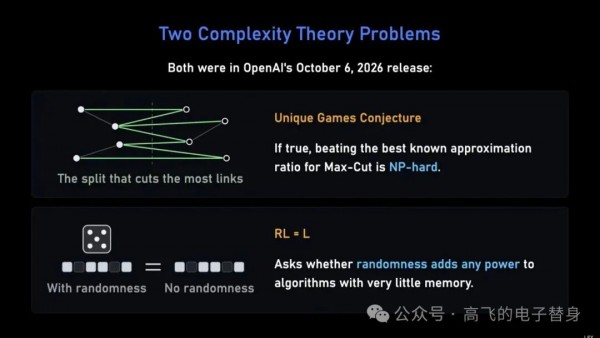
过去两年,AI在数学证明上取得的进展有一个共同特征:规模急剧膨胀,而验证方式越来越依赖机器本身。2026年4月,北京大学董彬团队用AI框架攻克交换代数中的安德森猜想,并完成了19000行形式化验证。同年9月,Anthropic用Claude完成费马大定理的Lean形式化证明,代码总量达到1300万行,耗时11天。OpenAI同期在GitHub上放出722篇AI生成的数学论文,其中包含对唯一博弈猜想的证明。
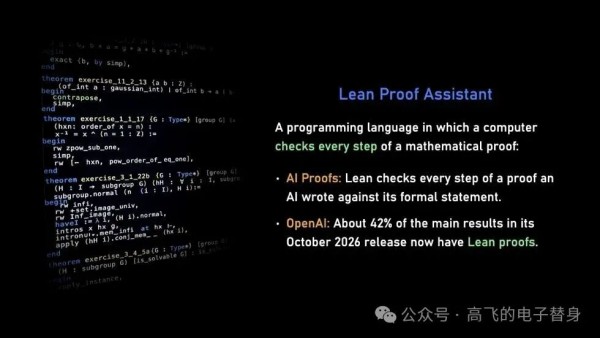
这些数字放在一起,指向一个明确的变化:证明正在变成一种可以被大规模生产、逐行检查的符号对象。Lean这类形式化验证软件的作用,是让计算机确认每一步推理在逻辑上无懈可击。1300万行代码意味着,没有任何一个人类数学家能够通读这份证明,更不用说在传统意义上“理解”它。但机器可以检查它,而且检查得比人类更可靠。
形式化验证解决的是信任问题,不是理解问题
这里需要做一个区分。形式化验证回答的问题是“这个证明有没有逻辑漏洞”,而不是“这个证明为什么成立”或“它揭示了什么新的数学结构”。前者是一个信任问题,后者是一个理解问题。AI目前大幅推进的是前者。
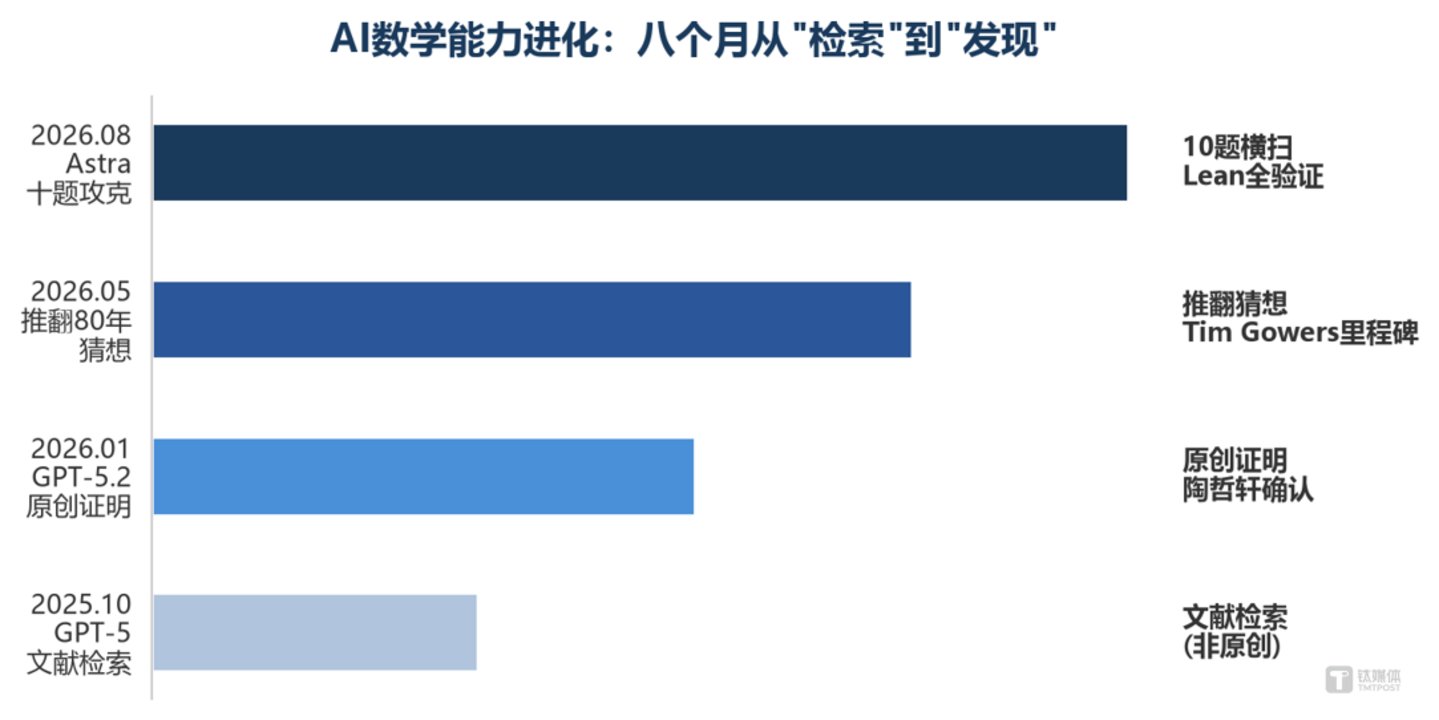
一个值得注意的反例来自GPT-5 Pro。OpenAI内部测试显示,它在某些任务上表现出超出简单搜索的独立推导能力,生成的证明并不只是已知框架内的排列组合。这说明“AI只会做形式化验证”的判断过于绝对。但即便存在这样的例外,它仍然没有改变一个基本事实:当证明的规模超过人类阅读能力时,数学共同体对证明的接受方式已经发生了实质性改变。
过去,一个证明被接受,意味着足够多的数学家读懂了它,并能在自己的工作中使用其中的思想。现在,一个证明被接受,可能仅仅意味着机器验证通过,而没有人真正读过它。这两种“接受”对应着两种完全不同的知识形态。前者改变人类对问题的理解,后者只确认一个命题为真。AI在数学证明上的突破,核心不在于“更聪明”,而在于它把后一种形态的生产成本降到了前所未有的低点。
数学家的共识:AI没有发明过任何一个新概念
“把边界点拉出气球之外”这件事,AI还没做到
判断AI在数学中的位置,有一个比“它能证明多少定理”更具体的标准:它是否引入过任何一个新的数学定义。截至目前的答案是,没有。在一次播客录制中,三位受访数学家明确把这一点作为共识保留下来。人类数学家能做的一件独特事情,是引入一个全新概念,把一个新的边界点拉出气球之外,然后从这个新点出发展开探索。AI还没有做到这件事。
这个观察之所以值得认真对待,在于它是可检验的经验事实,而不是对“机器是否拥有创造力”的哲学表态。过去几年,AI在定理证明、猜想验证、反例搜索上都产出了大量结果,但所有这些结果都发生在人类已经划定的问题空间内。新定义之所以更难,是因为它改变的不是答案,而是问题本身。一个成功的定义会重新划分已知与未知的边界,让此前无法表述的对象变得可以讨论。AI的搜索和推理能力再强,也仍然是在既有定义构成的坐标系里移动。
丘成桐的判断与此一致。他认为AI可以生成海量证明,却无法像人类数学家一样提出真正有洞察力的新问题,也无法拥有人类在长期研究中沉淀的数学直觉。这种直觉融合了经验、审美和创造力。他更进一步说,机器创造能力比不上人类,人工智能不懂开创数学的前沿,所以不用怕。这些表述带有个人色彩,但核心判断并不孤立:AI目前没有发明过新概念,是一个被多位数学家独立确认的事实。
丘成桐与陶哲轩的分歧点其实很小
丘成桐和陶哲轩常被放在对立位置,一个强调人类不可替代,一个积极拥抱AI工具。但细看两人的表述,分歧并没有表面那么大。
丘成桐谈的是“开创前沿”和“提出新问题”,这是数学研究中最上游、最依赖概念创新的环节。陶哲轩谈的是“广度”与“深度”的分工:AI擅长广度,可以大规模生成、验证和组合解法,发现人类专家遗漏的可能性;人类守住深度,负责理解过程、筛选问题、解释洞见,把成果消化成可传承的知识。两人都没有声称AI会在所有环节取代人类,也都承认AI在证明生产上的效率优势。区别只在于,丘成桐更强调边界的存在,陶哲轩更愿意探索边界可以向外移动多少。
陶哲轩同时提出一个警示:如果AI能在人类不深度参与的情况下解决最困难的问题,可能会削弱人类对数学的理解。他用远足与直升机的类比说明这一点——直升机直接把你送到瀑布,你看到了目标,却学不到如何到达那里,也看不到沿途的其他有趣现象。这个类比针对的正是“结果正确但理解缺席”的风险。也就是说,陶哲轩对AI的开放态度并不等于放弃“理解”在数学中的核心地位。
另一个来自应用数学领域的观察补充了同一判断。董彬在谈到人机协同猜测函数关系的研究模式时指出,这种方式更适用于“单点突破”,从局部解决某些具体问题,能使用这种方法的问题比较有限。单点突破意味着AI可以在一个已经被定义好的局部问题上做到极致,但它不负责重新定义这个局部属于哪个更大的结构。
把这些判断放在一起,可以看到一条清晰的分界线:AI目前的工作方式,是在人类划定的概念空间内做高强度搜索和推理。它的产出可以改变人们对某些命题真伪的认知,但尚未改变数学概念本身的边界。这个边界不是哲学上的不可逾越,而是当前技术路径下的经验事实。
“找路”的真正含义:判断什么值得证明
张宏说的“找路”不是修辞,是科研分工的实质
张宏在生命科学论坛上的表述指向一个具体的工作场景:AI可以在结构生物学、药物筛选等环节显著提升效率,但提出问题、判断因果、探索未知仍然依赖科学家。这里的“找路”不是某种玄妙的直觉,而是对研究路径的选择——在大量可能的实验方向中,决定哪一个值得投入资源,哪一个即使做出来也不会改变领域的基本理解。
这种分工在生物技术领域有可量化的对照。单克隆抗体技术的传统流程通常需要四年左右,在AI与生物技术协同下,从筛选到给患者用药的时间被压缩到九十天。蛋白质折叠问题困扰生物学界半个世纪,AI介入后从早期探索到关键突破只用了约两年。这些数字说明的是执行效率的跃升,而非问题本身的生成。抗体筛选和蛋白质结构预测都是已经被清晰定义的任务,AI压缩的是从任务定义到结果产出之间的时间。任务定义——为什么是这一种抗体、为什么这个折叠问题值得解决——发生在AI介入之前。
当证明变得廉价,问题的价值反而上升
如果把“给出答案”视为一种生产活动,AI带来的变化是答案的边际成本大幅下降。过去,一个数学证明或一项实验结论的产出需要耗费一个研究者数月甚至数年的劳动;现在,在已被定义清楚的问题上,AI可以在极短时间内生成候选结果。经济学上的直接推论是:当某种商品的供给急剧增加、价格趋近于零时,与之互补的稀缺品价值上升。在科研中,与“答案”互补的稀缺品是“问题”——更准确地说,是判断哪个问题值得投入、哪个方向可能改变现有理解的能力。
这解释了为什么人类角色正在从“解题者”向“选题者”转移。解题能力曾经是研究者核心竞争力的主要来源,因为它稀缺。当AI在特定类型的解题上表现出远超人类的速度和规模时,解题本身不再构成壁垒,而“选择解什么题”的权重上升。光明网一篇评论提出的人机协作范式与此一致:人类数学家负责提出猜想、开辟方向,AI负责繁琐的推导和验证。这个分工框架的价值不在于它是否已被学术共同体普遍接受,而在于它准确描述了当前技术条件下效率最大化的配置方式。
但这并不意味着“找路”完全不可被AI辅助。周伯文提醒,AI给出答案的前提是人类科学家在定义问题、设置任务、积累数据乃至构建思维链。这个判断同时包含两层含义:一方面,它确认了人类在任务定义环节的不可缺位;另一方面,它也暗示“定义问题”本身可能被部分工具化——如果思维链可以被构建,那么构建思维链的某些环节也可能被AI参与。人类对方向的判断目前仍是主要输入,但它不是一块不可分割的整体,而是一个可能被逐步拆解的过程。
因此,“找路”在AI时代的准确含义不是“只有人能做”,而是“目前还没有被AI成本有效覆盖的环节”。它依赖的不是神秘的天赋,而是对领域整体图景的把握和对“什么结果会改变理解”的预判。这两种能力恰恰无法通过扩大计算规模直接获得,因为它们需要的是对知识结构中缺口位置的感知,而非对已有路径的快速执行。
当证明不再稀缺,理解反而成了硬通货
Kontorovich的担忧:活在数据中心里的数学没有价值
Alex Kontorovich对AI证明的批评集中在一点:纯数学定理如果只以数据中心里的0和1存在,对人类并没有价值。数学的价值在于它活在人类头脑中。这个判断不是对技术进步的否定,而是对“证明”功能的重新界定。一个被机器验证为真的命题,如果没有进入任何人的理解结构,没有改变任何人对某个数学对象的感知方式,它在认识论上就是空的。它确认了一个事实,却没有产生知识。
这种区分在科研评价中同样成立。当证明的产出成本急剧下降,“发表了一个新定理”本身不再自动构成贡献。判断一项数学工作的价值,越来越需要追问它是否让某个领域的结构变得更可理解,是否为后续问题提供了新的概念工具。可验证性保证了正确性,却无法保证意义。意义始终是相对于人类理解而言的。
教育正在被迫回答一个它一直回避的问题
罗智泉的判断更为直接:在AI时代给家庭作业打分已经毫无意义,因为无法知道答案是如何生成的。真正可靠的试金石是面对面交流——学生站在教师面前展示,当场回答问题。这个立场把教育评估的核心从“产出是否正确”推向了“理解是否真实”。当AI可以批量生成正确答案时,评估体系被迫去测一个更难量化的东西:一个人能否用自己的语言解释为什么,能否在追问中暴露理解的边界。
徐文强从培养标准的角度补充了同一层意思。过去数学教育侧重训练计算能力和解题能力,这些恰恰是AI完成得更快更好的部分。培养标准必须提升到新的维度,学生最需要守住的是好奇心、独立思考和开放交流。这三者有一个共同特征:它们都无法通过标准化的书面产出来验证,只能在持续的人际互动中显现。
陶哲轩的提醒构成了必要的对冲:善用AI的数学家会取代不善用的。理解能力并不因为AI的存在而自动保值,它同样需要借助工具放大。拒绝AI不等于守护理解,反而可能在效率上被边缘化。丘成桐的立场与此一致:不赞同劝阻学生使用AI,但学生必须诚实面对自己究竟理解了多少,个人学术功劳取决于实际投入。两条线在此交汇——工具可以自由使用,理解的检验标准却不能放松。
当证明不再稀缺,能够判断证明是否重要、能否解释它为什么成立、能否基于它提出下一个问题,这些能力反而成为更稀缺的资源。它们不在AI的产出清单上,因为它们发生在证明完成之后,发生在人与人之间。