AI做材料,卡在“下一步做什么”
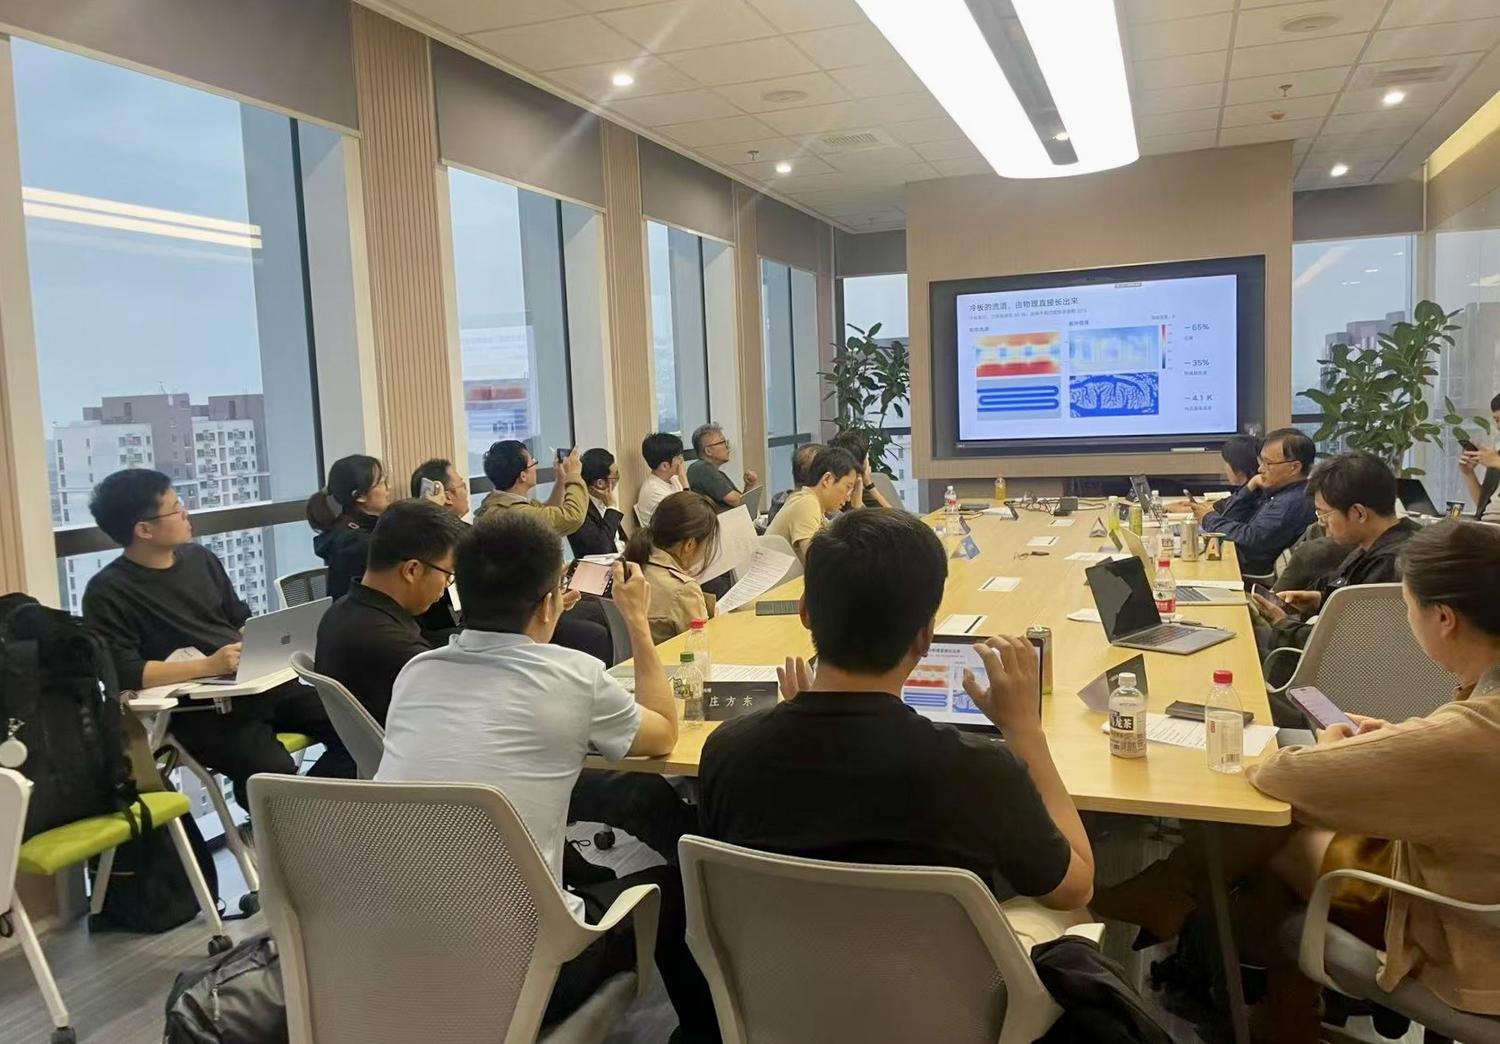
一场三小时闭门会显示,AI4M的进步集中在文献数据提取和结构识别,但与会者反复指向同一个分界:模型能读懂结果,不等于知道下一步该做什么。可合成性、工艺窗口和失败数据被提前纳入设计,才是缩短从候选到可用材料距离的关键。
AI做材料,卡在“下一步做什么”
模型变强了,但只解决了“读”的问题
基础模型变强,在材料研发中最直观的变化发生在文献处理环节。一位与会研究者提到,从论文图表里提取曲线数据,这项工作几个月前还需要人工辅助,现在基础模型已经能直接完成。变化不是渐进式的,而是在一个很短的时间窗口内,某个具体环节从“人机协作”跳到了“模型独立完成”。
这个例子把“模型变强”从一个模糊的行业判断,落成了一件可以被验证的小事。曲线提取是材料信息学里的典型前端任务:论文里的应力-应变曲线、热重曲线、阻抗谱,往往只以图片形式存在,要把它们变成可计算的数值,过去需要大量人工介入。模型能直接读图、识别坐标轴、还原数据点,意味着文献中积累的实验结果可以更快进入数据库。
但这一跃迁的边界同样清楚。它解决的是“读”的问题——从已有文献中把信息提取出来,并不涉及“下一步做什么”。一个候选材料的性能数据被准确提取,不等于它能在实验室里被合成出来,也不等于合成条件能够复现。材料研发链条中,文献提取只是最前端的一环,后面还有配方设计、工艺选择、设备约束、失败归因。模型在这一环上变强,真实但不构成对整个流程的替代。
这一观察来自个别研究者的经验,没有给出具体模型、文献范围或任务类型。它说明基础模型在特定信息提取任务上确实进步了,但不能据此推断所有材料数据问题都已解决,更不能把“读文献更快”等同于“研发更快”。
识别出晶体结构,不等于知道该合成什么
自主实验室经常被当作材料研发自动化的终点,但闭门会上的讨论给出了一个更窄的边界。识别图谱中的复杂晶体结构,与决定接下来合成什么,是两项不同的任务。前者表现再好,也不能直接证明后者已经具备。
这两项任务的区别不在难度,而在责任。读懂一张衍射图谱,本质上是模式识别:输入信号,输出一个晶体结构标签。模型可以在这件事上超过多数人类专家,因为它面对的是相对封闭的答案空间。决定下一轮实验则不同。它要求把当前结果翻译成一个可检验的假设——换一种前驱体、调一次退火温度、还是放弃这条路线——并且承担这个选择可能完全无效的后果。真实样品有噪声、混相和仪器差异,专家对标签也可能有分歧。关键是能否根据结果安排下一轮实验,再用实验检验判断,榜单分数不能代替这个过程。
所以,自主实验室的关键分界不在识别准确率,而在下一轮实验由谁、根据什么证据来决定。一个系统可以非常擅长从图谱中辨认出已知结构,却对“接下来该试什么”没有任何主张。反过来,一个决策能力尚不完善的系统,也可能在识别任务上持续进步。两者可能在不同系统中分别发展,不能把前者的表现当作后者已经成熟的信号。
候选方案越多,离可用材料未必越近
候选方案的数量增长,并不自动等于离可用材料更近。闭门会上的讨论把这一点讲得很清楚:材料研发需要同时回答两个问题——性能为什么成立,以及现实中怎样把它做出来。如果设计阶段只盯着性能指标,候选结构当然可以不断生成,但它们可能在合成或放大阶段被淘汰。可合成性、工艺窗口和应用条件应当更早进入设计循环,否则前期计算投入会被浪费。
这条因果链并不复杂。一个分子或晶体结构在计算上显示出优异的导电性、稳定性或催化活性,只说明它在理想条件下可能成立。实验室里要面对的是前驱体是否买得到、反应是否可控、产物是否单一、放大后热传递是否均匀。任何一个环节不满足,纸面上的性能就无从兑现。讨论中提到的“从候选到可用材料的距离”,指的正是这段从结构到实物的路程。候选方案增加,只是起点变多;如果筛选标准没有把可制造性纳入,距离本身并不会缩短。
并非所有早期筛选都需要完整工艺参数。在研发的某些阶段,先排除明显不可行的结构——比如合成路线过于复杂、原料成本过高或稳定性明显不足——已经足够。前置程度取决于具体阶段:发现阶段可以粗筛,开发阶段则必须把工艺窗口作为硬约束。问题不在于是否前置,而在于前置什么、前置到什么程度。把可合成性完全留到后期,等于把最大的不确定性推迟到成本最高的环节。
没有失败记录的数据资产,喂不出可靠的AI
制造业规模并不自动转化为数据优势。中国工厂多、产业链长,材料数据的积累潜力确实存在,但现场讨论反复指向一个更具体的问题:大量记录分散在不同部门、不同格式里,失败样品与实验记录之间缺乏可关联的标识。同一配方、同一批人,换一条产线也可能得到不同结果。如果数据只能说明“某个配方在某个时间点测出了某个性能”,而无法回溯到当时的工艺参数、设备状态和样品处理过程,这些记录对AI训练的价值就很有限。
问题不在于数据量不够,而在于数据结构不完整。材料数据资产不能只有配方和性能,还要记录工艺、设备、样品及失败过程。失败数据尤其关键。一个模型如果只见过成功案例,它学到的是“什么条件下可能成功”;只有同时见过大量失败案例,并且知道失败发生在哪个环节,它才可能学会“什么条件下大概率不行”。后者对筛选候选方案的作用往往更直接。
数据可信度是另一层风险。闭门会中有嘉宾分享了一次合作经历:企业负责人十分支持,但具体研发负责人提供了假数据,合作最终没能推进。高层的信任不能代替执行层的配合。这个案例只是单一嘉宾的分享,未披露企业、项目或时间信息,不能据此推断行业数据质量普遍如此。但它暴露了一个真实的人为风险:当数据治理的激励不足,或者研发人员担心真实失败记录会影响考核时,数据链条可能在最前端就出现失真。AI不会识别这种失真,它只会把假数据当作真实经验来学习。
自动化实验室的账,不能只看单步演示
企业愿意为什么付费,最终要落到执行层面。闭门会中有企业回顾了早期评估高分子自动化方案的经历:设备投入不低,实际通量却未必优于熟练的人工操作。这个判断来自单一企业的早期经验,不能推广为对自动化路线的否定,但它指出了一个容易被忽略的成本项——自动化设备本身不自动带来效率,只有当它在长流程中减少了人工干预、降低了批次间波动,投入才可能被摊平。
现场对自动化实验室的讨论也指向同一问题。单步演示成功,不等于长流程能稳定运行。移液动作结束,不代表液体已经完全转移;高黏度材料还涉及搅拌、转移、成膜等环节,任何一步的偏差都会在后端累积。自动化方案的价值,不在于机械臂能否完成一个漂亮动作,而在于失败发生时能否被定位、记录并用于下一轮改进。这正是当前多数系统尚未证明的能力。
这也解释了为什么垂类机会的讨论最终落在模型之外。材料体系差异大、真实数据稀缺、工艺和实验条件难以统一,模型能力再强,也无法替代对特定材料体系和产线条件的理解。企业愿意付费的,不是更聪明的预测,而是能稳定产出可复现结果的能力。在这一点被证明之前,AI4M的商业模式仍会停留在项目制和小规模验证阶段。