豆包把AI搬进21个工位,职场人真正要补的不是提示词
豆包工作上线21个职业工作台,核心变化不是AI技能变多,而是职业能力被预先打包,专业工作的门槛从“会不会用AI”转向“能不能判断AI输出”。文章拆解金融、医疗、教育三个场景,说明预置技能如何同时制造效率与过度信任,并给出三个校验问题帮助读者形成自己的判断。
豆包把AI搬进21个工位,职场人真正要补的不是提示词
工作台真正改变的不是效率,是谁来定义“专业”
从聊天框到工位,AI第一次有了职业身份
豆包工作上线“工作台”功能,首批覆盖金融、医疗、教育、创意设计等21个专业场景。这个动作本身不构成新闻——AI能写报告、能看片子、能出教案,早已不是新鲜事。真正值得拆解的,是产品形态上的一次位移:AI从通用聊天框里被搬出来,放进了按职业划分的固定空间。
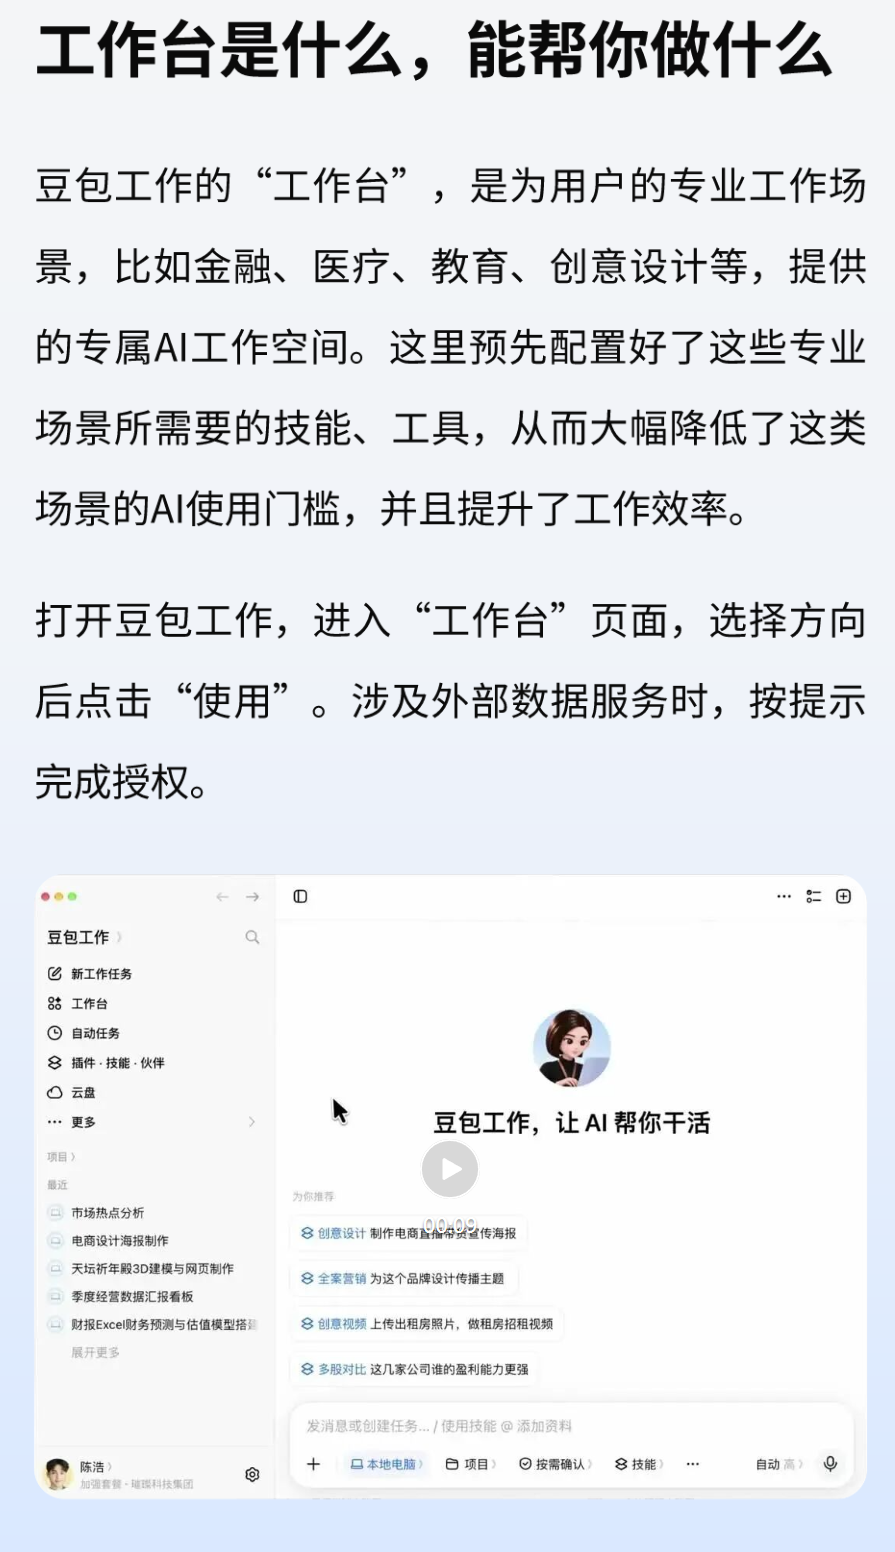
在聊天框里,用户必须自己描述任务。一个金融分析师要处理财报,得先想清楚让AI做什么、给什么格式、用什么口径;一个医生要整理病历摘要,同样需要先写一段足够精确的指令。通用模型的输出质量,很大程度上取决于提问者能不能把需求说清楚。工作台改变了这个前提。据豆包工作官方介绍,工作台是“为用户的专业工作场景提供的专属AI工作空间”,金融、医疗、教育等场景所需的技能和工具已预先配置,用户不必再逐项挑选。
这意味着AI第一次在产品层面获得了职业身份。它不是被用户临时调用,而是以“金融工作台”“医疗工作台”的形态预先存在,带着厂商对某个职业需要什么技能、接什么数据、走什么流程的具体判断。用户打开的是别人已经搭好的工位,而不是一块空白画布。
预置技能的本质是预置边界
把技能预先打包,表面看是降低使用门槛,深层作用却是划定边界。厂商决定了一个“金融工作台”里应该有什么、不应该有什么,哪些数据接口值得接、哪些流程可以自动化、哪些环节必须留给人。这个决定一旦被产品化,就会反向塑造使用者对自身工作的理解。
对初入行者,预置边界有实际价值。它提供了一套可参照的工作框架,减少了从零摸索的成本。对资深从业者,问题则复杂得多。21个模板能否覆盖金融、医疗、教育内部的巨大差异,本身存疑。一个做二级市场交易的金融从业者和一个做信贷审批的金融从业者,对“金融工作台”的期待几乎不可能重合。厂商预置的技能包越具体,就越可能在某类用户眼里显得多余,在另一类用户眼里显得不足。
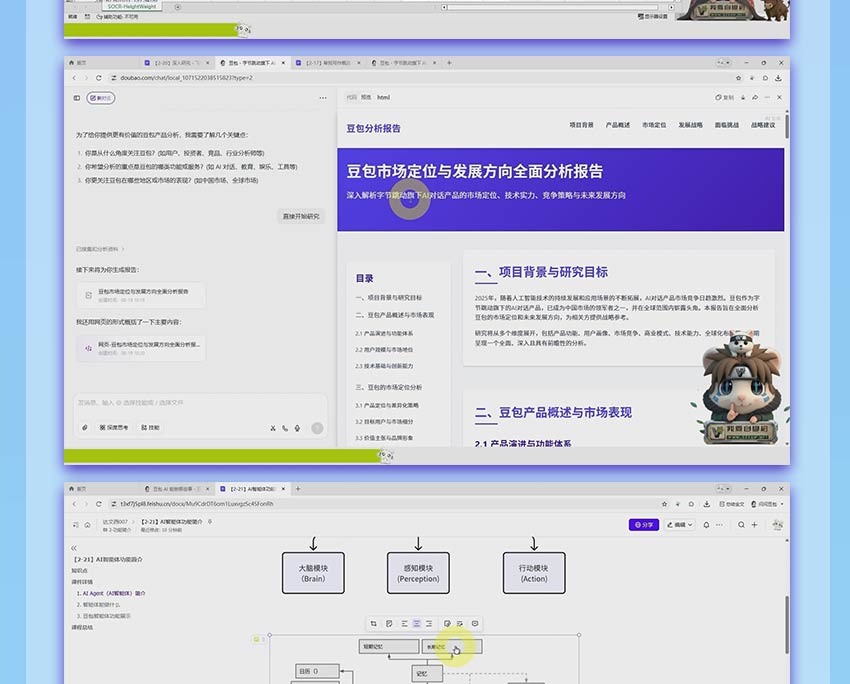
预置动作的另一面是标准化的诱惑。当大量从业者使用同一套预置流程,输出格式会趋同,判断路径会收敛。效率确实可能提升,但专业工作中那些依赖个人经验、机构惯例和情境判断的部分,会被压缩到模板之外。工作台没有让这些部分消失,只是让它们变得更难被看见。
金融工作台接入了万得和同花顺,这才是关键信号
数据插件让AI从“会说话”变成“能干活”
金融投研工作台与普通AI助手最直观的区别,不在对话能力,而在它连接了什么。根据产品信息,该工作台首页提供公告解读、业绩分析、市场简报、公司研究等任务入口,同时接入了万得、同花顺、国泰海通等专业数据服务插件。这意味着AI的输出不再依赖训练语料中的二手信息,而是可以调用用户所在机构已经购买、并授权访问的金融数据终端。
这个区别具有实质意义。普通AI助手在回答“某公司最新季度营收”时,只能给出训练数据截止前的内容,或者从公开网页抓取零散信息。接入万得或同花顺后,AI获取的是结构化、带时间戳、可追溯的金融数据库记录。输出内容的地基从“模型记忆”切换为“数据终端”。对投研场景而言,数据来源的可核验性往往比语言流畅度更重要。
但“接入”并非默认生效。工作台的价值依赖一条清晰的因果链:用户必须先授权相关金融数据终端的账号权限,AI才能调用这些专业数据。没有授权,工作台中的金融插件只是界面上的图标,不会自动获得任何数据访问能力。授权动作构成了整个机制的前置条件。
授权动作把责任重新推回给用户
授权这个动作看似技术性,实则重新分配了责任。用户点击授权的那一刻,等于向系统确认:我有权访问这些数据,我允许AI以我的名义调用它们,我对我触发的工作流负责。AI在这里扮演的是执行者,不是决策者。它依据用户给出的指令和数据权限生成内容,但无法替用户判断这条数据是否适用于当前的分析任务。
这带来一个新的责任结构。过去使用通用AI时,用户对输出的可信度天然保持警惕,因为模型可能编造数据。接入专业数据终端后,AI输出的数据部分有了明确来源,用户反而可能放松核查。风险恰好出现在这里:数据是真实的,不等于数据的选取、组合和解读是正确的。一份业绩分析可以引用准确的财务数字,却因为忽略了行业周期或一次性损益而得出误导性结论。来源可靠只解决了“数据是否真实”的问题,没有解决“分析是否成立”的问题。
现有公开材料没有提供数据调用后的准确率或实际使用效果数据。接入万得或同花顺并不自动保证输出可靠。专业判断仍然留在授权者手中,只是判断的重心发生了偏移:从“这个数字对不对”转向“这个数字用在这里对不对”。工作台提高了信息获取效率,但没有降低判断失误的代价。
医疗和教育工作台暴露了“预置”的另一面
医生工作台能查指南,但谁来为误读负责?
医生工作台的功能描述看起来克制:查找临床指南、检索和解读医学文献、准备患者沟通材料。官方口径把它定位为“循证参考”,而不是诊断工具。这个措辞本身已经划出了一条边界:工作台提供证据,医生做出判断。
但问题在于,预置专业感会改变这条边界的实际位置。当一个界面里已经放好了“临床指南”入口,医生点进去看到的是一段条理清晰、来源看似明确的文本,他有多大动力再去核对指南的版本、适用人群和证据等级?金融场景里,引用错误的财务数据会被审计和合规流程拦截;医疗场景里,一个被误读的指南条目可能直接进入处方或手术决策。错误的代价性质不同,核查的警觉却可能因为“这是专业工作台”而下降。
现有公开材料没有提供医生工作台的知识库来源、循证标准或任何临床验证数据。功能描述只说“预置了医生常用的专业技能与知识库”,没有说明这些知识库由谁维护、多久更新、在什么条件下可以安全使用。这意味着,工作台把“查找指南”的效率提高了,但把“判断指南是否适用于眼前这个病人”的责任完全留给了医生。效率提升是确定的,责任转移也是确定的。
教师工作台一键生成教案,省掉的是时间还是思考?
教师工作台的功能更具体:输入课题、教材和教学要求,一键生成教案和课件。另外,通过与学科网的合作,教师可以查找教学资源、用题图找相似题,还有班主任工作助手和教师专业发展助手两个技能入口。
一键生成教案的吸引力不言自明。备课是教师日常工作中最耗时、最重复的部分之一,把这一步压缩到几分钟,释放出来的时间可以用于批改作业、个别辅导或课堂设计。但教案从来不只是流程文件。一份合格的教案背后,是教师对班级学情的判断、对教材难点的拆解、对课堂节奏的设计。当这些判断被外包给预置模板,教师拿到手的是一份结构完整、表述规范的教学材料,他需要反过来追问:这个设计适合我这个班吗?这个难点拆分符合学生的认知水平吗?
教育场景的特殊性在于,错误不会立刻显现。一份不合适的教案可能不会造成即时伤害,但它会以“学生没听懂”“课堂节奏不对”的方式缓慢积累。更隐蔽的是,一键生成降低了备课的门槛,也降低了“不思考就上课”的成本。教师工作台与学科网的合作保证了教学资源的可获取性,但没有保证这些资源被恰当使用。预置技能越顺手,跳过独立判断的诱惑就越大。
两个场景暴露的是同一件事:预置专业知识库的价值和风险同源。它把专业门槛从“会不会找资料”降低到“会不会用工具”,但把判断门槛从“对不对”抬高到“用在这里对不对”。工具越专业,用户越容易把“看起来专业”当成“可以放心用”。而医疗和教育恰恰是最不能放心用的两个领域。
职场人真正要补的不是提示词,是校验能力
当AI替你完成初稿,你的价值转移到哪里?
工作台把提示词封装进了技能包。金融从业者不再需要琢磨怎么让AI读懂一份财报,教育从业者也不用从零搭建教案生成流程。豆包工作官方称,预置技能和工具“大幅降低了专业工作场景的AI使用门槛”。这个判断成立,但它同时意味着另一件事:提示词技巧作为一项独立技能,正在快速贬值。
当职业技能被预置,用户不再需要从零构建任务,但必须判断预置内容是否适用于眼前的具体情境。一份面向通用金融分析的输出模板,用在信贷审批和二级市场交易上,适用条件完全不同。预置降低了“开始使用”的成本,却把“用得对不对”的责任完整地留给了用户。
这种判断力无法被预置。工作台可以替你完成初稿,但无法替你确认这份初稿是否应该被提交。职场人的价值从“会操作工具”转移到“能对工具的输出负责”。
三个问题帮你判断一个AI输出能不能用
面对任何一份AI生成的专业内容,有三个问题比提示词技巧更接近职业能力的核心。
第一,数据来源是什么。 AI输出的可信度上限取决于输入数据的质量。如果一份行业分析引用了准确的财务数字,但数据源本身没有覆盖最新的行业政策变化,结论就可能失真。来源可靠只解决了“数据是否真实”的问题,没有解决“数据是否完整”的问题。
第二,适用条件是什么。 预置技能包是为某类典型场景设计的,但真实工作很少完全符合典型场景。一个医疗工作台生成的建议,在三级医院和社区卫生中心的可操作性可能完全不同。用户需要判断的是:这个输出在眼前的具体条件下是否仍然成立。
第三,如果错了谁负责。 这是最容易被跳过的问题。工作台降低了生成成本,但没有降低错误代价。一份被直接采纳的错误教案,代价由学生承担;一份未经复核的错误分析,代价由决策者承担。工具不会分担责任,责任归属始终在人。
对于标准化程度高、容错率高的任务,校验成本可能低于独立完成成本,此时AI确实会替代部分人力。但在低容错、强情境依赖的任务中,人的判断反而更稀缺。工作台没有消灭判断,只是把判断推到了更靠后的位置——推到了输出之后,而不是输入之前。