1年融资近10亿!这家清华系AI公司,要用世界模型重塑机器人
1年融资近10亿!这家清华系AI公司,要用世界模型重塑机器人
去年,一家公司悄无声息地融了6轮,拿了近10个亿。国新基金、淡马锡、北汽产投这些名字同时出现在股东名单里,老股东不仅没套现离场,反而超额追加。这场景,放在整个AI赛道都算得上激进。
但资本不是傻子。他们赌的不是又一个能聊天的机器人,而是一个能让机器真正“看懂”物理世界的引擎。
传统机器人依赖的VLA模型,本质上是在做模仿学习——见过倒水才会倒水,换个没见过的杯子就可能翻车。真实场景千奇百怪,部署成本被无限推高。世界模型则试图换一条路:让机器人理解“杯子碰倒会碎”“水洒了会湿”这类物理因果,而不是死记硬背动作序列。
资本押注的,是这套“物理引擎”成为机器人标配的潜力。 具身智能的爆发需要“大脑”,而当前主流方案在泛化能力上的短板,正在把世界模型推向舞台中央。这不是风口追逐,是一场技术路线的代际更替。
核心洞察:6轮融资背后,资本不是在赌一家公司,而是在赌VLA方案被替代的必然性。
技术理想再丰满,也得看谁来落地。Manifold AI的团队配置,精准击中了资本的信任阈值。
创始人武伟,前商汤科技高管,带队连续两年拿下Waymo Sim Agents挑战赛冠军——自动驾驶仿真领域含金量最高的赛场。他既懂前沿算法,也懂怎么把技术从实验室拽进工厂。团队里还有清华长聘教授、15岁考入清华的天才少年、前大厂世界模型负责人,累计顶刊论文200多篇,引用超10万次。
这个组合的稀缺性在于:学术深度和工业落地能力同时拉满。 清华FIB实验室的积淀,让他们有底气跟英伟达、李飞飞团队在学术前沿掰手腕;商汤系的工程化经验,又让产品路径不至于飘在空中。在资本眼里,这比纯学术明星或纯产业老兵都更具胜算——世界模型这场仗,既要仰望星空,也得在车间里吃灰。

二、 分析:路线之争,Manifold AI为何敢说VLA只是过渡方案?
Manifold AI创始人武伟曾直言:“VLA只是一个过渡方案。”这话在具身智能圈激起不小波澜。毕竟,VLA(Vision-Language-Action)模型是当前主流路线,众多机器人公司正沿着这条路狂奔。Manifold AI凭什么挑战共识?
2.1 核心分歧:World Model Action如何用“因果推理与想象”颠覆VLA的模仿学习?
两种路线的本质差异,在于对“智能”的理解完全不同。
VLA的本质是“翻译”:它将视觉信息压缩成语言,再映射为动作。这好比让机器人背诵了一本题库——见过的情况能应付,没见过就束手无策。武伟指出,VLA只是“知其然,不知其所以然”,它无法预测一个动作的连锁反应。
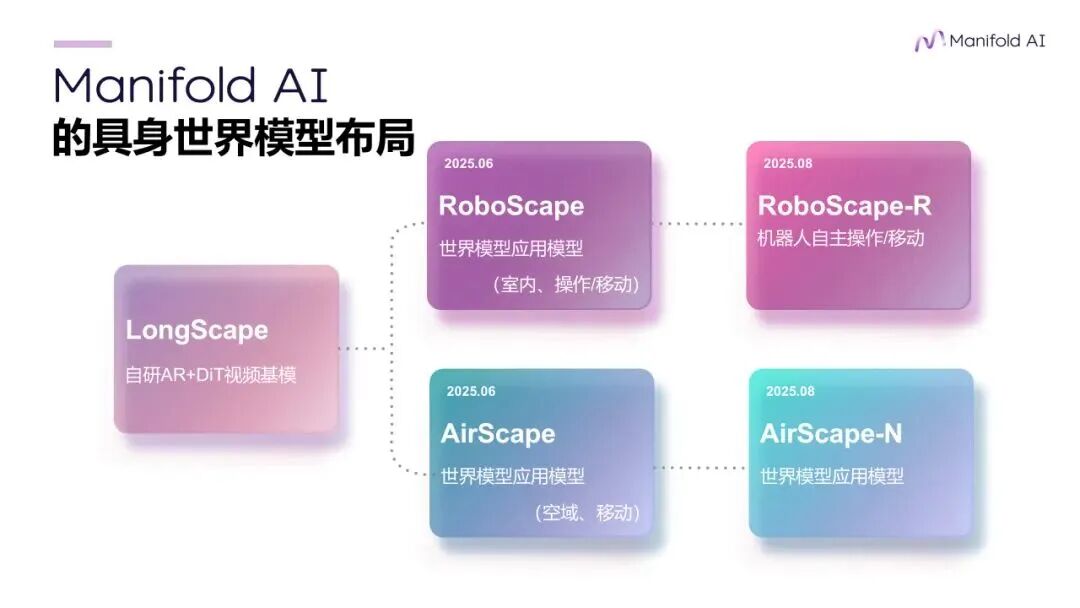
世界模型走的则是“推演”路线。 Manifold AI提出的WMA(World Model Action)架构,赋予模型三种核心能力:Reasoning(推理)、Dreaming(想象)、Acting(执行)。其中“Dreaming”能力是关键——模型在脑中模拟不同行动方案的可能后果,再选择最优解。
武伟用一个场景解释这种差异:看到一个人在哭,VLA只会基于经验给出模式化安慰;而世界模型会推演“如果我去安慰,对方可能会感激我”——这种因果推理能力,让机器从“复读机”进化为“思考者”。
技术架构上,Manifold AI首创的MoE(混合专家)架构支撑了这一理念。不同专家分别负责指令遵循、移动交互、操作推理,通过门控机制自适应整合。这避免了传统模型将高维物理世界强行压缩到语言维度所造成的信息损失。
但这里存在一个隐含挑战:“想象”的可靠性如何保证? 世界模型在脑内推演出的结果,如果与真实物理规律偏差过大,这种“想象力”反而会成为误导。这正是后文要审视的技术通病。
2.2 技术降本:重预训练策略如何从根本上降低碎片化场景的部署成本?
路线之争的另一焦点,是落地成本。
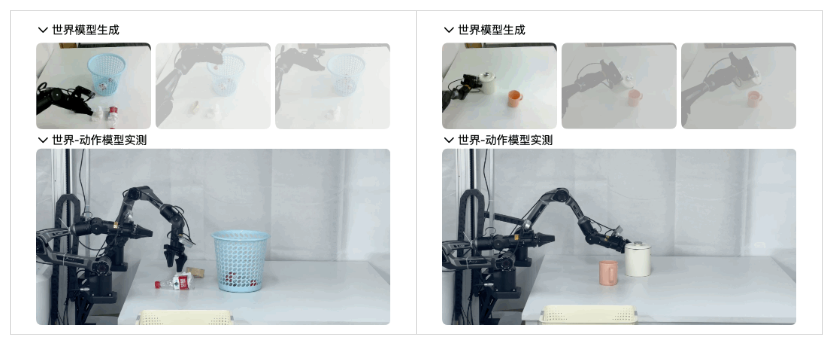
VLA模型有个致命短板:与特定机器人本体强绑定。换一个机器人形态——从人形换成四足机器狗——模型就需要大量后训练数据重新适配。碎片化场景的部署成本居高不下。
Manifold AI的策略截然不同:从预训练阶段就解决问题。 武伟指出,当前绝大多数VLA甚至部分世界模型,都是在已有视频或语言模型上做“后训练”。没有经过充分预训练的模型,缺乏对物理世界运行规律的深层理解,遇到未见过的情况就需要大量补充数据。
流形空间选择了一条更艰难的路:用70%互联网数据加30%真机采集数据,从零开始预训练。这种重预训练策略让模型“见过几乎人类所有的动作空间和任务完成数据”,获得强大的物理先验知识。
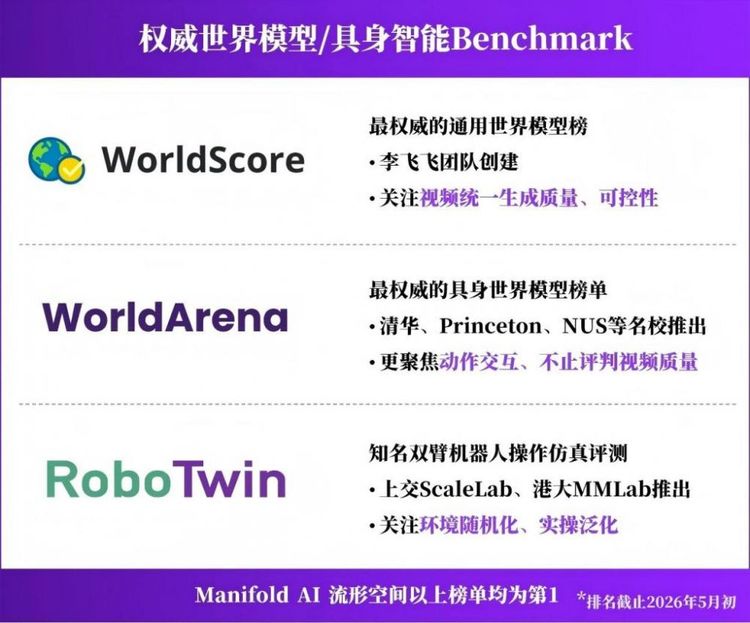
效果是显著的。在WorldScore评测中,WorldScape以仅为竞品10%的参数规模持续霸榜近两个月。更小的模型意味着更低的部署成本,更强的边缘侧适配能力。当基座模型去适配新场景时,后训练所需数据量大幅减少,甚至能实现few-shot甚至zero-shot泛化。
这种“预训练一次,多处低成本适配”的思路,显然比“每个场景重训一次”的VLA路线更具商业想象力——前提是,重预训练的巨额投入能在规模化部署中摊薄。这个“前提”,恰是下一章要审视的烧钱与造血难题。

三、 审视:光鲜背后的隐忧,世界模型能否跨越商业化的鸿沟?
Manifold AI的融资速度和团队光环令人目眩,但将技术理想锻造成商业利刃,从来不是一条坦途。世界模型赛道持续升温的表象之下,隐藏着一个所有前沿技术都无法回避的拷问:这条路,到底能不能走通?
3.1 技术通病:从生成“好看的视频”到做出“可用的决策”,还有多远的距离?
世界模型面临的核心挑战,在于**“感知-功能鸿沟”**。
Manifold AI联合建立的WorldArena评测基准,揭示了一个尴尬的事实:多数模型在视觉质量上表现优异,画面清晰流畅,但一旦涉及物理遵循、三维空间准确性等具身功能指标,得分便大幅下滑。模型很会“画饼”,却难以支撑机器人做出可靠决策。
这并非Manifold AI一家的问题,而是整个赛道的通病。传统视频生成模型“重渲染、轻规律”,生成的是视觉幻象而非物理模拟。WorldScape虽强调对物理规律的统一建模,并以仅为竞品10%的参数规模登顶评测,但从评测榜首到真实工厂的零失误运行,中间横亘着无数边缘场景的考验。
更关键的是,当前的评测体系本身仍在进化。WorldArena覆盖了六大维度、16项指标,但真实世界的复杂性远超任何基准测试。一个在模拟环境中表现完美的模型,面对光照突变、物体形变、多智能体博弈等动态场景时,能否保持鲁棒性?这需要大规模、长周期的真机验证,而非几段演示视频能够回答。
3.2 烧钱与造血:一年烧掉数亿,在攀登技术高峰前,能否先实现“沿途下蛋”的商业化闭环?
Manifold AI的融资节奏堪称激进:一年6轮,累计近10亿元。这种速度在资本市场降温的大背景下,既是对其技术路线的认可,也意味着极高的期望值压力。
公司提出“攀登高峰,沿途下蛋”的策略——在追求通用具身世界模型的同时,通过领域模型在电商物流、3C制造等场景实现商业化。目前,WorldScapePolicy已在部分场景落地,但规模化营收能力仍有待验证。
值得审视的是其成本结构。世界模型的预训练需要海量数据和算力支撑,Manifold AI自研了Ego-centric、UMI等多种数采设备,已积累数十万小时高质量数据。这套数据基建是技术护城河,也是持续烧钱的无底洞。本轮融资明确投向Infra平台建设,意味着短期内支出只会更大。
此外,其目标市场——具身智能机器人——本身仍处于产业化早期。下游客户对“世界模型”的认知和付费意愿尚未成熟,市场需求碎片化。Manifold AI选择的电商物流、3C制造等场景虽然需求真实,但每个场景的定制化部署都可能消耗大量工程资源,标准化与个性化的矛盾将直接影响商业化的边际效益。
“沿途下蛋”的美好愿景,最终取决于一个残酷的指标:在下一轮融资窗口到来前,能否交出足够亮眼的营收数据,证明自己不只是资本催熟的实验室明星。