降本竞赛救不了AI泡沫:Token便宜了,价值为什么没跟上?
李彦宏警告AI应用层渗透低于预期、可能变成泡沫,OpenAI和云知声却在同一时间把Agent工作流的token成本大幅压低。本文不站队,而是拆解这场降本竞赛到底改变了什么:它降低了试错门槛,但没有自动创造收入;它让调用量暴涨,但调用量本身不等于收益;它甚至可能掩盖“用了AI但利润没提升”的真实问题。关键变量不是token单价,而是单位成本下降后,企业是否找到了能产生增量价值的场景。
降本竞赛救不了AI泡沫:Token便宜了,价值为什么没跟上?
降本解决的是“用得起”,不是“用了能赚”
OpenAI把单任务成本打到Claude Fable 5.2的5%,证明的是模型调用正在快速变便宜,而不是AI应用已经普遍创造利润。李彦宏的警告指向另一个变量:很多企业用上AI之后,收入和利润并没有明显提升。成本下降与价值兑现分属两条线——前者是供给侧的价格变化,后者是需求侧是否愿意持续付费的问题。降价可以降低Agent工作流的进入门槛,但无法替企业回答“调用之后赚不赚钱”。更便宜的token不等于更有价值的输出。
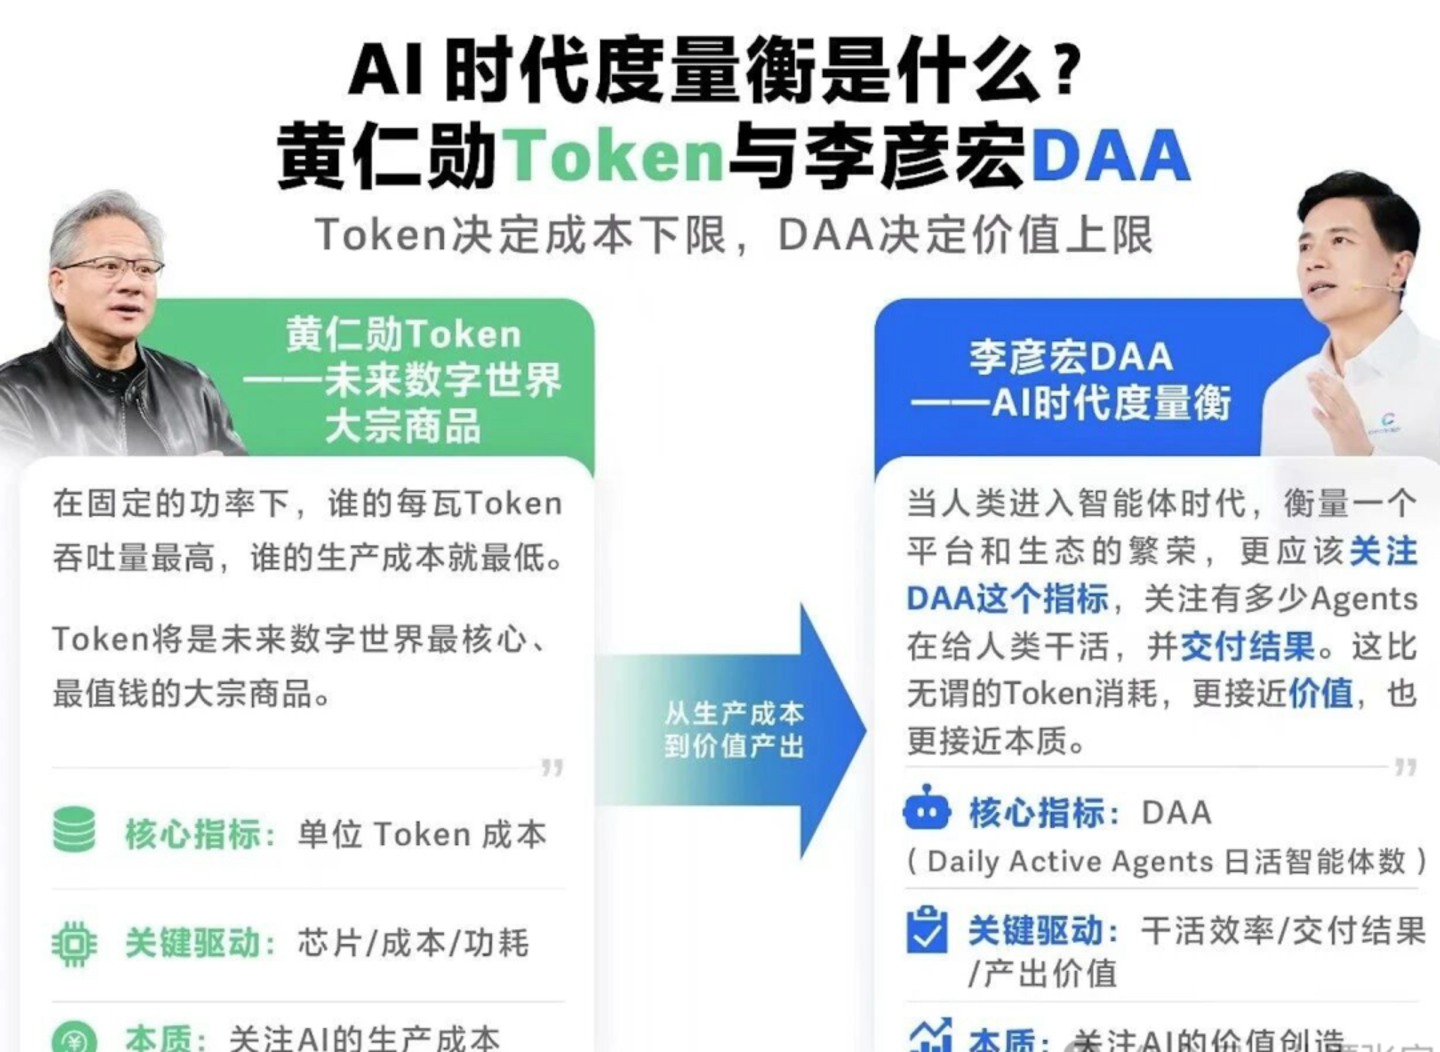
调用量暴涨,但Token是成本不是收益
李彦宏在Create 2026百度AI开发者大会上提出用DAA(日活智能体数)替代DAU和Token调用量来衡量AI价值。他给出的理由很直接:Token不一定代表终局,Token代表的是成本,不是收益。
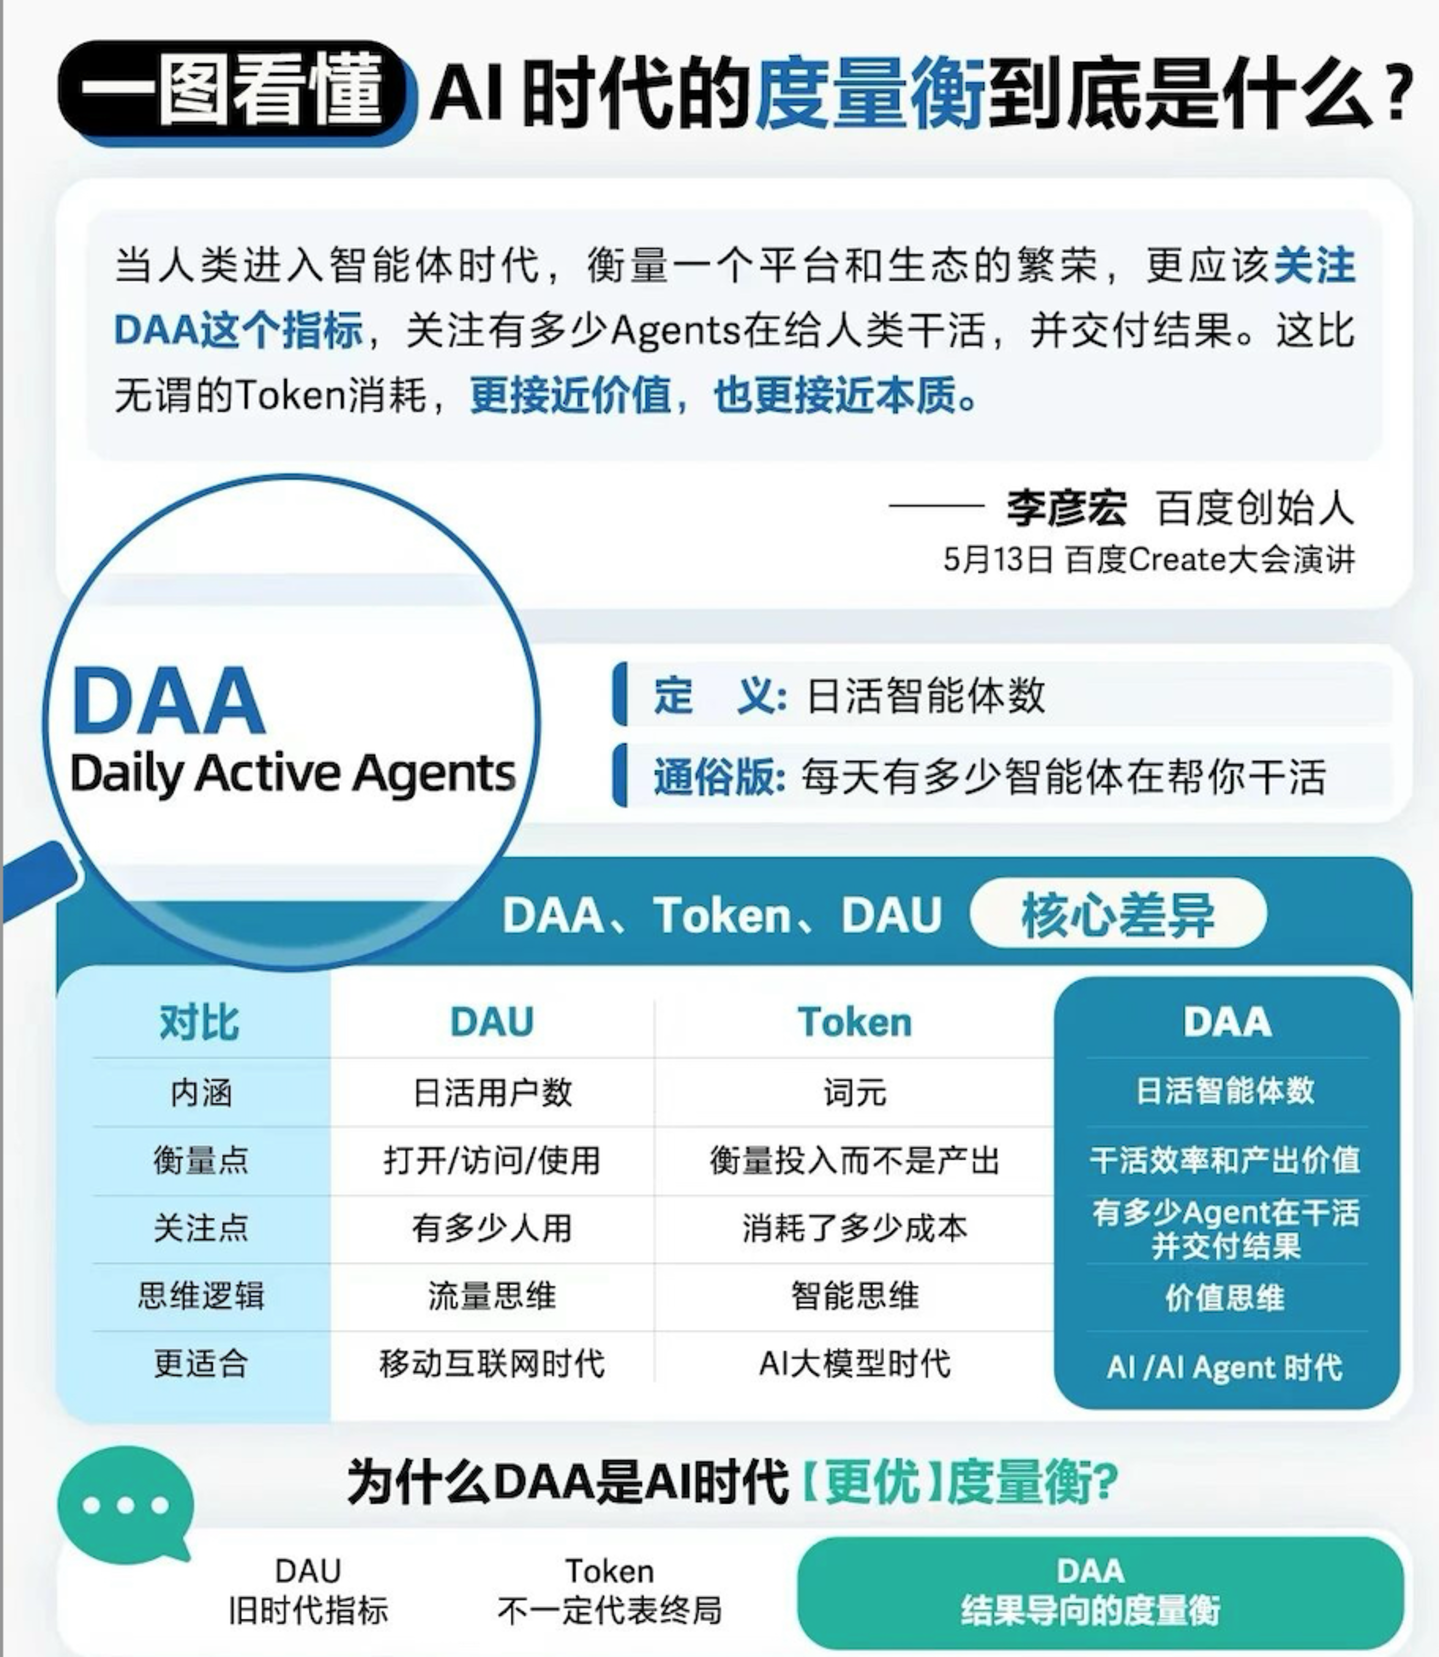
调用量增长在降价环境下尤其具有误导性。单次调用成本大幅下降时,价格弹性会放大非必要调用,调用量上去了,产出却没有同步增加。Gartner的一份报告也持类似判断,认为Token消耗是衡量AI市场领导力的误导性指标,因为它发生在AI价值链的最早期阶段,反映的是计算活动本身,而非经济或战略影响力。
Meta内部的数据更能说明问题。据钛媒体报道,Meta曾流行一个叫“Claudeonomics”的排行榜,8.5万名员工按30天内消耗的Token量排名,全员烧掉60万亿Token,榜首单月消耗2810亿。这个数字只记录了一家公司内部有多少计算资源被投入模型调用,无法读出这些调用转化成了多少决策质量、代码产出或业务收入。
调用量增长在某些场景下确实反映真实需求扩张。文心一言的日调用量从2亿增长到5亿,至少说明有更多开发者和应用在接入模型。但这一指标本身无法区分有效调用与无效调用。
Anthropic的对比更清楚地暴露了调用量与商业价值之间的断裂。其Claude全系产品DAU总和仅为ChatGPT的约2%,但2026年初年化营收ARR反超OpenAI,从2024年的10亿美元升至2026年4月的300亿美元,5月进一步达到440亿美元。如果调用量是价值的可靠代理,这个结果不应该出现。低DAU高ARR的组合说明,Anthropic的用户可能更集中在付费意愿强的企业场景,而不是高频但低价值的消费级对话。
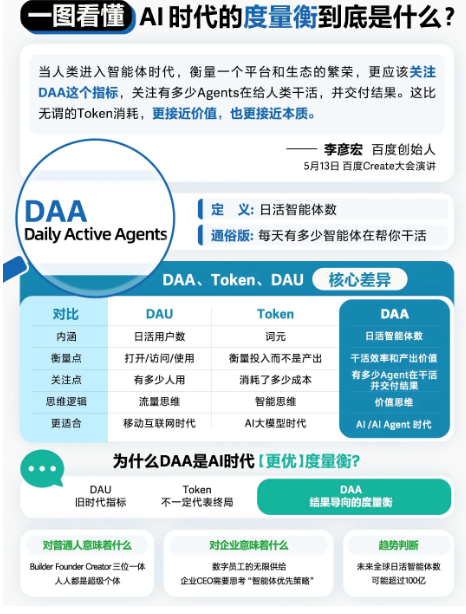
Token消耗是成本侧指标,它回答的是“模型被用了多少次”,而不是“这些使用创造了多少收入或节省了多少人力”。把调用量翻倍当作AI落地的证据,等于把电费账单增长当作工厂产值提升。降本竞赛让这个误区更容易发生:当token足够便宜,无效消耗的代价低到可以忽略,企业就更没有动力去追问每一次调用是否真的必要。
降本的真实作用:降低试错门槛,而非创造需求
降本的作用需要拆成两层看。第一层是让已经在用的场景更经济,同样的任务花更少的钱;第二层是让原本不敢试的场景变得可以试。后者对应用层渗透的意义更大,因为它改变的是企业的决策门槛,而不是某个具体任务的账单。
云知声的U2-Flash-1118提供了一个可观察的样本。根据公司公告,在相同任务集和一致评测条件下,升级版模型的总Token消耗较原版本降低约37.0%,模型调用次数减少约44.8%。公告同时提到,模型在保持原有语言基座参数规模不变的基础上新增了约1B参数的视觉模块,复杂编程、Agent自动执行和多模态理解能力均有提升。调用次数与Token消耗同时下降,指向单次调用本身变得更高效,但公告未披露这一变化的具体机制,无法据此断定节省的来源。
这个案例的关键不在于37%这个数字本身,而在于它提示了降本可能来自模型效率提升,而非单纯的价格下调。如果成本下降只是因为厂商降价,企业得到的是临时性的价格优惠,模型能力没有变化,试错结果不会因为便宜而变好。效率型降本才具有可累积性:它让单次试错的绝对代价下降,同时让每次试错携带的信息量不缩水。但U2-Flash-1118的指标变化是否完全源于效率提升,公开资料未披露因果机制,只能作为观察样本而非定论。
对中小企业而言,这个差异是决定性的。李彦宏在2024年的一次对话中明确指出,中小企业“账是算得非常精的”,只有确认能降本增效才会持续使用。当模型调用成本降到足够低的水平,企业愿意尝试的场景数量会明显增加。那些过去因为ROI算不过来而被搁置的用例,在效率型降本之后才进入可验证区间。降本在这里的作用不是直接创造价值,而是把价值验证的成本降到企业愿意支付的水平。
但试错门槛降低不等于试错结果自动变好。更便宜的Token意味着失败尝试的代价更小,这可能让企业在缺乏清晰场景定义的情况下盲目铺开Agent工作流。Uber在2026年头四个月花完全年AI工具预算后重新评估的案例说明,当试错成本被压得过低,预算约束反而可能失去筛选功能。降本降低了进入门槛,也同时降低了“停下来想一想”的紧迫性。真正的分界线不在于Token有多便宜,而在于企业是否把省下来的试错成本用于验证真实需求,而不是用于扩大无效尝试的规模。
泡沫的判定标准:单位成本下降后,有没有增量价值
判断AI是泡沫还是真实价值,不能看token单价降了多少,也不能看调用量涨了多少。唯一有效的标准是:单位成本下降之后,企业是否找到了产生增量收入或利润的场景。降本和增量价值必须分开记账。前者是供给侧的参数变化,后者是需求侧的商业验证。只有后者为正,降本才构成加速器;后者为负或不可验证,降本只是让无效试错的燃料更便宜。
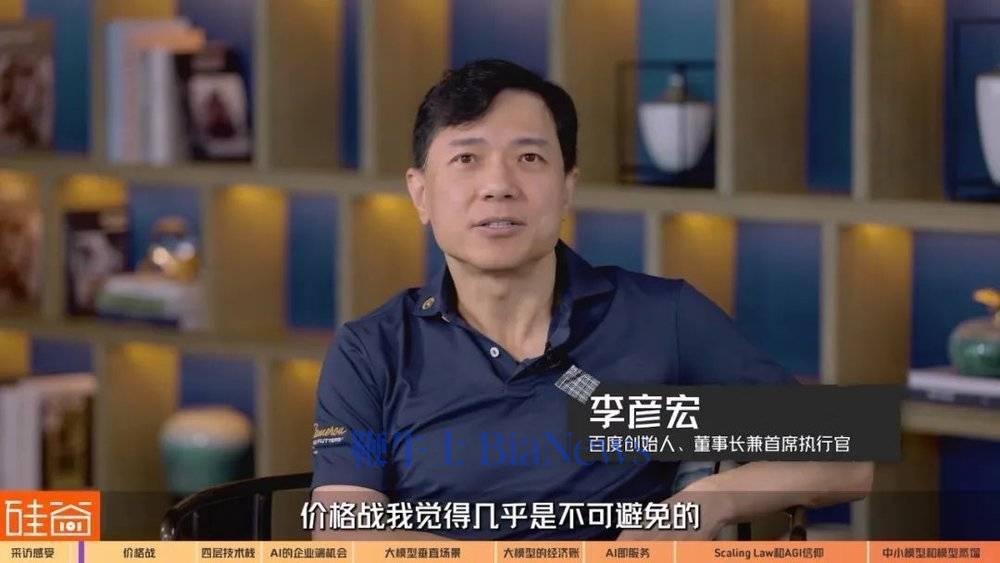
李彦宏在APEC发言中给出了一个与主流叙事相反的因果顺序:重大技术突破和颠覆式创新往往是规模化应用的结果,而不是原因。他举例说,没有万卡集群就不会有大模型的智能涌现,没有数以亿计的运营公里数,无人驾驶就不可能比有人驾驶安全十倍。这套逻辑落到当前语境里,意味着应用层的规模化验证才是技术价值的最终裁判。token降价可以降低验证门槛,但门槛降低本身不产生价值。价值只能来自真实场景中可计量的收入或利润变化。
同一个降本环境下,不同企业的ROI分化才是关键信号。李彦宏提到,最近一个季度百度智能云增速接近100%。这个数字需要谨慎解读:智能云收入中包含云资源销售,不能全部归因于AI价值。但即便存在口径问题,它至少说明部分企业在为AI相关能力持续付费,且付费规模在扩大。与之相对的是Uber的案例:2026年头四个月就花完全年AI工具预算,随后开始重新评估投入。同样面对更便宜的token,一家企业的AI相关收入在加速,另一家在预算失控后收缩。这种分化比行业平均调用量或平均单价更有信息量。
单一案例不能推广为行业趋势。百度智能云的高增速可能被云资源销售放大,Uber的预算失控也可能只是个别企业的管理问题。但分化本身指向泡沫判定中最核心的变量:应用层是否在产生可验证的增量。如果降本之后,越来越多企业像Uber一样发现支出增长远快于价值兑现,那么降本就是在加速泡沫形成;如果更多企业像百度智能云所显示的那样持续扩大付费规模,降本才是在加速真实价值落地。
对普通读者和企业决策者而言,可操作的判断框架只有一条:把降本和增量价值分开记账。任何AI项目,先问单位成本下降后,收入或利润有没有出现可归因的增长。如果答案是否定的,那么更便宜的token只是让问题暴露得更晚。