为什么 AI 写的文章一眼假?实测“个人风格 DNA 蒸馏 + 套话硬拦截”如何写出真人语感
深度拆解 AI 文章一眼假的三大病灶(二元对立句族泛滥、研报黑话、段末免责堆砌),实测 SupaWriter 超写派(官网 supawriter.sevnday.com)内置 4 套拟人口吻底座与个人风格 DNA 蒸馏如何在初稿与返修双阶段写出真人专栏语感并保持 100% 改稿零丢图。
为什么 AI 写的文章一眼假?实测“个人风格 DNA 蒸馏 + 套话硬拦截”如何写出真人语感
导读:几乎所有用 AI 写过长文的人都在提示词里加过一句“请用真人语气、不要有 AI 味”,结果出来的稿子照样一股浓烈的塑料公关味。问题到底出在哪?本文拆解让读者 3 秒划走的三大 AI 语言病灶,并实测如何通过“确定性套话拦截 + 4 套拟人口吻底座 + 个人风格 DNA 蒸馏”让机器真正写出有呼吸感的人话。
打开手机刷公众号或行业专栏,现在的读者练出了一项本能:往往不用读完前三段,就能精准嗅出“这篇是 AI 拼出来的”。
奇怪的是,哪怕创作者在提示词里反复叮嘱“模仿资深从业者口吻、语言要自然接地气、严禁 AI 味”,大模型交出来的初稿,依然像同一位刚背熟互联网黑话词典的公关秘书写出来的。
为什么一句笼统的“去 AI 味”指令总会失效?因为对大模型来说,“像真人”是一个毫无操作边界的模糊形容词;不知道该删什么的时候,它就会本能地退回到预训练语料里最安全的**“高分作文模板”**里去。
要想真正拔掉这股塑料感,先把病根扒出来。
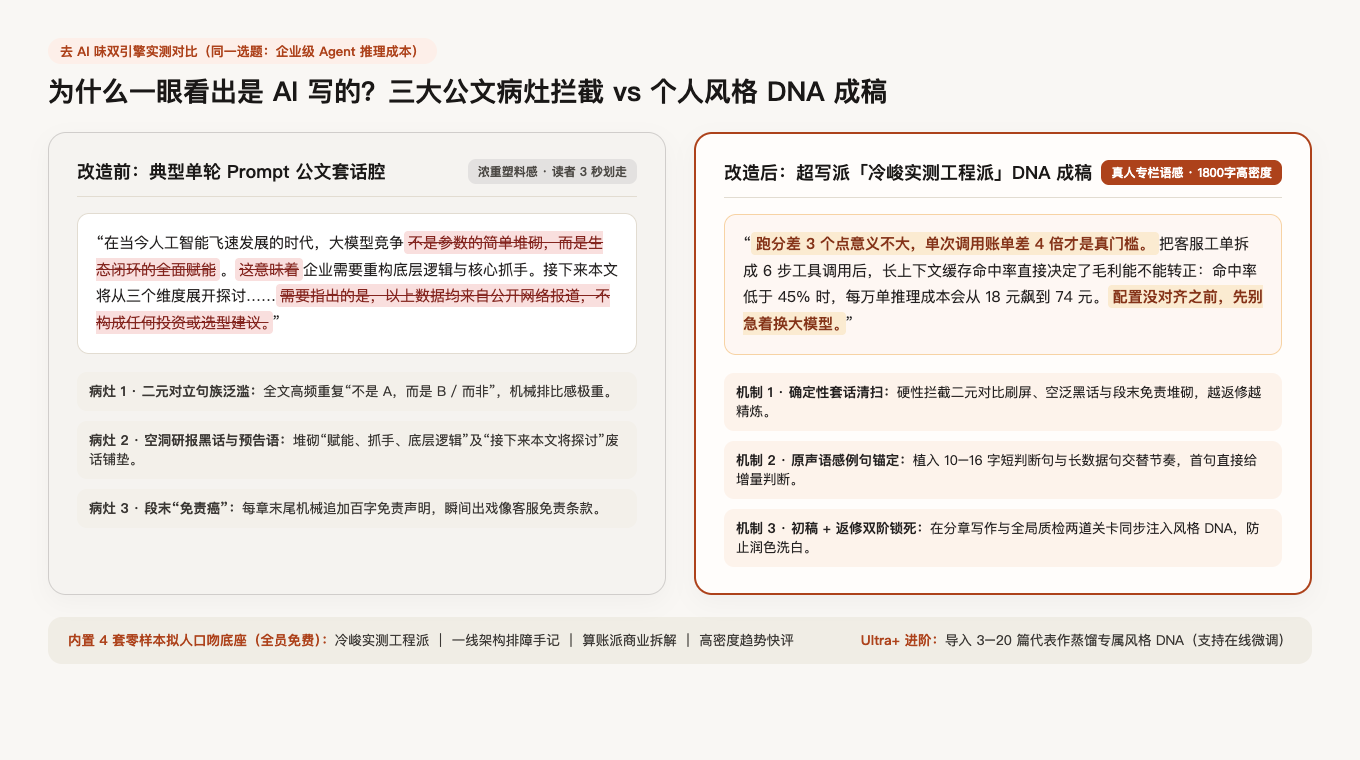
一、解剖“一眼假”:AI 长文最顽固的三大病灶
我们统计了上百篇未经工程干预的大模型直出长文,发现读者反感的“AI 味”根本不是某几个生僻词,而是三种高频重复的句法与结构惯性:
病灶 1:“不是 A,而是 B”二元对立句族刷屏
通用大模型极度迷恋用二元对立制造所谓的“深刻感”:
“大模型的竞争不是参数的简单堆砌,而是商业闭环的全面重构;Agent 落地不是技术的单点突破,而是组织心智的深层跃迁……”
一篇文章里出现一次尚可忍受,连续出现四五次(包括变体“并非…而是…”“与其说…不如说…”),整篇文章就会呈现出强烈的机械排比腔,只有姿态没有事实。
病灶 2:空洞研报黑话 + 解说员式预告废话
当手头缺乏具体数字和一手细节时,模型最擅长用抽象大词糊弄过去——满屏“赋能、抓手、底层逻辑、生态闭环、范式转移”;每逢换章节还要像晚会主持人一样先报幕:“在了解了背景之后,接下来我们将从以下三个维度深入探讨……” 读者滑了两屏,一行干货增量都没看到。
病灶 3:段末“免责癌”与第四章车轱辘话总结
经过安全对齐训练的模型特别怕把话说满,动不动就在章节末尾塞一段百字免责补丁:“需要指出的是,以上数据均来自公开网络报道,受限于样本差异,不构成任何选型建议……” 到了全篇结尾,还要硬凑一个第四章把前面讲过的观点换套近义词再复述一遍,原本 1600 字能讲透的事硬生生注水到 3500 字。
二、破局实测:用“工程约束 + 风格 DNA”替代玄学提示词
看清这三个病灶就会明白:去 AI 味从来不是给文字“加滤镜”,而是先做减法删水份,再把具体的人格句法锁进去。
近期在写发一体工作台 SupaWriter(超写派) 上实测了它最新上线的拟人风格管线,这套方案没有靠玄学抽奖,而是把“写出真人感”拆成了三步硬约束:
第一步:默认 1800 字高密度预算 + 确定性套话清扫
一篇文章一旦被允许漫无目的地写到三四千字,注水套话几乎不可避免。超写派在不额外指定超长篇幅时,默认把全篇预算收敛在 1800 字左右(3–4 章紧凑结构,短章不拆碎三级小标题)。
在成稿与质检环节,系统直接对高频套话做确定性扫描:超标的二元对比句式、解说员预告语、公关黑话以及段末免责堆砌会被精准定位重写,多维指标强制收敛为一眼扫清的紧凑表格——越返修字数越精炼,而不是越改越啰嗦。
第二步:零样本直选 4 套实战拟人口吻底座
很多刚起步的创作者还没有积累满意的历史代表作。针对冷启动场景,超写派在创作页直接向全员(包括免费版用户)开放了 4 套颗粒度极细的实战口吻底座:
| 内置口吻底座 | 叙事姿态与人设视角 | 句法节奏与标题纪律 | 硬性禁用的套话清单 |
|---|---|---|---|
| 冷峻实测工程派 | 跑过基准压测的一线评测工程师,重成本与翻车边界 | 标题必带具体模型/项目与数字差距;事实在前,10–16 字短句落锤在后 | 禁用“不是…而是…”刷屏、感叹号与段末免责套话 |
| 一线架构排障手记 | 资深后端给同行写的选型排障手记,重吞吐延迟权衡 | 主语落回具体队列、接口与服务动作;讲方案优点必配五分钟回滚代价 | 禁用“赋能/闭环/底层逻辑”黑话,严禁编造虚构故障日志 |
| 算账派商业拆解 | 用现金流与单位经济模型看热闹,拆穿补贴公关话术 | 点名具体公司与财务反差矛盾;长句交代财报口径,短句点明谁出钱谁赚走 | 禁用“心智占领/核心抓手”,严禁单开第四章复述前文 |
| 高密度趋势快评 | 面向时间紧迫熟手读者的锋利简评,3 分钟读完核心增量 | 18–26 字短标题直亮利益转折;单段不超 4 行,首句直接给判断后接硬事实 | 禁用常识铺垫、“这意味着”连用与套路自问自答 |
拿同一个选题《企业级 Agent 落地推理成本》做同题对比:
- 普通对话直出写的是:“在智能化浪潮下,企业落地 Agent 不是简单的模型调用,而是成本与效率的深度平衡……”
- 切换「冷峻实测工程派」后开篇直接落锤:“跑分差 3 个点意义不大,单次调用账单差 4 倍才是真门槛。把工单拆成 6 步工具调用后,缓存命中率一旦掉到 45% 以下,每万单推理成本就会从 18 元飙到 74 元。配置没对齐之前,先别急着换大模型。”
高下立判。
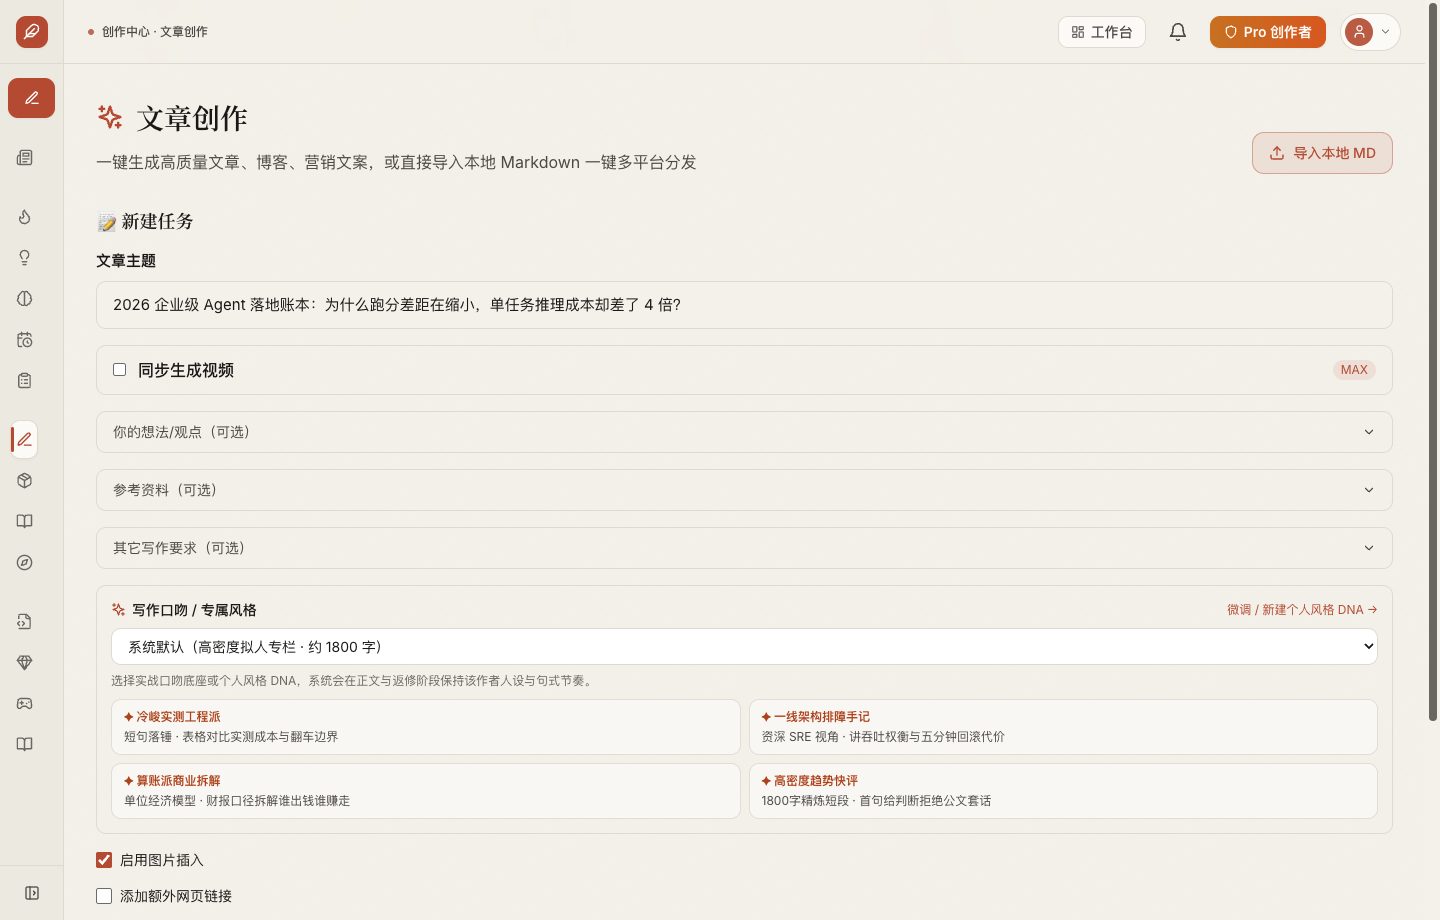
第三步:导入代表作蒸馏可编辑的「个人风格 DNA」,初稿返修双阶锁死
对于已经有成熟个人文风的公众号主理人或专栏作者(Ultra 及以上档位),可以直接粘贴或导入 3 至 20 篇过往代表作。系统会自动蒸馏出一份完全白盒透明的 个人风格 DNA 报告:
- 你偏好的标题结构习惯;
- 从你原文中提取的 3–5 句标志性原声语感例句(锚定长短句呼吸节奏);
- 你的结构推进模板与个人忌讳禁用词表。
有两个工程细节非常关键:
- 完全白盒可在线微调:蒸馏出来的 DNA 不是黑盒参数,你可以随时打开编辑器手动增删某条禁用词、或者把内置的 4 套底座一键克隆过来改成自己的变体。
- 写作 + 返修双阶段注入,且改稿不丢配图:很多工具初稿还有点人味,一过润色节点又被洗成了标准客服腔。超写派在分章初稿和全局质检返修两个阶段同步锁定同一份风格 DNA,同时用不可变锚点把正文里的跨模态图表牢牢锁在原位——文字越改越像你本人写的,配图一张都不会丢。
三、给内容创作者的三条实操建议
无论你目前用哪套工具辅助写作,想让产出的长文真正留住真人读者,建议立刻把这三条规矩用起来:
- 给篇幅设上限,别给字数设下限:深度好文拼的是单位字数的信息密度。把常规公众号和专栏文章控制在 1600–2000 字,砍掉一切“众所周知”的背景寒暄和结尾同义复盘。
- 把“不要 AI 味”翻译成具体的禁用词与句长纪律:明确禁止标题使用对比套话、禁止单段超过 4–5 行、禁止段末免责补丁,用具体公司、具体动作和具体数字做句子主语。
- 人出核心判断,机器做查证、配图与多端落地:在 SupaWriter(超写派) 新建任务时,花 30 秒在「你的想法/观点」里写下你最真实的哪怕一句犀利判断,再选定一套口吻底座或个人风格 DNA,剩下的多源核验、语义配图、公众号富文本填稿乃至 14 平台分发,放心交给流水线去跑完。
附:体验说明
- 文中实测的 4 套拟人口吻底座 已向 SupaWriter(超写派) 全部注册用户免费开放(注册即享每月 5 篇免费额度);
- 如需体验在线免登录 Markdown 转微信公众号富文本工具,可直接访问
supawriter.sevnday.com/tools/markdown-to-wechat。