AI带AI的真正门槛:不是生成速度,而是知识治理
文章区分了演示级递归与工程级AI主导研发,用紫讯AI-DLC的版本数提升与返工率未同步改善、华为云CodeArts客户反馈等证据说明:瓶颈已从生成速度转移到知识治理与流程可复现性。读者可据此判断一个组织是否具备推进AI主导研发的前提条件。
AI带AI的真正门槛:不是生成速度,而是知识治理
从“AI写代码”到“AI带AI”:被混淆的两件事
“AI带AI”这个说法最近出现得越来越多,但它指的事情至少有两层,混在一起谈就容易得出过头的结论。
浅的一层是模型生成代码、生成芯片设计、生成测试用例,然后由人把这些产物接进真实系统。Anthropic此前披露其内部代码有相当比例由AI参与生成,这类数字常被拿来证明“AI已经在研发AI”。但生成速度快并不等于研发闭环,模型仍然需要人设定目标、判断取舍、处理失败。另一层是AI在受约束的工程流程里持续参与从需求到验证的完整环节,包括自己触发测试、读取失败信号、修改方案并重新提交。二者都叫“递归”,实际难度差着一个组织形态。
NTLx博客的文章列表里出现过《当AI开始建造自己,我们还能抓住什么?》和《当AI开始设计运行自己的芯片:AlphaEvolve一周年回顾》这类标题,但资料中没有提供正文内容,无法据此判断其中描述的是哪一层递归。同样,围绕NeoHorse等原型的讨论,目前可核实的也只是“存在原型”这个层面,具体机制和稳定性缺乏公开细节。把这些标题级案例当作产业共识,是当前讨论中最常见的跳跃。
同济大学朱少民在《跨越“生成”的鸿沟:2026智能体编程的真正拐点》中提出,任务视界——模型在无人干预下自主工作并持续改进的时间长度——比生成速度更关键,并把2026年视为智能体编程从“辅助工具”走向“生产力主体”的分水岭,包含能力、范式、进化三个拐点。这是预测性判断,不是已经发生的事实,它给出的价值在于提示衡量维度:看AI能独立跑多久,而不是看它一次能吐多少代码。
区分这两层递归的意义在于,演示级递归靠模型能力提升就能推进,工程级递归必须靠流程改造。后者才是产业路径能否成型的真正门槛。
真正卡住AI研发的,不是生成速度
紫讯的版本数提升与返工率未同步改善
紫讯把AI嵌入真实研发流程后,内部统计出现了一组值得细看的数据:2026年5月较3月,月度版本数提升约22%,版本覆盖仓库数提升约11%,日均版本数提升约18%。版本数是迭代活动的观察口径,反映的是单位时间内发生了多少次提交和发布动作,不是交付质量指标。这三个数字放在一起,说明AI确实让团队“动得更频繁”了。
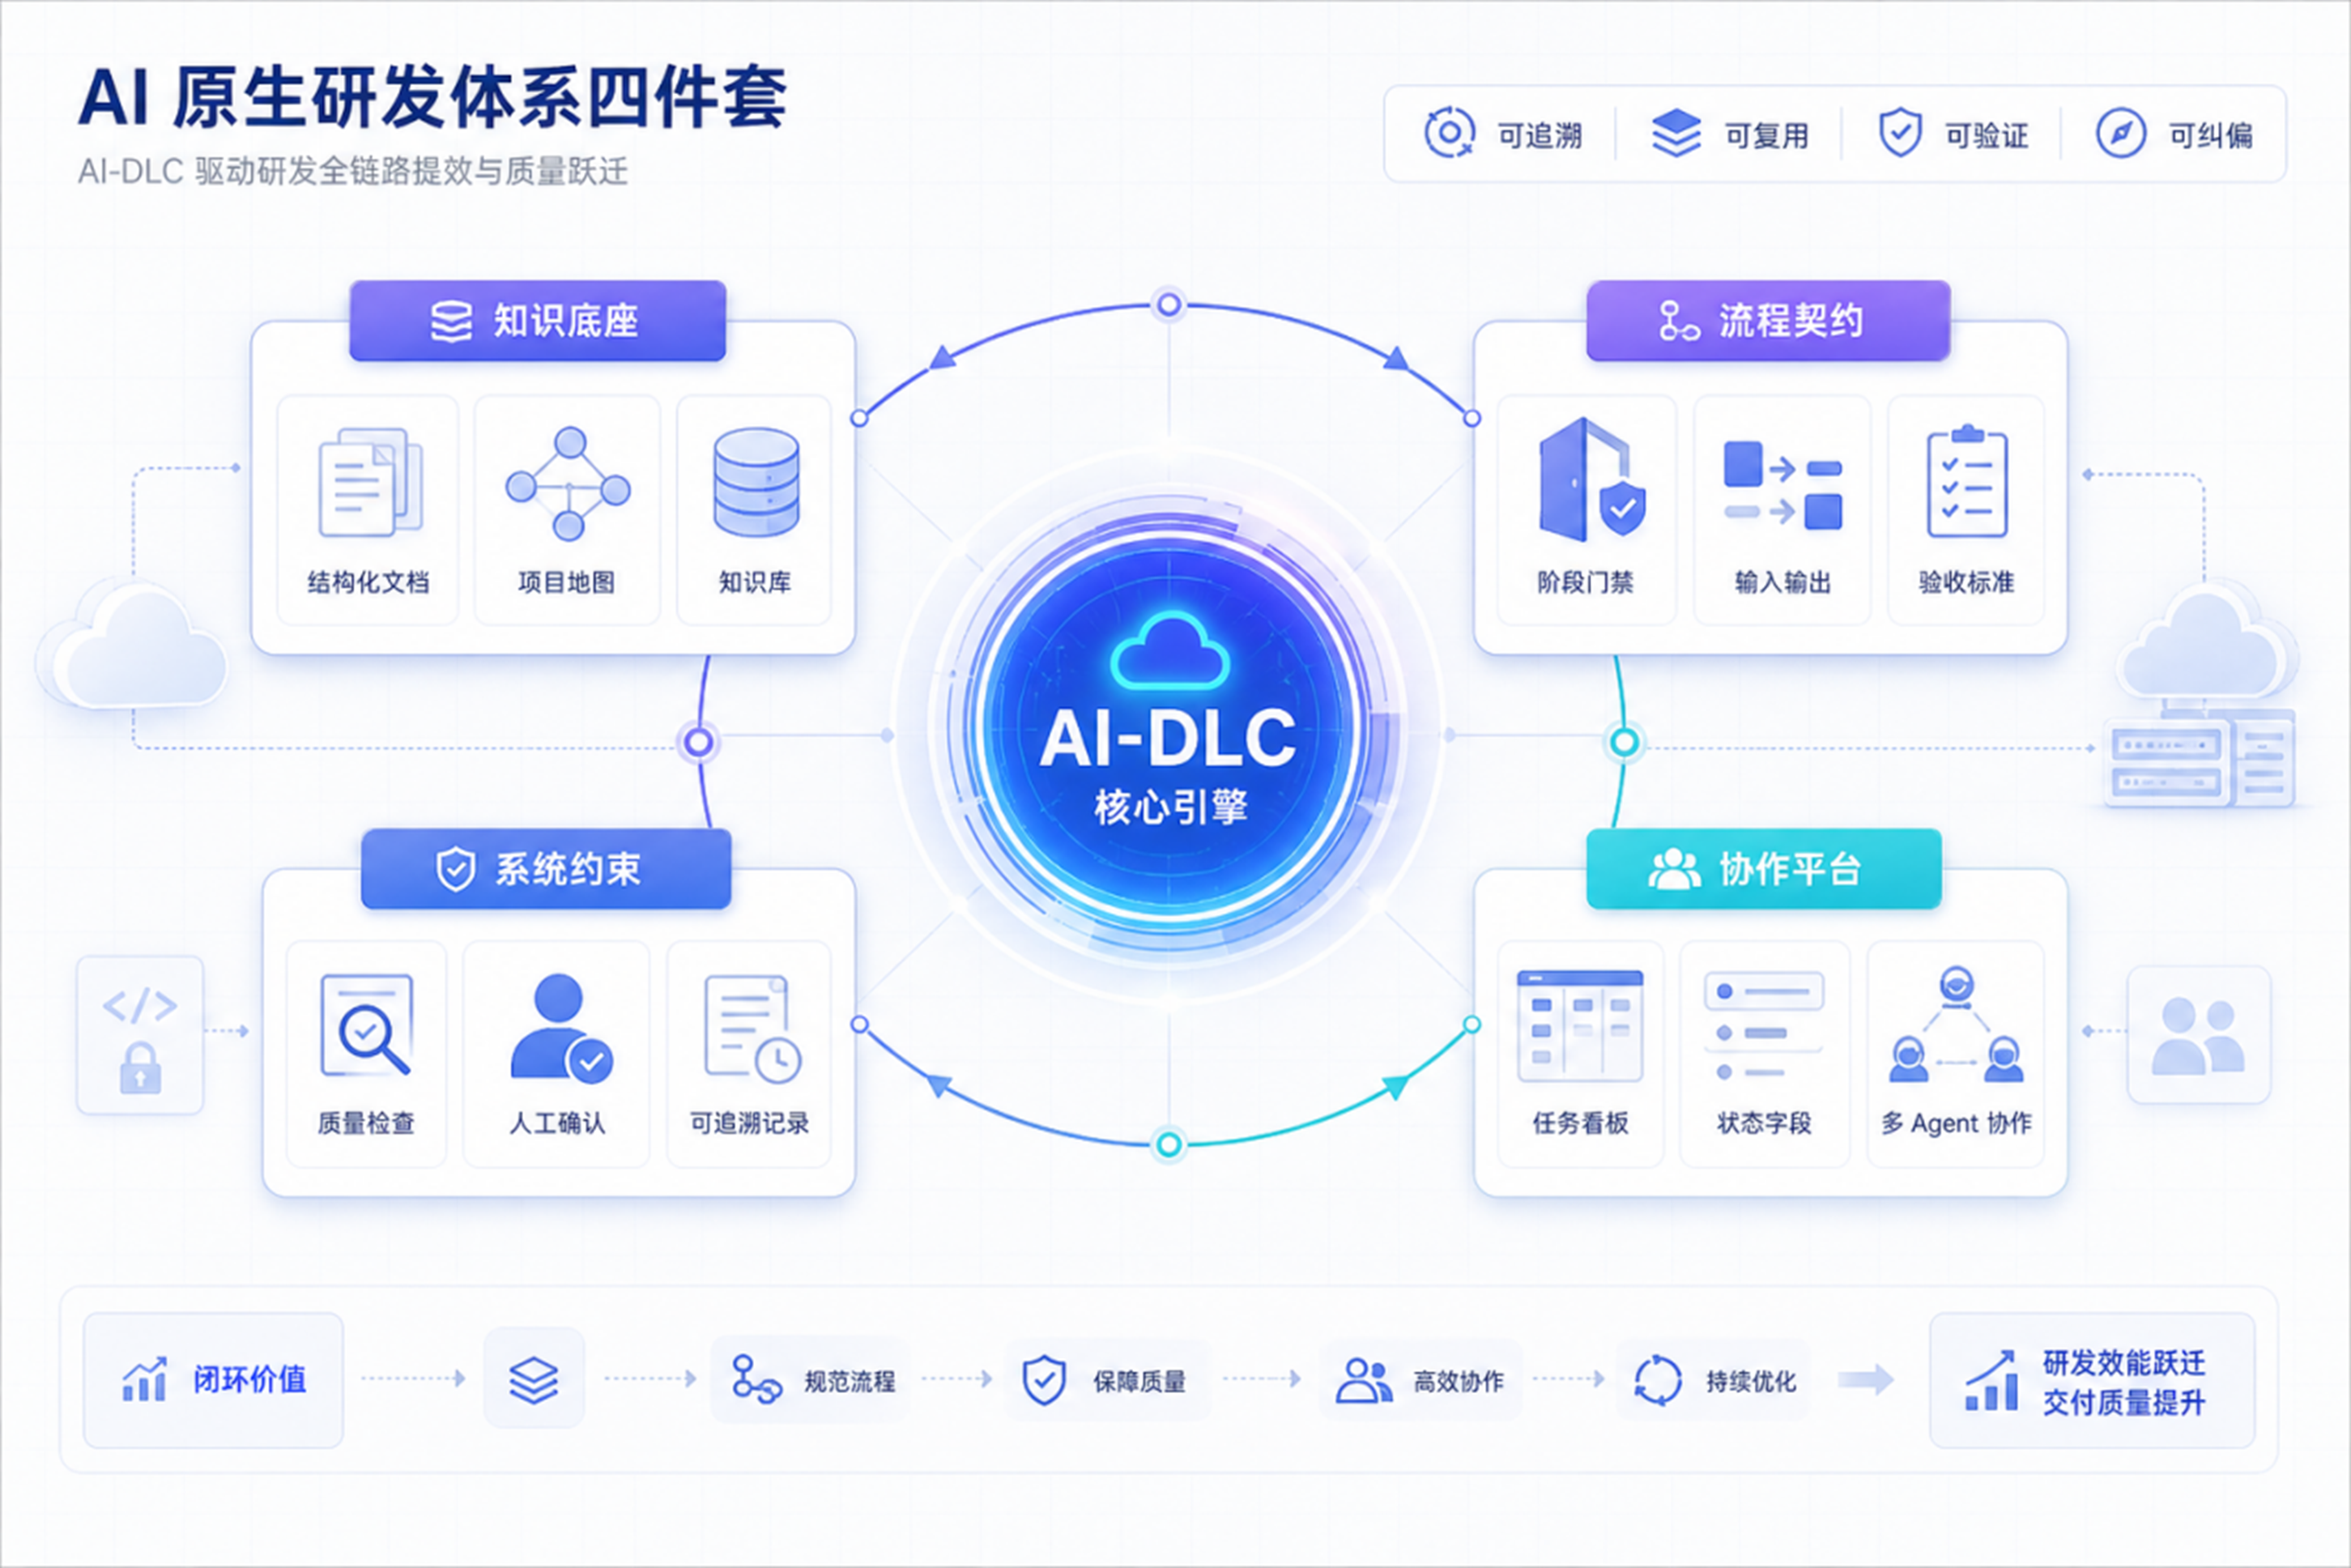
但紫讯自己的复盘同时列出了另一组事实:个人提效明显,需求交付周期、跨角色协作效率和返工率并没有同步改善。两条线并行,恰好构成一个反例——生成速度上去了,交付结果没跟上。
知识分散、结论不可复现、文档过期无过期感
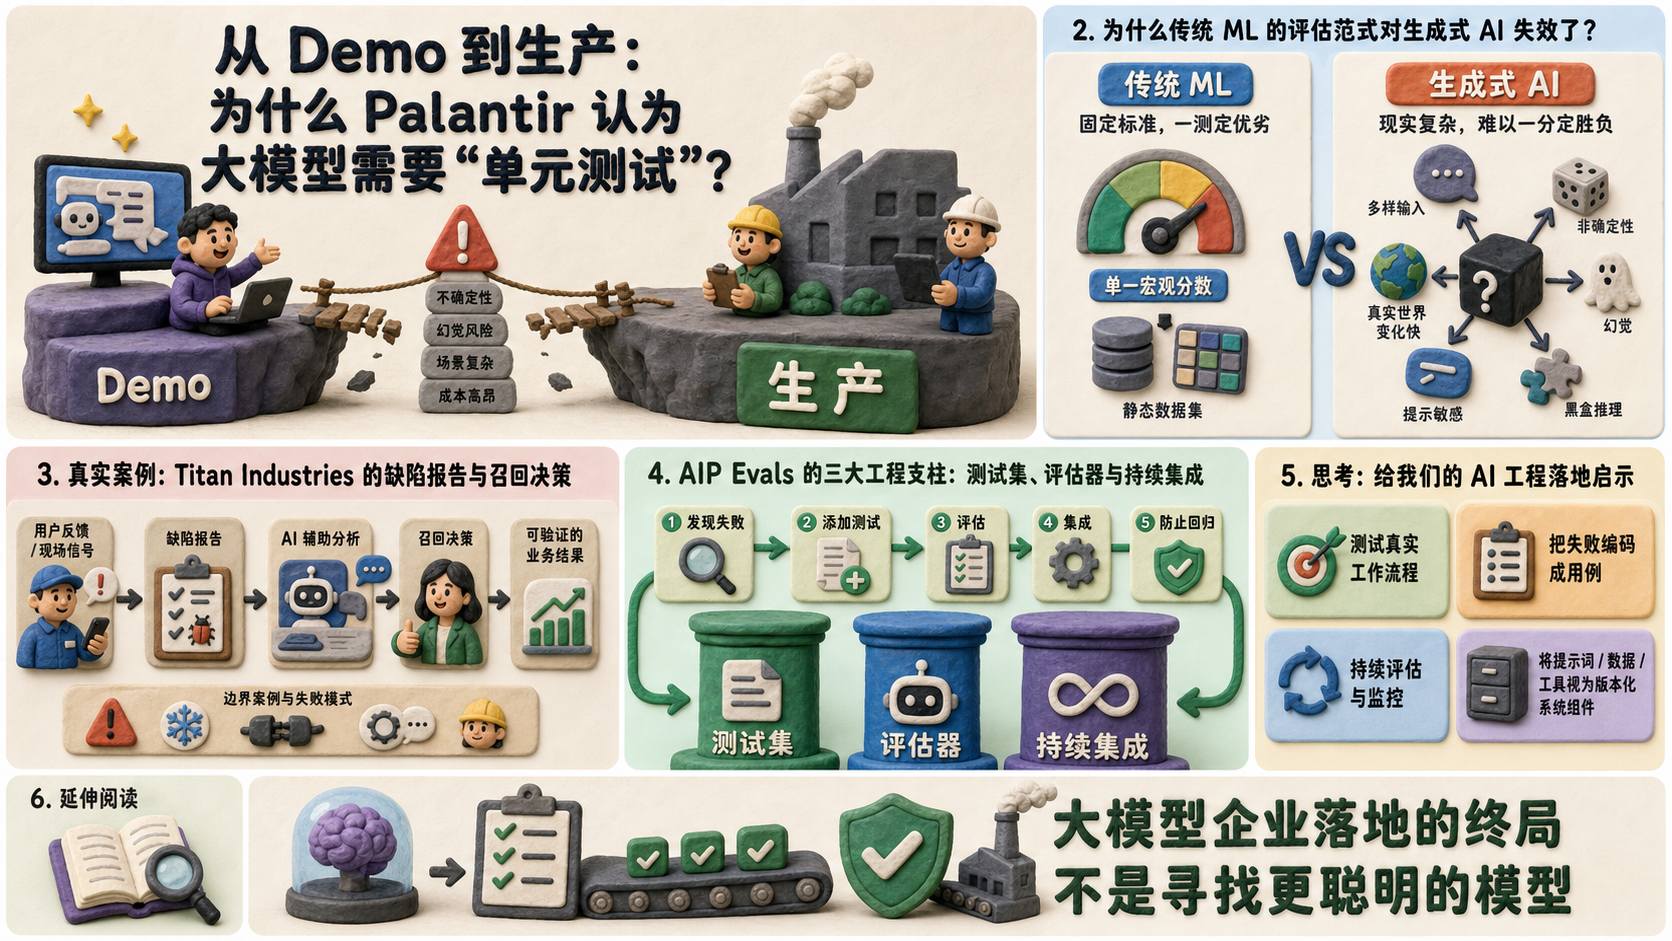
紫讯在流程嵌入期遇到的几类问题,指向同一个结构:项目知识分散在文档、协作工具、代码评审和个人笔记里,AI每次都要重新拼凑上下文;同一个问题在不同轮次、不同Agent中给出不同答案,结论无法复现;AI缺信息时倾向于补全空白,而不是显式承认缺口;文档过期后没有“过期感”,AI仍可能把旧内容当成权威规则。
这条因果链的关键在最后一步:知识分散导致AI补全空白,补全出的结论不可追溯、不可复现,评审和测试环节无法稳定验证,返工率自然不降。版本数提升只是把更多未经验证的产出推入流程,并没有减少流程本身的摩擦。
华为云CodeArts首席产品专家汪维敏提到,通过130家客户、500余条反馈揭示企业级AI编码的深层需求。这个数据来自客户反馈汇总,统计时间和样本范围未在文中说明,不能当作行业普遍水平的度量。但它至少说明,紫讯遇到的问题不是孤例——企业级客户在真实流程中碰到的障碍,集中在工程体系层面,而非模型生成能力层面。
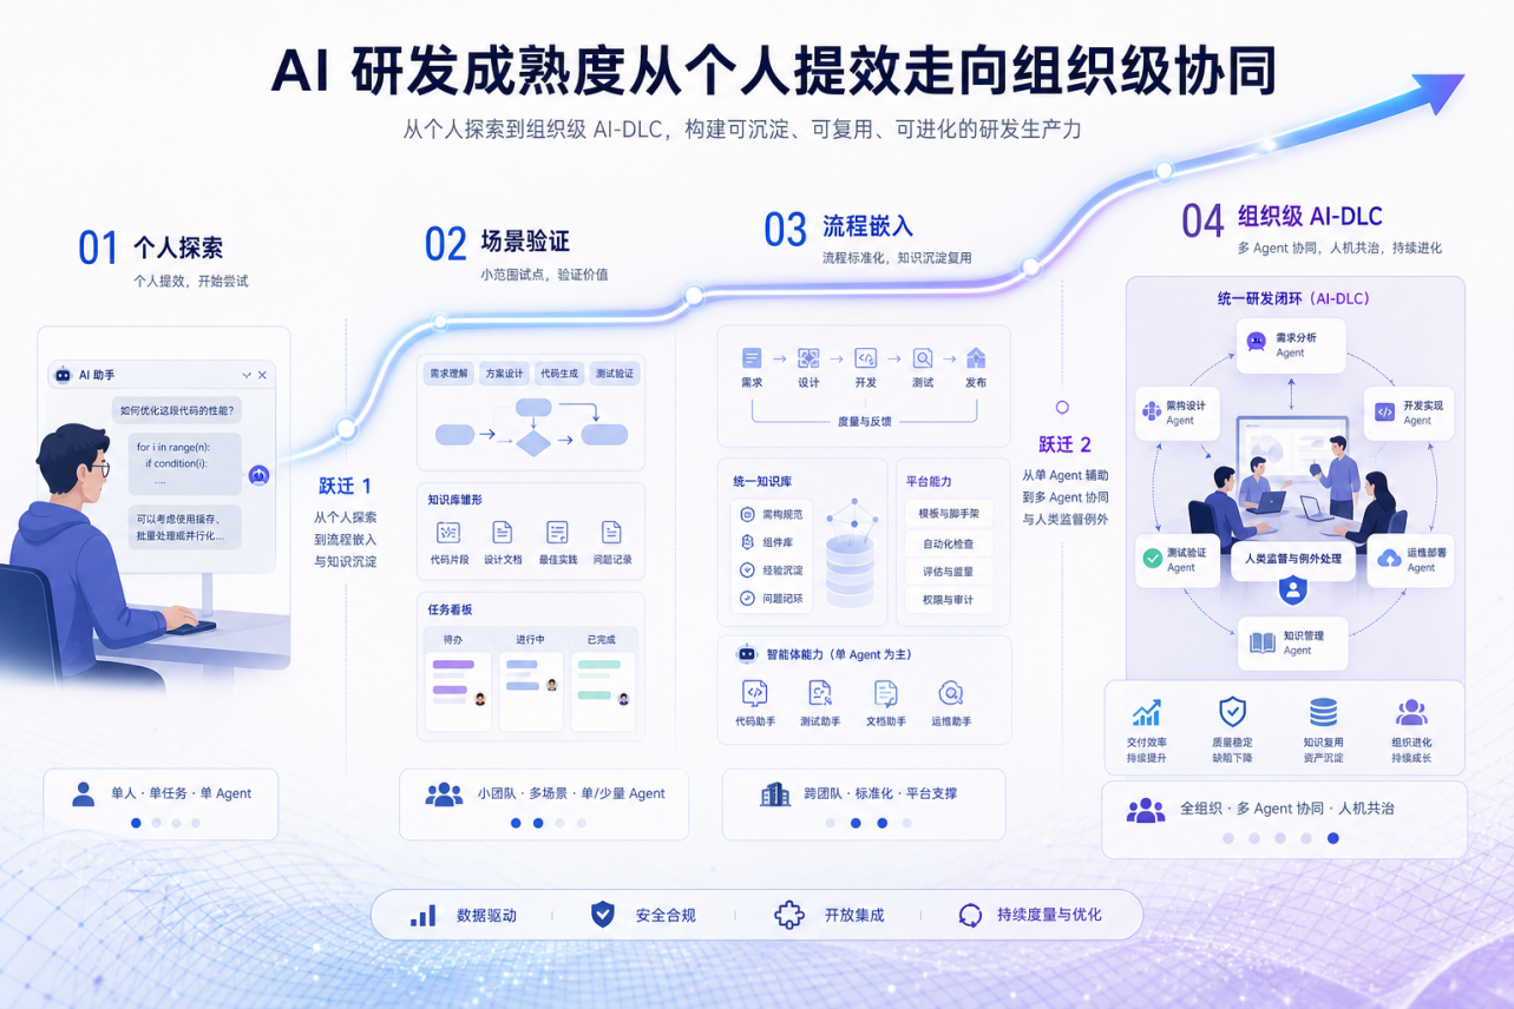
紫讯的判断是:AI原生研发的关键,不是让AI写更多代码,而是建设一套让AI能按工程标准稳定参与完整研发流程的体系。这句话放在版本数提升和返工率未改善的对照里,才显出分量。瓶颈已经从“生成速度”转移到“知识治理与流程可复现性”,个人提效无法自动转化为交付改善。既然瓶颈不在生成速度,那被重新定义的到底是什么?
被重新定义的是研发流程的约束条件
从代码生产者到规范设计者、工作流指挥家
角色变化的讨论容易停留在岗位名称上。极客时间一篇专栏开篇词把软件工程师的新定位概括为:从代码“生产者”到规范“设计者”,从任务“执行者”到AI工作流“指挥家”,从Bug“修复者”到系统质量“终极责任人”。这个表述来自单一专栏,没有附带数据或案例,作为行业判断需要打折。但它指向的方向和Vercel CEO Guillermo Rauch在BUILD 2025上的说法一致:AI将开发者角色从编写代码转变为有意图地引导智能系统。Rauch还强调,“交付”才是当代开发者最关键的元能力——从问题判断、产品设计、实现方式,到测试、迭代、讲清楚价值,并持续提高标准。
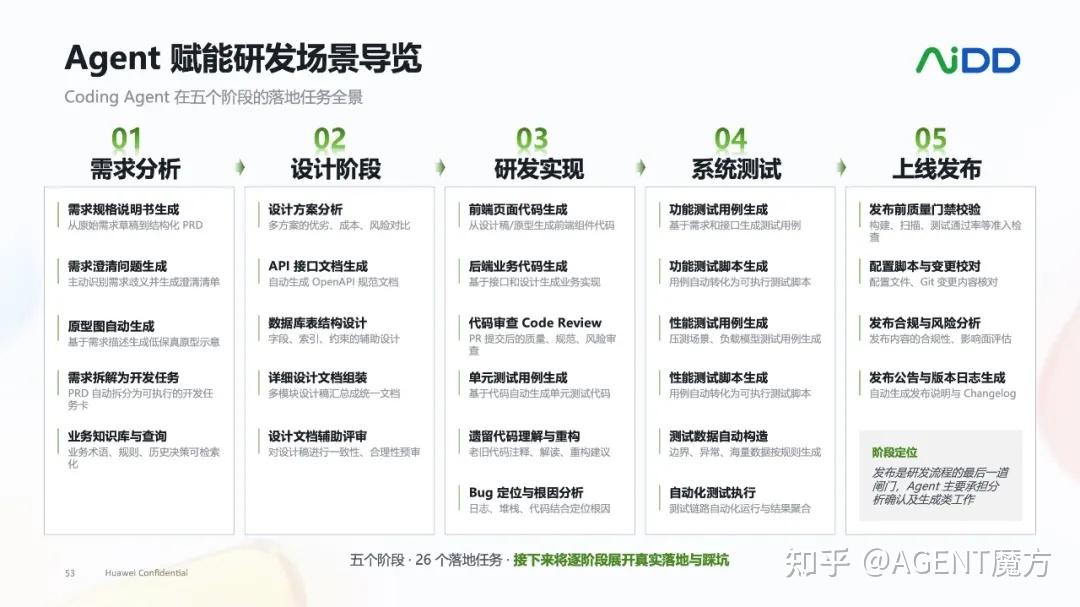
这两组表述都属个人判断,不是经过验证的行业事实。把它们放在一起看,能提取出一个共同的结构:人从执行链的中间环节退到两端——前端定义规范和意图,末端对系统质量负责。中间的执行密度被AI接管,但接管的前提是规范足够清晰、意图足够明确。
AI-DLC把多Agent放进同一可追溯链路

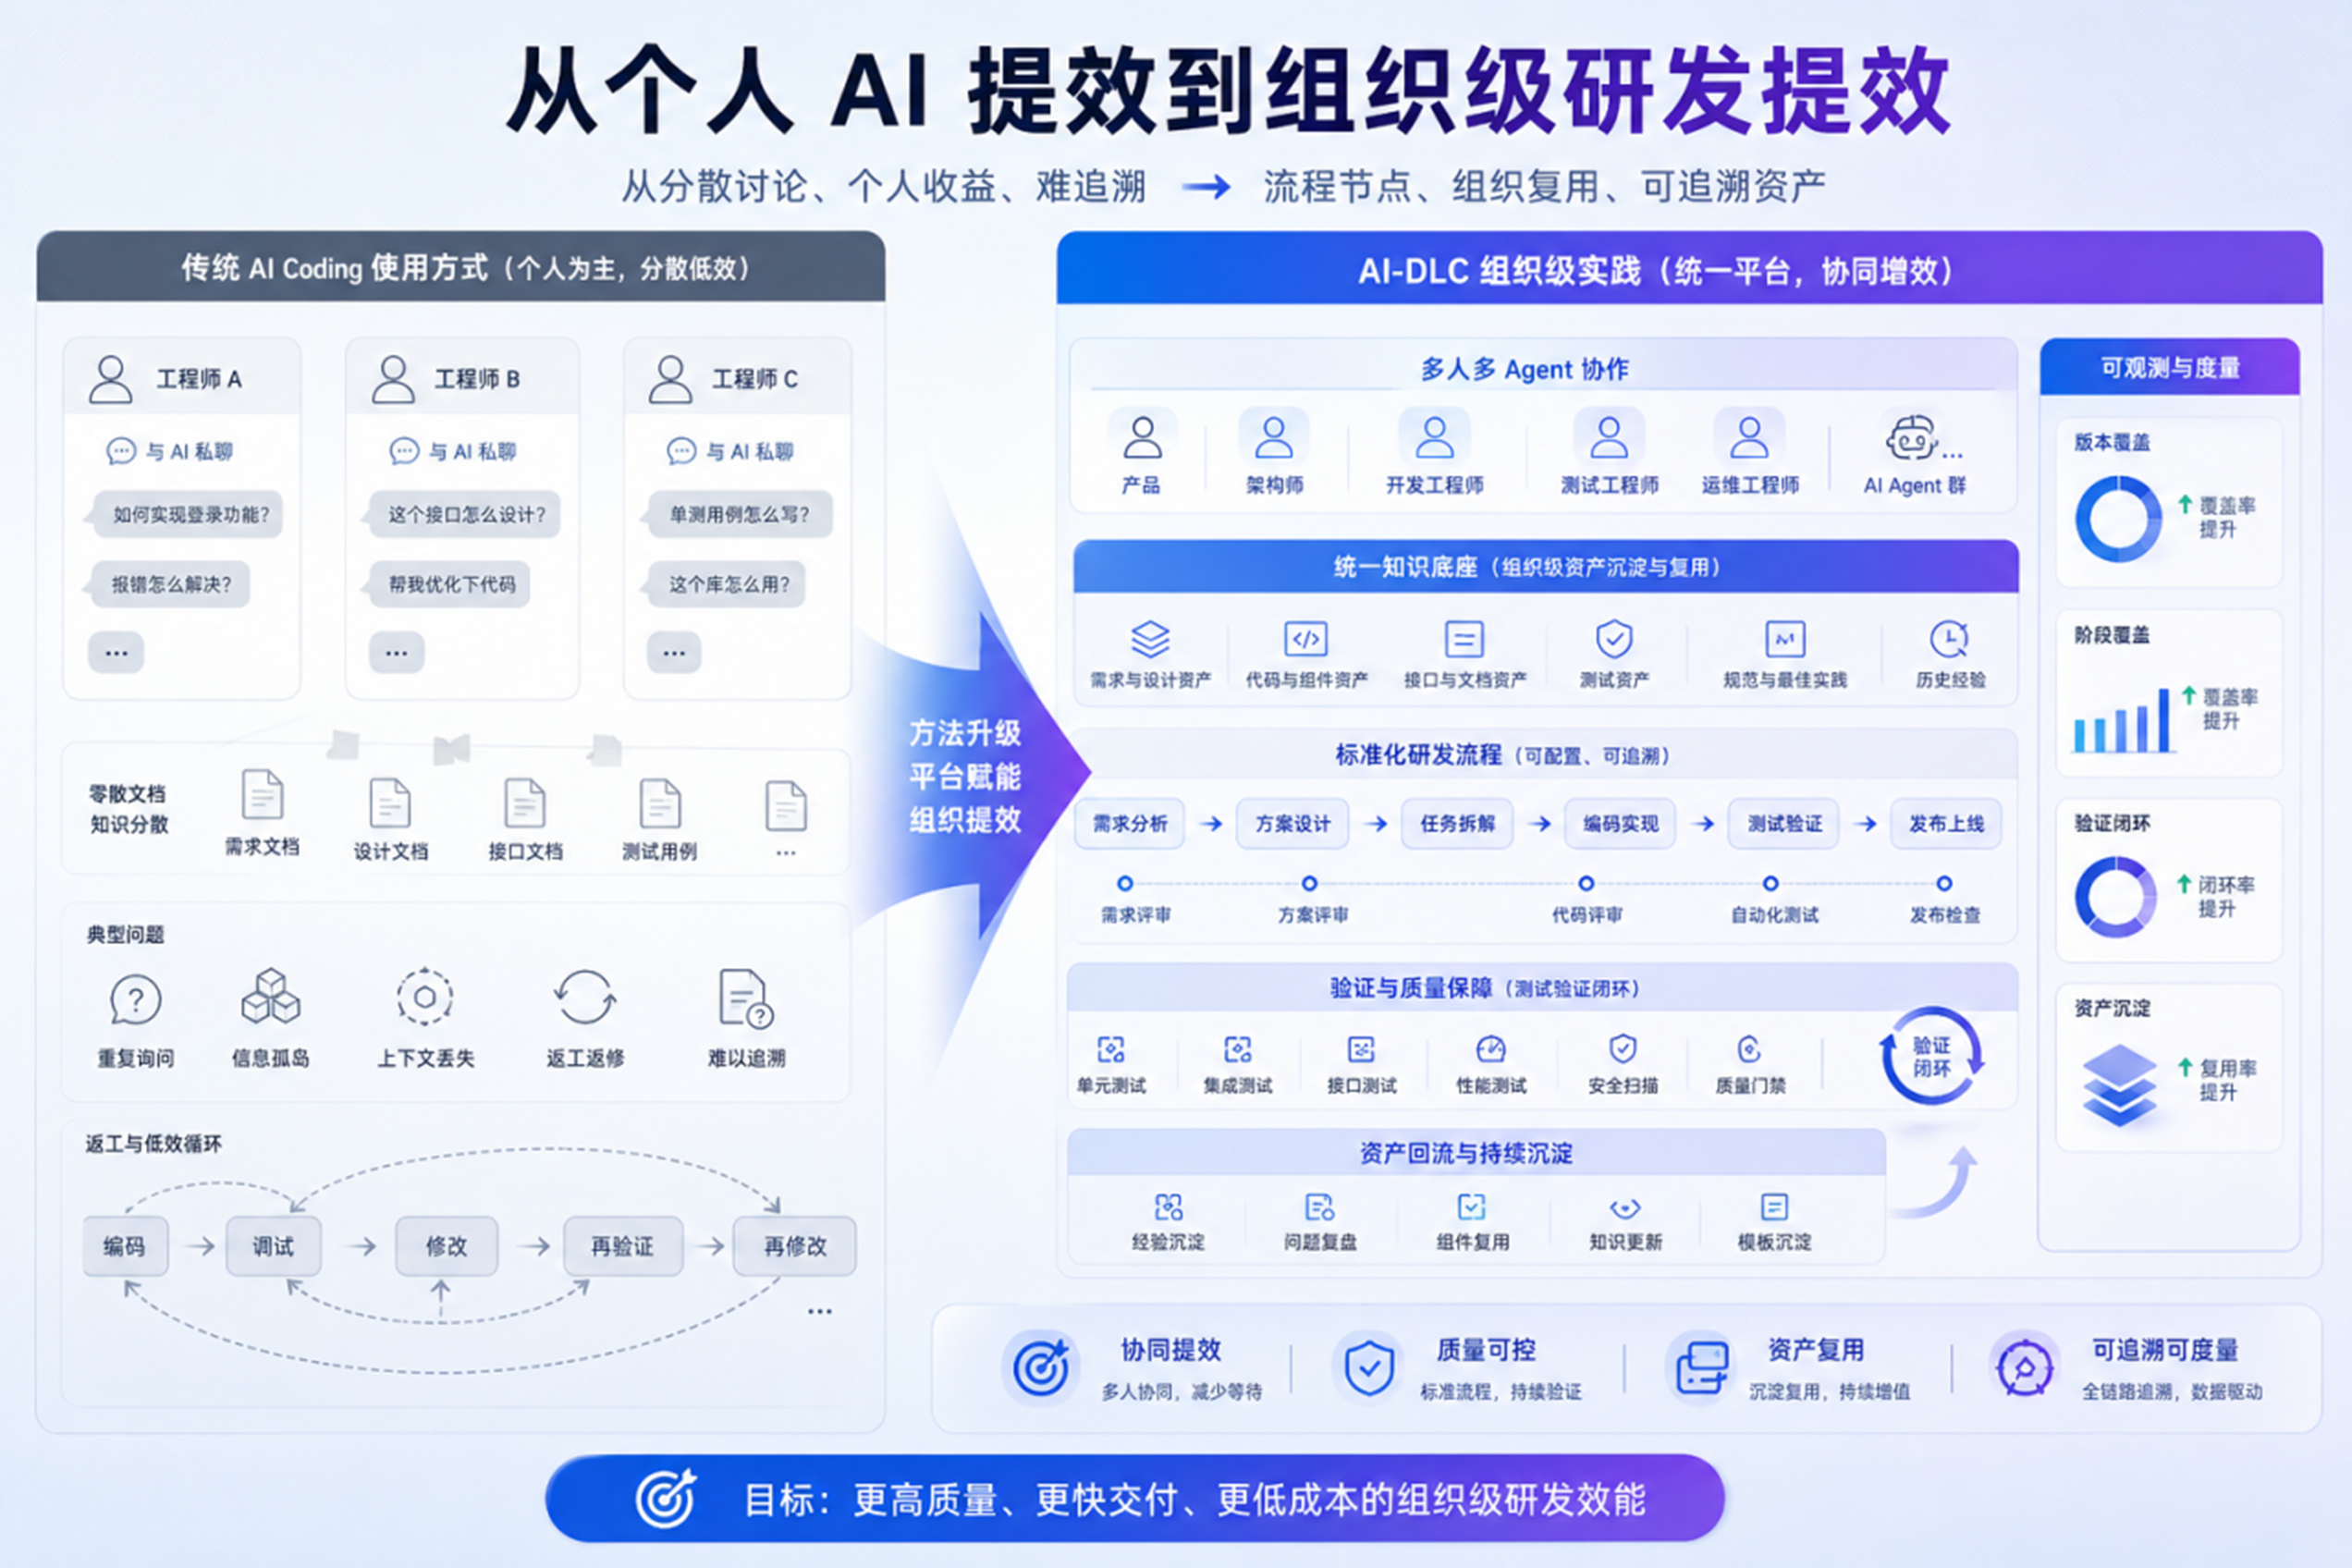
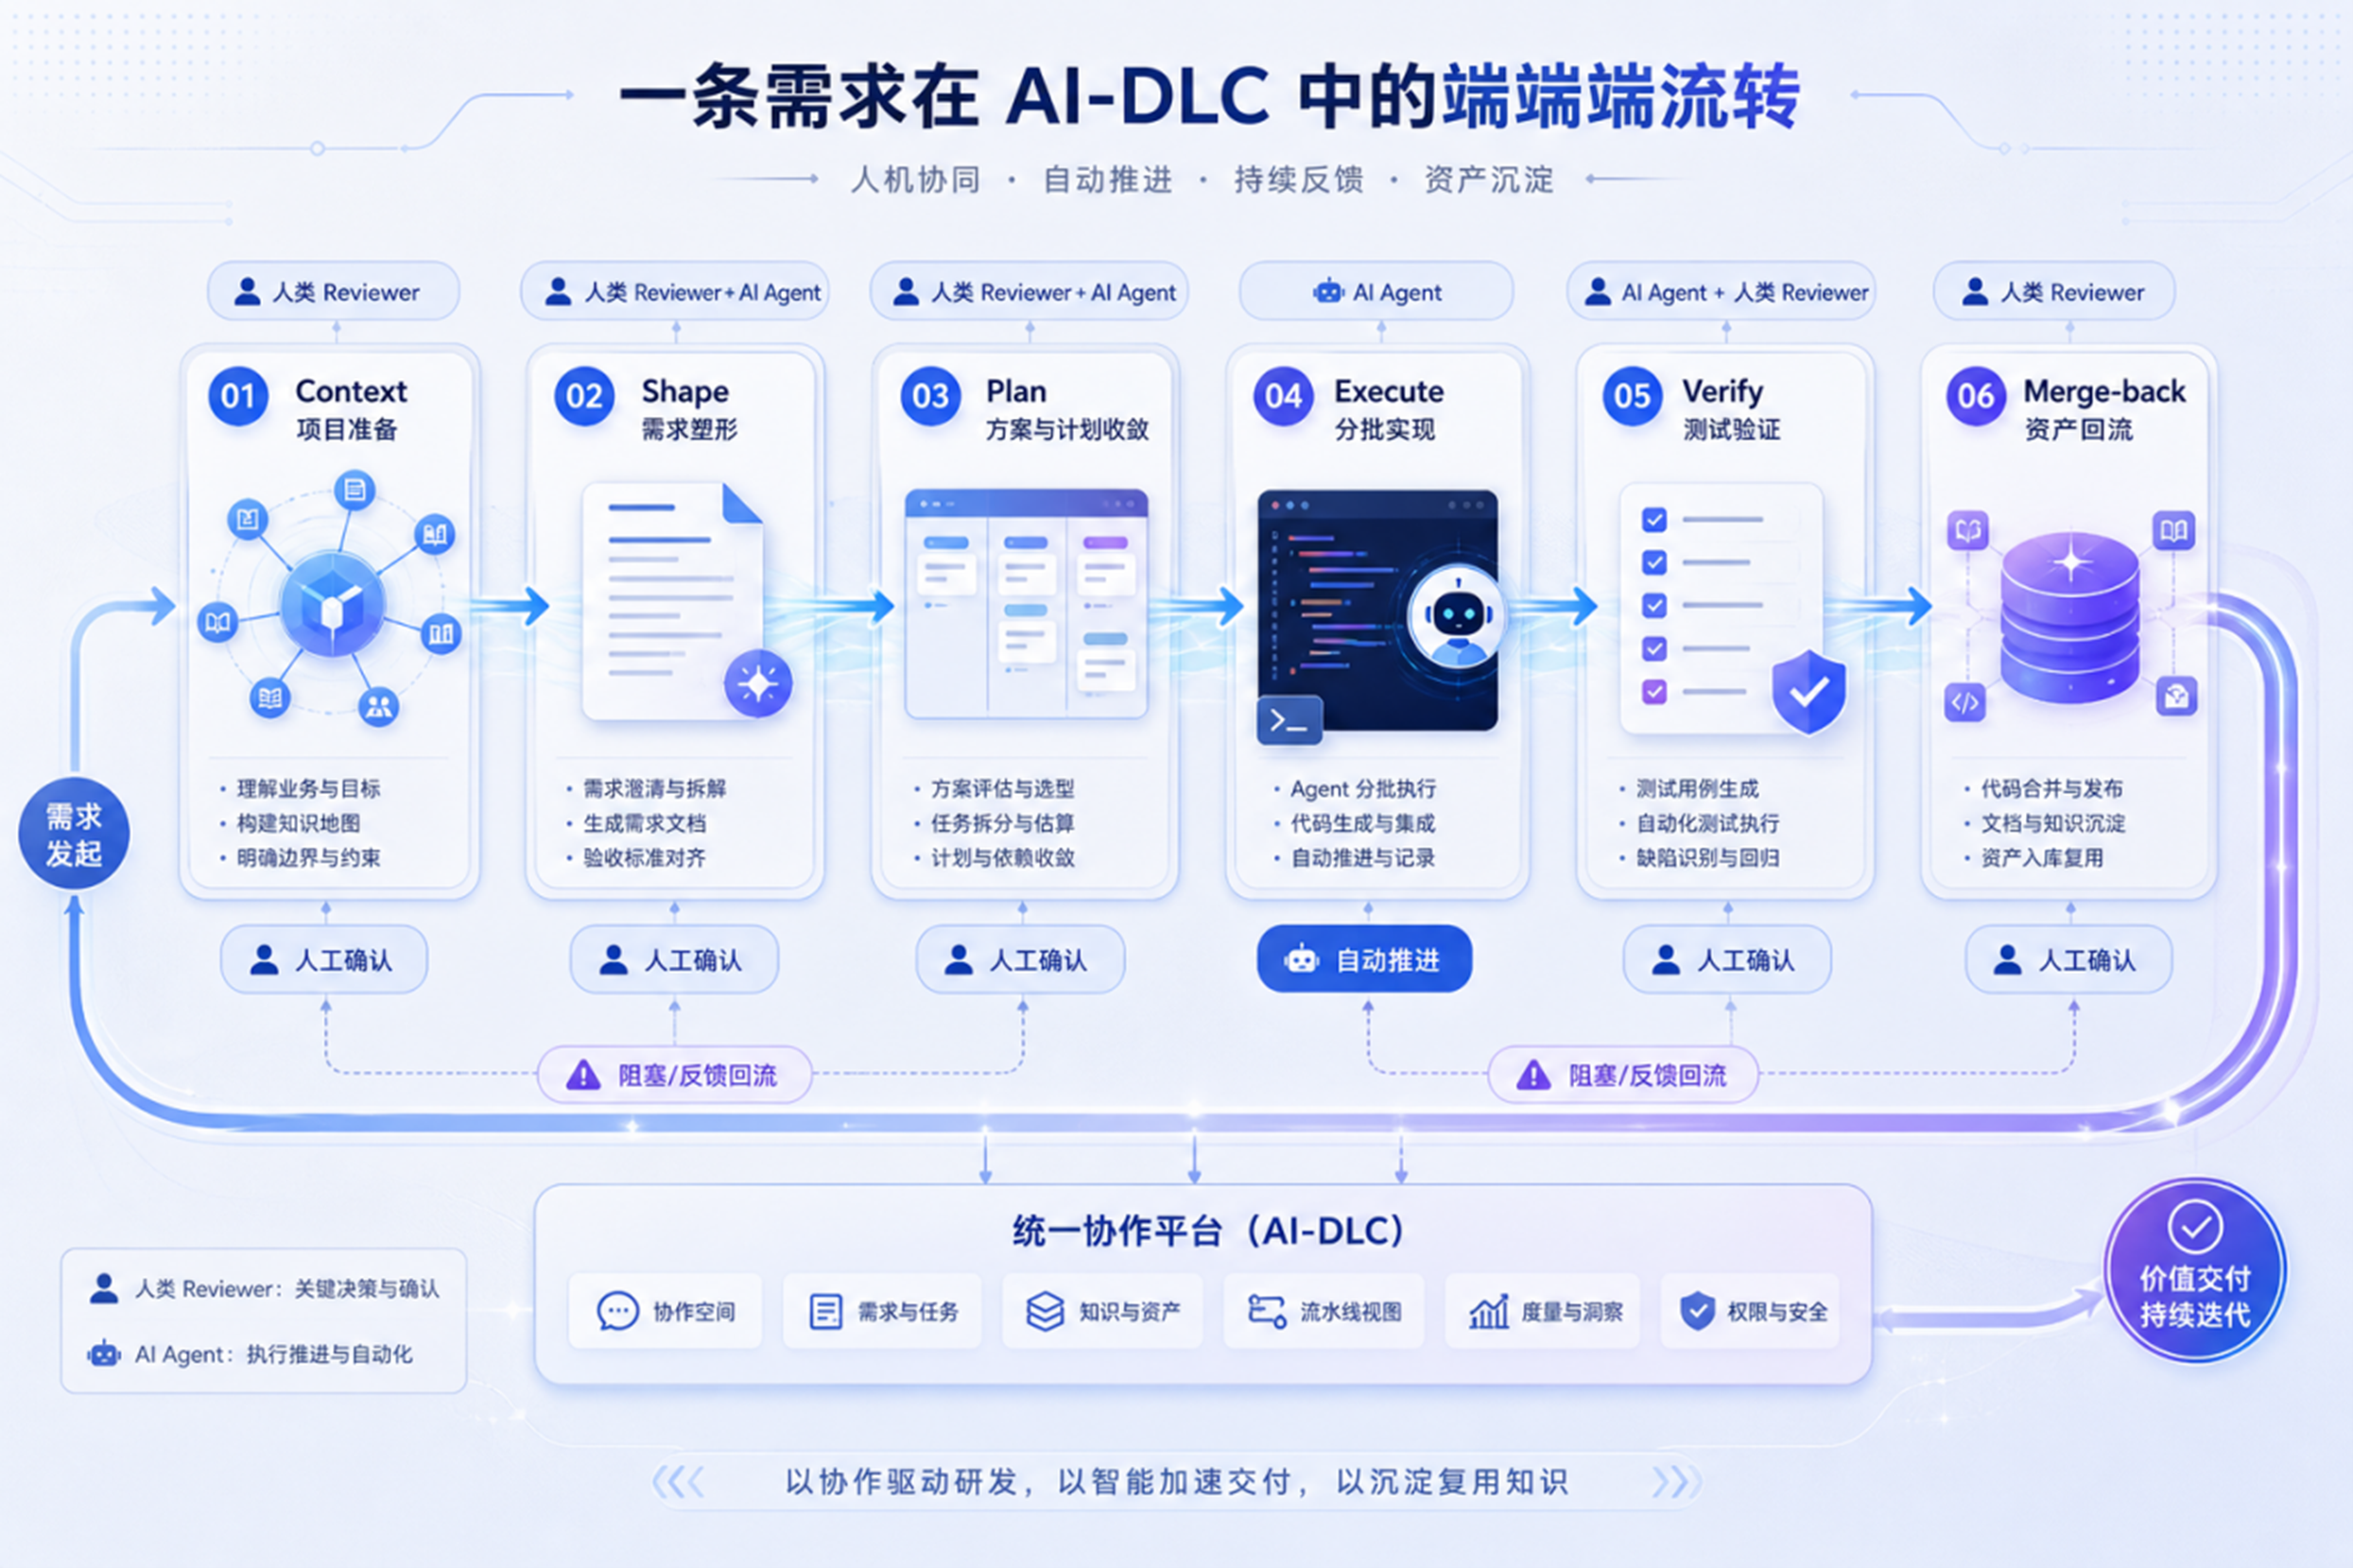
角色叙事是结果,流程约束条件的变化才是原因。紫讯的AI-DLC实践提供了一个具体参照:通过统一知识管理、流程规范、质量门禁和协作平台,让多人、多角色、多Agent在同一套可追溯链路中协同推进。这个案例来自AWS官方博客,属企业内部实践,不能直接外推为行业标准,但它展示的机制值得拆开看。
多Agent协同的难点不在单个Agent的能力,而在Agent之间的交接。谁在什么条件下把任务移交给下一个环节,中间产物以什么格式留存,出问题时能否回溯到具体步骤——这些问题靠更快的模型解决不了。统一知识管理解决的是上下文一致性,流程规范解决的是交接标准,质量门禁解决的是每个环节的准出条件,协作平台解决的是人和Agent在同一视图下工作。四者缺一,多Agent协同就会退化成多个独立工具各自为战。
企业级安全合规的要求进一步收紧了约束条件。端到端安全沙箱、最小权限控制、全链路行为审计被视为企业将AI引入核心研发流程的前提。这条来自知乎专栏的表述没有给出具体企业案例或量化验证,但逻辑上成立:如果AI在研发链路中的行为不可审计,企业不会把核心流程交给它。
约束条件被重写后,失效的场景也随之清晰。当知识管理散落在个人手中、流程规范只存在于口头约定、质量门禁依赖人工判断时,多Agent协同就缺少可追溯的载体。此时增加Agent数量不会提升产出,只会放大交接损耗。

这条路径成立的前提,以及它可能不成立的地方
安全沙箱、最小权限、全链路审计是入场券
企业级安全合规的要求,在多数讨论中被当作落地时的附加项,但它在AI主导研发的路径上实际是前置条件。端到端安全沙箱、最小权限控制、全链路行为审计,这三项被来源文章明确列为AI协同开发在可控、可审计框架下落地的前提。逻辑并不复杂:如果AI在研发链路中的行为无法被完整记录和回溯,企业就不会把核心流程交给它。这不是保守,而是权责问题——当Agent自主完成需求分析、代码生成、测试执行时,出错后需要定位到具体环节和具体决策,没有审计链就没有追责基础。
紫讯与亚马逊云科技在2025年12月组织的AI-DLC专题Workshop,属于单一个案,但它反映了一个趋势:企业开始把AI原生研发当作需要系统性建设的能力,而非工具采购。紫讯自己的判断是,关键不是让AI写更多代码,而是建设一套让AI能按工程标准稳定参与完整流程的体系。
当知识治理缺位,AI只会放大不可复现
紫讯在把AI放进真实研发流程后遇到的问题,恰好构成这条路径的反面证据。项目知识分散在文档、协作工具、代码评审和个人笔记中,AI每轮都要重新拼凑上下文;同一个问题在不同轮次、不同Agent中给出不同答案,结论无法复现;AI缺信息时倾向于补全空白,而不是显式承认缺口;文档过期后没有“过期感”,AI仍可能把旧内容当成权威规则。这些问题的共同指向是知识治理缺位。
在知识治理缺位的情况下,AI带AI的递归不会收敛,只会放大错误。每一轮Agent的输出都建立在上一轮不可复现的结论上,返工率不会因为生成速度提升而下降。紫讯的个案经验显示,个人提效明显,但需求交付周期、跨角色协作效率和返工率并没有同步改善。这不是模型能力问题,而是工程体系问题。缺少可追溯、可复现的知识载体,递归自我改进就退化为演示。
对普通读者而言,这意味着什么?判断一个组织是否适合推进AI主导研发,看的不是它用了多强的模型,而是它的知识管理是否集中、流程规范是否可执行、质量门禁是否可自动化。这些条件不具备时,增加Agent数量只会加速不可复现的返工。