AI的下半场,快比多值钱
当大模型知识储备趋同,端侧30B模型和130毫秒决策的出现,说明行业投入正从扩大知识面转向压缩决策时间。本文解释为什么响应力是智能体进入实时场景的前提,同时划清其适用边界——快速决策只对结构化选择有效,且个人智能体的稳定落地可能要到2027年之后。
AI的下半场,快比多值钱

知识量不再是壁垒,响应速度才是
大模型的知识储备正在趋同。头部模型在语言理解、常识推理和代码生成上的差距,已经不足以构成稳定的产品壁垒。当模型都能读懂邮件、总结会议、生成合规文本时,用户感知到的差异不再是“谁懂得更多”,而是“谁先给出能用的结果”。

行业投入的方向随之改变。2024年,端侧模型的主流规模还在7B上下;到2026年骁龙峰会上,高通与阶跃合作,在参考设计上跑通了30B参数级别的MoE模型,完成邮件理解、行程规划和日历同步。30B此前基本只能在云端部署,这次通过芯片、模型、推理引擎与存储的协同设计,首次在智能手机上实现持续稳定运行。MoE架构的稀疏激活机制,使30B模型的实际计算量可以压缩到7B至13B稠密模型的水平,这是它能够落到端侧的关键。

同一时期,Cloudflare发布的Clef-omni把决策延迟压到了另一个量级。它的文本请求P50延迟约为130毫秒,图像请求约为150毫秒。这个模型基于Qwen3-Omni-30B-A3B-Instruct骨干构建,不生成散文,而是从给定选项中选择最佳项并附上概率分数,面向路由、分类和智能体动作选择。130毫秒意味着,在人类几乎察觉不到的间隔里,模型已经完成了从输入到动作选择的全过程。
端侧30B模型和130毫秒决策,看似分属硬件和推理优化两个领域,实际上指向同一件事:压缩从感知到行动的时间。知识量不再是稀缺品,响应力才是。当模型的知识面足够覆盖常见任务,决定体验的就不再是它还能多懂一点,而是它能不能在用户失去耐心之前,把正确动作做完。
这个判断有边界。在需要深度推理、长程规划或开放生成的场景中,知识量和推理质量仍然优先于速度。一个慢但正确的法律分析,比一个快但浅的摘要更有价值。但当任务本身已经被充分理解、选项空间明确时,速度就从体验问题变成了能力问题。
端侧30B不是参数竞赛,是耐心竞赛
30B参数模型出现在手机上,首先需要解释的是一个技术矛盾:手机的内存和算力长期只够承载7B到13B参数的模型,30B意味着参数规模翻了一倍以上。矛盾之所以被化解,在于MoE架构的稀疏激活机制。模型虽然拥有30B总参数,但每次推理只激活其中一部分专家模块,实际计算量被压缩到7B至13B稠密模型的水平。参数规模扩大了,运行成本却没有等比上升。
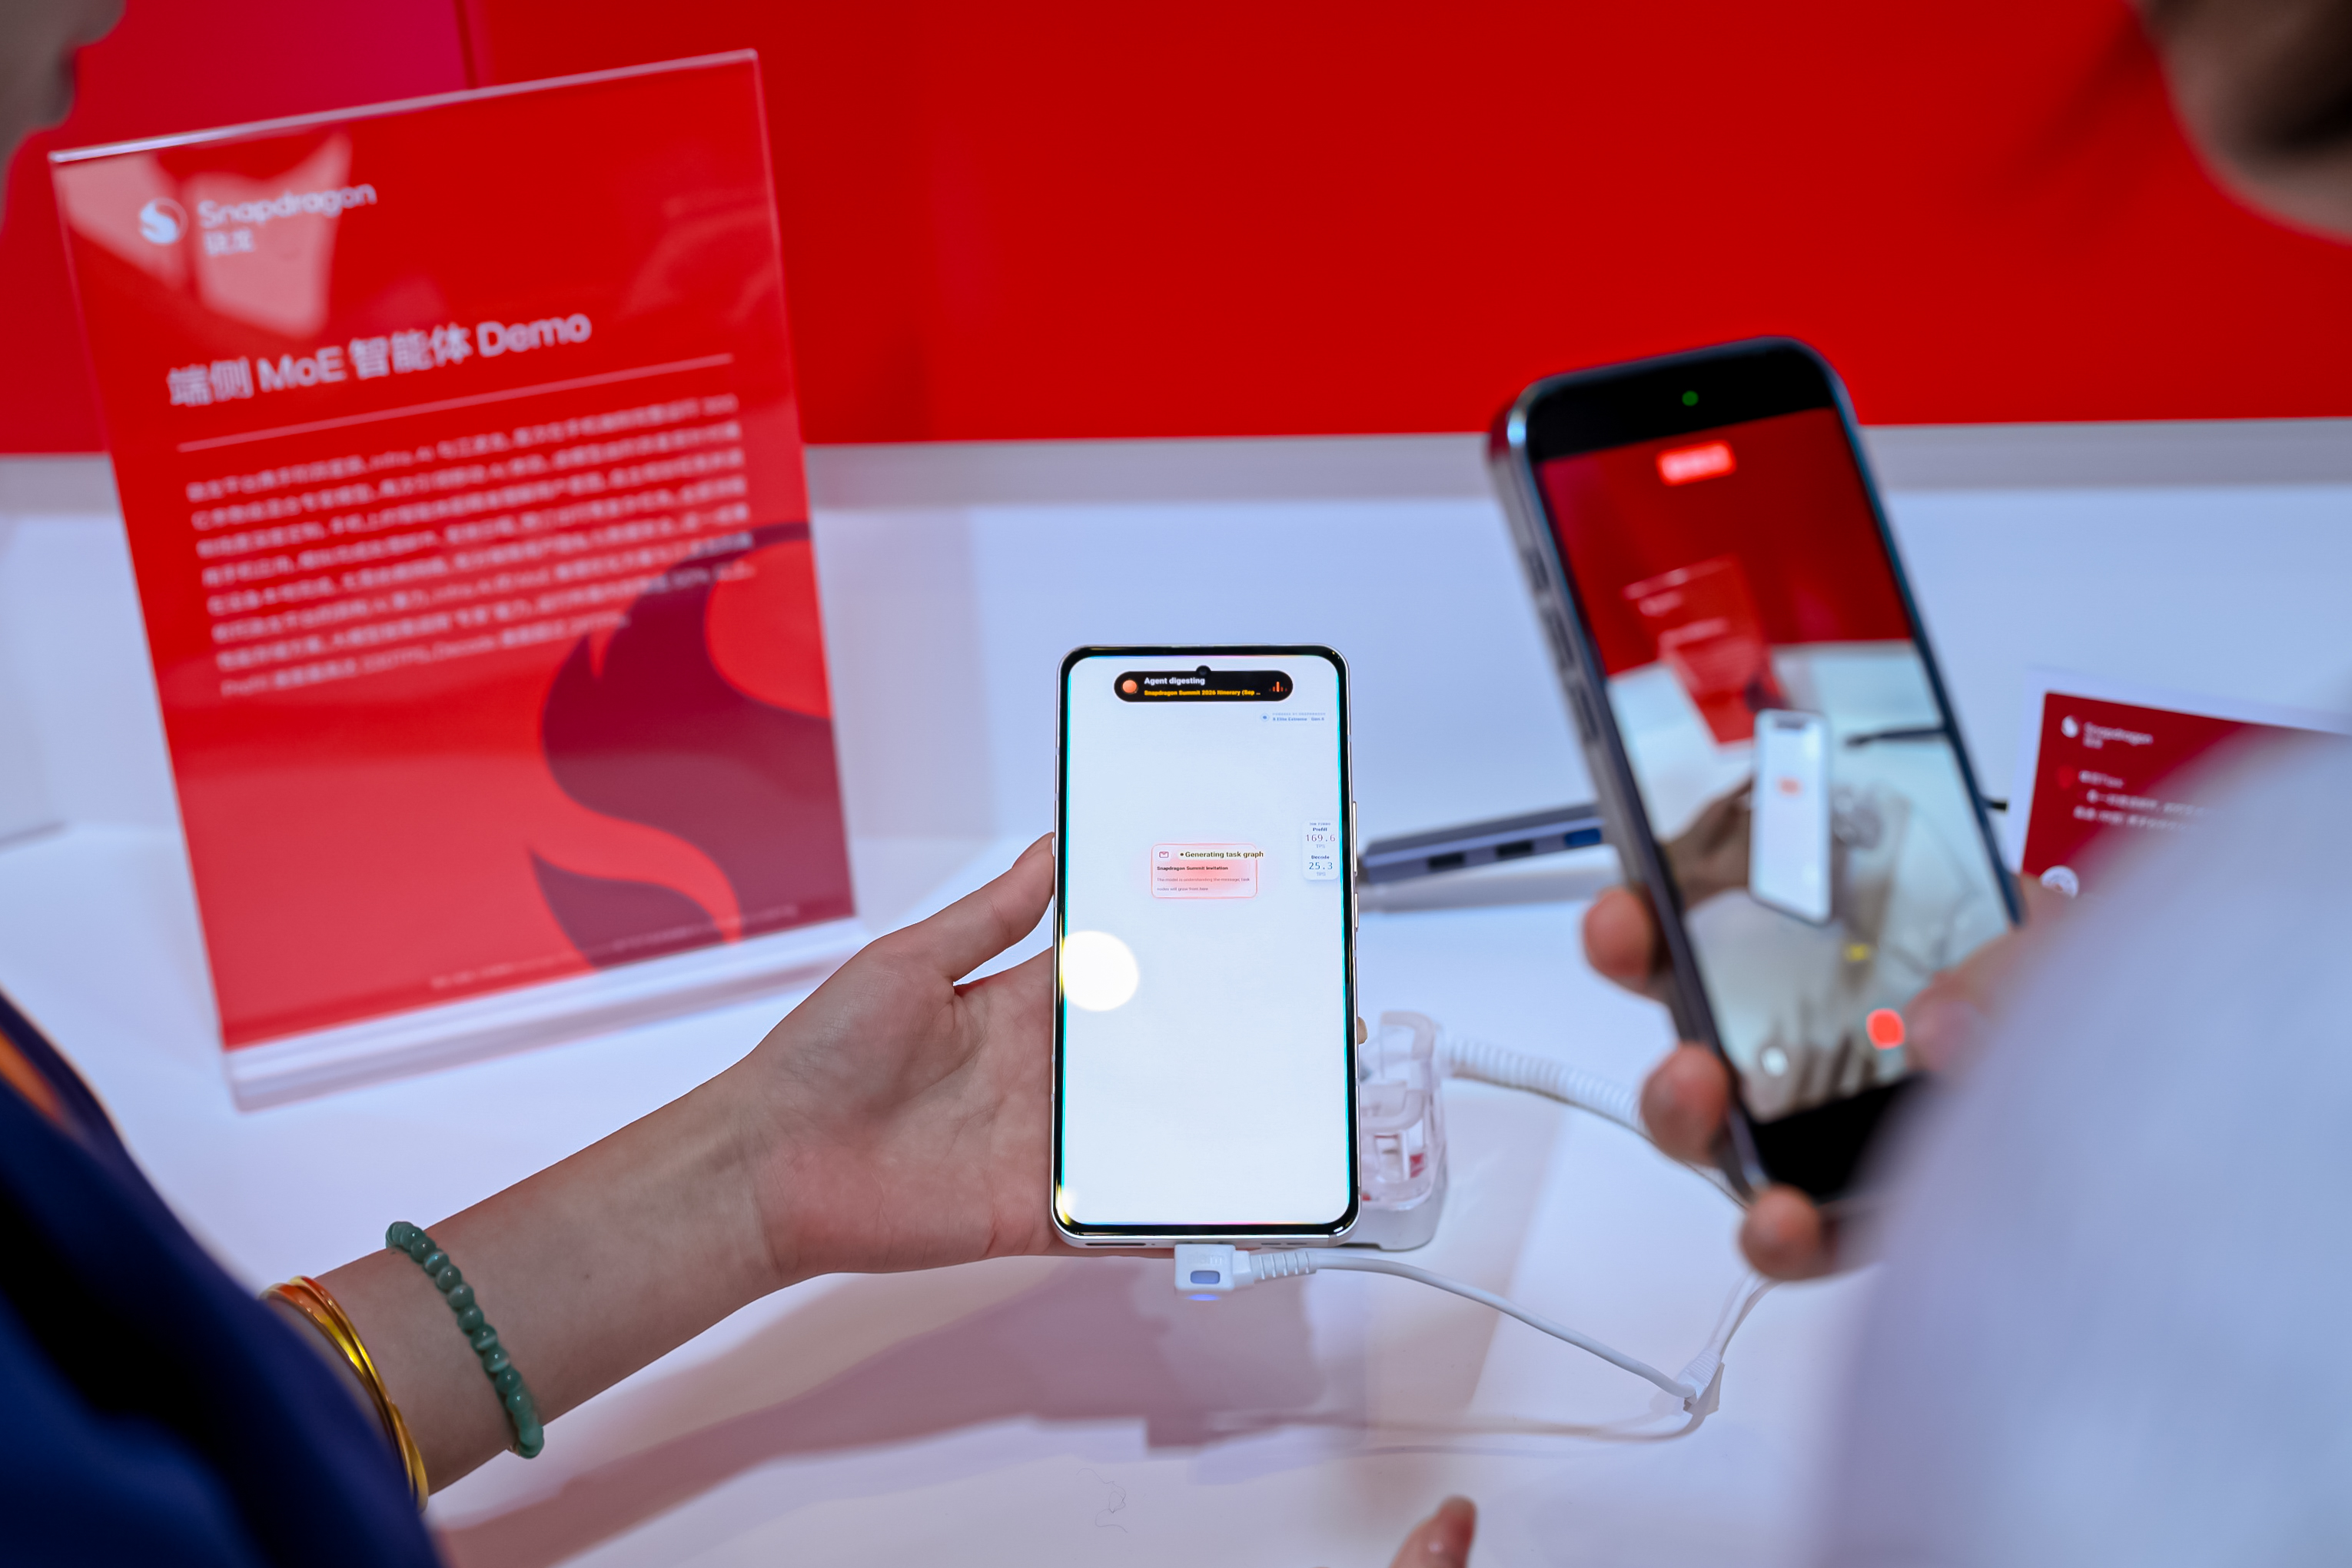
真正让这件事从实验室演示变成可运行方案的,是推理引擎和芯片调度两层的配合。无量火自研的Ember推理引擎将阶跃30B-MoE模型的运行内存需求降低了超过50%,这是端侧部署能否成立的关键一步。芯片层面,第六代骁龙8超级至尊版把任务拆开:CPU负责工具调用和任务调度,NPU承担模型推理,低功耗感知单元处理后台信息。NPU与GPU双引擎协同后,预填充吞吐超过330 Token/s,解码吞吐超过28 Token/s,首个词元生成达到毫秒级。

这些数字指向同一个结果:端侧模型不再只是“能跑”,而是可以连续工作。2026年骁龙峰会上的演示展示了这种工作方式的变化——端侧30B-MoE模型读懂一封邮件,提取行程信息,同步日历,推荐航班和酒店,再草拟回复。整条链路涉及理解、规划和多次工具调用,但不需要把每一步都发到云端等待返回。网络往返这个最大的延迟来源被从执行链中移除了。
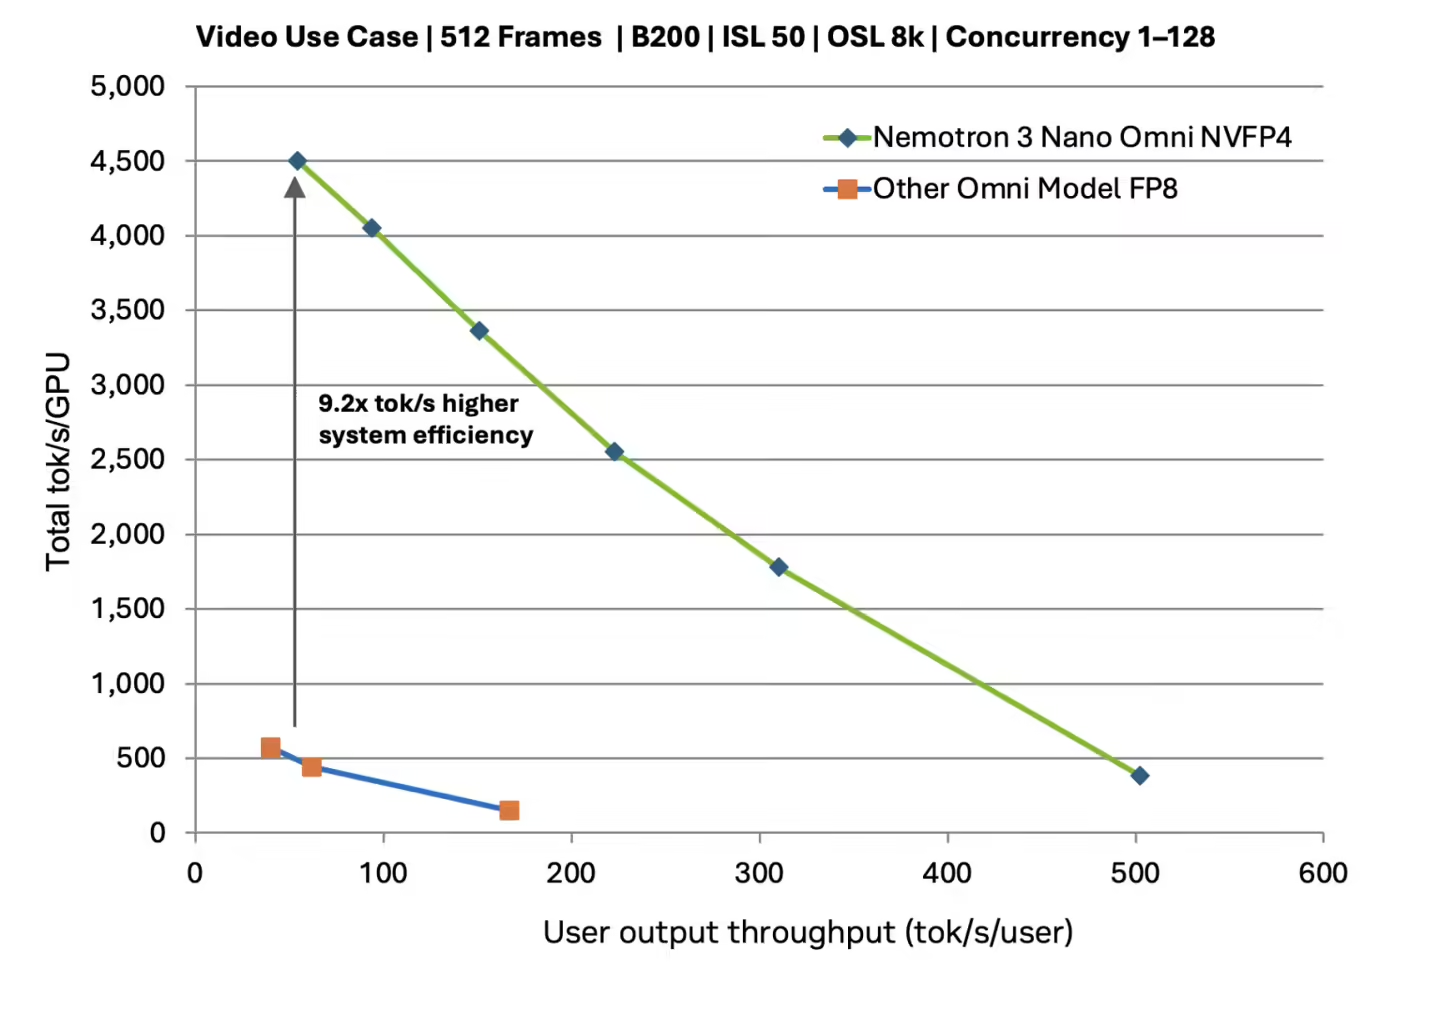
NVIDIA对同一问题的判断从另一个方向印证了这一点。其发布的Nemotron 3.5 Lightning同样是30B参数的MoE模型,每个token仅激活3B参数,定位明确:常驻智能体的执行层,而非推理或规划。NVIDIA博客作者给出的理由是,长期运行的AI智能体大部分时间花在高频执行上——工具调用、结果验证和子智能体委派。这些动作不需要模型在每一步都重新思考全局,需要的是快速、稳定地把当前步骤做完。
端侧部署并非没有代价。高通中国区董事长孟樸指出,大模型每3个月迭代一次,而手机适配周期长达9到12个月。这意味着端侧模型从设计到落地,天然落后于云端前沿能力。端侧30B解决的是一次部署后的连续执行效率,而不是保持模型能力的最新状态。对于需要调用最新知识或最强推理能力的任务,云端仍然是不可替代的。端侧模型的价值边界很清楚:它适合那些任务结构已经明确、需要反复执行、对延迟敏感的环节,而不是替代云端去做深度推理或开放生成。
150毫秒决策只对“选择”有效,对“生成”无效
速度优势来自一个容易被忽略的设计取舍:这些模型不写句子,只做选择。Clef-omni基于Qwen3-Omni-30B-A3B-Instruct构建,输出不是一段自然语言,而是从给定选项集中挑出最佳项,并附上每个选项的概率分数。文本请求的P50延迟约130毫秒,图像约150毫秒,21秒带音频的视频约1.5秒。这样的速度之所以可能,是因为模型放弃了生成式模型的自由度——它不需要逐token构造一个完整回答,只需在有限的候选动作间分配概率。路由、分类、工具选择、动作触发,这些任务的答案空间在调用之前就已经确定,模型的工作是判断而非创作。
NVIDIA的Nemotron 3.5 Lightning沿用了同样的逻辑。这个30B混合专家模型每token仅激活3B参数,定位是常驻智能体的执行层。NVIDIA博客作者Chris Alexiuk和Chintan Patel给出的判断是,长期运行的AI智能体大部分时间花在高频执行上:工具调用、结果验证和子智能体委派。这些环节的共同特征是任务结构清晰、选项有限、重复发生,不需要模型在每一步重新审视全局。NVIDIA据此提出一个明确的架构分工:前沿模型负责编排和复杂规划,更小、更高效的模型处理高频执行层。这不是同级别模型之间的速度竞争,而是把智能体系统拆成两层,让不同能力的模型各司其职。
这种分工的前提值得认真对待。它只在任务可以被清晰分解为“规划”和“执行”两层时成立。一旦任务本身是模糊的、需要持续推理的,或者选项空间无法预先枚举,快速决策模型就失去了工作基础。一个需要理解合同条款并给出法律判断的任务,不能被压缩成一组候选动作;一个需要根据对话上下文逐步调整策略的谈判智能体,也无法把每一步都交给只做选择的模型。在这些场景中,云端大模型仍然承担主要推理工作,快速决策模型至多负责中间某个明确的子步骤。

Clef-omni的另一个设计选择进一步印证了这个边界。它直接接受wav、mp3、mp4和webm文件,在一次API调用中处理文本、图像、音频和视频,省去了单独的转录服务和帧切分流水线。来源认为这是实际收益,因为典型视频流水线中每个环节都会增加延迟、成本和故障模式,且转录会丢弃可能携带信号的声音语气和时机信息。这个判断成立的前提是:下游任务只需要对多模态输入做出分类或选择。如果任务要求理解视频中的论证逻辑、生成详细摘要,或者对内容进行批判性分析,跳过转录和帧切分就会变成信息损失,而不是效率提升。
速度的价值高度依赖任务结构。当选项空间明确、判断标准稳定、错误成本可控时,亚秒级决策从体验优化上升为能力门槛。当任务需要开放生成或深度推理时,快并不能弥补浅。智能体系统的设计问题因此不是“选快还是选准”,而是能否在架构层面识别出哪些环节属于执行层,哪些环节属于规划层,并让合适的模型承担合适的部分。
2027年之前,别指望它替你订机票

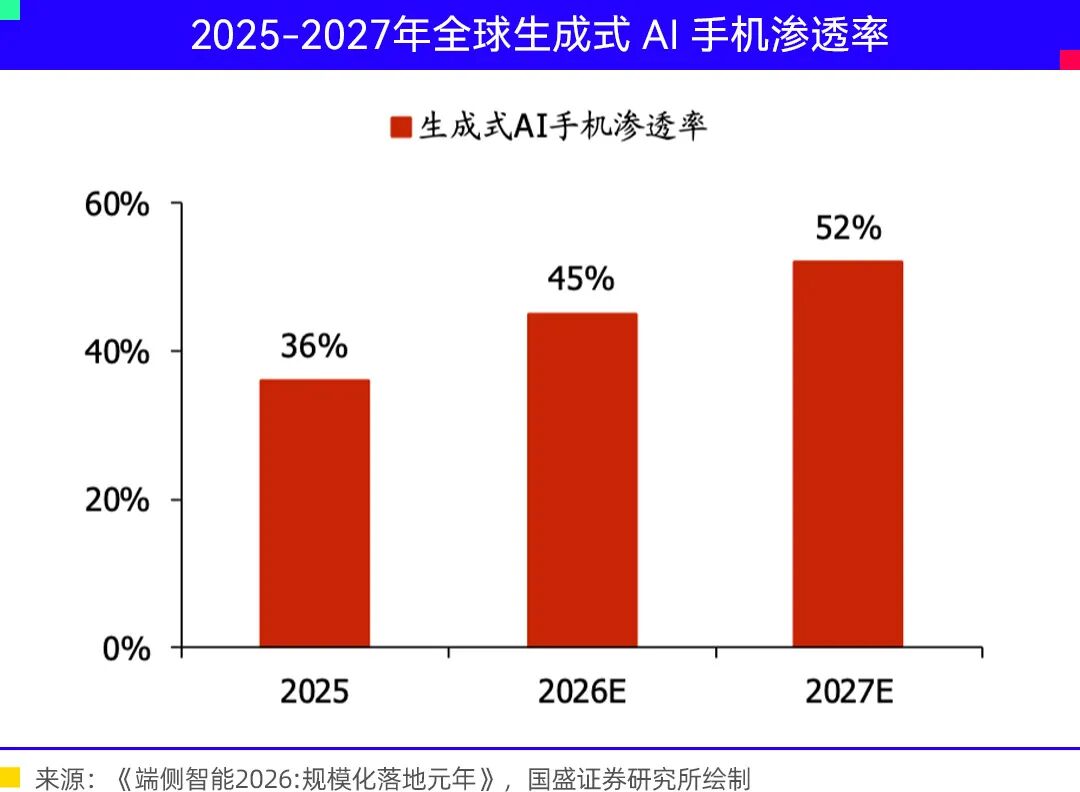
技术演示跑通和产品稳定落地之间,隔着一条不短的时差。高通中国区董事长孟樸给出的判断是,跨终端持续服务的个人智能体,可能要到2027至2028年才会比较稳定地开始逐步落地。这个时间表的依据不在模型能力本身,而在两套节奏的错配:大模型每3个月甚至更短时间就迭代一次,智能手机完成适配后却可能9到12个月无需调整。端侧模型从设计到部署,天然落后于云端前沿能力;一次适配做完,模型已经换了两三代。
这不是哪家公司执行不力,而是端侧部署的结构性代价。云端模型可以随时更新,端侧模型必须跟着芯片、操作系统和功耗约束走完一整套适配流程。模型迭代越快,端侧追赶的成本越高。所谓“2027到2028年稳定落地”,实质是在等两件事同时发生:模型能力增速放缓到终端适配周期可以消化的程度,以及端侧算力足够支撑一个不需要频繁更换的模型版本。
过渡期的现实方案是端云分工。科大讯飞总裁吴晓如给出的分工账是:约60%的问题由端侧独立完成,30%通过端云协同解决,剩余约10%的复杂任务走纯云端。这个比例承认了端侧的局限性——它负责高频、低延迟、任务结构明确的环节,云端承接需要最新知识或深度推理的部分。前提被吴晓如点得很明确:端侧的效果要好。如果端侧模型在60%的任务上频繁出错,协同分工就失去了意义。

车载场景可能比手机更早达到可用状态。座舱任务封闭、场景可控,端侧模型不需要应对跨应用、跨终端的碎片化环境。科大讯飞星火智慧座舱3.0的端侧增强哨兵模式覆盖16类风险事件,单事件4秒下发研判结果,识别准确率90%。这类指标说明,在边界清晰的任务集合里,端侧模型已经可以稳定运行。手机端个人智能体则要面对应用之间数据不互通、权限体系割裂、任务链条跨越多个终端的问题,落地难度高出一个量级。
2027年之前,端侧智能体会在座舱、安防、工业检测这类封闭场景里积累可靠性,但替用户跨应用订机票、改行程、协调多终端连续服务的个人智能体,仍处在适配周期与模型迭代速度的拉锯中。产品化的瓶颈不在“能不能做”,而在“能不能稳定地做,并且不需要每三个月推倒重来”。