友谊医院把第一道分诊交给AI,真正的问题是答错了谁认账
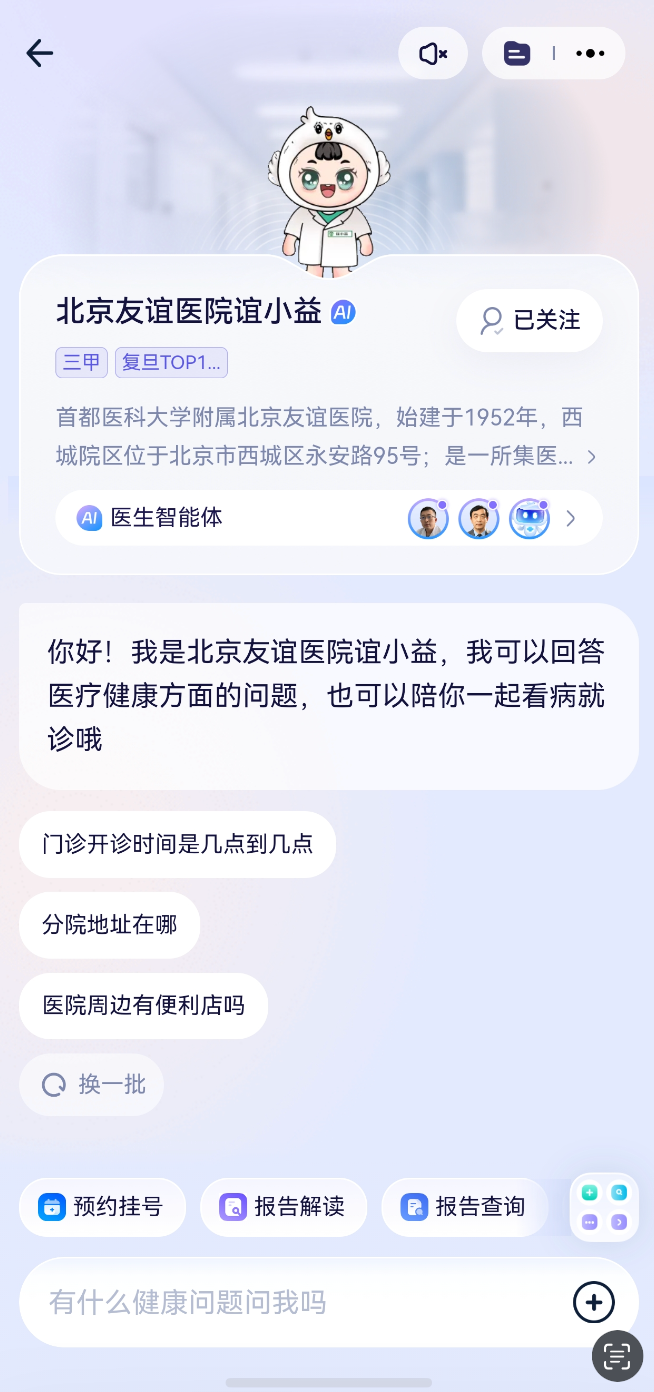
北京友谊医院与蚂蚁阿福合作上线智能体“谊小益”,覆盖诊前导诊、诊中提醒、诊后报告解读。本文不讨论AI能否看病,而是聚焦医院为何主动把第一道分诊交给AI、它实际能处理哪类问题,以及一个尚未被回答的关键问题:AI给出错误建议时,责任由医院、平台还是患者承担。
友谊医院把第一道分诊交给AI,真正的问题是答错了谁认账
医院为什么愿意把“第一道门”交给AI
不是技术展示,是资源再分配
三甲医院门诊大厅里最常见的一幕,是导诊台前排着两支队伍:一支是真正需要分诊判断的初诊患者,另一支是来问“报告在哪取”“医保卡怎么关联”“消化内科在几楼”的人。后一支队伍消耗的并不是医学判断力,而是信息检索和流程记忆。
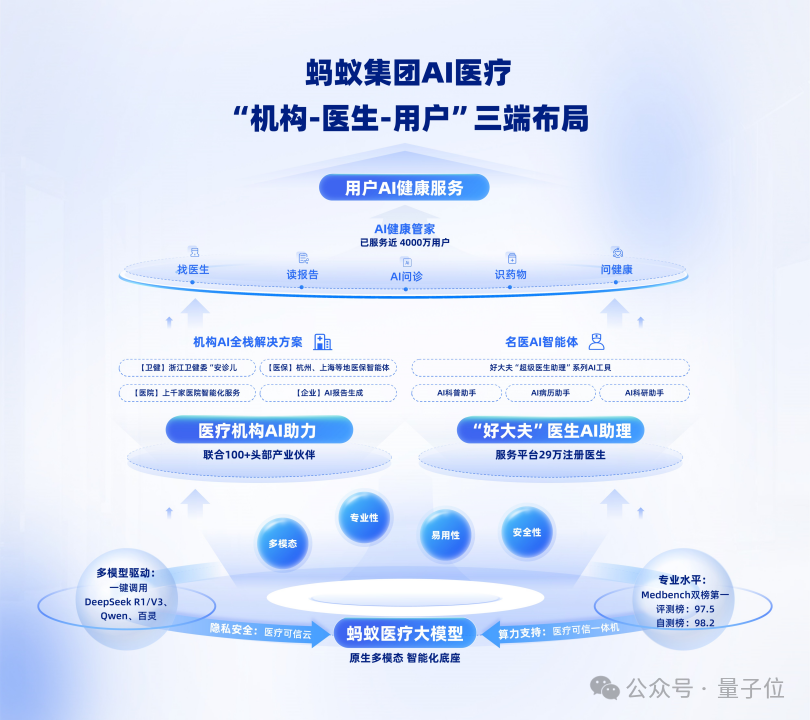
友谊医院把“谊小益”接进阿福App,本质上是在处理这笔账。据院方介绍,这款智能体融入了友谊医院的科室特色、就诊规则、办理材料、院内流程等信息,结合蚂蚁阿福的AI能力提供一站式就医咨询(E02)。院方相关负责人的说法更直接:AI可高效承接90%以上的基础咨询和日常健康疑问,帮医务人员从重复性问答中解放出来,把更多精力投入复杂病情研究和患者关怀(E07)。
这个数字需要拆开看。90%以上是院方表述,没有公布统计口径——是按咨询条数算,还是按咨询类型算?是导诊台现场提问,还是包含电话和线上渠道?口径不同,含义差别很大。但即便打个折扣,方向是清楚的:友谊医院是一所拥有74年建院历史、集医疗、教学、科研、预防为一体的大型三级甲等综合性医院(E19),这类医院的专家时间,确实不该被“几点下班”“能不能加号”这类问题切碎。
三甲医院的真实痛点:专家时间被基础问题消耗
医院多招几个人,能不能解决同样的问题?能解决一部分,但解决不了全部。导诊人员可以回答流程问题,却很难回答“我这个症状该挂哪个科”这类需要医学背景的初筛问题;而分诊护士能回答初筛问题,数量又有限,且无法覆盖线上渠道的并发咨询。
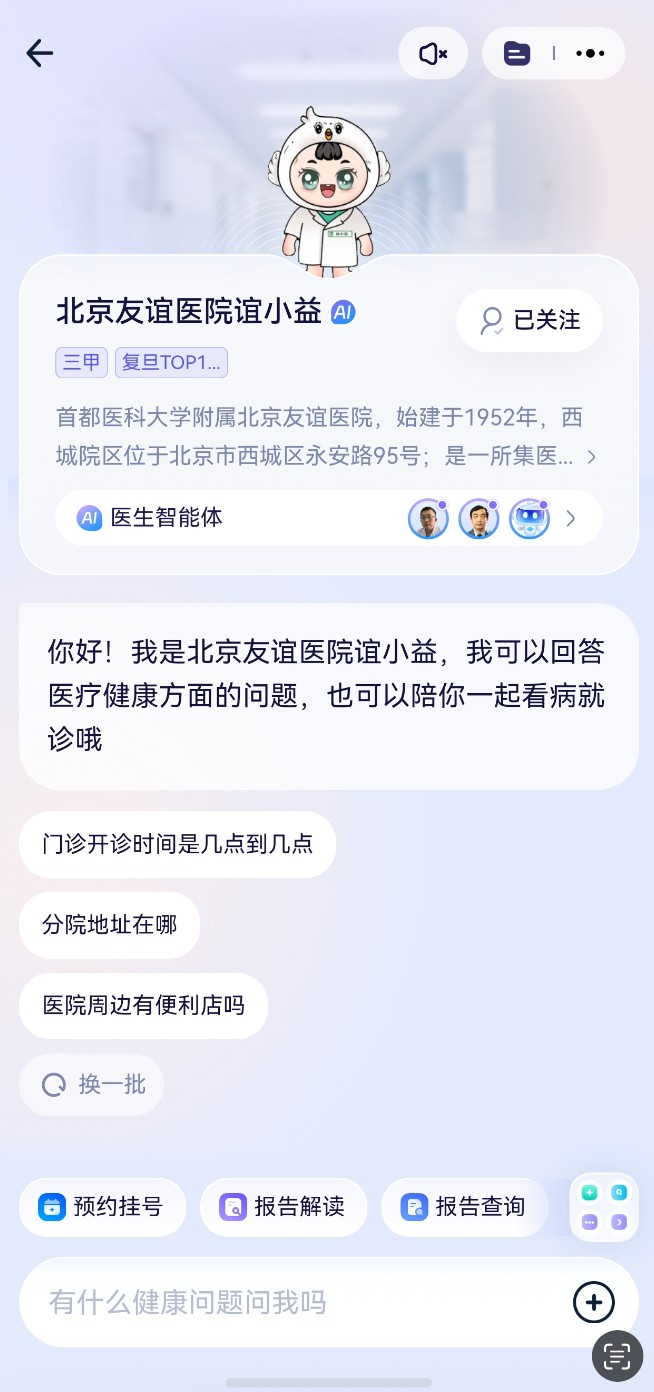
AI智能体在这中间的位置,是承接第一层过滤。它不需要做出诊断,只需要把“确定不需要紧急处理、但不确定该找谁”的患者,引导到正确的科室和流程上。友谊医院相关负责人把这层价值表述为打破“信息不对称、流程不清晰”的痛点,实现“让信息多跑路,让患者少跑腿”(E04)。
但第一层过滤有个天然风险:AI一旦答错,纠错成本会转嫁到医生身上。患者按AI指引挂了错误的号,见到医生后第一句话是“AI让我来的”,医生就得先花时间纠正路径,再进入真正的诊疗。这部分损耗目前没有公开数据可以衡量,院方也没有披露“谊小益”上线后的纠错率或转人工比例。
把第一道门交给AI,前提是它接得住。接不住的时候,谁来兜底,比它能接住多少更重要。
“全流程覆盖”到底覆盖了什么
诊前、诊中、诊后的功能清单
从公开信息看,“谊小益”的功能覆盖了就诊的三个阶段。诊前做智能导诊,解决挂错科室的问题;诊中提供科室导航、候诊提醒、检查节点提醒;诊后支持报告查询,并用AI对检查检验结果做通俗化解读。此外还包含预约挂号和门诊缴费入口(E03、E16)。

这份清单的密度不低。但功能清单本身不能说明效果。所有描述均来自院方和合作方的产品介绍,没有第三方披露实际使用率、导诊准确率或患者满意度数据(E12)。全流程覆盖和每个环节都可靠,是两件事。
与通用AI问答的本质区别:嵌入医院规则

在蚂蚁阿福上直接提问,和通过“谊小益”提问,区别不在底层模型的医学知识,而在“谊小益”被嵌入了友谊医院的科室特色、就诊规则、办理材料和院内流程(E08、E17)。
这个区别指向两类不同的问题。通用AI能回答“胃疼该看什么科”,但回答不了“友谊医院消化内科的专家号怎么约、约不上能不能加号、加号需要什么材料”。前者是医学知识,后者是机构知识。机构知识通常散落在导医台、挂号窗口、科室护士站和患者的反复试错里,很少被系统化整理。智能体的作用,是把这层知识从人工问答中抽出来,变成可查询的标准化输出。
这也是它和通用健康AI最实质的差异。模型能力可以采购,但院内规则和流程的梳理只能由医院自己完成。友谊医院愿意做这件事,比它用了哪家模型更值得注意。
功能覆盖看起来完整,但覆盖不等于可靠。诊前导诊如果判断失误,患者挂错科室,纠错成本会转移到诊室里的医生身上。报告解读如果输出不准确,可能引发不必要的焦虑或延误。这些环节的容错空间比“科室导航”小得多。目前没有公开数据说明“谊小益”在这些高风险节点上的实际表现,院方也未披露转人工比例或纠错机制(E12)。

AI参与诊断的边界在哪里
李鹏的风险分层原则
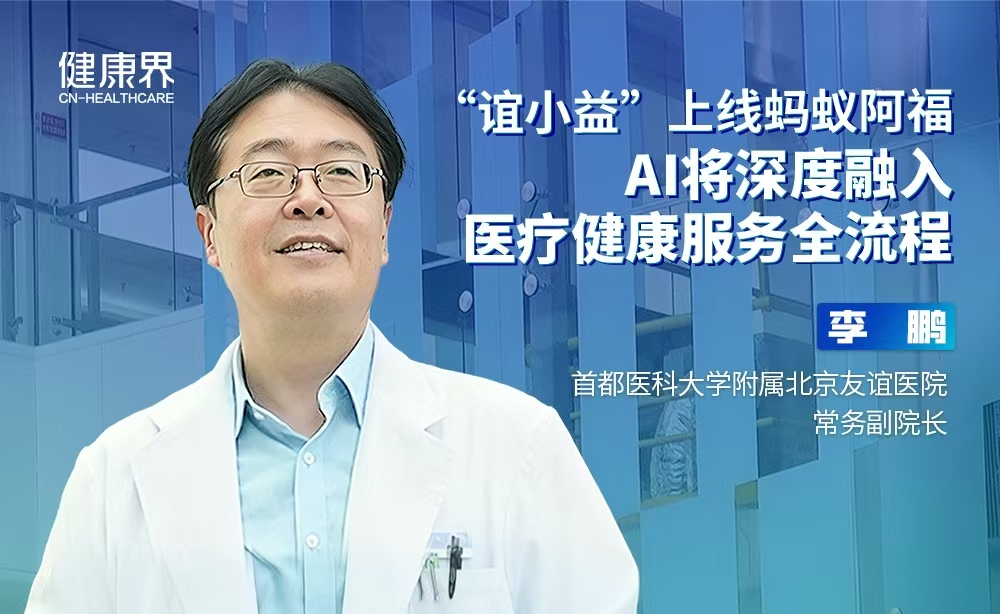
北京友谊医院常务副院长李鹏在谈AI与医生的关系时,给出了一个相当明确的判断框架:人工智能可以帮助医生,但不能取代医生。具体怎么帮、帮到什么程度,按风险等级来分。低危、中危、高危三个层次,对应AI参与程度的高低。分诊这类简单、风险不大的环节,可以把更多权限放给AI;风险较高的环节,必须由医生更多参与(E13)。

这个原则的价值在于,它绕开了“AI行不行”这种容易空转的争论,直接问“在什么条件下让AI参与”。从医院管理角度看,这是目前最务实的边界设定。它承认AI有能力差异,也承认医疗场景的风险不对称——低危环节出错,代价可控;高危环节出错,后果不可逆。
但分层原则依赖一个前提:医院能准确判断风险等级。这个前提在现实中并不总是成立。患者主诉模糊、症状交叉、病史不完整,都是门诊常态。如果分层本身判断错误,低危被误判为高危,AI被过度限制,效率收益打折;高危被误判为低危,AI参与过深,安全边界就被突破。分层原则的有效性,最终取决于分诊环节的准确率,而不是AI在单个诊断任务上的表现。
那场消化科诊断比赛的启示与局限
李鹏提到一场院内比赛:用真实的、已有诊断结果的消化相关疑难病例,让年轻医生、资深医生和四个人工智能(包括蚂蚁阿福)分别给出诊断结论。结果是“非常惊艳,出乎很多医学人士和专家的预料”(E14)。
这个案例说明,AI在某些诊断任务上已经具备参考价值,至少在回顾性、有标准答案的场景里,它的表现超出了部分医生的预期。对于医院管理者来说,这类结果会直接影响他们对AI参与程度的判断——如果AI在疑难病例上都能给出有价值的参考,那么在低危、标准化的环节,放权给AI似乎顺理成章。
比赛场景和真实门诊有本质差异。比赛用的是已有诊断结果的病例,信息完整、边界清晰,评价标准明确。真实门诊中,患者表述可能前后矛盾,关键信息可能缺失,症状可能处于早期不典型阶段。AI在比赛中的表现,不能直接推导到门诊环境。李鹏本人也没有提供比赛的规模、评价标准和具体数据,这场比赛的结论更适合作为方向性参考,而非能力定论。
风险分层原则和诊断比赛,指向同一个问题:AI参与医疗的边界,不取决于AI在理想条件下的上限,而取决于它在不理想条件下的下限。分层原则试图用制度设计来管理这个下限,但制度设计本身也需要数据支撑——目前公开信息里,还没有看到友谊医院披露分层判断的准确率或AI在高危环节的实际表现。
谁为AI的失误负责
医院与平台的责任分工尚未明确
“谊小益”由北京友谊医院与蚂蚁阿福联合发布,用户通过阿福APP就能调用友谊医院的智能体服务。这种合作模式把医院的院内规则和平台的分发能力绑在了一起,但两方各承担什么责任,目前没有公开说明。

如果AI导诊建议患者挂错了科室,患者到了诊室才发现,谁该为这次错误负责?如果AI解读一份检查报告时给出了偏离临床判断的结论,导致患者延误就医或产生不必要的焦虑,责任在医院、平台还是患者自己?这些问题在现有公开信息中找不到答案。
责任归属之所以关键,是因为它直接决定纠错机制是否存在。患者发现AI建议有问题时,有没有渠道反馈、多久能得到回应、错误是否会被记录并用于改进——这些流程如果缺失,AI服务的可靠性就只能靠技术准确率来担保,而技术准确率在真实门诊环境中恰恰是最不稳定的变量。
对普通患者意味着什么
蚂蚁阿福的用户规模让这个问题的影响面被放大。来源引述的数据显示,阿福用户数已突破1亿,其中55%来自三线及以下地区(E05、E09)。另一处来源则称用户数量已达1.5亿(E15)。两组数字口径不同,但指向同一个事实:大量用户可能把AI建议作为就医决策的参考依据。
三线及以下地区用户占比过半,意味着相当一部分使用者所在区域的医疗资源密度低于一线城市。对他们来说,AI给出的导诊建议可能比大城市的患者更接近“第一意见”。如果这个第一意见出错了,纠错成本由谁承担,比技术准确率的小数点更值得关注。
责任机制缺失是AI医疗行业的普遍问题,并非友谊医院独有。但三甲医院与亿级用户平台合作,会把这一问题的实际影响放大——医院品牌为AI建议提供了隐性背书,患者很难区分哪些建议来自医院审核过的规则,哪些来自平台通用模型的推断。
“来医院前先问问AI”要成为一种可靠的习惯,前提不是AI答得有多准,而是答错的时候有人认账。这个前提目前还没有被满足。