DeepSeek限额背后:免费AI的算力账单终于到了
DeepSeek对免费用户限额并非偶发故障,而是调用量两个月增长近三倍、算力供给跟不上时的必然选择。本文从用户反馈、调用量数据和服务中断记录切入,解释免费AI为何必然撞上算力墙,以及普通用户如何应对免费工具的“降级”风险。
DeepSeek限额背后:免费AI的算力账单终于到了
免费AI的蜜月期结束:DeepSeek开始对免费用户限额
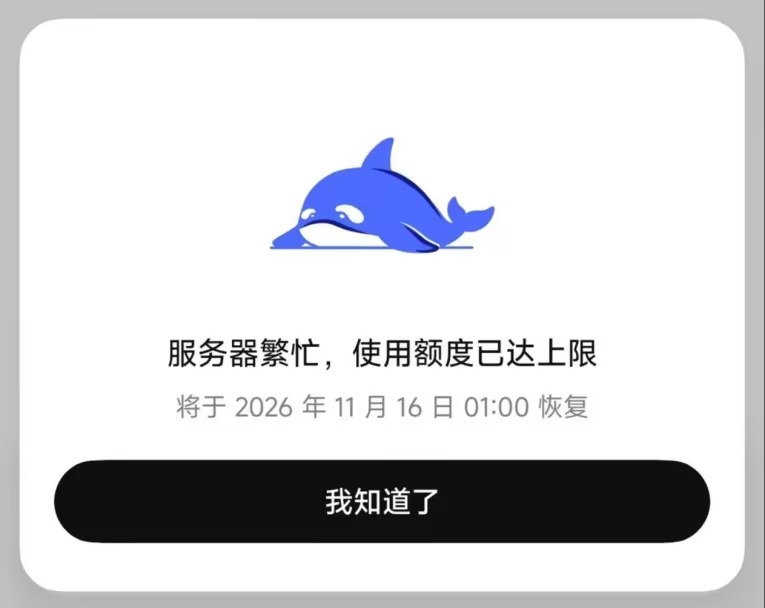
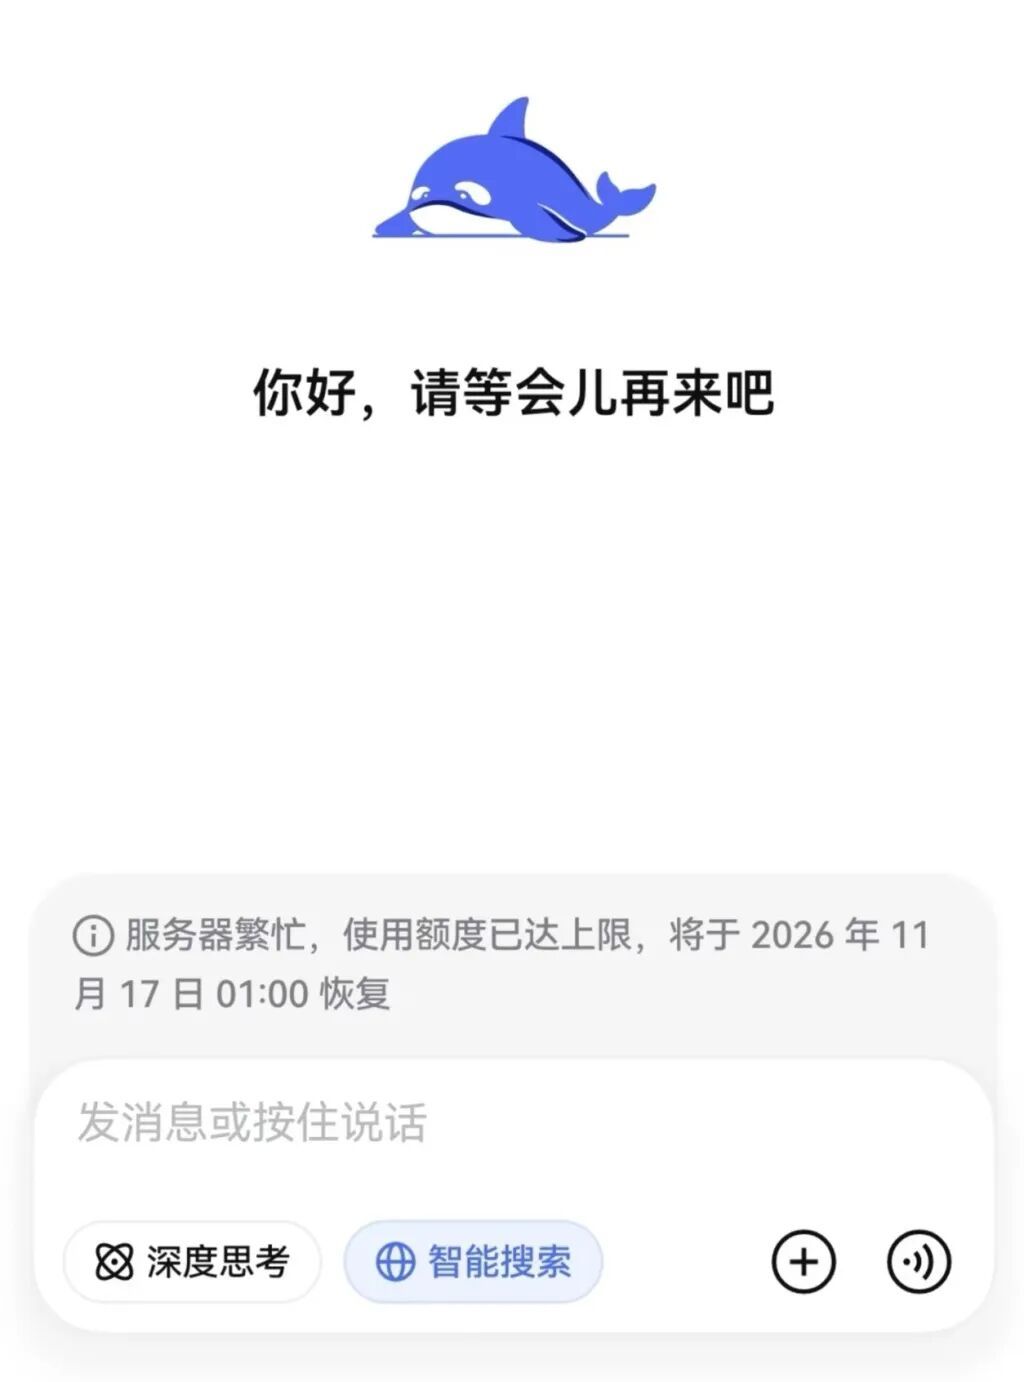
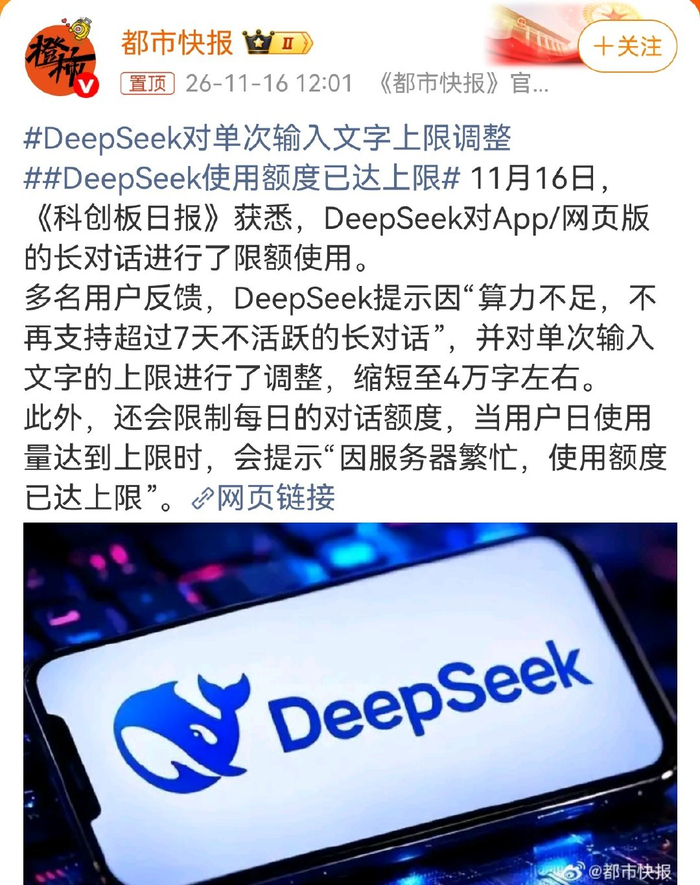
2026年11月16日,“DeepSeek使用额度已达上限”登上微博热搜。大量用户发现,App和网页版开始限制长对话、每日使用额度以及单次文字输入长度,提示原因直指“算力不足”。截至发稿,DeepSeek官方尚未发布统一的限额规则,也没有说明限制何时解除。
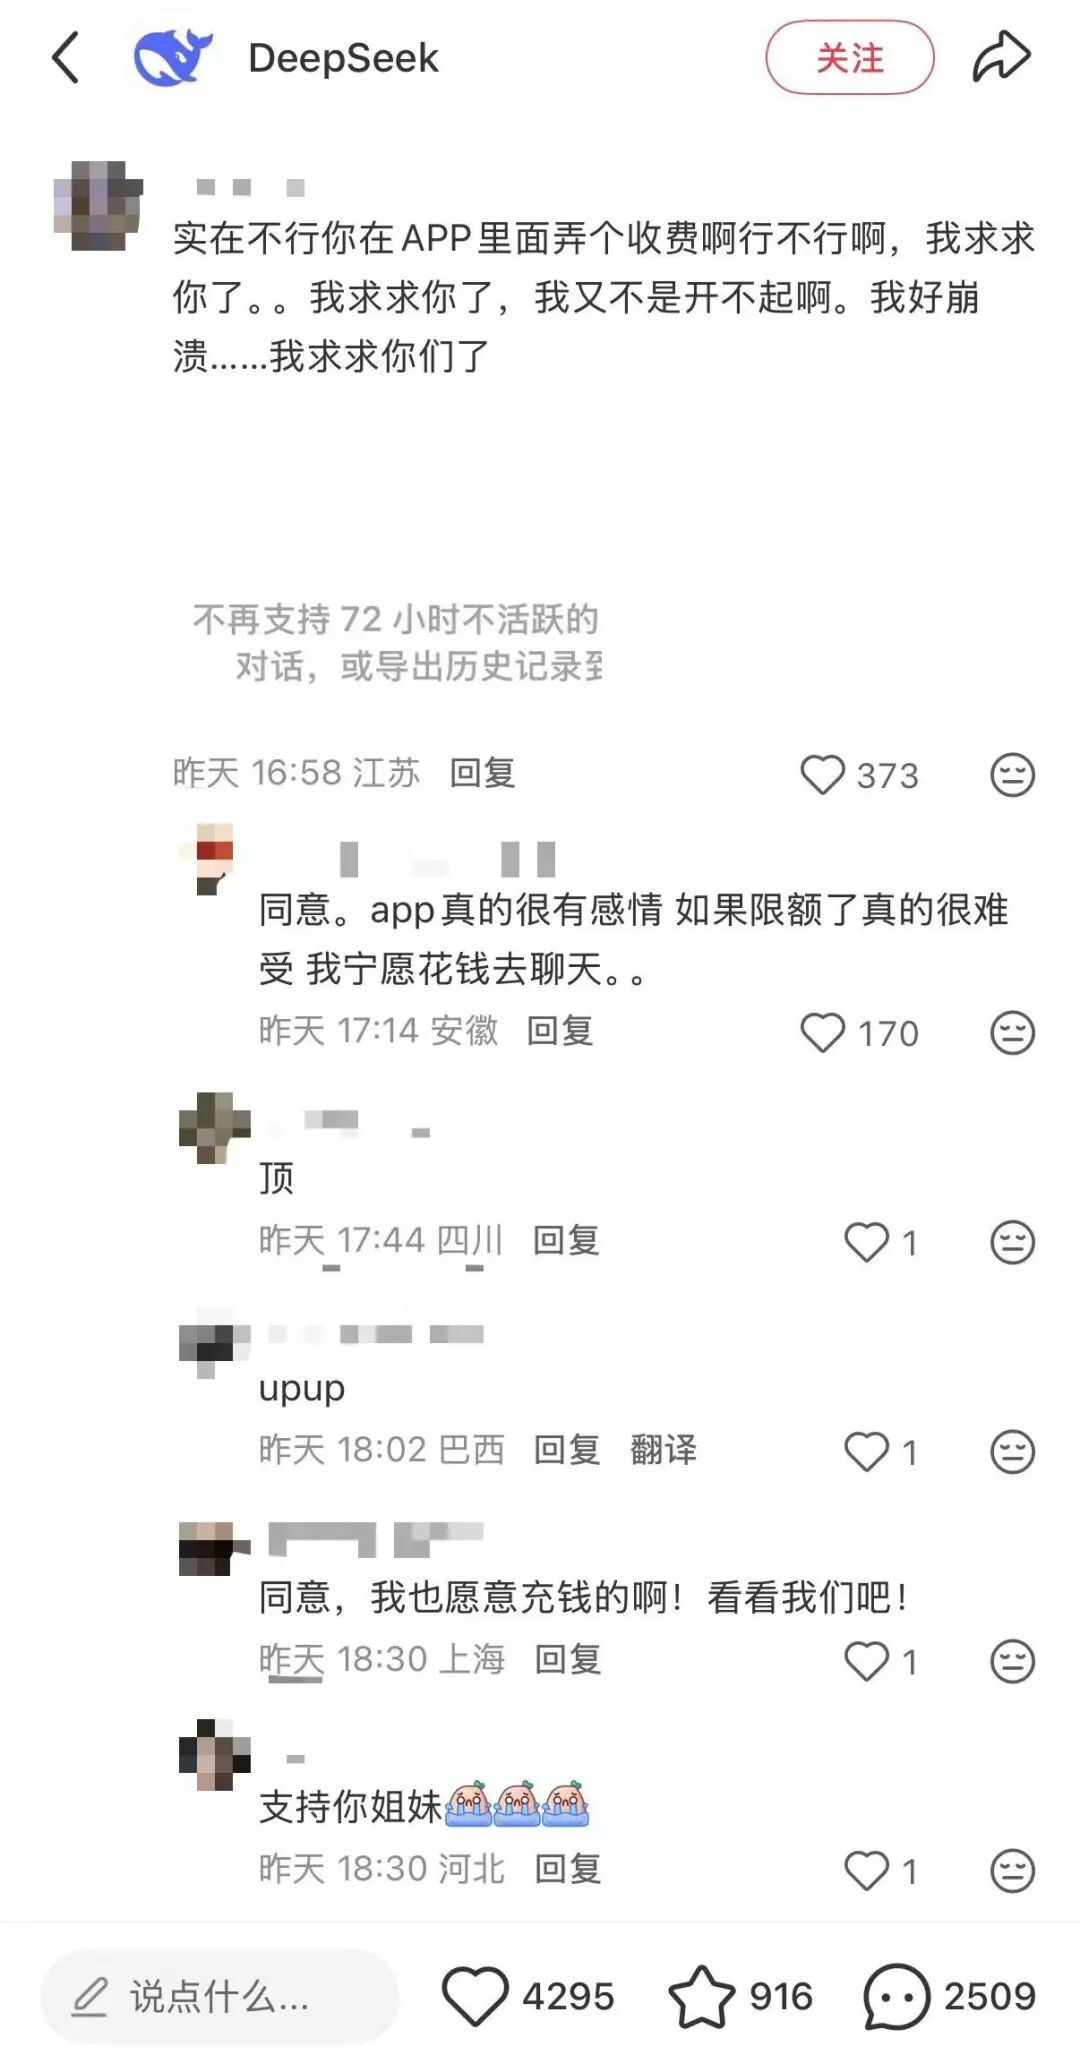
从公开反馈看,这次限额并非一次整齐划一的策略调整。有用户收到提示,超过7天不活跃的长对话将不再支持;也有人反映,超过72小时未活跃的对话就无法继续。单次输入上限被压缩到约4万字,部分用户在连续使用不到两小时后便收到额度耗尽的提示。不同用户遇到的限制标准并不一致,说明目前更像一套临时启用的流量控制机制,而不是经过充分设计的长期产品规则。
限额针对的是App和网页版C端免费用户,而非开发者使用的API接口。这意味着DeepSeek在调用量激增和服务中断频繁并存时,把算力供给的紧张转嫁到了最容易被压缩的需求端。
官方对此保持沉默,既没有解释触发条件,也没有公布恢复时间。用户感受到的是“突然限额”,但免费AI的蜜月期,正在以这种方式结束。
2万亿Token调用量:免费AI的算力账单有多重
用户最先感知到的是弹窗,但真正需要解释的是弹窗背后的数字。OpenRouter的数据显示,2026年11月9日至15日这一周,DeepSeek V4.1 Flash 1017的Token调用量达到59.2万亿,居全球首位。这个模型9月10日才推出,9月14日当周的调用量还是15.8万亿。两个月,增长近三倍。
59.2万亿Token是一个抽象数字,但它的含义很具体:每一次调用都在消耗GPU的浮点运算能力,而GPU的供给并不由DeepSeek单方面决定。调用量可以在一周内往上跳,算力集群的扩容却要以季度为单位规划。当需求曲线陡峭上升、供给曲线只能缓慢爬坡时,缺口就出现了。
服务中断记录把这个缺口变得可见。DeepSeek官方状态页显示,自2026年10月以来,平台已发生至少5起部分服务中断及服务异常事件,覆盖对话服务和V4 Pro、V4.1 Flash的API。10月15日那次崩溃持续约5小时,C端网页、App和API同步受限。有分析认为崩溃或许源于算力供应问题,但官方未确认。可以确认的是,中断频率与调用量激增在时间上高度重合。
算力紧张还反映在租赁价格上。截至2026年11月5日,H100、H200、B200的按需价格较30日前分别上涨10.21%、27.22%、24.97%。高端GPU的现货价格走高,意味着DeepSeek无论是自有算力还是外采算力,边际成本都在上升。开源证券引用的一季度数据显示,国内AI算力需求同比增长417%,有效供给增速为128%。需求增速是供给增速的三倍以上,这不是某一家公司的偶发困境,而是整个推理算力市场的结构性紧张。
需要说明的是,OpenRouter的调用量统计反映的是API调用,与C端免费聊天服务并非同一套计费规则。但两者最终消耗的是同一个算力池。API调用量激增会挤占可用于C端服务的算力,反之亦然。因此,59.2万亿这个数字虽然不能直接等同于免费用户的消耗规模,却足以作为算力压力的有效指标。
把这几组数据放在一起,因果链并不复杂:模型调用量在两个月内增长近三倍,算力供给无法同步跟上,服务开始频繁中断,免费用户成为最先被压缩的变量。限额不是DeepSeek突然改变了商业策略,而是算力配给逻辑在压力下被迫浮出水面。
从免费到限额:AI产品商业化的必然路径
梁文锋在2026年7月与投资人交流时表示,今天AI最大的问题还是算力,团队知道方向,也知道应该怎么训练,但真正限制团队的是算力资源。这次交流发生在DeepSeek完成首次外部股权融资期间,创始人强调的不是增长目标,而是算力瓶颈。
一家目标AGI、在C端商业化上长期克制的公司,突然对免费用户动手,原因在于免费策略的账算不过来。用户增长不直接带来收入,每一次对话却都在消耗显存和推理资源。当调用量增速远超供给增速,公司必须选择:要么继续让免费用户挤占算力,影响所有服务的稳定性;要么把有限的算力优先配给更重要的需求。DeepSeek选了后者。
有分析认为,这次限额的具体目的之一是回收闲置会话占用的KV缓存资源。长对话会持续累积缓存,长期不用的会话却仍占用稀缺显存,回收这些资源可以优先保障活跃用户的推理需求。限额是资源配给的理性手段。
华尔街见闻的报道也提到类似判断:相比大多数积极争夺用户和订阅收入的大模型厂商,DeepSeek在C端商业化上态度较为克制,公司不缺用户,但显然非常缺算力。不缺用户却缺算力,意味着免费获客对DeepSeek的价值已经边际递减。它不需要用免费来换增长,反而需要用限额来保护已有用户的使用质量。
但这个选择并非没有代价。有受限制用户表示,自己并非不愿意付费,只是希望能继续在App上稳定使用,而官方目前没有给出付费选择。限额是免费模式不可持续时的理性收敛,但DeepSeek还没有准备好承接那些愿意付费的用户。如果限额长期持续,却始终不提供付费通道,部分用户会流向其他有明确付费方案的产品。
从行业视角看,DeepSeek的限额是免费AI模式在算力约束下的一次显性收敛。免费获客阶段可以容忍亏损,因为用户规模本身是估值的一部分;但当算力成为硬约束,免费带来的每一单位新增使用都在推高成本,却无法转化为收入,限额就成了必然。区别只在于,有的公司用订阅制消化成本,有的公司用排队和额度管理需求,DeepSeek目前选择了后者,且尚未给出下一步的商业化路径。
普通用户如何应对AI工具“降级”风险
对普通用户而言,DeepSeek这次限额最值得吸收的不是某一次提示词,而是一个判断:免费AI的稳定供给并不构成承诺。当算力紧张时,最先被压缩的往往是免费C端服务。此次限额主要针对App和网页版,而非开发者使用的API接口,这已经说明产品内部的优先级排序。把任何单一免费工具当作不可替代的基础设施,风险会随着模型调用量继续增长而放大。
多工具备份因此不是焦虑下的过度反应,而是算力配给时代的理性默认设置。不同产品背后的算力储备、商业化节奏和限额触发条件并不相同,同一时间全部不可用的概率远低于单一工具故障。轻度用户可能几乎感受不到变化,偶尔查询、简单写作的调用量很难触及上限;重度用户则需要把工作流拆开,避免把关键任务绑定在唯一入口上。
一个现实落差是:部分受限制用户表示并非不愿意付费,只希望稳定使用,但官方尚未提供付费选择。这意味着用户暂时无法用付费换取确定性,只能通过多工具组合来分散风险。等付费通道出现后,是否订阅会变成更清晰的成本收益计算;在那之前,备份意识比等待官方规则透明更实际。