ChatGPT定位误差0.39公里,GeoSeer在冈比亚偏出4580公里
澎湃明查用10张真人拍摄照片实测6款AI地理定位工具,ChatGPT和Geo-Sleuth中位误差不到1公里,远超GeoGuessr冠军组151公里的基准,但GeoSeer在冈比亚照片上误差超过4580公里。本文拆解这组数字背后的真实含义:精度来自街景索引匹配而非通用推理,厂商宣传的准确率因数据集和阈值不同几乎不可比,而专用工具的高命中率往往以牺牲不确定性表达为代价。
ChatGPT定位误差0.39公里,GeoSeer在冈比亚偏出4580公里
10张照片、6款工具:ChatGPT中位误差0.39公里,但冈比亚一张图翻车4580公里
澎湃明查从同事手机相册里导出10张真人拍摄照片,覆盖瑞典、韩国、埃及、西班牙、肯尼亚、美国、智利、冈比亚、俄罗斯、泰国10个国家,既有城市街景也有自然风光。他们把这组照片喂给6款模型和工具,让AI直接猜拍摄坐标。
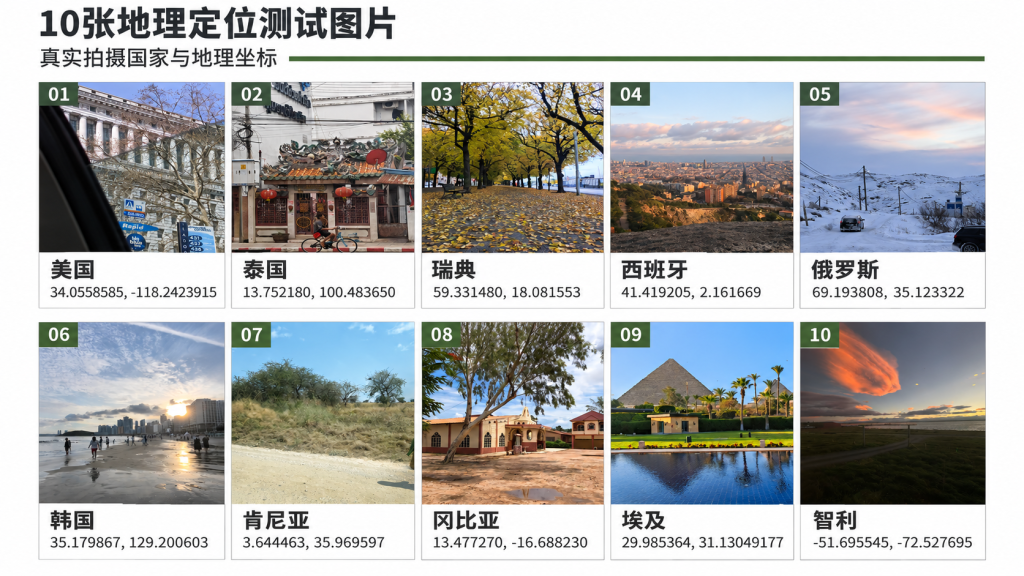
ChatGPT中位误差0.39公里,冈比亚一张图翻车4580公里。 这两个数字出自同一场测试,前者接近街景级精度,后者等于从北京偏到莫斯科。核心判断一句话:AI地理定位的精度高度依赖具体工具和具体照片,单次测试只能证明“可以很准”,不能证明“总是很准”。
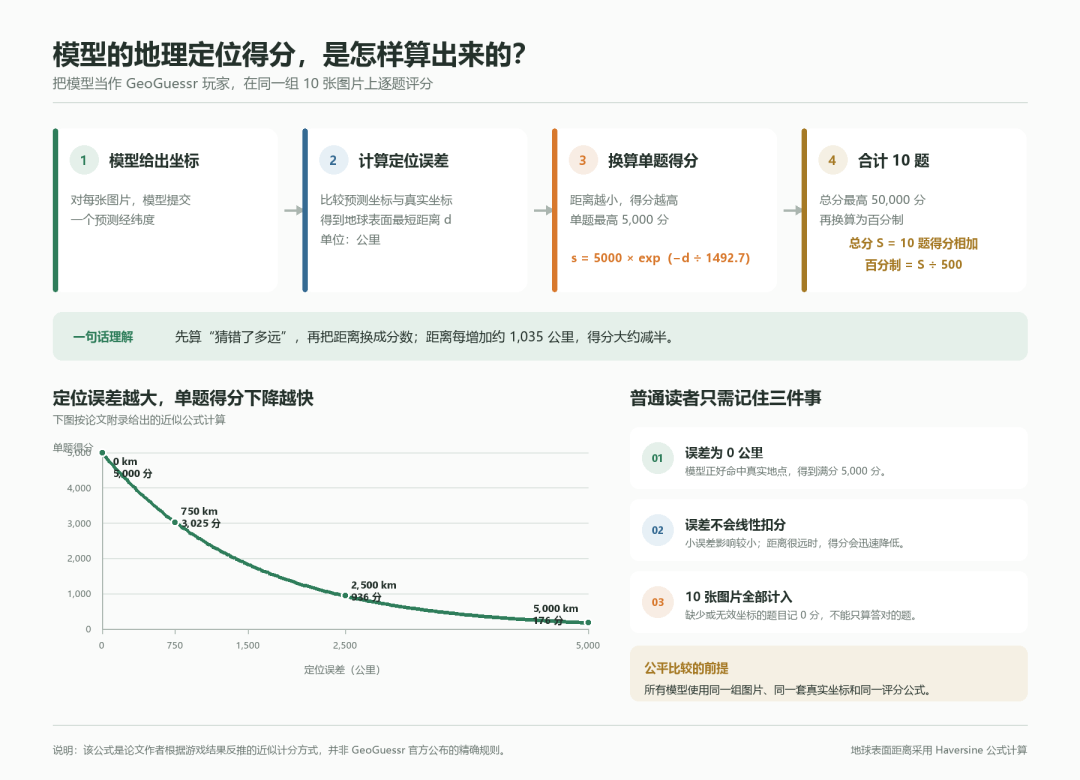
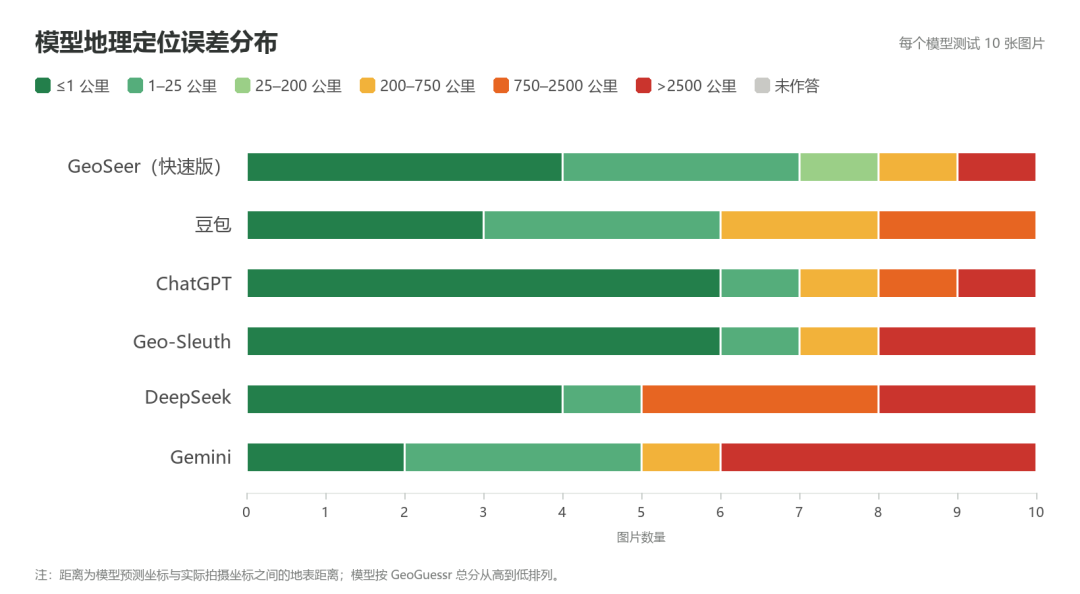
看中位误差,ChatGPT和Geo-Sleuth分别跑出0.39公里和0.63公里,10张照片里有6张误差在1公里以内,7张在25公里以内。作为参照,GeoGuessr冠军组玩家的中位误差基准是151公里,这个基准来自斯坦福大学Haas等人2024年研究的逆向工程公式。头部AI工具在这个样本上确实把人类顶尖玩家甩开了两个数量级。
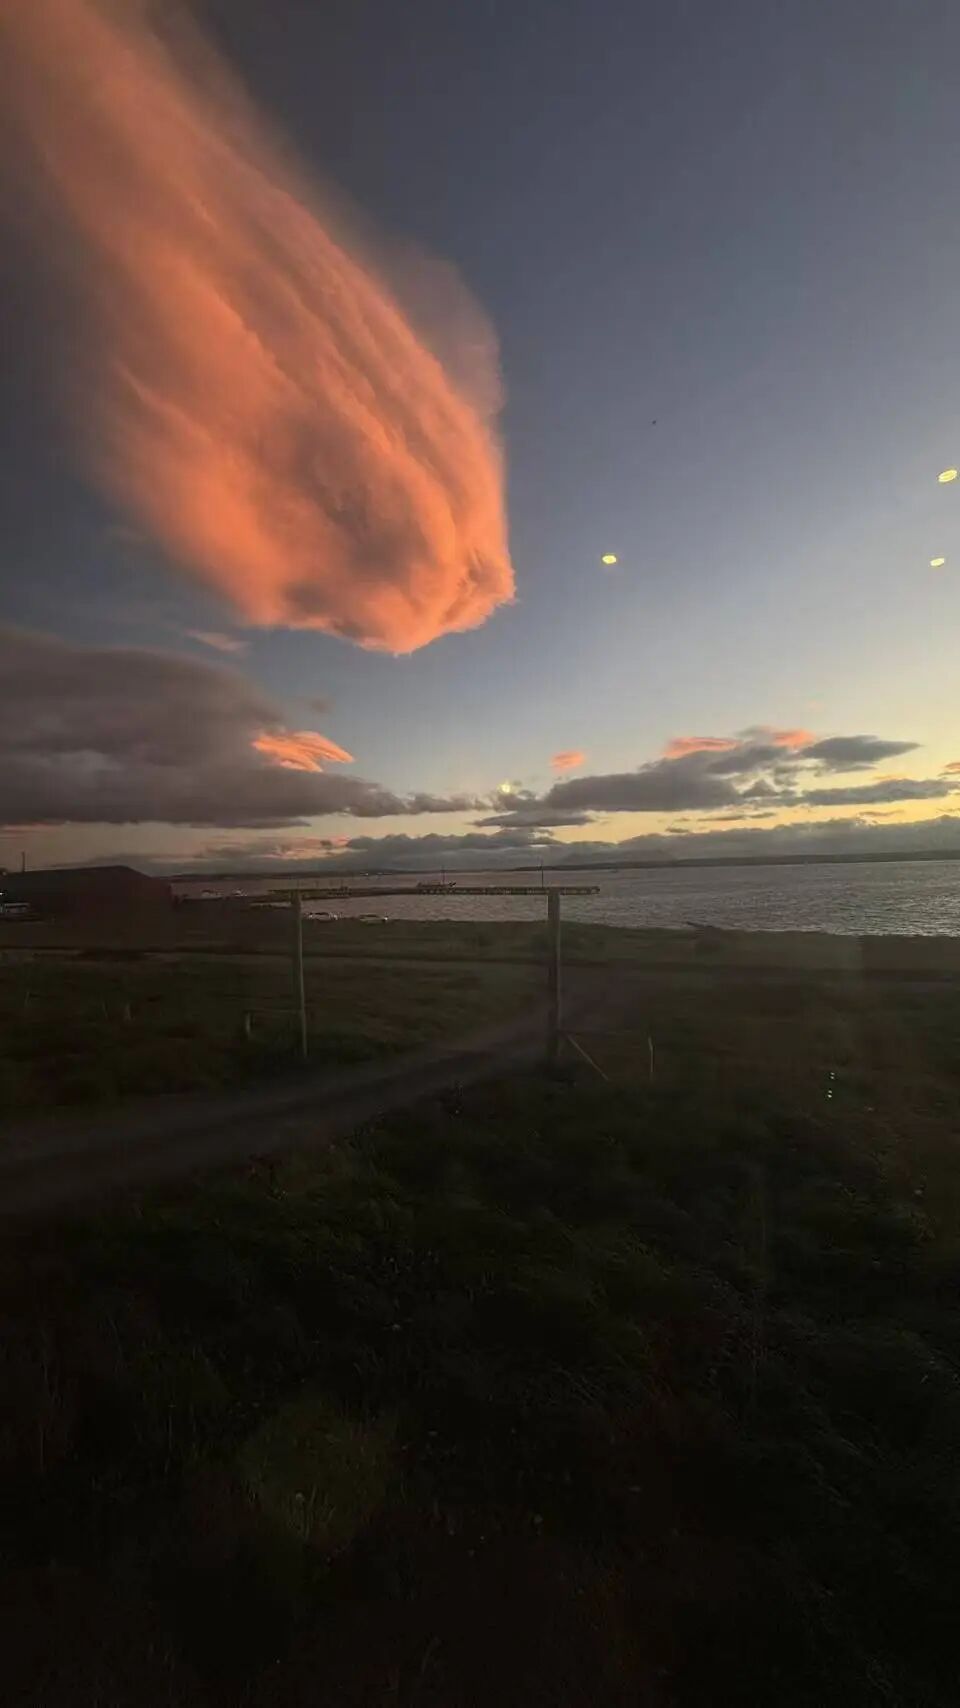
但换一张照片,故事立刻反转。得分最高的GeoSeer在定位冈比亚那张图时,误差超过4580公里。没有一款模型或工具能做到完全精准检测拍摄坐标。中位误差和极端误差并存,这才是AI定位能力的真实分布:头部工具在部分样本上接近街景级精度,尾部风险却大到足以让任何实际应用场景重新评估依赖程度。
参与测试的6款工具构成也值得拆开看。ChatGPT免费版、Gemini免费版、豆包免费模式快速版、DeepSeek-V4.1-Flash-1017,这4款是商业模型代表。另外加上地理定位服务商GeoSeer免费模式快速版和开源工具Geo-sleuth。商业模型读者关注度高、用户量大,垂直定位工具则代表专业路线。两类工具同场竞技,结果差异本身就是信息。
谁在真定位,谁在猜:ChatGPT靠街景索引,GeoSeer的94%准确率换不来冈比亚
0.39公里和4580公里同时出现,不是同一套能力在抽风。ChatGPT和Geo-Sleuth跑出的街区级精度,可能靠的是把照片特征对回已索引的街景库。GeoSeer在冈比亚翻车,则可能与其索引覆盖不足有关。两条技术路径,决定了两类工具完全不同的误差分布。
GeoSeer自己发布的基准里,Agent模式在62张照片上1公里内命中率做到94%。GeoAxis是87%,Oceanir 79%,Picarta 62%。这套数字看着很能打,但样本只有62张,还是GeoSeer自己搭的集子,覆盖城市、乡村和室内。澎湃明查那10张照片里,GeoSeer在冈比亚一张就偏出4580公里。94%的基准准确率换不来一次非洲小国的定位,原因就在这:专用工具的优势区间和盲区一样极端。
通用助手走的是另一条路。ChatGPT、Gemini这类模型没有街景级参考索引,但读招牌、辨区域风格的能力很强,通常只能定位到街区级别。可澎湃明查的实测里,ChatGPT中位误差0.39公里,10张里6张压在1公里内。这跟“只能到街区级”的定性判断直接打架。解释只有一个:样本里那几张照片恰好落在通用助手擅长的范围内——地标可见、文字信息充足、区域特征明显。
两条路径的能力边界,用一张表看得更清楚:
| 工具类型 | 能力来源 | 优势区间 | 典型翻车场景 |
|---|---|---|---|
| 通用助手(ChatGPT、Gemini) | 视觉特征推理+招牌/文字识别 | 地标、商业区、文字密集场景 | 无文字、无地标的荒野或乡村 |
| 专用工具(GeoSeer、GeoAxis) | 街景索引匹配+推理引擎 | 索引覆盖充分的地区 | 索引盲区(如部分非洲国家) |
GeoSeer的94%来自它自己挑的62张图,澎湃明查的4580公里来自一张冈比亚街景。两组数字都对,但谁也不能单独代表真实水平。专用工具在索引覆盖好的区域能跑出惊人命中率,一旦出了覆盖圈,误差直接崩到千公里级。通用助手没有索引可依,反而不会出现这种断崖式崩溃,但精度上限也卡在街区级。
DeepSeek和Gemini的中位误差420公里和259公里,25公里内命中率都只有50%。这俩在10张照片的测试里表现平平,可它们跟ChatGPT用的是同一类视觉推理逻辑。差距不在技术代际,在样本适配度。把测试照片换成10张地标清晰的欧洲城市图,排名可能显著变化。
所以0.39公里和4580公里的共存不矛盾。它说明AI定位的精度高度依赖照片特征与工具索引库的重合度。照片里有一个可读的店招,通用助手就能把范围缩到一条街;照片里只有一条土路和几棵树,专用工具的推理引擎就开始在训练分布里硬找答案。
厂商说94%,实测翻车4580公里:AI定位的准确率数字为什么不能直接比
厂商自报的准确率,读数字前先读脚注。同一个“1公里内命中率”,在著名地标集上跑和普通街景集上跑,是两个难度。Picarta在IM2GPS3k公共基准上自报44.8%,还补了一句与其他方法的比较可能不完全公平。GeoSeer在自己的62张测试集上做到94%,在IM2GPS3k测试集上自报67%。数据集、距离阈值、照片类型、测量方,四个变量没有锁死,数字之间就没有可比性。
2026年的照片定位工具分三条路:读内嵌GPS元数据、匹配已索引的网络副本、对全新场景做AI推理。whereisthis.place走EXIF优先,Picarta和GeoSeer做规模化AI定位,Google反向图片搜索和TinEye各自覆盖不同的匹配语料。工具定位不同,自报准确率的计算口径也跟着不同。拿GeoSeer的94%去比Picarta的44.8%,等于拿自家训练场成绩比公共赛道成绩。
对普通用户,真正的筛选标准不在命中率高低,而在工具是否承认不确定。一个十次答对六次、但会在没把握时明说的工具,比十次答对七次、却永远一副笃定模样的工具更有用。冈比亚那张4580公里的翻车,问题不在误差本身,在于工具给出答案时没有任何犹豫信号。用户拿到一个精确到街道的坐标,天然会高估可信度。
判断一个AI定位工具值不值得用,盯三个点:
- 它报准确率时,用的是公共基准还是自建数据集
- 距离阈值是1公里、25公里还是750公里
- 输出坐标时,有没有附带置信度或不确定提示
前两条决定数字的水分,第三条决定你被误导的概率。
一张街景照能暴露多少位置:AI定位的隐私账本与交叉验证底线
把技术能力换算成隐私风险,先分清两条线。Raven(原GeoSpy)只向执法、政府和经过审查的调查团队开放,需通过演示请求获取,公开版GeoSpy已终止。它精度再高,普通用户碰不到,不构成日常威胁。真正需要盯的是公开工具:GeoInfer这类平台明确面向OSINT调查员、执法部门和数字取证人员,但任何人都能访问,且无需EXIF或GPS元数据就能从照片反推位置。
你的照片不需要内嵌坐标,AI照样能猜。一张带店招的街景、一段有独特建筑轮廓的视频截图,喂给公开定位工具,就能得到街区级甚至更细的坐标。澎湃明查的10张测试里,ChatGPT中位误差0.39公里,这个精度在部分样本上已经接近锁定一栋楼。
隐私账本的核心变量不是“有没有GPS”,而是照片里有多少可读特征。店招文字、路牌样式、植被类型、建筑风格、阴影方向,每一项都是坐标线索。删掉EXIF只能挡住第一层,挡不住AI推理。
操作底线很具体:
- 发图前裁剪掉店招、门牌、路牌等文字信息
- 对背景做模糊或替换处理,而非只抹GPS
- 用澎湃明查给的方法做反向验证:拿工具给的坐标,回看照片里建筑轮廓、道路方向和地形视线是否对得上
AI定位是交叉验证工具,不是隐私审判官。真正决定暴露程度的,是你往照片里放了多少线索。