Chrome内置大模型:网页开发告别云端,前端要变天了
Chrome内置大模型:网页开发告别云端,前端要变天了
你肯定遇到过这种抓狂时刻:网页上明明有答案,却还得手动复制粘贴扔给ChatGPT,写一堆“请帮我总结这段文字”的废话。如果浏览器自己就能看懂网页、处理数据,还要什么中间商?
谷歌正把这件事变成现实。从Chrome 126开始,Gemini Nano大模型直接嵌入浏览器,让Chrome从一个被动的网页渲染工具,进化为能独立执行AI任务的本地运行时环境。这不是简单的“浏览器里跑个模型”,而是把AI推理能力变成了浏览器的基础设施,就像当年加入JavaScript引擎一样,将彻底改变Web应用的能力边界。
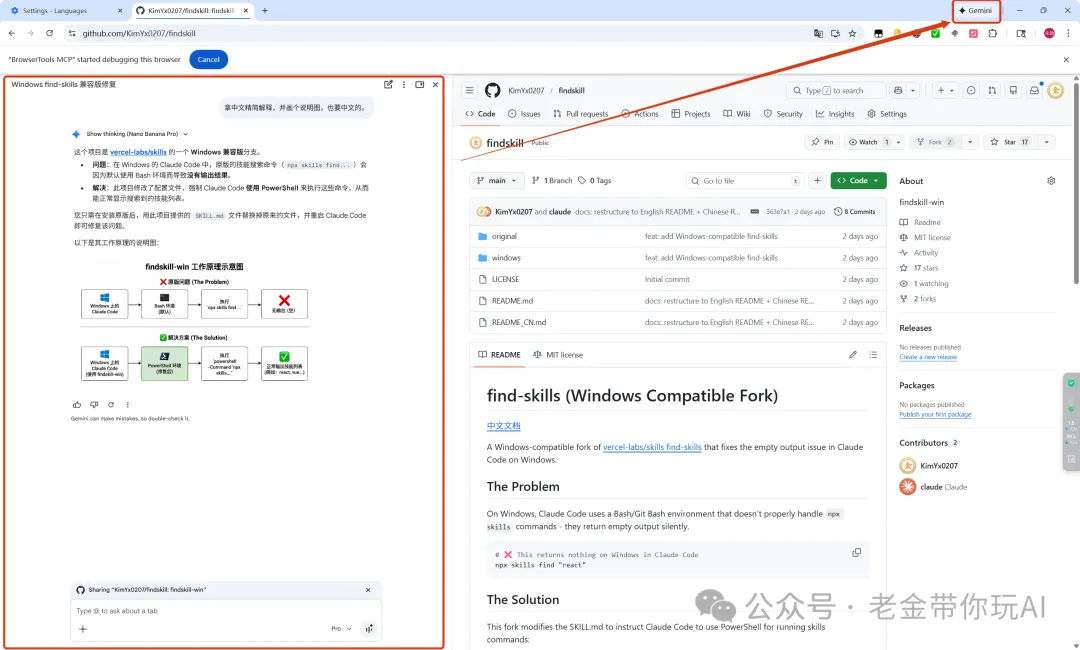
Gemini Nano在本地运行的是一个3.5B参数的模型,体量虽小,但专攻端侧高频任务。它能做什么?语法纠错、实时翻译、文本摘要、图像识别,这些都不需要联网。你在浏览器里选中一段英文,它直接本地翻译成中文;打开一篇长文,它几秒内生成摘要。整个过程数据不出设备,延迟低到几乎无感。
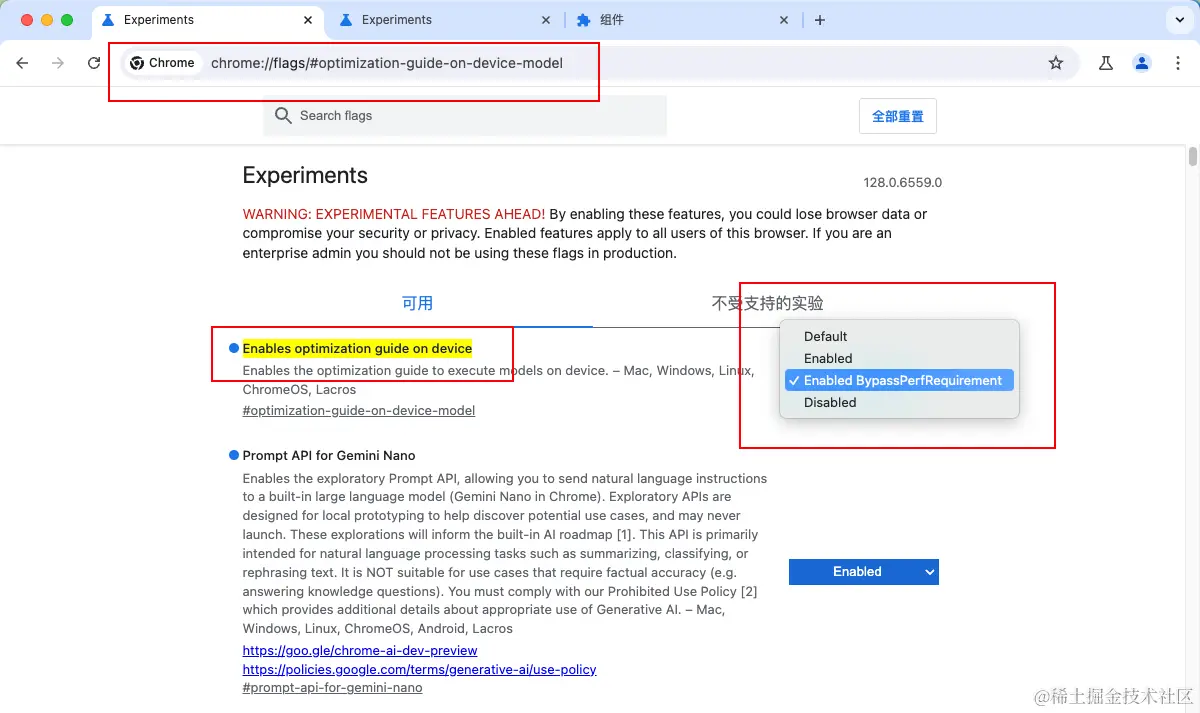
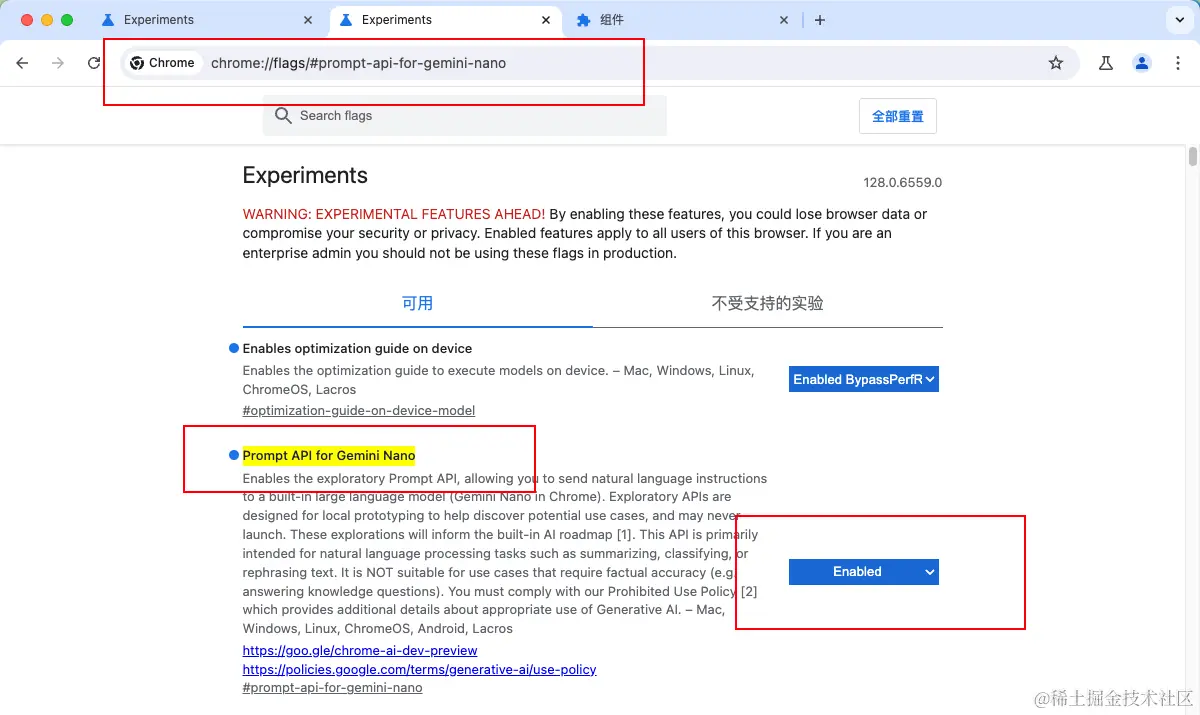
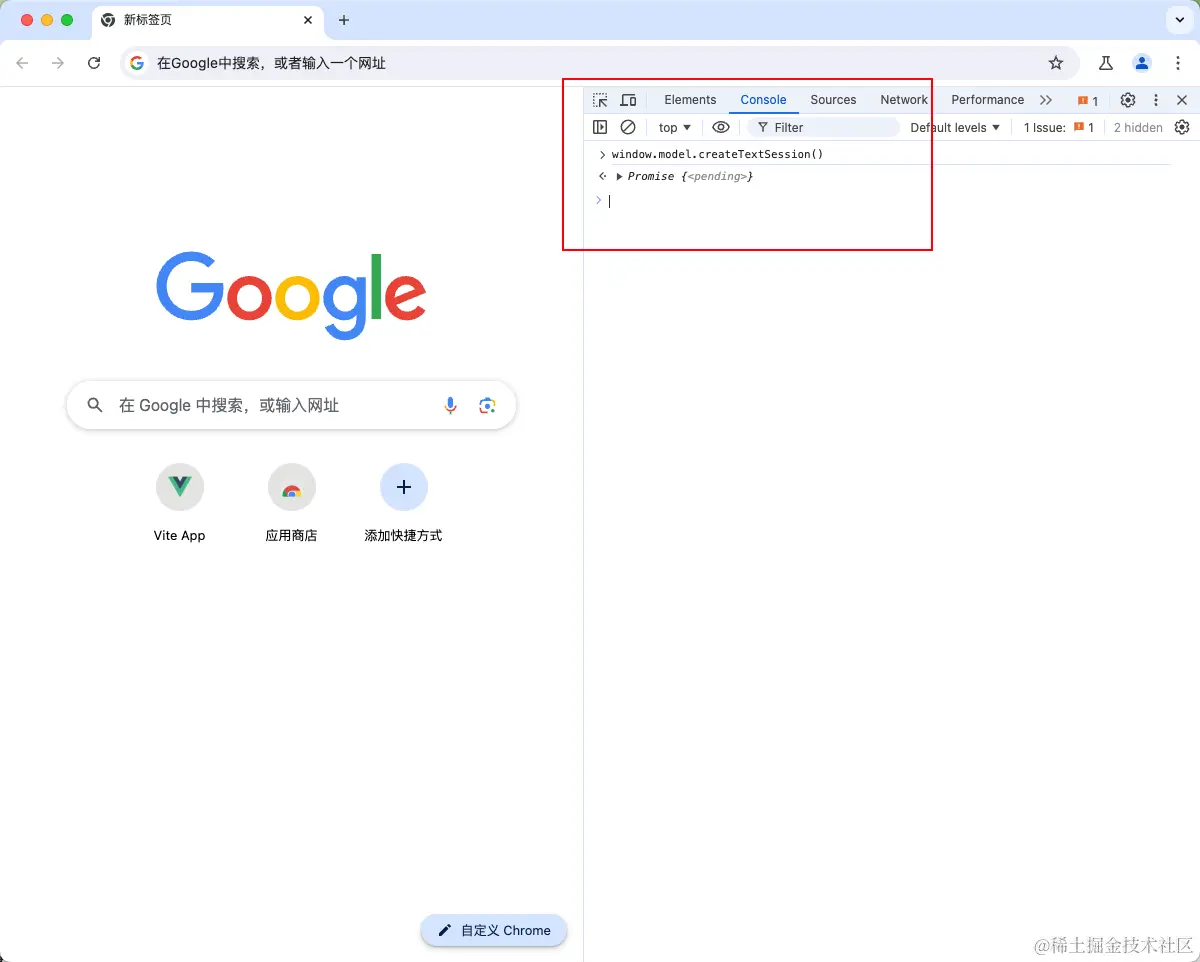
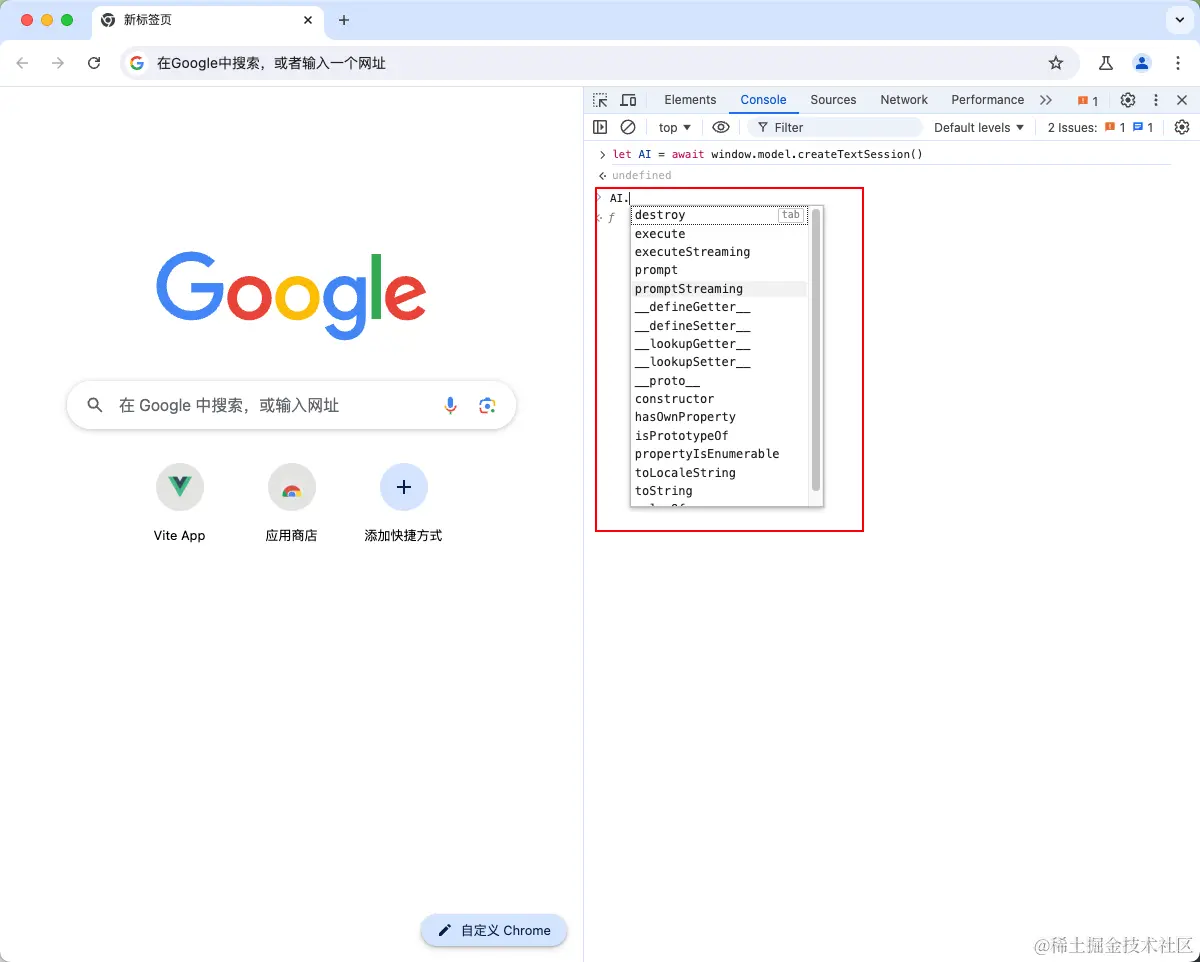
技术上,这依赖的是Prompt API和navigator.modelContext。开发者只需几行JavaScript就能调用:
const session = await window.ai.createTextSession();
const result = await session.prompt("总结这段内容");
没有后端转发,没有复杂的Prompt工程。浏览器内核直接读取DOM结构和页面上下文,模型“看”到的就是你正在浏览的页面状态。这意味着AI不再是一个外挂服务,而是浏览器原生能力的一部分,就像localStorage或WebGL一样触手可及。
传统Web AI的痛点很明确:数据必须上传云端,延迟不可控,隐私全靠厂商良心。处理一份含敏感信息的合同或医疗记录时,用户只有一个选择——信任服务商不会拿你的数据去训练模型。而本地推理彻底改变了这个等式。
Gemini Nano在本地执行推理,意味着数据从输入到输出完全留在设备上。离线也能用,网络抖动不再影响响应速度。资料显示,本地处理速度远快于API调用,因为省去了网络往返和服务端排队的时间。
本地推理不是“锦上添花”,而是让“隐私”和“智能”从对立走向统一。
这对开发者意味着什么?以前做AI功能,必须先搭后端、接模型API、处理数据合规。现在,敏感数据场景可以直接在前端闭环,只有复杂任务才需要云端兜底。架构选择从“必须上云”变成了“按需上云”——浏览器自己就成了第一道AI推理引擎。
二、开发范式重构:从调用API到编排本地智能体
Chrome 内置 Gemini Nano 带来的不是功能叠加,而是开发范式的底层重构。
过去十年,前端调用 AI 的本质是“远程调用”——数据必须离站,延迟不可控,隐私靠承诺。现在,浏览器本身成了 AI 运行时。开发者面对的,不再是如何拼 Prompt 发给云端,而是如何在本地编排智能体的行为逻辑。
实战入口:Prompt API 与 navigator.modelContext 的调用逻辑
Prompt API 是开发者接触 Chrome 内置 AI 的第一入口,调用方式简洁到令人不适:
const session = await window.ai.createTextSession();
const result = await session.prompt("总结这个页面的核心观点");
但真正的变革不在 API 的简洁,而在 navigator.modelContext 的上下文感知机制。
传统做法中,实现“总结当前页面”需要:手动提取 DOM → 清洗结构 → 拼接 Prompt → 发送云端。而 modelContext 在浏览器内核层面打通了感知能力——模型可以直接理解页面结构、用户交互状态,甚至标签页间的关联信息。
这意味着什么?AI 不再依赖你告诉它“我在看什么”,而是通过浏览器内核直接获取上下文。 对表单辅助、页面摘要、实时翻译等场景,调用代码从几百行缩减到几十行,且数据全程不离开设备。Prompt 工程的重心从“如何描述页面”转向“如何定义任务目标”——这是两个完全不同的复杂度量级。
混合架构设计:本地处理敏感数据,云端兜底复杂推理的落地路径
但 3.5B 参数规模 决定了 Gemini Nano 并非全能。
面对复杂逻辑推理、大规模知识检索时,本地模型仍显力不从心。这就催生了**“端云协同”的混合架构**,其设计原则很清晰:
- 本地优先处理敏感、即时任务:表单填写、实时翻译、隐私数据提取,由 Gemini Nano 在设备端完成,保证毫秒级响应和数据安全。
- 云端兜底复杂推理:当任务复杂度超出本地模型能力阈值,自动路由到 Gemini Pro 或 Claude 等云端高性能模型。
这种架构的关键不在技术实现,而在边界划分。开发者需要在应用层预设“复杂度评估”逻辑——根据用户输入长度、任务类型标签、是否需要外部知识库等因素,决定调用 window.ai 还是转发云端 API。
真正的挑战:什么算“敏感数据”?什么场景“必须本地处理”?这既是技术决策,也是产品合规问题。
但一旦架构搭建完成,开发者获得的是一套兼顾隐私、速度与能力的完整方案。端云协同不是妥协,而是 Web AI 走向生产环境的必经之路。
三、落地挑战:硬件壁垒、能力边界与合规困境
将大模型嵌入浏览器的愿景固然美好,但落地现实远非一片坦途。从硬件门槛筛掉大批设备,到模型能力存在天然天花板,再到地区合规筑起隐形高墙——开发者若只看到技术亮点而忽视这三重困境,项目翻车只是时间问题。
硬件与存储:2GB模型下载与4GB显存要求是否脱离大众用户
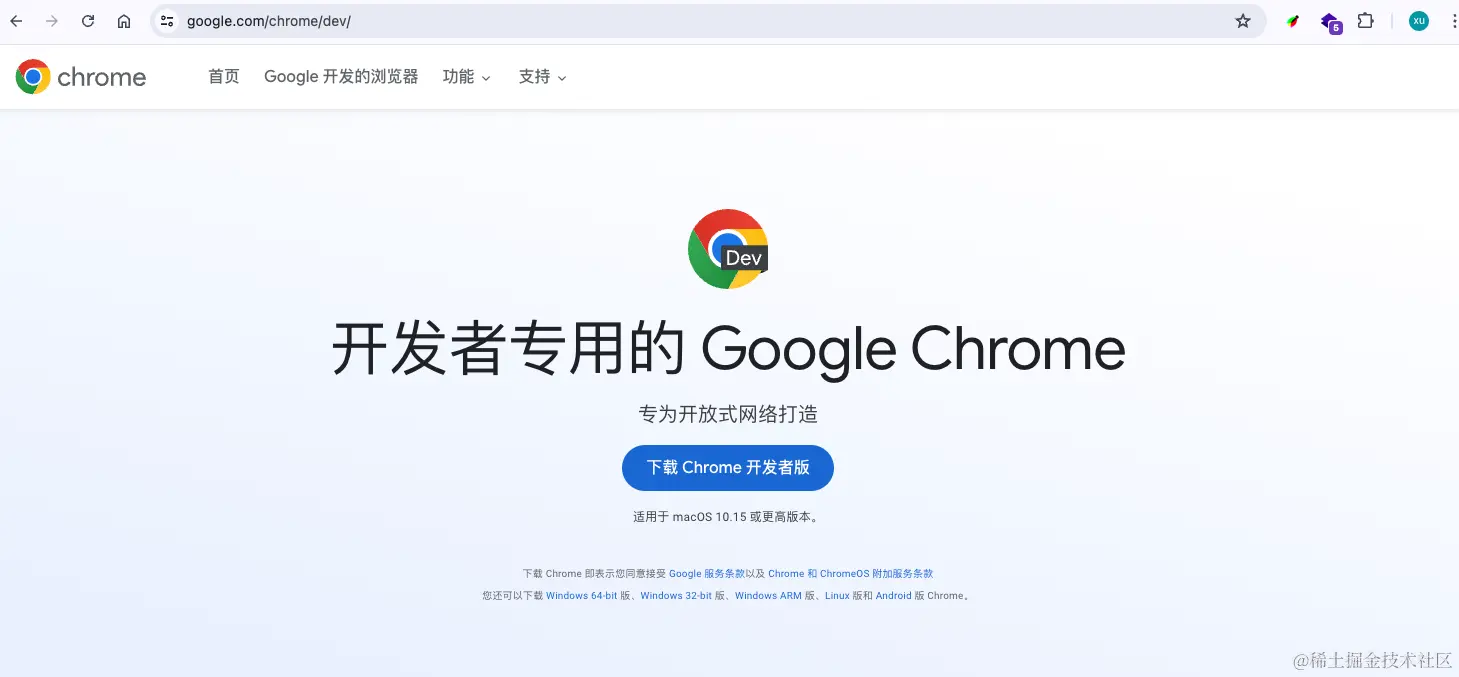
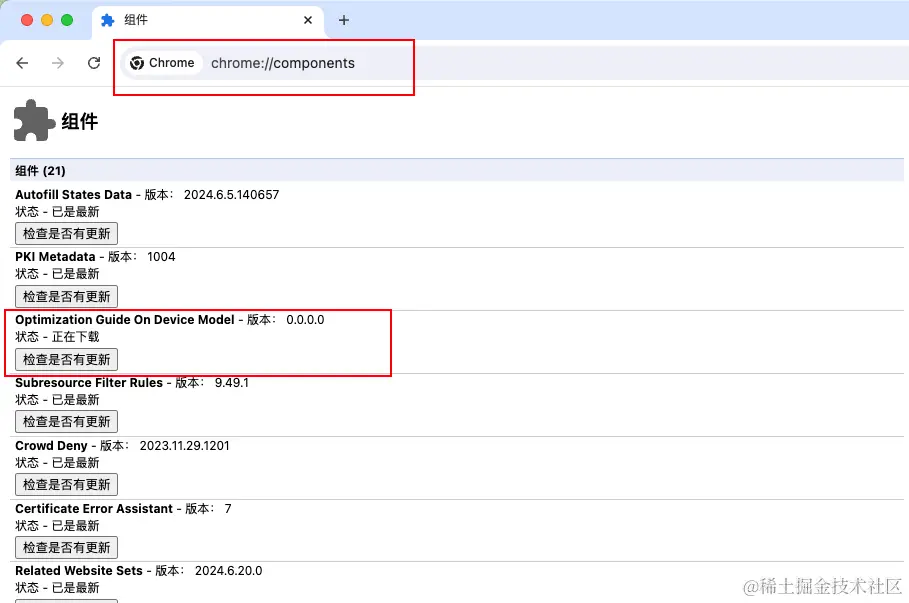
激活Gemini Nano的第一步,就是下载约2GB的模型文件。这个体积对于动辄几十GB的云端模型不算什么,但对浏览器扩展或轻量级Web应用而言,却是不小的准入门槛。
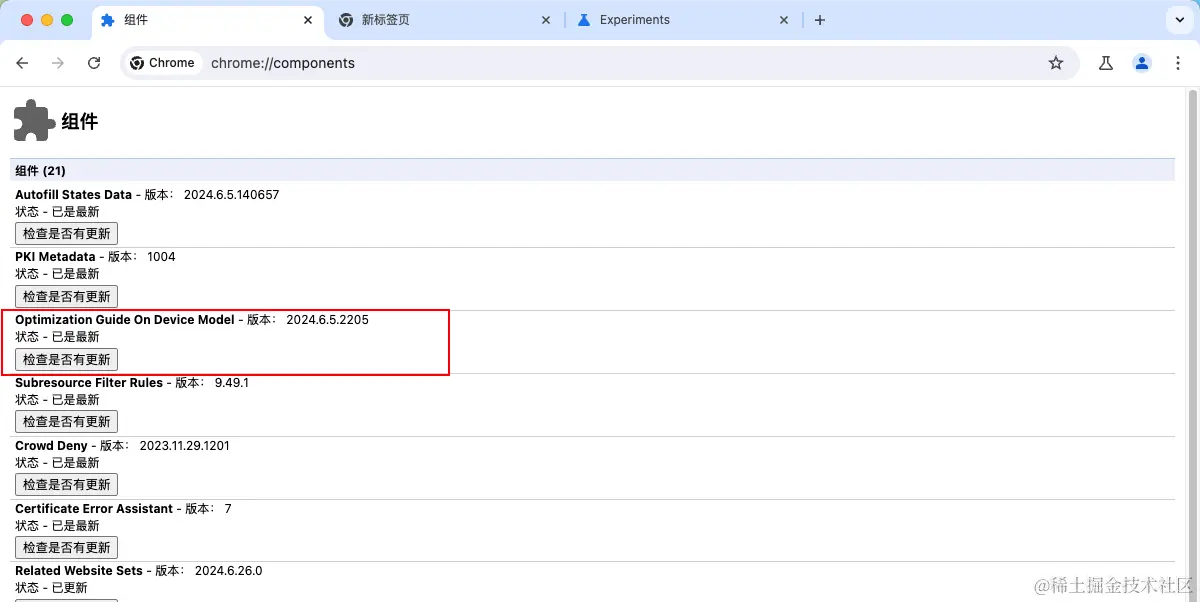
更关键的是硬件筛选机制:Google要求设备至少具备4GB显存,Intel 5500等集成显卡直接被拒之门外。轻薄本、老旧台式机、大部分办公电脑,很可能无法满足运行条件。资料显示,安装Chrome Canary的磁盘至少需要22GB空闲空间,且下载过程依赖Google组件服务——网络不通畅的用户,连模型文件都拉不下来。
本地AI的“普惠”叙事,在硬件壁垒面前露出了残酷的一面:它可能成为少数高配设备的专属能力。
更棘手的是稳定性问题。有开发者反馈,模型“能用一段时间又不能用”,隔天升级版本后才恢复。这种不确定状态,对生产环境部署是致命伤。开发者如果贸然将核心功能押注在本地模型上,等于直接放弃无法满足硬件条件的用户群体。
能力与限制:3.5B参数模型在复杂逻辑推理上的短板与地区壁垒
Gemini Nano在Chrome本地运行的是3.5B参数版本,这个量级直接划定了能力边界。
速度快,但深度不足。实测证明,它在语法修正、实时翻译、文本摘要等轻量任务上表现优异,响应速度远超Phi-3等同类端侧模型。然而一旦涉及复杂逻辑推理、多步骤任务编排或大规模知识检索,3.5B参数的局限立刻暴露。这正是混合架构存在的根本原因——本地模型做不了的重活,必须甩给云端。
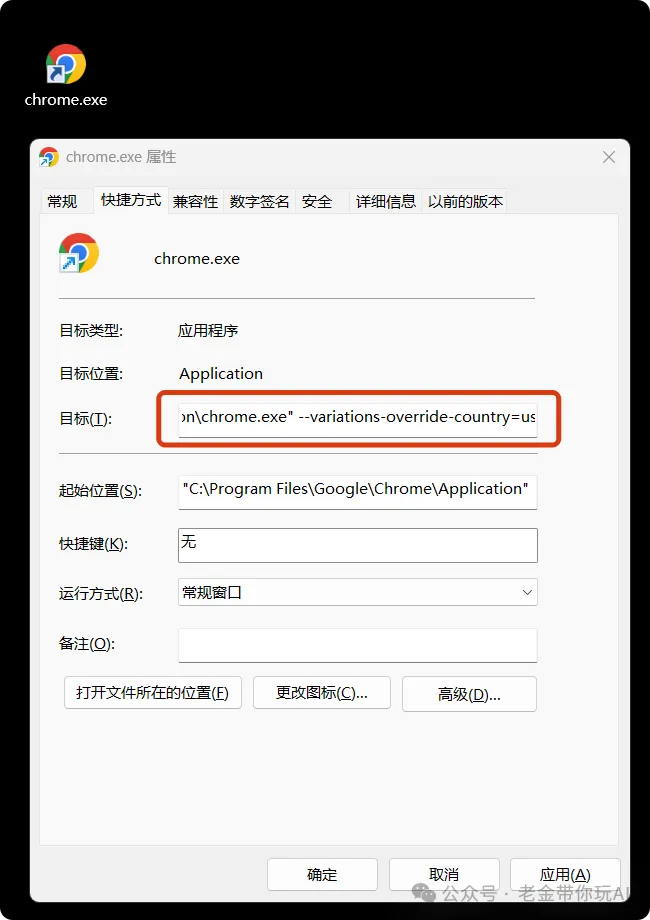
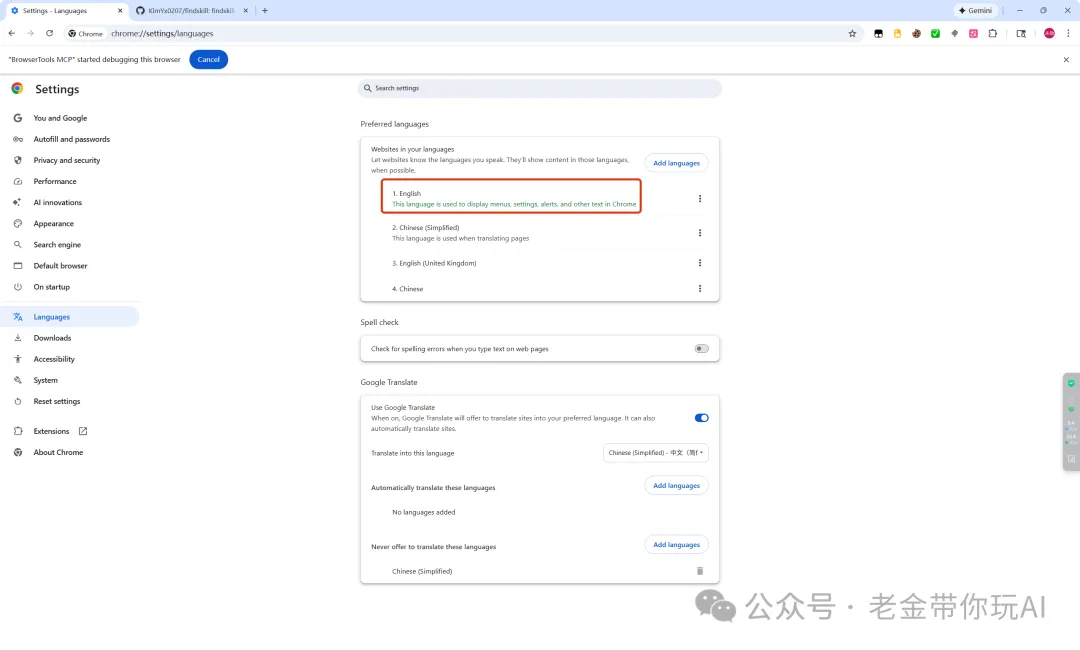
地区合规则是另一道隐形高墙。目前该功能仅对美区账号开放,需要将Chrome语言设为英语、Google账号地区为美国。国内开发者想体验,要么走“快捷方式加参数”的曲线救国路线,要么用脚本模拟地区环境。这些操作不仅增加了接入成本,更意味着正式商用遥遥无期——没有明确的全球开放时间表,开发者只能处于“实验观望”状态。
技术民主化的口号很响亮,但现实中,地区、硬件、语言三重过滤机制,正在制造新的数字鸿沟。

四、前端变局:从页面工匠到AI编排者的角色跃迁
Chrome内置大模型带来的不仅是技术堆栈的改变,更在重塑前端开发者的职业定义。当浏览器本身就是一个AI运行时,开发者面对的不再是静态页面,而是一个能理解上下文、自主决策的智能环境。
开发者角色转变:告别像素级还原,转向智能体行为设计
过去,前端开发的核心工作是像素级还原设计稿、处理浏览器兼容性、优化渲染性能。这些技能的价值不会消失,但重心正在转移。
当navigator.modelContext能直接读取DOM结构,当本地模型能理解用户意图,开发者的职责从“告诉浏览器画什么”变成了**“设计智能体如何理解和响应”**。这类似于从平面设计师变成了交互导演——你不再逐像素绘制,而是定义行为规则和决策逻辑。
核心转变:从“实现UI”到“设计体验路径”。
一个在线文档编辑器的例子就很典型。用户输入“帮我把这段话翻译成法语并保存到云端”,浏览器内置模型通过理解页面上下文,识别出需要“翻译”和“保存”两个动作,再通过MCP协议调用对应工具。开发者的工作不再是写翻译接口和保存按钮的交互逻辑,而是编排智能体的工具调用链,定义在什么条件下触发什么能力。
这意味着前端开发者需要掌握的新能力栈:意图识别设计、工具链编排、异常回退策略。代码量可能减少,但架构决策的复杂度反而上升。你不再纠结于某个按钮的圆角像素,但要思考模型误判意图时如何优雅降级。
分发逻辑重塑:AI原生应用如何打破传统网页的用户获取模式
传统Web应用依赖SEO、社交媒体引流、应用商店推荐来获取用户。但AI原生浏览器环境正在创造新的分发入口。
当Chrome侧边栏的Gemini能主动理解用户正在浏览的内容,用户不再需要“打开某个网站”才能获得服务。他们可能直接在浏览器中完成翻译、比价、信息提取等操作,网页本身从目的地变成了数据源。
这对开发者意味着两件事:
- 能力暴露优先于页面展示:你的工具能否被浏览器AI发现并调用,比你的页面设计是否精美更重要
- API化生存:通过MCP协议将核心能力封装为可被调用的工具,可能比维护一个完整的Web应用更有竞争力
分发逻辑的本质变化在于:用户获取从“拉”转向“推”。AI主动识别需求、主动推荐能力,开发者需要确保自己的服务在AI的工具清单里,而不仅仅在搜索引擎的索引里。
这标志着AI终端从“模型原生”进化到“应用原生”。联想集团围绕Chrome浏览器进行硬件适配的逻辑,同样适用于软件开发者——适配浏览器的AI能力,而不是试图把所有用户拉到自己的页面上。