滴滴猜你要去公司:AI预判需求把决策权前移
滴滴首页从输入框变成推荐卡片,跨境电商选品从数天缩到数小时,AI预判需求正在把决策起点从用户端前移到系统端。效率提升真实存在,但代价是判断力隐性折旧,分界线在于可逆性、风险等级和不确定性。
滴滴猜你要去公司:AI预判需求把决策权前移
滴滴不再问“去哪儿”,AI开始替你拿主意
2018年打开滴滴,首页最显眼的是一个输入框:“你要去哪儿?”四个字,等你开口。现在你还没说话,屏幕已经弹出一张卡片:“猜你要去公司,预计32分钟,现在出发较合适。”
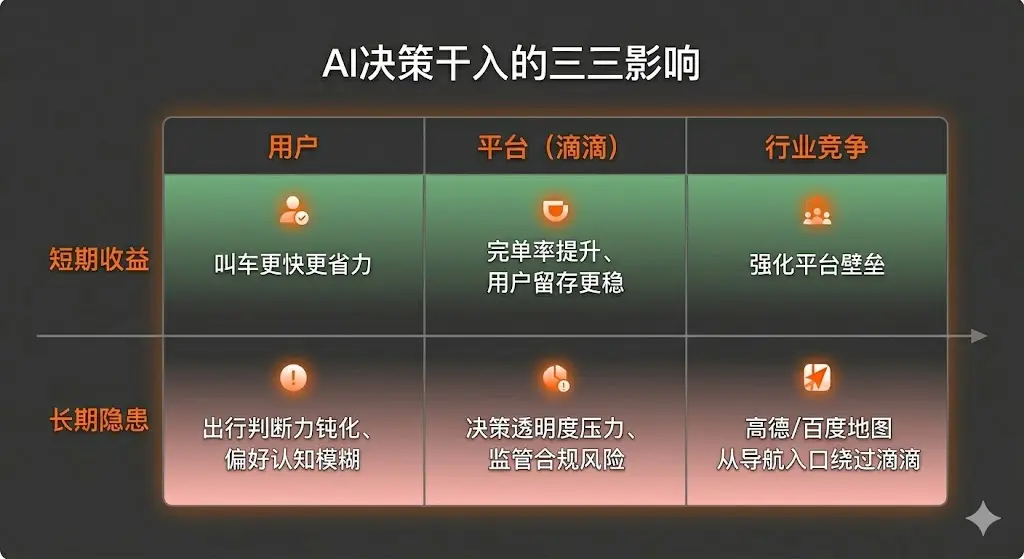
这个变化只用几行代码,却把决策的起点挪了位置。过去是用户先想清楚目的地,再向系统表达;现在是系统根据历史行程、时间和位置先替你生成一个答案,你只需要确认或划掉。AI预判需求把决策起点从用户端前移到系统端。
效率提升是实打实的。少打几个字,少等几秒,对赶时间的上班族就是真实收益。但作者在人人都是产品经理的文章里点破了一个更隐蔽的代价:每一次出行方案都由系统生成,用户慢慢会失去“判断当前情况下什么出行方式最合适”的感知能力。这跟GPS导航让人记不住路是同一个逻辑。
滴滴只是消费级场景的一个切片。当这种预判逻辑进入企业决策链,效率数字会变得更具体,但判断力折旧的代价也更难看见。全文的核心判断先放在这里:效率提升真实存在,代价是用户判断力的隐性折旧;真正的分界线在于哪些决策可逆、哪些不可逆。
跨境电商的AI账:选品从数天缩到数小时,决策节点前移
企业端的数据更直接。2025年中国跨境电商进出口规模达2.84万亿元。2026年9月商务部披露,据有关机构测算,跨境电商企业AI应用率已超过60%。亚马逊《2026中国出口跨境电商发展趋势白皮书》给出的数字更极端:超过98%的受访中国卖家已在运营中使用AI工具,其中16%已从单点工具进阶到部署AI工作流或智能体。
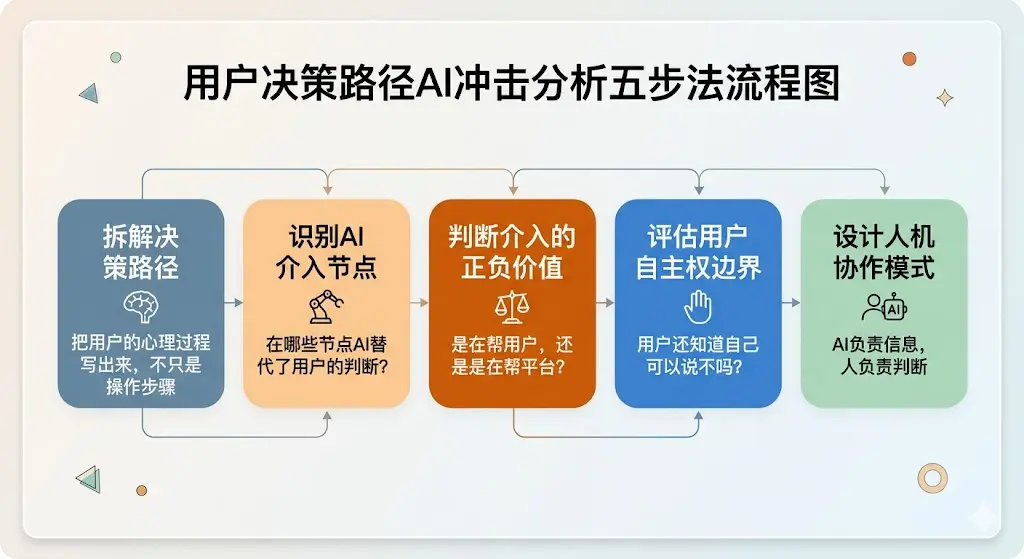
选品是第一个被重构的环节。传统逻辑里,选品经理靠经验和展会信息做判断,一款产品从发现机会到决定上架要走数天。AI介入后,多维度数据整合加评分建模,单款产品分析周期被压缩到数小时。决策节点随之向需求预判前移——系统不再只回答“这款产品过去卖得怎样”,而是直接给出“下一批应该备什么货”的建议。
客服场景的自动化程度更高。基于大模型的智能客服已能实现多语种7×24小时响应与需求主动挖掘,头部企业客服自动化率可达85%。这85%覆盖的是退换货咨询、物流查询、尺码推荐等可标准化问题,处理成本低、出错代价小、用户可随时纠正。
效率收益集中在可逆环节。选品分析从数天缩到数小时,但最终拍板的人还是运营负责人;客服自动应答错了,用户骂一句转人工就能挽回。真正的问题出现在决策节点前移之后:系统开始预判需求,谁为预判失误负责?目前没有答案。
一晚访谈300人之后,判断力成了最后的护城河
孙克强提到一家头部消费电子品牌用觅深科技平台做过一次测试:一晚上完成200多位受访者深度访谈,总量超过300人。过去这活儿要搭团队、飞全国各地、花一整月。效率跃迁是真实的,但孙克强自己把话说得很清楚——AI替代的是高智力重复劳动,判断力非常难被替代。
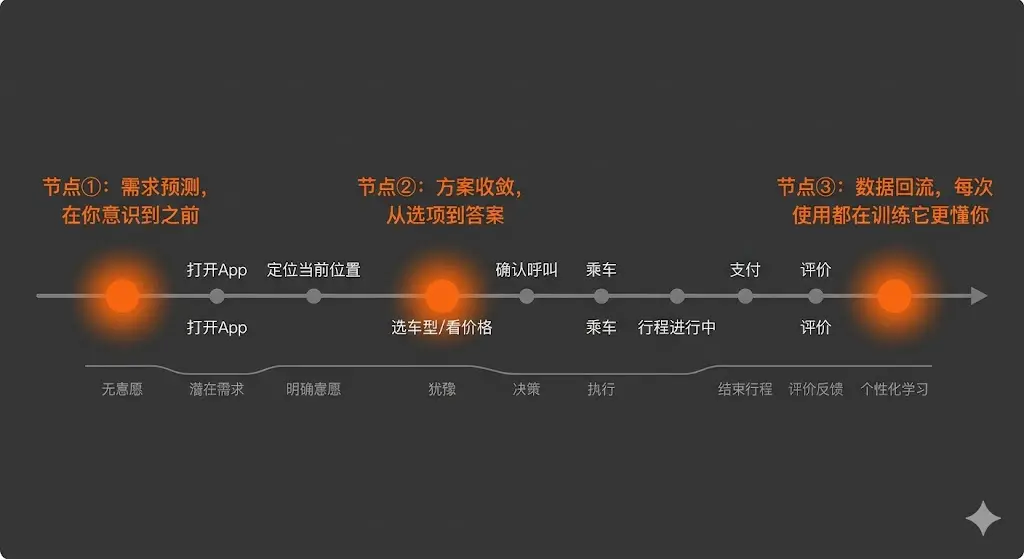
他公司内部的变化更直接。一个售前工程师过去支持两个销售,现在支持六个。客户背景梳理、能力匹配、案例调取、方案初稿,AI全接过去了。这些活儿智力含量不低,但重复性极高。刘润在日课里点过同一件事:高智力活动容易被替代,判断力难。那些只会重复高智力操作的“脑力体力劳动者”,才是第一批被洗牌的人。
孙克强用Meta元宇宙把反面讲透了。扎克伯格每年往Reality Labs砸约100亿美元,Oculus Quest销售始终没达预期,Horizon Worlds用户留存惨淡,2022年股价一度暴跌。这是战略判断失误,AI替不了,也背不了。战略判断的成本以百亿美元计,且不可逆。
落到具体项目,孙克强给出三个硬指标:
| 指标 | 交给AI的条件 | 必须留人确认 |
|---|---|---|
| 可逆性 | 错了能改,成本低 | 错了难回头 |
| 风险等级 | 低风险,出错不伤筋动骨 | 大额付款、合同签署、对外承诺 |
| 不确定性 | 规则清楚,AI有把握 | AI自己也说不准 |
信息整理、生成周报、创建任务、发送提醒,低风险、可逆、规则清楚,AI该干就干。人员决策、大额付款、合同签署,高风险、不可逆,必须留一道人类确认的门。孙克强所在公司的案例来自单一客户,行业和公司名称未披露,代表性有限。但三个指标本身不依赖样本量,它依赖的是决策后果的账。
拿主意的人不会被洗牌。被洗牌的是那些把高智力操作当成判断力的人。
给AI自主权之前,先划清可逆与不可逆的线
企业级AI预判项目最容易死在一个环节:上线了,但没人说得清它到底该干什么。Log-Hub对供应链需求预测项目的分析把话说得很直——自主性层级不清晰,AI预测项目只会产出仪表盘而非决策。团队吭哧吭哧干半年,最后交付一块大屏,上面全是曲线和红绿灯,但没人敢让系统真做点什么。
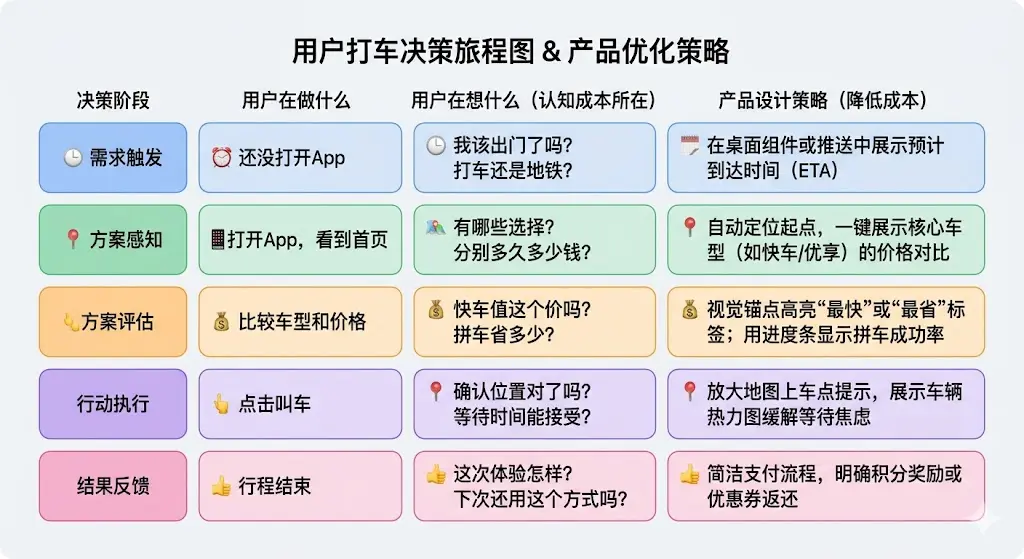
启动前第一件事,是把目标自主性层级写死在项目章程里。Log-Hub给了三级框架:
| 层级 | 系统做什么 | 人做什么 |
|---|---|---|
| 监控告警 | 盯数据、报异常 | 全部决策 |
| 情景模拟 | 算方案、推结果 | 在方案间拍板 |
| 限定自主执行 | 在预设边界内直接执行 | 处理边界外异常 |
层级不写清,交付物就漂移成仪表盘。问题出在目标定义,不在技术能力。
治理成本同样需要提前入账。数据集成占AI实施时间线的42%,按Kumar等人2024年的研究口径。一个六个月的AI预测项目,约两个半月耗在把数据弄干净、打通、对齐口径上。预算和排期按这个比例留,别等项目跑到一半才发现治理活儿没人干。
护栏必须前置。Log-Hub的建议是“先设治理护栏,再授自主权”。具体动作包括:限定自主执行的范围、设定人工确认节点、明确异常升级路径。护栏是项目启动时就该定死的边界条件。
后续跟踪只看两个数:自主执行比例是否与可逆性评估结果匹配,以及人工确认节点是否被绕过。第一个数看系统有没有越权,第二个数看人有没有偷懒。两个都盯住,自主权才收得回来。