LLM Wiki vs 传统RAG:知识库从“检索”到“编译”的革命?
LLM Wiki vs 传统RAG:知识库从“检索”到“编译”的革命?
最近给一个做智能客服的朋友做技术咨询,他一脸愁容地问我:“为什么我给模型喂了几百份产品文档,它回答‘A功能和B功能怎么联动’时还是胡说八道?”
这不是他一个人的困惑。传统RAG在知识库领域几乎成了标准答案,但用过的都知道,它像个临考前一晚疯狂翻书的学霸——每次提问,都要把资料翻出来现场拼答案,答完就忘,下次再问重来一遍。
这引出了一个根本性的分歧:知识的组织,应该在查询时“拼凑”,还是在摄入时就“编译”好?
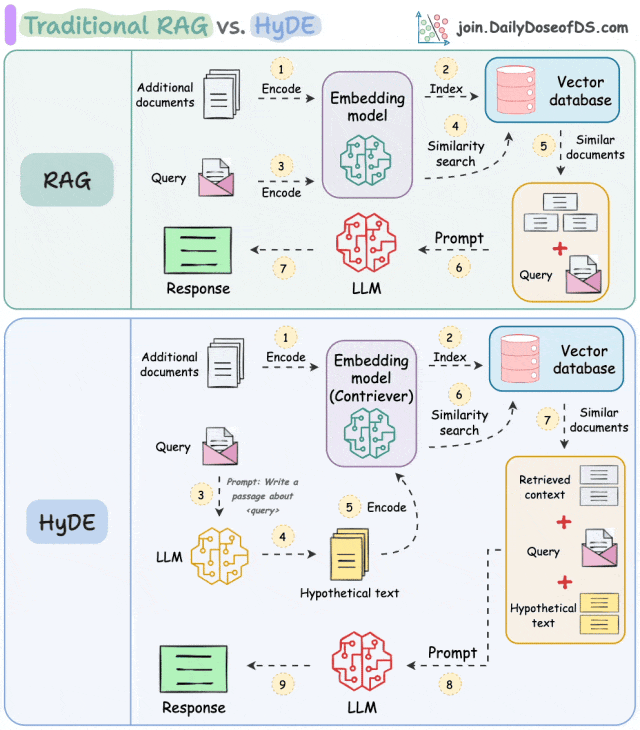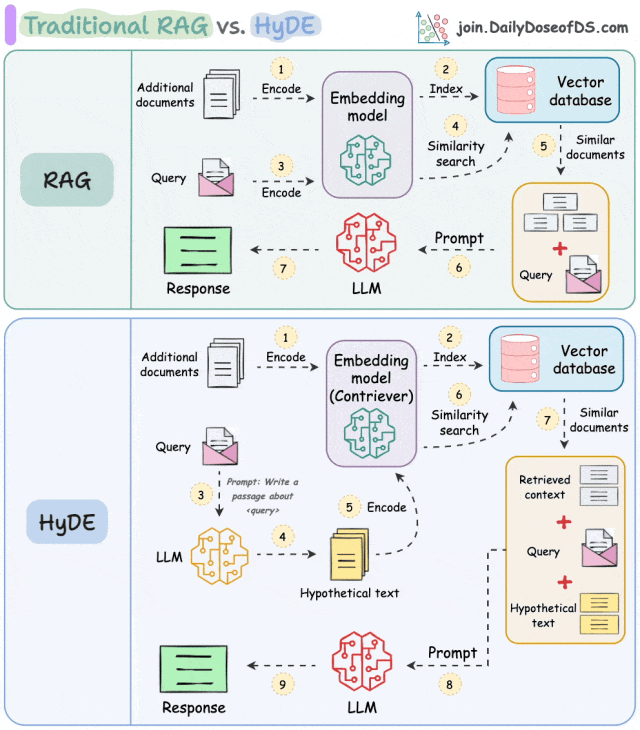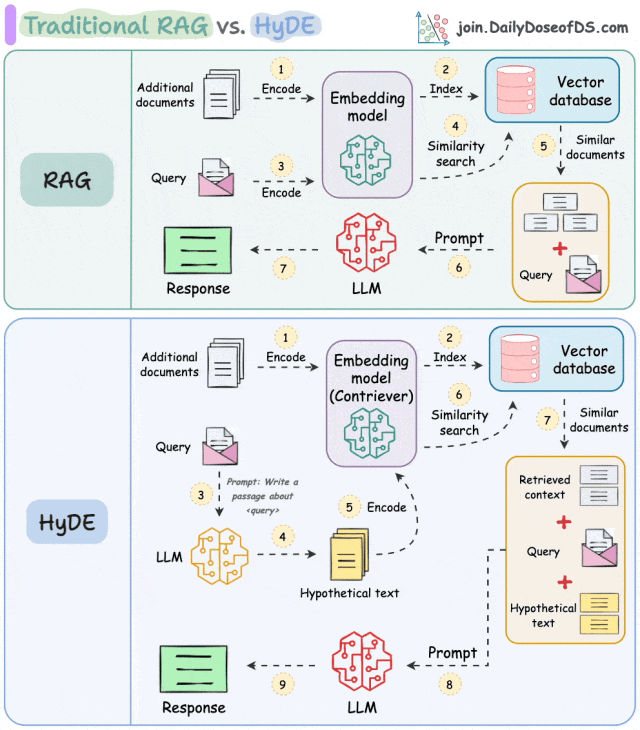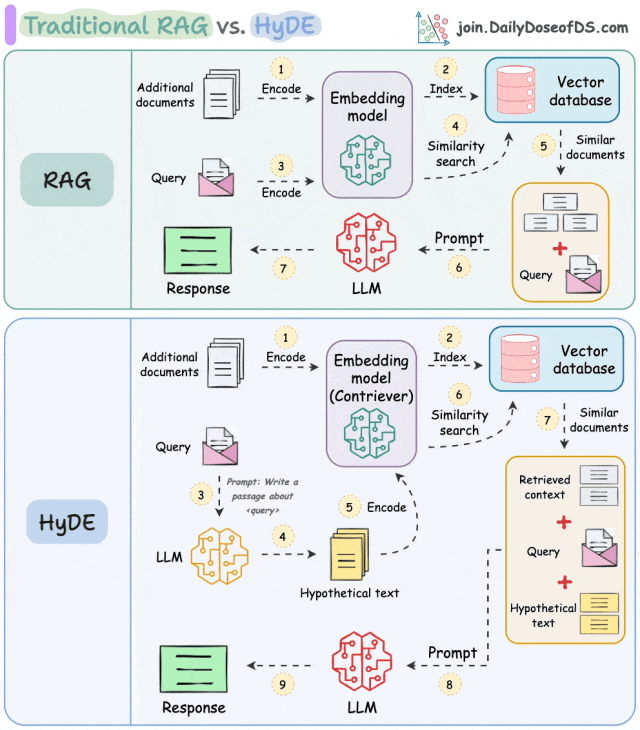
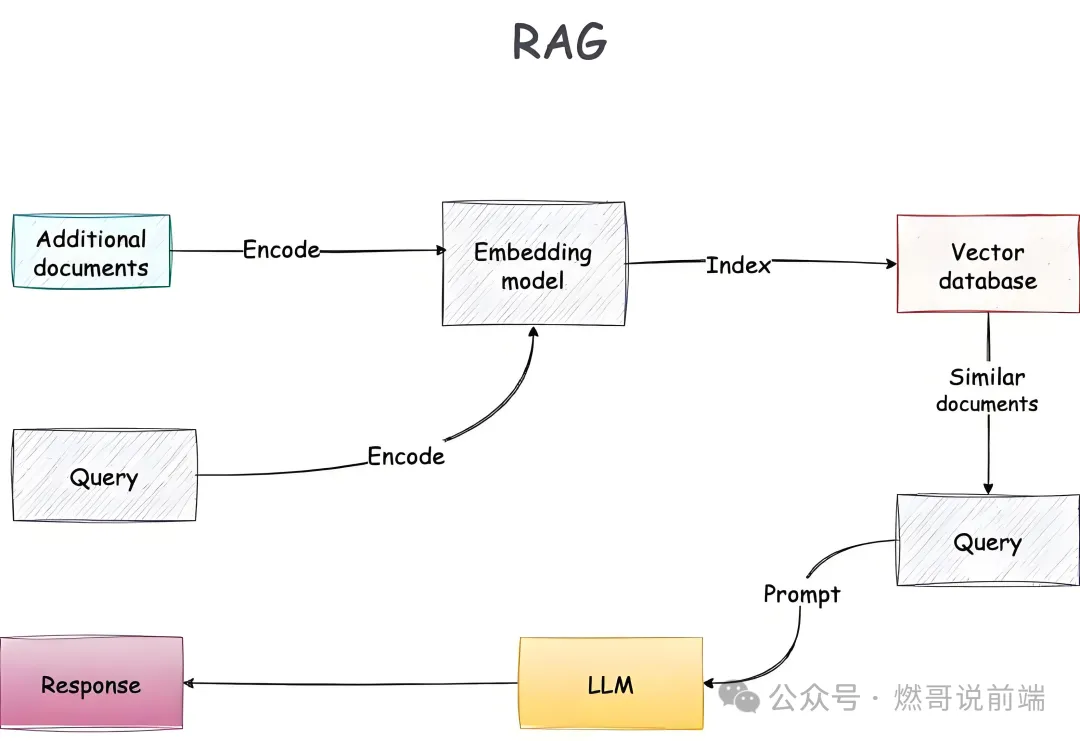
传统RAG的底层逻辑,本质上是一场实时语义拼图游戏。当你问“AI Agent的核心组件有哪些”,系统做的事很简单:把你的问题转成向量,去向量库里搜最相似的几个文本块,然后一股脑塞给大模型:“喏,根据这几段话回答,别瞎编。”这就是典型的**“解释器模式”**——每次查询,都要重新解析原始文档、重新推理。
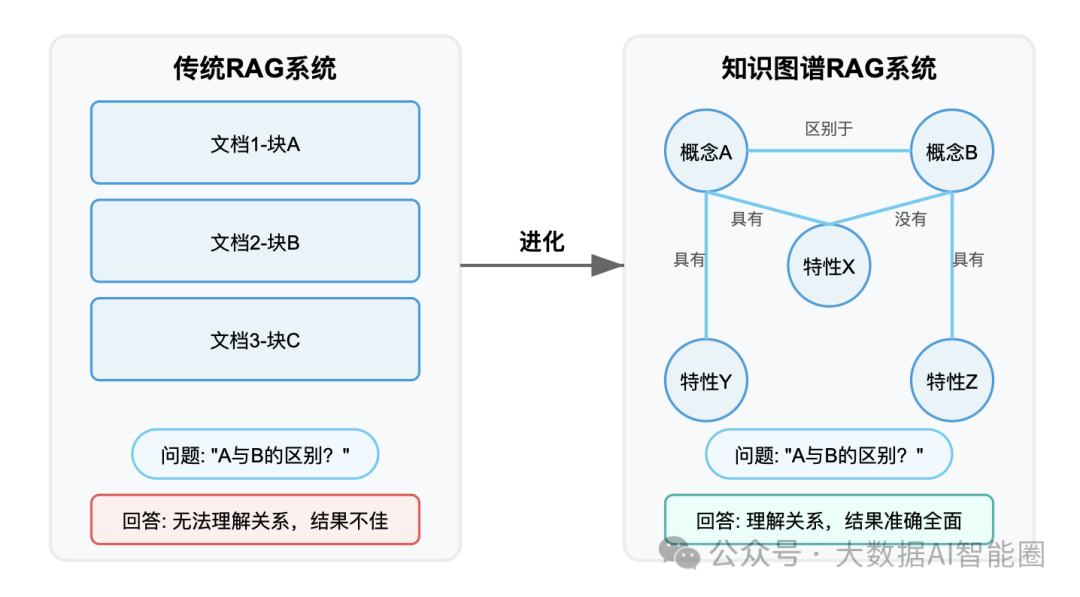
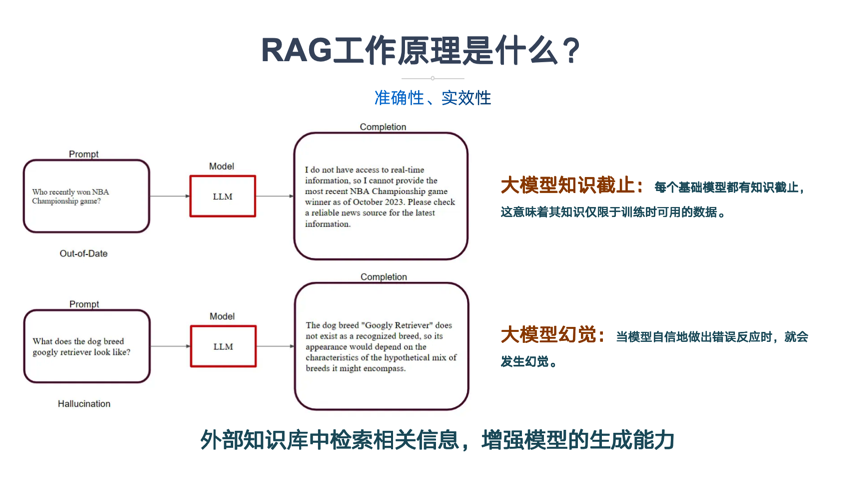
它的致命缺陷在于无状态。这次检索不会留下任何“学习成果”,下一次提问的检索路径、拼凑逻辑、上下文关联,全部在回答结束后清零。更麻烦的是碎片化盲区——RAG给出的是孤立的文本片段,大模型就像盲人摸象,拿到一段讲“Planning”的chunk就说Agent的核心是规划,拿到“Memory”的片段就说核心是记忆。它很难建立跨文档的逻辑关联,更别说发现新旧知识的矛盾了。Karpathy的研究揭示了一个残酷事实:RAG按语义相似度检索,命中率随文档长度和Chunk质量剧烈波动,一旦文档超过一定规模,准确率断崖式下跌。
传统RAG = 雇了个临时工,每次干活都要重新看一遍资料,干完就忘。
LLM Wiki直接把这个逻辑倒了过来。它的核心思想来自Karpathy的精妙比喻:把RAG从“解释器”升级为“编译器”。原始资料一进来,不是简单切块存向量,而是由大模型预先“编译”成一本结构化、带交叉引用、不断更新的个人维基百科。
具体怎么编译?当你丢进一篇新论文,AI Agent会自动读取、理解,然后生成或更新相关实体页、概念页、综述页,并用双向链接将所有页面编织成知识图谱。一份材料可能同时触发十几个Wiki页面的连锁更新——这就是**“有状态图谱”的核心:知识之间的关系被预先建立、持久化存储、持续维护。当你再提问时,模型不需要从碎片堆里翻找,而是沿着已经编译好的知识链接,精准定位所需信息。知识不再每次清零,而是产生复利效应**——越用越聪明,越积累越深刻。
LLM Wiki = 雇了个全职秘书,资料给她一次,她整理成完美笔记,越记越全。
看到这里,你可能会问:“那LLM Wiki是不是直接干掉RAG了?”
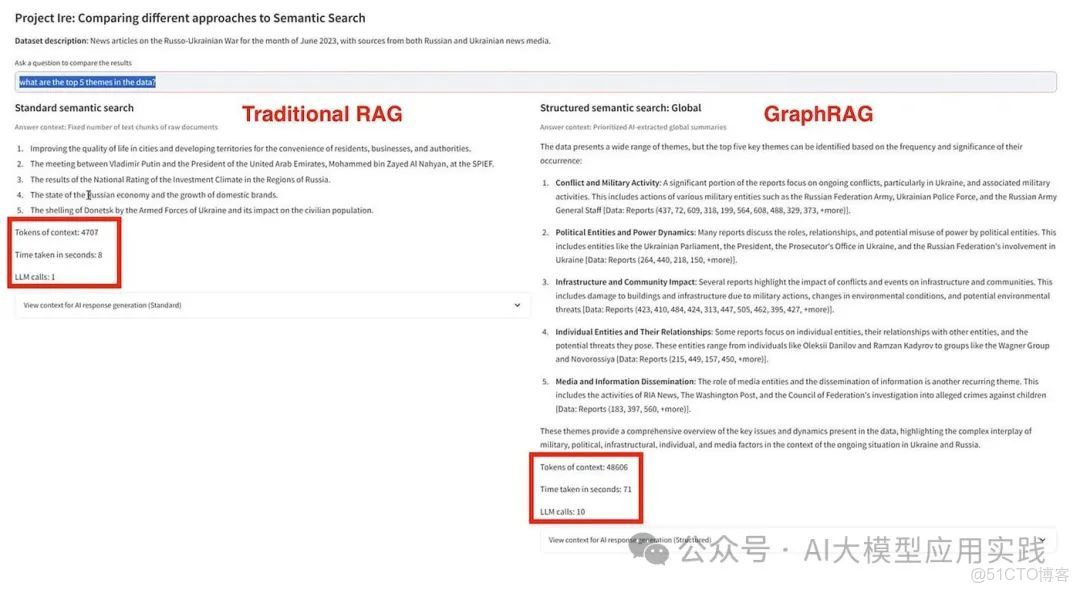
没那么简单。两者的分水岭,本质上是**“检索的便捷性”与“知识的可沉淀性”之间的取舍**。传统RAG的优势在于零门槛冷启动:丢进文档就能问,不需要前期处理。对“这份合同里违约金条款怎么说”这类简单事实查询,它足够快、足够便宜。但一旦涉及“对比2026年Q1各厂商在医疗领域的表现差异”这类需要综合多份文档、全局理解的问题,RAG就露怯了——每次都要重新把碎片拼起来,还拼不全。
LLM Wiki牺牲了冷启动速度,换来了长期的知识沉淀。前期编译成本高,但查询时直接读结构化页面,延迟从秒级降到毫秒级,成本砍掉90%以上。更重要的是,它真正让AI在“学习”和“成长”,而不是每次都失忆重启。正如资料中那个经典对比:在Agent Harness概念页,LLM Wiki同时容纳了正反两方观点,还用表格对比了两种流派的差异——这种跨文档的交叉引用和矛盾标注,RAG是做不到的。
所以,这不是替代关系,而是不同阶段的选型问题:要快速出demo,选RAG;要构建长期演进的知识系统,LLM Wiki是更根本的解法。
二、深度对比:LLM Wiki如何解决RAG的“森林”盲区与碎片化之痛?
RAG的核心短板不在于“找不到”,而在于“看不见全局”。当问题需要综合多份文档的矛盾观点时,碎片化检索的结构性缺陷便暴露无遗。LLM Wiki的价值,正是在这些传统方案失效的场景中得以凸显。
2.1 全局理解力与幻觉控制:从“断章取义”到“强溯源”
RAG的运作逻辑是语义相似度匹配——将问题向量化,从文档库中召回最相似的Chunk,拼接后交由模型生成答案。这个过程中,模型从未真正“阅读”过完整文档,它看到的只是被切割后的孤立片段。
这带来两个致命问题:
第一,跨文档的矛盾盲区。 当资料A主张“多Agent架构是未来”,资料B批评“多Agent是过度设计”时,RAG无法主动发现这两种对立观点。它只会根据提问召回其中一边的片段,生成看似完整实则片面的答案。LLM Wiki的做法截然不同——它在编译阶段就识别出这种对立,直接在概念页用表格对比两种流派,标注来源和差异点。这是知识的结构化沉淀,而非临时拼凑。
第二,幻觉的溯源困境。 RAG生成的答案混入了检索片段和模型自身知识,你无法判断哪句话来自文档、哪句话是模型“脑补”的。LLM Wiki则天然具备强溯源能力——每个实体页、概念页都有明确的链接关系,答案可追溯至原始材料。用Karpathy的话说,这是“编译一次,持续维护”,而非“每次从零开始”。
核心差异在于:RAG是“查询时拼图”,LLM Wiki是“摄入时建图”。前者追求检索速度,后者追求知识深度。
当用户问及“AIAgent各组件之间的依赖关系”时,RAG可能召回分别提及Planning、Memory、Tool的三个孤立文本块,但这些碎片之间没有逻辑连线。模型只能在信息真空处自行脑补,这正是幻觉的温床。而LLM Wiki预先构建的知识图谱中,Planning→调度→Tool Use、Memory→支撑→上下文管理的关系链路已被明确标注,模型直接在已建好的关联网络上导航,而非猜测。
2.2 知识维护成本:AI自动去重演进 vs 人工整理与零积累
传统RAG模式下,知识维护是不存在的。你扔进去的文档永远是原始形态——重复的内容、过时的信息、矛盾的观点,全部原封不动地躺在向量库里。每次查询,模型都在这些未经整理的“原材料”里翻找。更棘手的是,你问过100次关于“Transformer架构”的问题,第101次它依然从零开始检索原文片段,零积累,零进化。
LLM Wiki重新定义了维护成本的结构:
- 去重与合并:AI在编译新资料时,自动检查已有Wiki页面,合并重复实体、更新过时概念。一份新材料可能触发十几个页面的联动更新。
- 矛盾标注:当新旧资料观点冲突时,AI不会悄悄覆盖,而是显式标注
[!Conflict],形成可追溯的知识演进记录。 - 持续复利:知识库的价值随编译次数递增。第一次编译成本最高,后续增量更新成本递减,知识网络反而越密集、越有价值。
但这里有一个被忽略的真相:AI自动维护也有代价。模型在编译时可能“偷懒”——一次性浅读多份材料,生成的Wiki页面信息密度极低,跟目录没什么区别。实际落地中,需要优化提示词让模型逐份精读,甚至分段处理长文档。这不是理论问题,而是工程挑战。
最终,两者的维护成本曲线完全不同:RAG是零维护但零积累,查询质量随规模膨胀而劣化;LLM Wiki需要前期重投入,但产生知识复利。选择哪种,取决于你是在建一个“临时工具”,还是在培养一个“数字大脑”。
三、选型悖论:LLM Wiki是“银弹”还是昂贵的“花瓶”?
LLM Wiki的编译器模式确实令人耳目一新,但任何技术选型若只谈优势而回避代价,都是不负责任的。在决定是否从RAG切换到LLM Wiki之前,有两个关键问题必须正面回答:前期投入是否可承受?知识质量的风险是否可控?
3.1 隐藏的代价:前期编译成本与总结偏差的致命弱点
LLM Wiki的“编译”并非免费午餐。它的代价体现在两个维度:Token消耗和信息失真风险。
前期编译成本是硬门槛。 传统RAG几乎零成本入库——切分文档、生成向量即可。但LLM Wiki要求每篇新资料都经过LLM深度处理:提取实体、撰写摘要、更新相关页面、添加双向链接。Karpathy本人也承认,首次导入大量资料时,“LLM要疯狂写页面,耗时耗Token”。一篇技术论文的编译,可能触发10-15个Wiki页面的连锁更新。对于日均新增数百份文档的企业场景,这笔成本不容忽视。
更隐蔽的风险在于总结偏差。 LLM Wiki的核心假设是“AI总结的信息足够准确”,但这个假设本身就很脆弱。大模型在提炼原文时,可能出现三种偏差:
- 遗漏关键细节:为追求简洁,删除了看似次要实则关键的边界条件
- 错误归纳:将特例误判为普遍规律,或将相关性理解为因果性
- 过度概括:模糊了原文中的精确限定词,导致知识“稀释”
传统RAG直接检索原文碎片,虽然碎片化,但至少保留了原始表述。LLM Wiki的编译层一旦引入偏差,后续所有问答都建立在这个偏差之上——错误会被系统性地放大,而非纠正。
这正是LLM Wiki必须保留raw/目录作为不可篡改的事实基准、并要求所有结论可追溯到原始文档的根本原因。但即便有溯源机制,用户实际查询时往往只读Wiki页面,很少逐条核对原文。编译层的偏差,在实践中极易成为“沉默的杀手”。
3.2 场景化决策:何时值得为“知识复利”额外付费?
理解了代价之后,选型的关键不是“哪个更好”,而是“你的场景更需要什么”。可以从三个维度判断:
值得投入LLM Wiki的场景:
- 知识密集型且相对稳定:技术文档、学术研究、产品知识库,资料增长可控,知识半衰期长,前期编译成本能被长期复用摊薄
- 需要全局理解的问题占比高:用户经常问“这个系统的整体架构是什么”“A和B之间有什么关系”,而非“某个参数是多少”
- 知识沉淀本身即核心价值:团队需要积累领域认知资产,而非仅仅快速查答案
传统RAG更优的场景:
- 文档高频更新、时效性优先:新闻摘要、实时政策解读、动态业务数据,编译速度跟不上变化速度
- 查询以事实检索为主:用户问题多为“某条款怎么规定”“某参数值是多少”,碎片化检索完全够用
- 预算有限且准确率要求极高:宁可直接看原文片段,也不愿承担总结偏差的风险
一个务实的组合策略是:用RAG处理“热数据”(高频更新、时效敏感),用LLM Wiki沉淀“冷数据”(相对稳定、需要深度理解)。两者并非替代关系,而是互补关系——RAG解决“快”的问题,LLM Wiki解决“深”的问题。
核心判断标准只有一个:你的知识库是“消费品”还是“资产”? 如果每次查询后知识就失去价值,RAG完全够用。如果知识需要沉淀、生长、产生复利,LLM Wiki的前期投入才值得。资料中反复提到的一句话值得深思:“garbage in, garbage out”在今天依然成立——解析质量决定了编译质量的上限。如果你决定采用LLM Wiki,投入最好的解析策略和最强的模型,不是奢侈,而是防止知识库被系统性地污染的必要成本。