Token 正在变成财务指标:Agent 测评的会计学转向
当 Agent 工作流把多个模型、工具、重试和人工审核串成一条任务轨迹,Token 消耗不再等于模型账单。本文从最小成本单位、成功任务成本、单位经济学三个层面说明:为什么按 Token 直接计费会失真,为什么低 Token 消耗可能反而更贵,以及 CFO 真正该看的是每次成功结果的成本,而不是聚合 Token 账单。
Token 正在变成财务指标:Agent 测评的会计学转向
Token 不再是「用量」,而是「成本」
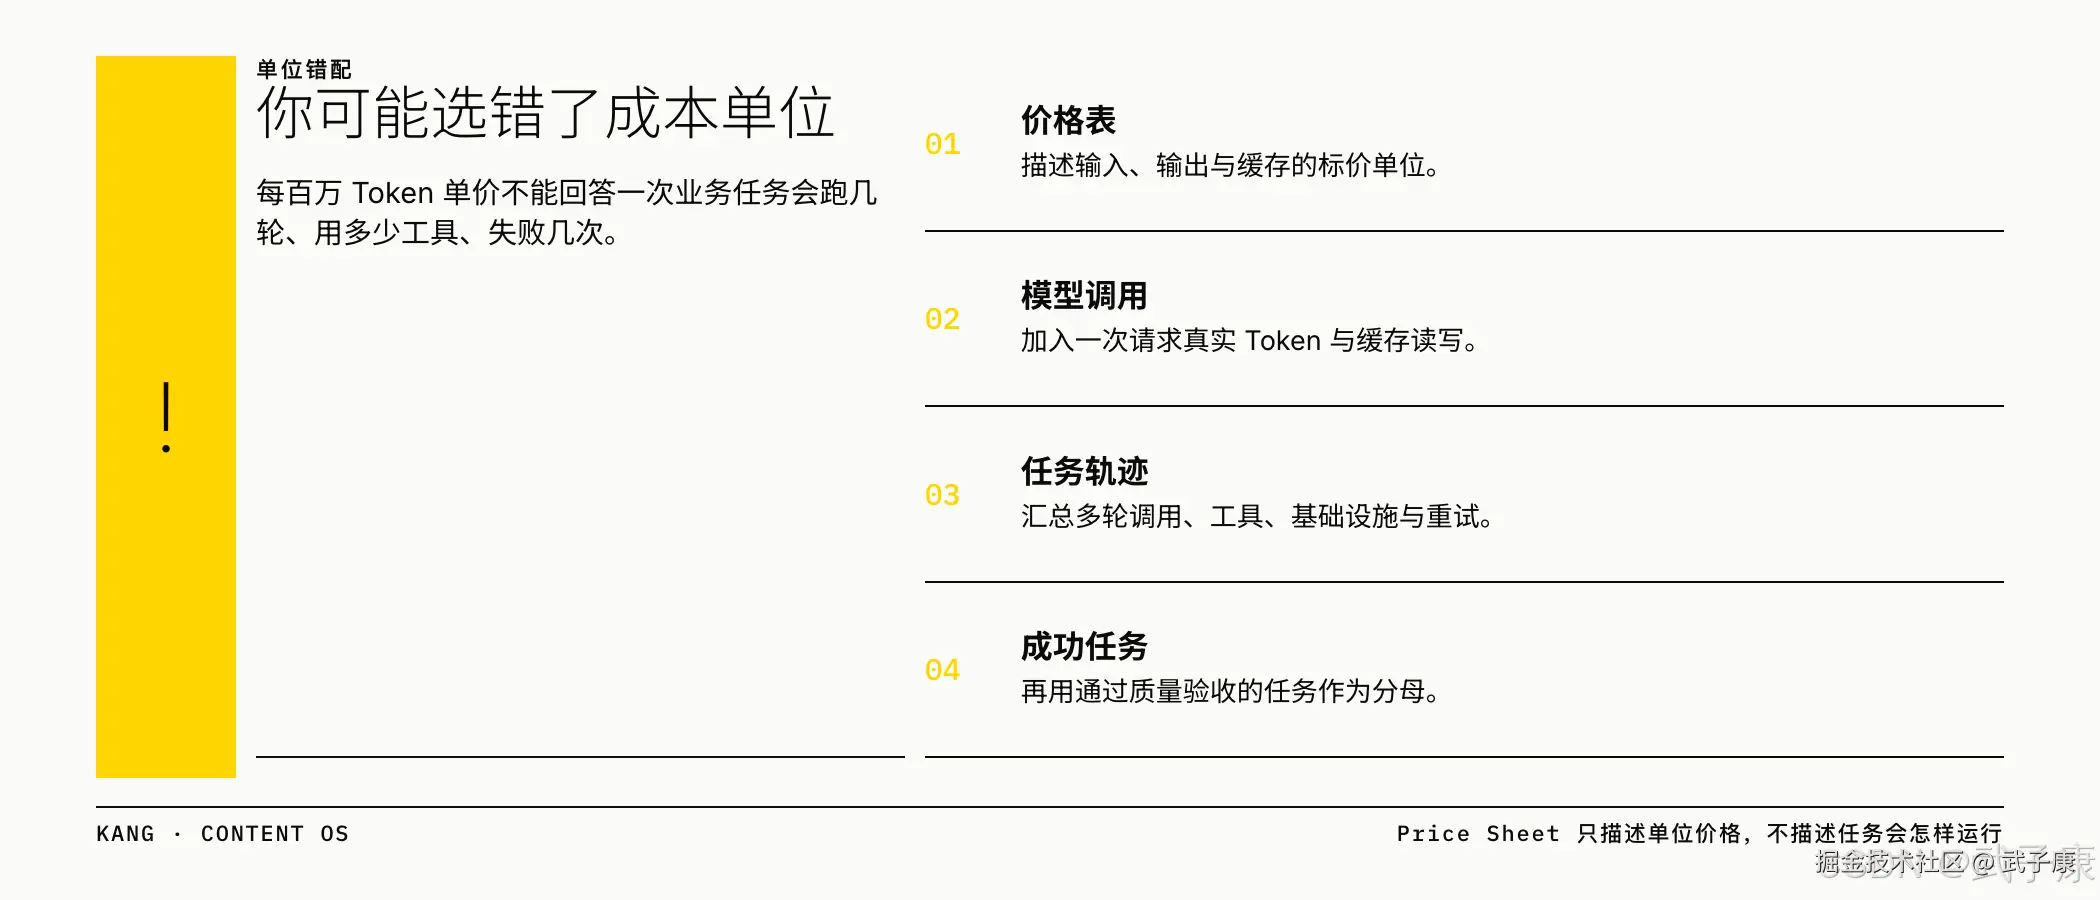
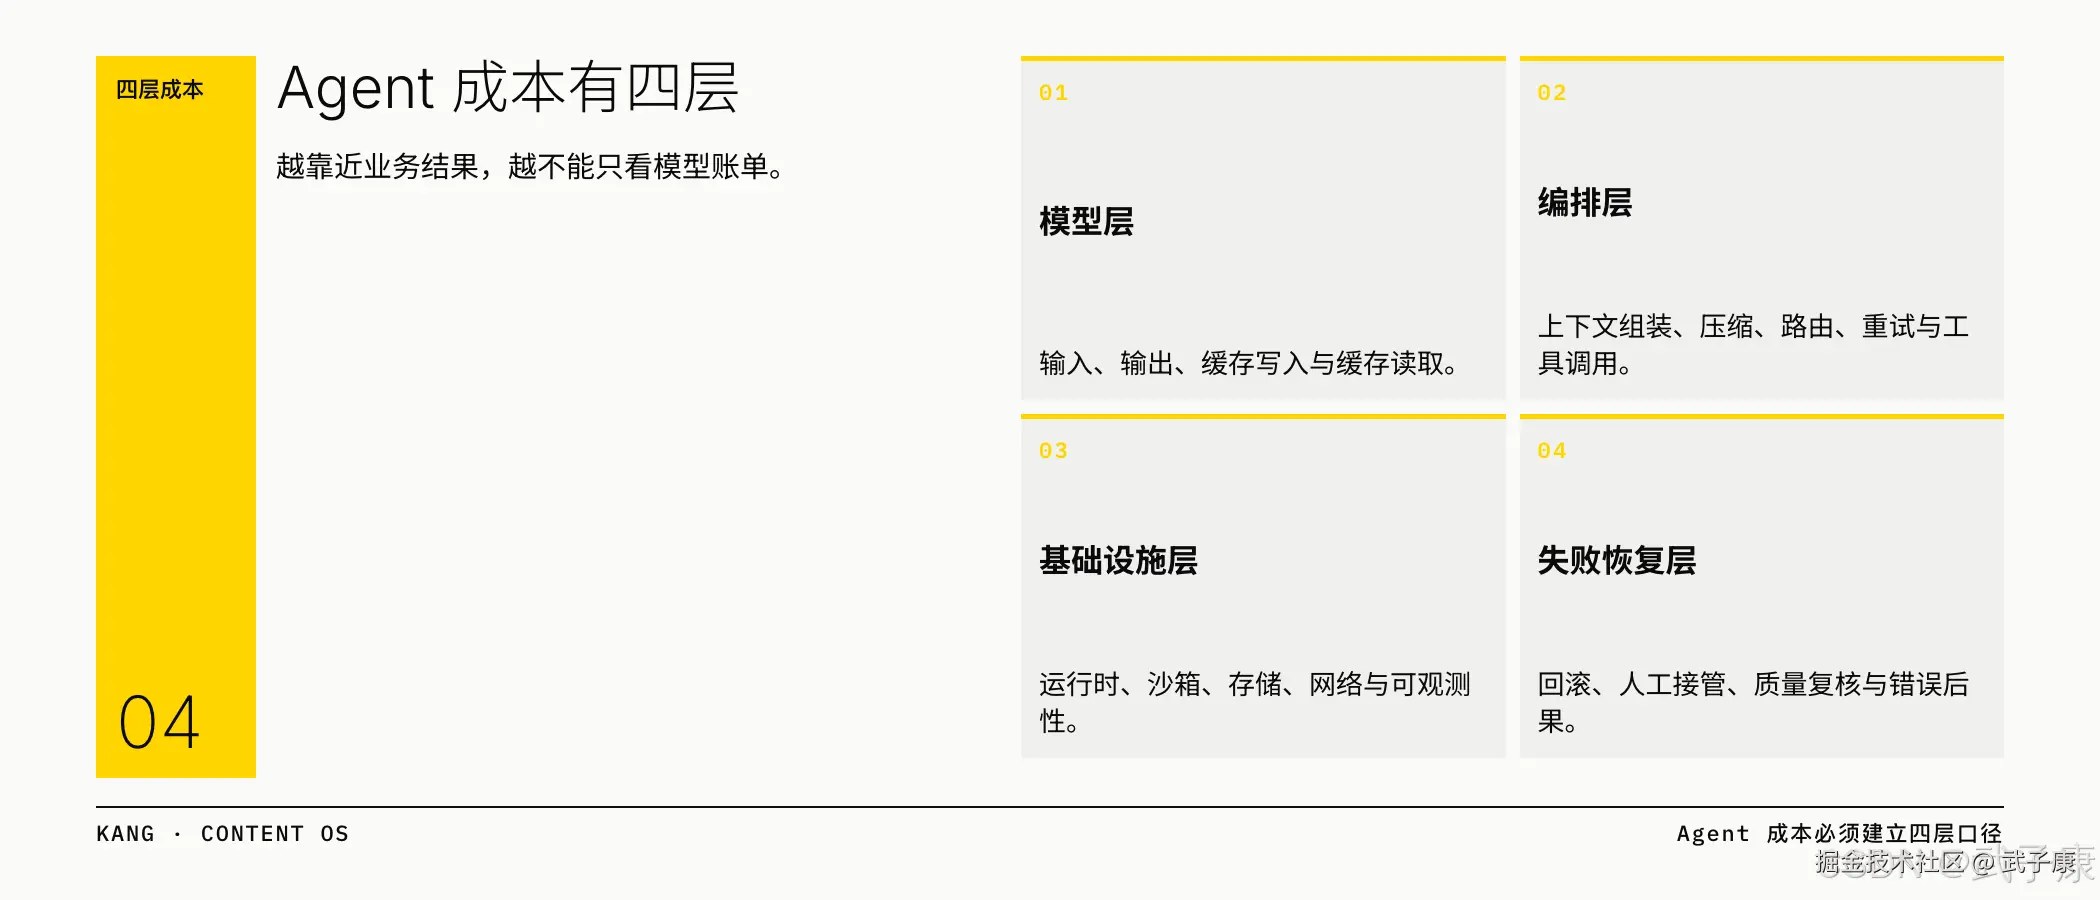
Token 消耗的财务化,实质是成本核算单位从单次模型调用转向包含缓存、工具、重试、失败和人工处理的完整任务轨迹。Agent 的一次任务不是一次调用,而是一条会分叉、会回头、会卡住的路径。单价仍然存在,但它已经不能单独回答「这次任务花了多少钱」。
从模型调用到任务轨迹:成本单位变了
在单轮对话或单次生成场景里,Token 成本可以近似为一次 ModelCall:输入 Token 乘以输入单价,加上输出 Token 乘以输出单价。这个公式在 Agent 出现之前基本够用。但 Agent 的行为模式不同。VibePay 在讨论多模型费用分摊时明确建议,不要「把用户发送一次消息直接当成一次 Token 费用」,因为 Agent 可能先调用规划模型,再调用检索模型和生成模型。最小成本单位应当是模型调用,而不是用户消息;再把多个调用归并到同一 Agent 任务下。
成本核算的粒度必须下沉,同时又要重新向上聚合。下沉到每一次模型调用,是因为不同模型的输入输出单价不同;聚合到任务,是因为只有任务才是业务上可识别、可归因的单位。一个任务里可能包含一次便宜的规划调用、三次昂贵的生成调用、两次工具调用和一次失败后的重试。如果只看其中任何一次调用,都会低估或高估真实消耗。
为什么单价低反而总成本高
IBM Research 在 2026 年 7 月发布的一个测试结果把这个问题暴露得很清楚。在相同的 CodeAct Agent 下运行 417 个 AppWorld Test Challenge 任务,Claude Sonnet 4.6 的总成本是 79 美元,约 0.19 美元/任务;GPT-4.1 的总成本是 155 美元,约 0.37 美元/任务。按照 IBM 当时采用的价格快照,GPT-4.1 的输入和输出 Token 单价更低,Sonnet 的推理步骤还大约多三倍,但最终总账却相反。
这个结果不能外推为两个模型的普遍优劣。它受特定任务集、价格快照、缓存行为和运行配置约束。但它足以推翻一个默认假设:单价低就意味着任务便宜。在多步 Agent 中,总成本由任务轨迹的长度、重试次数、工具调用频率和缓存命中情况共同决定。一个单价更低的模型,如果规划不稳定、频繁重试或工具调用冗余,完全可能把省下来的单价差额成倍吐回去。
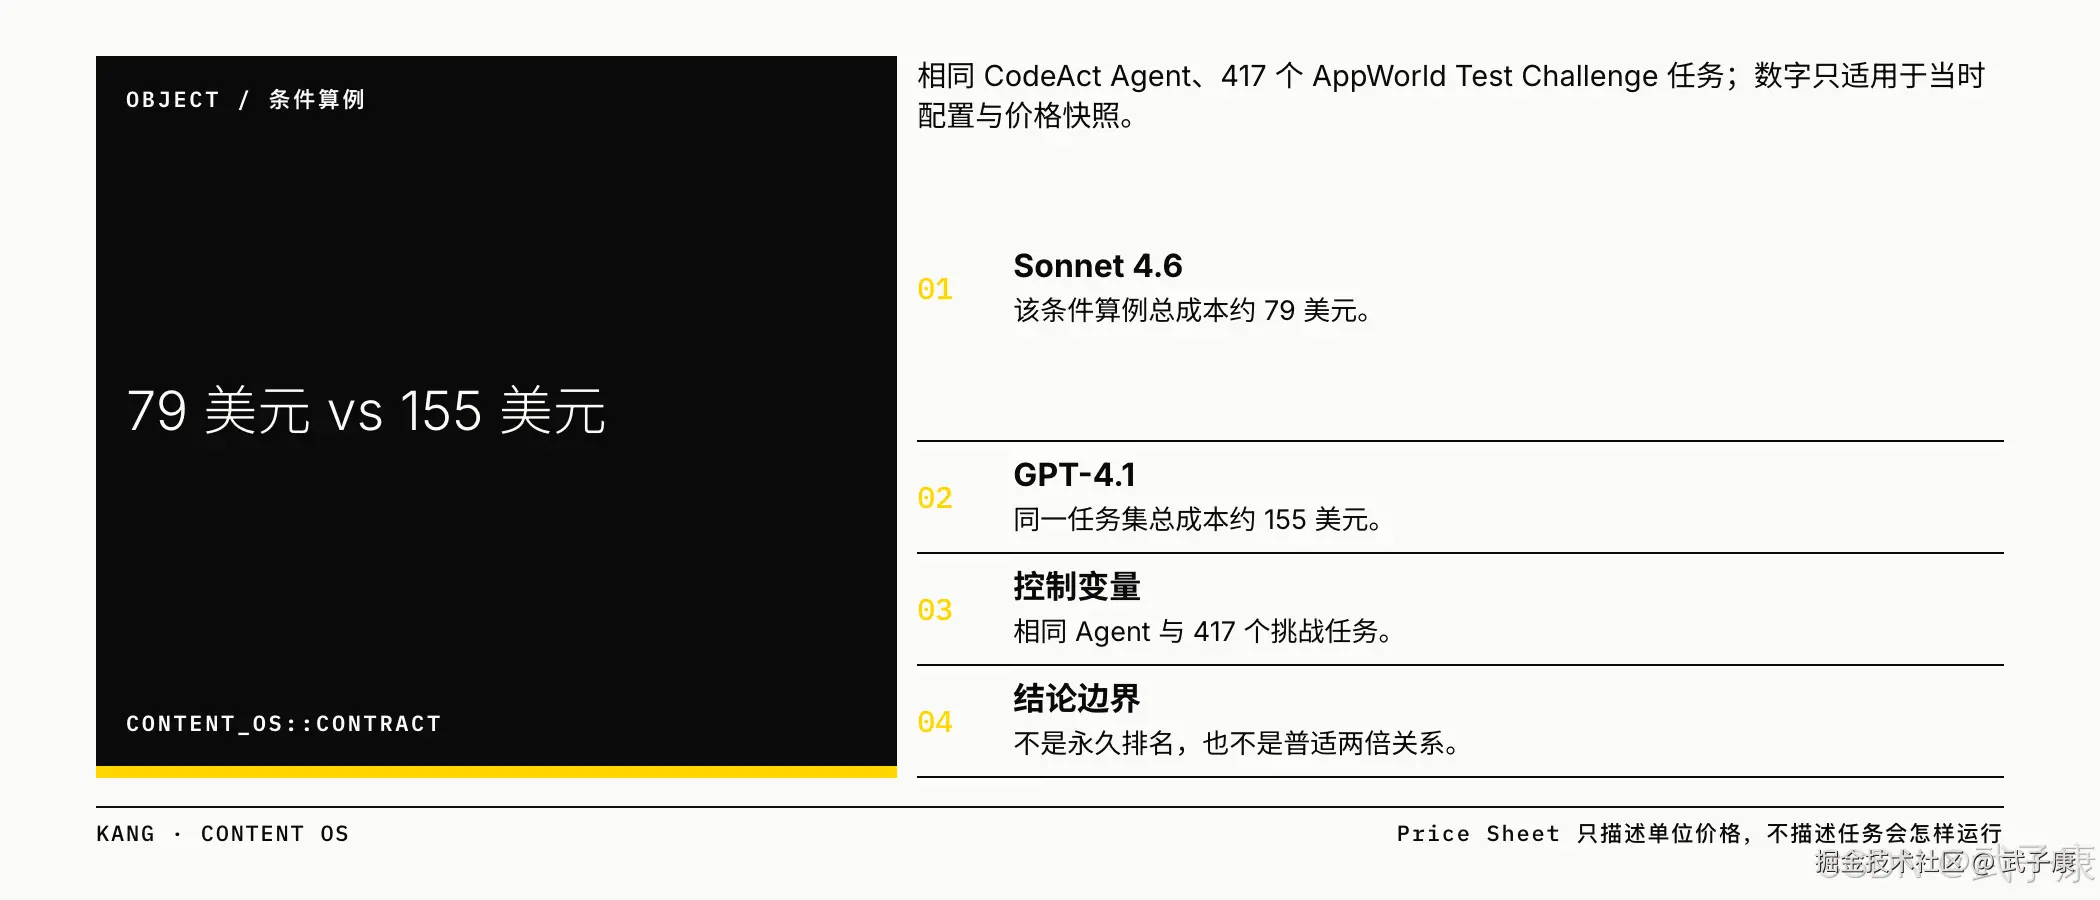
多步 Agent 的成本单位不是一次 ModelCall,而是一条走到业务结果的完整任务轨迹。价格表没有错,错的是把价格表当成了最终成本答案。对一次性、短上下文、无工具的调用,单价比较仍可作为粗略估算;但一旦 Agent 具备规划和工具调用能力,这个简化就不再成立。
成功任务成本:把分母从「调用」换成「结果」
30% 成功率意味着什么
把 Token 消耗当作财务指标的第一步,是承认一个尴尬的事实:大部分 Agent 尝试并没有产生可验收的结果。卡内基梅隆大学研究者的 TheAgentCompany 基准测试中,最具竞争力的 Agent 在模拟软件公司环境里自主完成的任务比例是 30%。这个数字本身不是判决,但它改变了成本的计算方式。
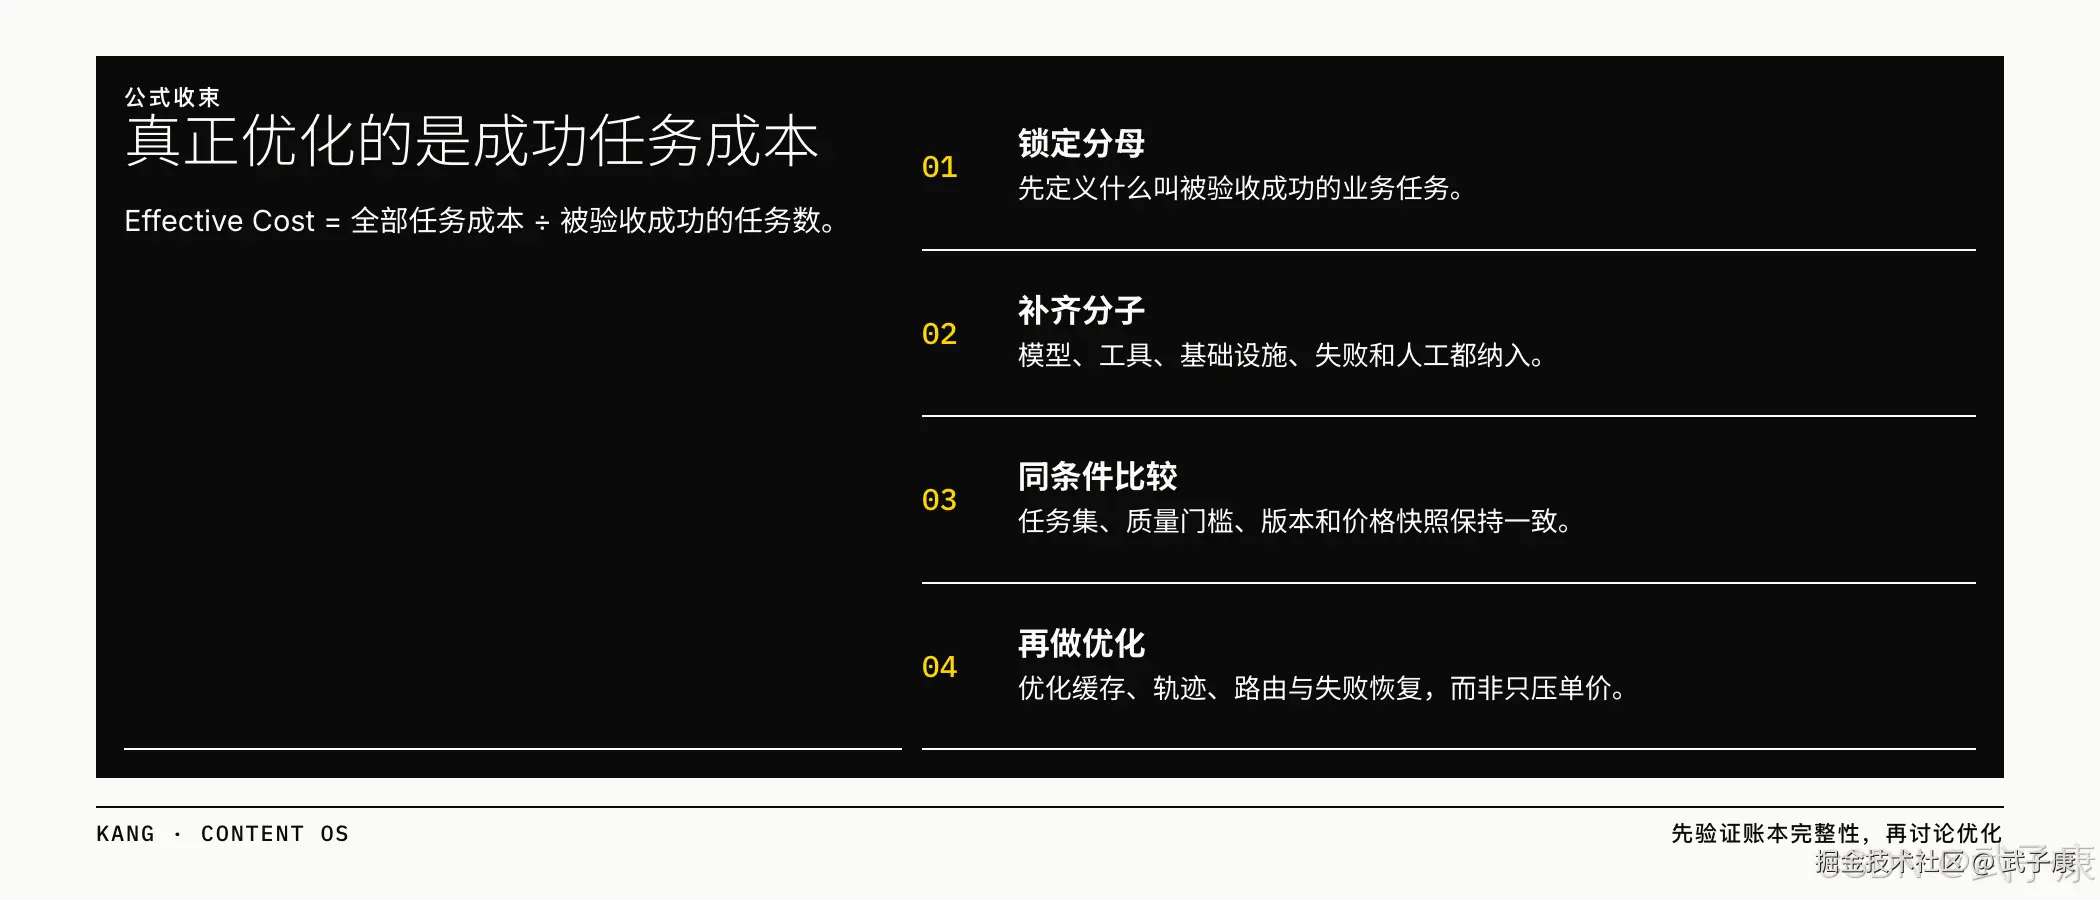
当成功率只有 30%,每次尝试消耗的 Token、工具调用和推理时间并不会因为任务失败而消失。它们被成功的任务吸收。GAI Insights 给出的推算很直接:一个每次尝试成本 1 美元的 Agent,在 30% 成功率下,每完成一个单位的成本是 3.33 美元,而且这还没有计入返工。失败不是免费的。
企业如果只监控 Token 消耗总量或单次调用成本,看到的是一张被失败尝试稀释过的账单。真正有信息价值的数字藏在分母里:不是消耗了多少 Token,而是这些 Token 换来了多少个通过验收的任务。成功任务成本的计算公式因此变得关键——统计周期内智能服务总成本除以同一周期内通过业务验收的成功任务数。这个比率把 Token 消耗从输入属性转译成了结果属性。
低 Token 消耗可能更贵的反直觉逻辑
只比较 Token 消耗量,会得出与真实经济价值相反的结论。一个 Agent 可能只消耗少量 Token,却需要员工反复核验和修正;另一个 Agent 可能调用多个模型和工具,但能独立完成复杂任务,减少人工处理和业务等待。前者的 Token 账单更低,后者的业务成本更低。
GAI Insights 构建的发票处理 Agent 案例把这个反直觉逻辑量化了。每次尝试的推理、检索、编排和工具成本为 0.80 美元,人工审核每次增加 1.20 美元。在 40% 完成率下,每张完成发票的成本是(0.80 + 1.20)÷ 0.40 = 5.00 美元。如果每张发票的增量价值为 3.50 美元,这个 Agent 每完成一个单位亏损 1.50 美元——它在自动化工作的同时消耗利润。
低 Token 消耗的 Agent 之所以可能更贵,是因为人工核验、返工和等待时间没有被计入模型调用账单。这些成本真实存在,只是不在 Token 价格表上。只有当人工介入成本被纳入分母所对应的总成本时,Token 消耗的比较才具备财务意义。
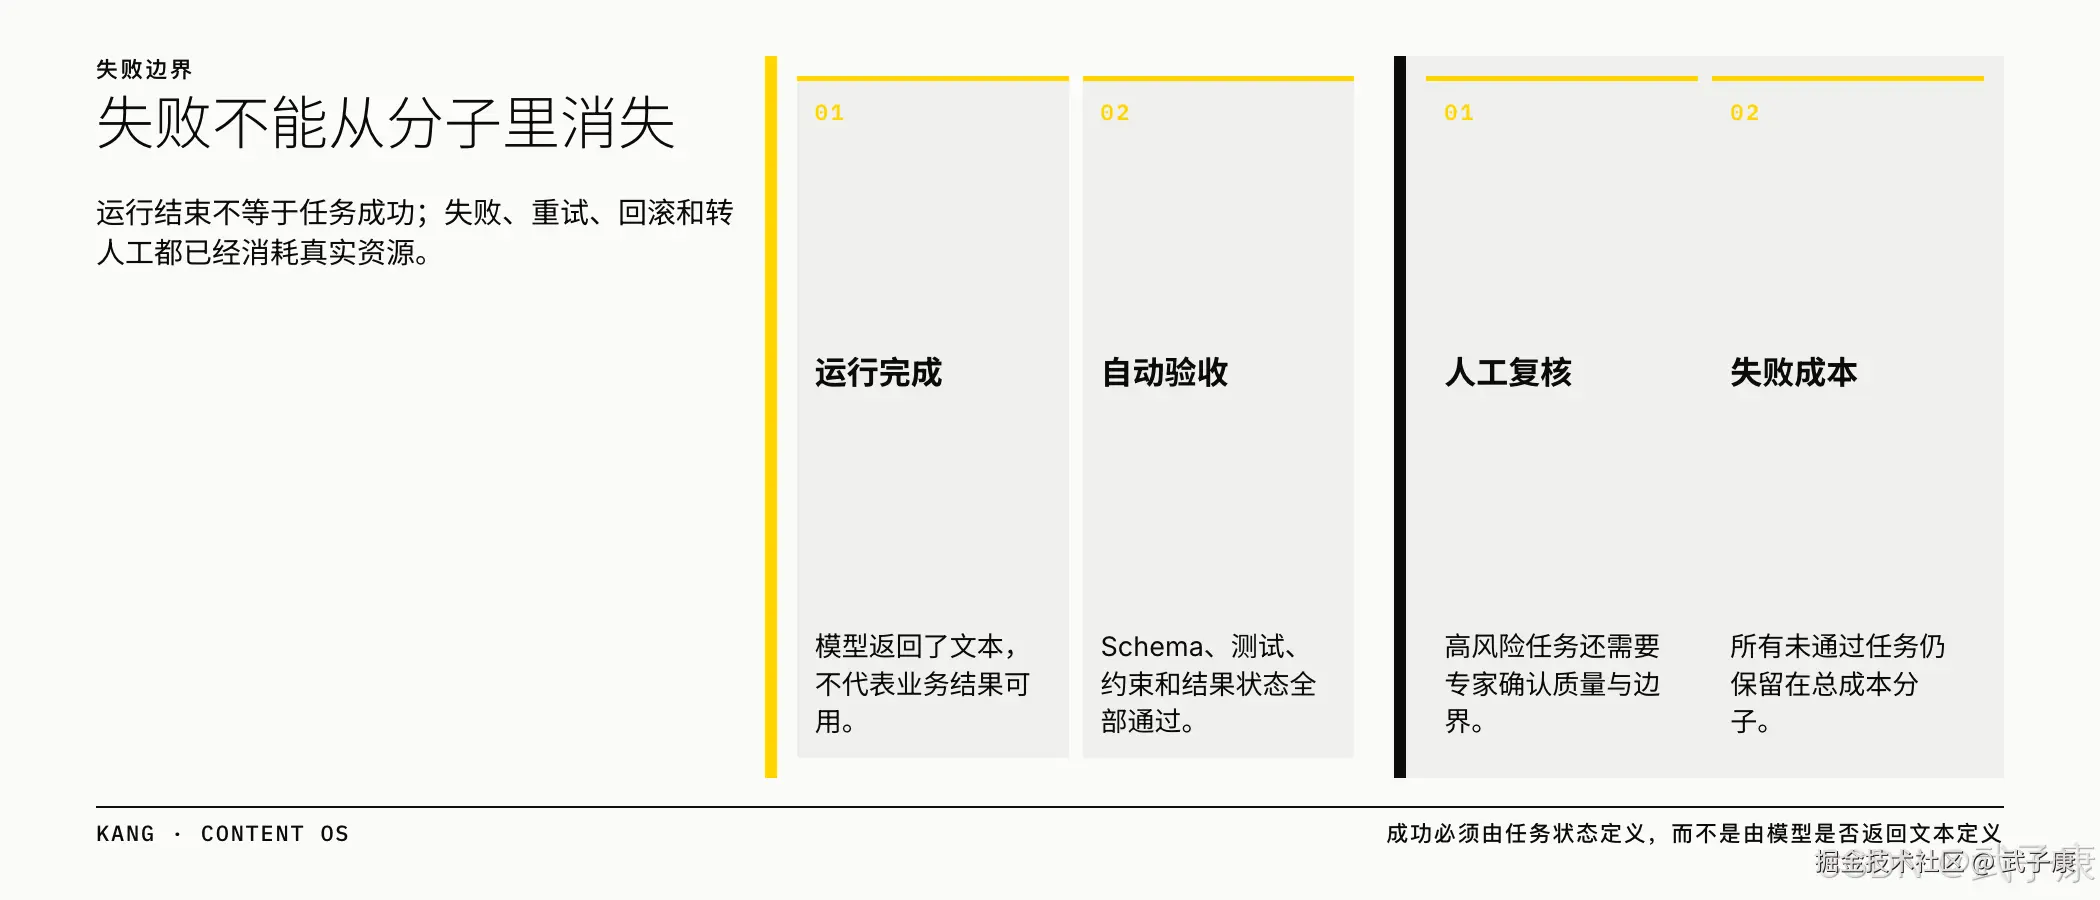
这个指标也有边界。成功任务成本依赖明确的任务验收标准。Agent 输出“已完成”不等于任务成功,模型调用返回 200 也不等于业务结果正确。如果“成功”的定义模糊,或者任务状态无法被可靠判断,这个比率本身就会失真。同样,人工介入率高不一定代表模型差,可能反映业务风险高或审批制度严格。这时候,成功任务成本还能用,但得把验收规则和人工介入的原因一起算进去。
单位经济学:CFO 要的不是账单,是商业案例
三个比率:毛利率、Token 收入比、自愈资本
CFO 看到的 AI 账单,大多数情况下只是一份成本报告。企业追踪 Token 消耗、席位数、API 调用次数,是因为供应商把这些数字放在仪表盘最前面。但这些指标没有一个能回答最核心的问题:这个 Agent 是否在赚钱。GAI Insights 对 2026 年企业 Agentic AI 采用现状的判断很直接——CFO 拿到的账单不是商业案例。要完成从成本报告到商业案例的转换,需要把聚合 Token 账单拆解到任务层面,按每一次完整执行来归因成本和收益。
按任务归因之后,有三个比率值得放进财务评估框架。第一个是任务毛利率:每次成功执行所替代的人工劳动净价值,减去直接模型成本和基础设施成本。第二个是 Token 消耗与收入比:支撑一个活跃付费客户或合同里程碑所需的总推理支出。第三个是自愈资本增量:自动化重试和恢复循环的成本,与人工异常处理成本之间的差额。这三个比率都指向同一个问题——Token 花出去之后,换回来的是不是比省下的人工成本更多。
聚合账单把高价值任务和低价值任务的成本混在一起,掩盖了交叉补贴。一个客户争议解决工作流,每次运行成本 18 美分,当它替代 4 美元的人工审核时,产生正利润。另一个分类任务在未优化的前沿模型上每次运行成本 32 美分,而缓存的小语言模型以相同精度完成同样任务只需 0.04 美分。前者的成本绝对值更高,却是有利可图的;后者的成本看似很低,却在摧毁利润空间。差别不在 Token 单价,而在任务被替代的人工价值与模型选择是否匹配。
预算护栏与模型降级的财务逻辑
单位经济归因也改变了成本控制的落点。聚合账单只能触发整体性的“少用一点”指令,任务级预算则可以设置程序化护栏。一种做法是在三个层面同时设限:单次提示的 Token 上限、单次运行的美元限额、滚动租户配额。当任务达到预算上限的 80% 时,系统自动降级到高效蒸馏模型,或触发异步人工审批。这个机制的价值在于把成本控制从事后对账变成执行过程中的约束。
模型降级有一个可操作的触发条件:当任务在历史验证数据集上的可测准确率超过 98% 时,使用蒸馏模型可以将每次执行成本降低最多 85%,而不降低客户满意度。这个阈值来自作者的建议,不是行业共识。具体到不同业务,98% 的准确率门槛是否适用、85% 的成本降幅能否实现,都需要企业用自己的验证数据确认。
这些比率和护栏策略的边界同样需要说明。三个比率是框架性指标,目前没有行业标准或经过广泛验证的基准数据。预算护栏的层级设计和 80% 降级触发点也是作者提出的系统设计建议,而非已被普遍采纳的实践。企业在采用这些指标时,需要把它们当作内部核算的起点,而不是可以直接对标的行业参数。
从会计基准到工作流实践:降本 50% 的成立条件
APEX-Accounting 揭示的预算敏感性与推理瓶颈
APEX-Accounting 基准包含 160 个任务,覆盖 10 家模拟公司,用于测试 AI 代理能否按专业标准完成真实会计工作。这个基准最有价值的地方不在排行榜本身,而在它把预算约束直接嵌入了测试设计。
在每任务 1、5、10、50 美元的预算上限下,模型表现排序发生了显著变化。Claude Fable 5 在 1 美元预算下仅通过 11.8% 的专家评分标准,到 50 美元时跃升至 56.4%,差距超过 44 个百分点。Meta 的 Muse Spark 1.1 则呈相反模式:低预算下已经表现不错,预算增加后提升有限。在 50 美元上限下,Fable 5 每次运行约花费 32 美元,Muse Spark 1.1 约花费 5 美元,两者得分差距却不超过 4 个百分点。
这个对比说明,Token 财务化不是简单地在模型之间比单价。预算约束本身会改变哪个模型才是最优选择。一个在充足预算下领先的模型,在严格预算下可能完全不具竞争力。企业如果只按排行榜选模型,而不按自己的预算上限重新测试,很可能为一个边际质量提升支付数倍成本。
APEX-Accounting 还提供了失败模式的分类。排名前三的模型中,约七成失败属于推理失败,而非信息获取失败。模型可能在流程早期正确识别出差异,却在最终日记账分录中遗漏或推翻这一发现。这意味着,仅靠改进检索或增加上下文,无法解决大部分错误。财务指标在这里的作用是定位问题:如果失败主要发生在推理环节,那么追加 Token 预算的边际收益可能很低,优化方向应转向模型能力本身或任务分解方式。
拆分多 Agent 不直接省钱,但打开优化空间
Harness 工作流的成本优化实践提供了一个生产环境视角。作者团队围绕减少无关上下文、减少重复上下文的原则,改造了架构拆分、稳定前缀、代码图谱、工具调用并行化等 10 个方向,整体全流程预估降本 50% 到 65%。其中一项可量化的改造是:将 MCP 数据获取子 Agent 化后,同一工作流单轮会话的 input token 从 1,030,000 降到 634,905,降幅 38.4%。
这里有一个容易被误读的结论。拆分多 Agent 本身并不直接省钱。作者的判断很明确:6 个 Agent 并行运行,等于同时有 6 份系统提示词在计费。真正的收益来自两个机制:短生命周期子 Agent 跑完即销毁,把原本持续累积的历史上下文切段;以及拆分之后才可能实施的后续优化——稳定前缀、工具裁剪、模型分层、子 Agent 化都建立在“已经拆分”的前提下。
把拆分多 Agent 当作降本手段来宣传是一种账面游戏。拆分的价值在于打开优化空间,而不是优化本身。如果一个团队只做拆分,不跟进前缀稳定和工具裁剪,Token 消耗甚至可能上升。
两项证据的边界需要同时说明。APEX-Accounting 是模拟环境,160 个任务和 10 家模拟公司无法完全复现生产环境的复杂性和长尾场景。Pass@8 最高仅 21.5%,58% 的任务没有任何模型在任何一次运行中完全解决,这些数字提示当前 Agent 在会计任务上的绝对能力仍然有限,基准结论更适合用于相对比较而非绝对能力判断。Harness 案例的 50% 到 65% 是预估区间而非实测精确值,且来自单一团队的特定工作流,不能外推为所有 Agent 工作流都能实现的降本幅度。
Token 财务化的实际收益取决于三个条件:预算约束下重新测试模型选择,而非依赖无预算限制的排行榜;用失败模式诊断确定优化方向,而非盲目追加上下文;把架构改造理解为打开后续优化空间的前提,而非降本动作本身。三个条件同时满足时,50% 量级的降本才是可预期的工程结果,而不是营销数字。