VLM“开卷”提分指南:CARPRT不训练如何精准划重点
VLM“开卷”提分指南:CARPRT不训练如何精准划重点
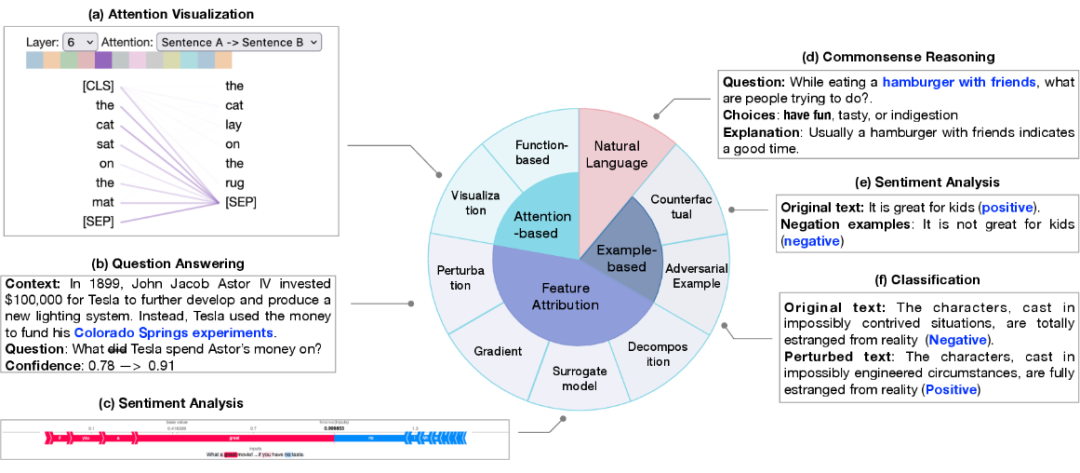
最近有个挺扎心的实验:你给VLM看一张哈士奇的照片,问它“这是狼还是狗”,模型犹豫半天选了个“狼”。你不服,把提示词改成“这是一只被驯化的、会摇尾巴的犬科动物”,结果它斩钉截铁地告诉你——这是狐狸。
这不是个段子,而是零样本分类的真实困局。
问题的根源,藏在提示词的设计逻辑里。标准的零样本分类,通常会给每个类别写一段“通用描述”,比如“这是一张狼的照片”“这是一张狗的照片”。模型拿到这些描述后,去匹配图像特征,算出每个类别的匹配分数。
但这个流程有个致命缺陷:它假设一段描述对某个类别的所有样本都同等有效。
现实是,狼的图片千差万别——雪地里的白狼、森林里的灰狼、奔跑中的黑狼,它们对“狼”这个通用描述的匹配程度完全不同。用同一把尺子量所有样本,本质上是一种“平均主义”暴力。
更微妙的问题在于,某些类别之间的差异极其精细。比如区分“狼”和“哈士奇”,关键特征可能只是眼睛的弧度或脸型的宽窄。一个笼统的“狼”的描述,很难精准捕捉到这种边界——它既可能漏掉真正的狼,也可能误把哈士奇拉进来。
通用提示词的“平均主义”,让模型在类别边界上变成了近视眼。
如果说“平均主义”是精度不够,那噪声问题就是方向跑偏。
零样本分类通常会给每个类别准备多套提示词模板,比如“一张{类别}的照片”“{类别}的特写镜头”“这是一只{类别}”。理想情况下,这些模板应该互相补充,提供多角度的匹配信号。
但实际情况往往是:某些模板不仅没帮忙,还在添乱。
比如“一张{类别}的照片”这个模板,对大多数类别都适用,但它几乎不包含任何区分性信息。当模型同时参考这个模板和另一个更有区分度的模板时,前者就像一个在考场上大声背课文的人——它说的没错,但干扰了你思考真正关键的线索。
更糟的是,某些描述可能直接和图像内容产生语义冲突。如果一张狼的图片背景是雪地,而某个提示词模板恰好是“一只在森林里的狼”,这个不匹配的信号就会把模型的注意力从狼本身拽向背景环境。
低质量提示词不是中性的,它在主动稀释有效信号。
这两重困境叠加的结果是:模型手握大量提示词,却像在一个嘈杂的房间里听人耳语——该听清的关键信息被淹没,不该听的噪声却放大了。这就是为什么VLM的零样本分类,明明有强大的视觉理解能力,却常常表现得像在“盲猜”。
二、破局:CARPRT的“划重点”机制如何实现精准提分?
传统方法将所有提示词一视同仁,就像让全班学生用同一份笔记复习——有人适用,有人完全看不懂。CARPRT的思路直击要害:既然模型是黑箱,那就别动内部参数,去动输入端的信息权重。
核心设计:一种无需训练的“类别感知”动态权重分配策略
CARPRT的核心突破,在于为每个类别定制专属的提示词权重方案。
这不是全局调整某个提示词的好坏,而是认识到一个关键事实:描述对“哈士奇”是金标准,对“柯基”可能只是噪音。这种**“类别感知”的粒度**,让权重分配从一刀切变成了精准滴灌。
从概率建模角度看,CARPRT将分类问题转化为在提示词空间中对类别概率的重新加权。具体而言,它通过计算每个提示词对特定类别的适配度,动态生成权重向量——高适配度提示词获得更大话语权,低适配度则被边缘化。
整个过程完全在模型外部完成,不触碰VLM任何内部参数。模型本身不变,但输入的“小抄”质量被大幅提升,真正实现了“开卷考试”式的优化。
关键动作:在概率空间中放大高适配提示词并抑制低适配噪声
这一策略的本质,是在概率空间中进行信噪分离。
当模型接收多个提示词时,每个提示词都会产生一个类别概率分布。CARPRT的权重机制在这些分布上进行加权投票:对于某个类别,如果某提示词能稳定给出高置信度,CARPRT会放大其贡献;反之,那些输出混乱、置信度低的提示词,其影响力被系统性压制。
核心洞察:零样本分类的瓶颈往往不是模型能力不足,而是信息权重分配失当。高质量信号被大量平庸噪声稀释了。
这种操作的巧妙之处在于:它不改变模型对任何单一提示词的理解,只改变最终决策时各提示词的声量大小。就像在嘈杂的会议室里,不是换掉参会者,而是给真正懂行的人递上麦克风,同时关掉那些只会制造噪音的发言通道。
这意味着,即使初始提示词集合质量参差不齐,CARPRT也能自动完成动态筛选——让适配的说话,让不适配的闭嘴。
三、审视:零训练成本提分是“银弹”还是脆弱的“取巧”?
CARPRT的“零训练”标签极具吸引力,但任何技术都有其适用边界。在为其提分效果喝彩之前,有必要冷静审视:这种完全不触及模型参数的黑箱优化,究竟是普惠的突破,还是仅在特定条件下的精巧“取巧”?
价值验证:在多个基准上分类精度显著跃升且零额外开销
CARPRT的实用价值首先体现在极致的轻量化部署。
在多个细粒度分类基准测试中,该方法展现出了无需微调、零额外训练成本即可显著超越标准提示词方案的性能。对于计算资源敏感的场景,这意味着使用者无需准备昂贵的GPU集群,也无需担心灾难性遗忘问题,仅通过后处理阶段的权重重分配,就能从现有VLM中“榨取”出更高性能。
这种“开卷考试”式的优化,本质上是让模型在推理时更聪明地“审题”,而非重新“学习知识”。
从工程角度看,CARPRT提供了一种即插即用的提分方案。它不改变模型结构,不增加推理延迟,仅通过算法层面的动态调整,便实现了分类精度的跃升。这种低侵入性,使其能快速集成到现有视觉AI流水线中,尤其适合那些模型已固化、无法重新训练的落地场景。
边界批判:对初始提示词质量的强依赖与泛化能力的潜在天花板
然而,CARPRT的“零训练”优势,恰恰暴露了其最核心的脆弱性:对初始提示词池的高度依赖。
该方法的本质是在一个给定的提示词集合内进行权重重分配,而非创造新的知识。这意味着,如果初始提示词池本身就存在严重偏差或关键描述缺失,CARPRT的“划重点”机制将巧妇难为无米之炊。它只能放大已有的最佳信号,却无法修正根本性的语义错误。
这引出了一个更深层的批判:CARPRT的提升是否只是“矮子里拔将军”?
当面对开放世界中的长尾类别或高度抽象的视觉概念时,人工设计的提示词池很可能覆盖不全。此时,CARPRT的类别感知权重分配反而可能放大有限描述中的偏差,导致模型在那些真正考验泛化能力的场景中碰到性能天花板。其提升效果,可能局限于那些提示词设计已相对成熟、仅需微调的基准数据集上。
因此,CARPRT并非万能“银弹”,而是一把需要审慎使用的精密工具。它的真正价值,在于为黑箱VLM提供了一种低成本的性能压榨手段,但使用者必须清醒认识到,提示词工程的前期质量,已为这种优化的上限划定了隐形边界。