DeepSeek V4发布:万亿参数原生多模态,开源王座易主
DeepSeek V4发布:万亿参数原生多模态,开源王座易主
去年此时,整个AI圈都在问同一个问题:DeepSeek V4到底什么时候来?从春节等到清明,从清明盼到五一,硬生生把一众竞品逼成了“抢跑型选手”。而当它终于现身,外界才明白这种“拖延”并非技术卡壳,而是架构级重构的必然代价。
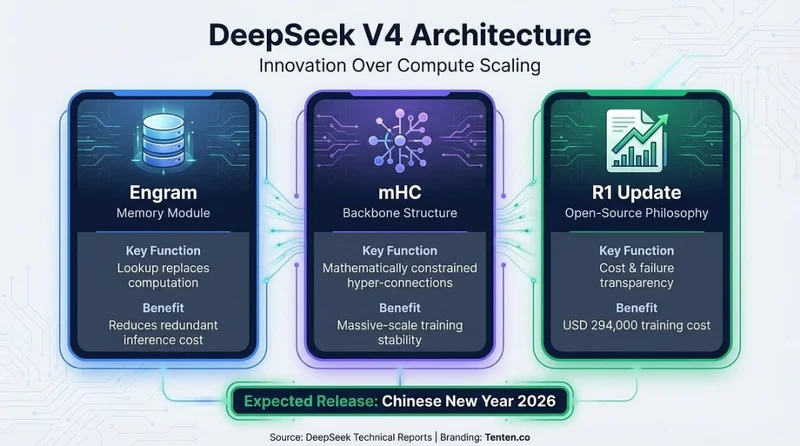
传统大模型有个致命缺陷:每次推理都要把所有参数塞进昂贵的GPU显存,就像每次出门都要把整个家当背在身上。参数越大,负担越重,成本越高。DeepSeek V4用Engram架构打破了这条铁律。

Engram的核心思路很朴素——把“死记硬背”和“临场发挥”分开。静态知识被存储在外部索引表中,可以放在成本更低的CPU内存甚至固态硬盘上;只有需要动态推理的部分才调用GPU算力。这相当于给模型装了一个“外挂硬盘”,随用随取,不用时绝不占用显存。
效果有多明显?实验数据显示,Engram能精准识别固化语言模式,在100万token超长上下文中实现恒定时间检索,信息召回率达到97%,而上一代V3在128K上下文时召回率仅45%。这意味着处理整本财报、整个代码仓库时,V4不会像前辈那样“读到后面忘了前面”。配合mHC流形约束超连接技术,万亿参数模型的训练效率提升了约30%,推理吞吐量在DualPath系统加持下有望翻倍。一句话:V4用“记忆外包”的方式,把万亿参数模型的运行成本打到了千亿级别的水平。
市面上的多模态模型大多是“后期拼接”——先训练一个文本大脑,再外挂一个视觉模块。这种方案的问题在于,文本理解和视觉感知是两张皮,遇到需要跨模态推理的任务就容易翻车。

DeepSeek V4走了另一条路:原生多模态融合架构,在预训练阶段就让图像、视频、文本深度统一。这带来的直观变化是空间推理能力的质变。泄露的测试中,V4 Lite仅用54行代码就生成了复杂的Xbox手柄SVG矢量图,在视觉还原度和空间构图上被认为超越了部分主流旗舰模型。
更值得关注的是,这个对比是在不公平条件下完成的:V4 Lite是非思考模式,而V3.2是开了深度思考的。一个没开“外挂”的轻量版,干翻了上一代旗舰的全力输出。这说明原生多模态不是简单的功能叠加,而是从底层改变了模型理解世界的方式——它不是在“看图说话”,而是在“用视觉思考”。结合百万级token的超长上下文和全新视觉压缩技术,V4在处理超长文档、视频内容分析等场景时,不再陷入“信息模糊”的困境。这不是一次普通的版本迭代,而是一次架构范式的切换。

二、市场收复战:错失窗口期后,V4的生态突围路径
V4的发布比行业预期晚了整整一个季度。这三个月里,Kimi、智谱、MiniMax完成了至少一轮迭代,Claude Code和Cursor已经深度嵌入开发者日常工作流。V4要打的,是一场从“被遗忘”到“被需要”的认知收复战。
2.1 代码与智能体:百万级上下文能否撼动现有开发者生态
过去一年,AI编程的标准由Claude Code和Cursor定义。DeepSeek在这个战场上,更多是被调用的一方,而非规则制定者。
V4试图用100万token上下文窗口打破僵局。这不是营销数字——传统模型处理大型代码库时,必须将项目切分成片段分别理解,跨文件的依赖关系往往在切割中丢失。百万级上下文意味着,整个代码仓库可以被一次性加载到模型的“工作记忆”中。
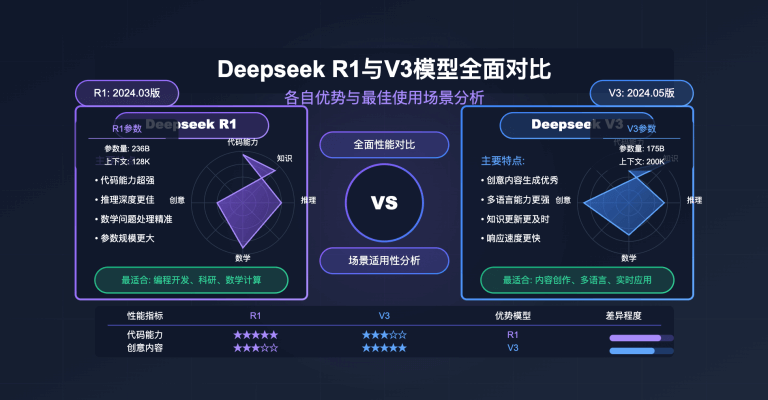
内部测试显示了一个残酷的对比:V4在100万token长度下的信息召回率达到97%,而V3在128K时的表现仅为45%。这直接关系到智能体的执行可靠性——当Agent需要同时理解三个微服务模块、两份配置文件和一个数据库Schema时,信息丢失就意味着任务失败。
V4的Engram条件记忆系统在这里扮演关键角色。它不是在上下文窗口内做模糊检索,而是维护了一个可精确寻址的知识索引表。
但生态建设不只是技术指标。Cursor和Claude Code的成功,靠的是与IDE的深度集成、工作流优化和社区运营。V4的代码能力再强,如果只停留在API调用层面,就很难撼动已经形成的工具惯性。DeepSeek需要尽快补上的是开发者体验这一环——插件、文档、社区支持,这些看似“非技术”的东西,恰恰是生态粘性的来源。
2.2 性能虚实:从基准跑分到真实落地的关键差距

V4的基准测试成绩足够亮眼:HumanEval达到98%,SWE-bench Verified超过80%,AIME 2025约85%。但有一个容易被忽略的细节——部分早期泄露的测试截图已被证实存在问题,数字本身不完全可靠。
这不是说V4不行,而是说基准测试正在失去参考价值。
行业里已经出现一种现象:模型在特定benchmark上“应试优化”越来越明显。就像学生刷题刷出了高分,遇到没见过的题型就露怯。真正的考验在于真实场景的鲁棒性——处理一个没见过框架的遗留代码库,理解一份充满内部缩写的技术文档,在信息不完整的情况下做出合理推断。
V3.2曾展示过“跨工具记忆保持”能力,在多次工具调用间维持推理链不丢失。这是比跑分更务实的进步。V4能否将这种能力扩展到更复杂的Agent任务中,才是决定其能否收复失地的关键。
另一个务实指标是成本。V4的MoE架构每次推理仅激活约370亿参数,输入价格每百万token仅0.14美元。在Agent场景下,单任务消耗的token量是传统对话的几十倍,成本优势本身就是一种竞争力。当开发者发现用V4跑完一个完整项目分析的费用还不到竞品的零头时,生态迁移的动力就自然产生了。
跑分赢得掌声,成本赢得用户,稳定性赢得忠诚。 V4的收复战,不会靠一个benchmark榜单打完。
三、战略深水区:国产算力适配是突围捷径还是增长枷锁
DeepSeek V4的发布,表面是模型性能的胜利,底层却是一场精心策划的硬件“换轨”。当全球AI竞赛仍围绕英伟达CUDA生态运转时,DeepSeek选择了一条最艰难的路——将V4的首次适配权独家交给华为昇腾等国产芯片厂商,英伟达和AMD反而被排除在早期名单之外。这一决策直接导致V4发布时间从原定的2月一再跳票,背后的代价比外界看到的更为沉重。
这不仅是技术选择,更是一次战略押注——用短期的时间窗口损失,换取长期的供应链自主权。
3.1 脱离CUDA的代价:优先适配昇腾如何导致发布跳票
从CUDA迁移到华为CANN架构,不是简单的代码翻译,而是底层逻辑的重构。DeepSeek工程师团队花费数月重写核心算子,解决内存分配、算子融合、通信优化等一系列适配难题。据路透社报道,这一过程远比预期复杂,是V4数次延期的直接原因。
这里的代价是多维度的。时间成本上,V4错失了年初至今的黄金窗口期,让Claude、Gemini等对手抢占了开发者心智;人才成本上,能同时精通CUDA和CANN的工程师凤毛麟角;性能成本上,迁移初期国产芯片上的推理效率远不如英伟达原生环境。
但代价换来的是战略筹码。如果V4能在国产芯片上跑出世界一流性能,它将成为全球首个不依赖英伟达的前沿AI模型。黄仁勋近期在采访中直言,这种局面“对美国来说将是一个糟糕的结果”——因为一旦AI模型被优化为在中国硬件上跑得最好,美国芯片的生态护城河就不再牢固。
更深层看,这一决策已触发连锁反应。DeepSeek在内蒙古乌兰察布首次公开招聘算力基础设施驻场人员,暗示其正从“租用算力”转向“自建国产算力集群”。从依赖到自建,从适配到优化,这条路径的终局是彻底摆脱对单一芯片生态的锁定。
3.2 开源生态转折:从模型权重开源到产业生态链构建

DeepSeek V4延续了Apache 2.0协议的开源策略,但这次的开源内涵已发生质变。过去一年,开源模型在OpenRouter平台的份额从个位数攀升至33%,中国开源力量一度占据前六中的五席。但DeepSeek错失了Agent、多模态等四波技术浪潮,其开源生态始终停留在“模型权重开放”层面,未能形成开发者社区和工具链生态。
V4正在试图扭转这一局面。百万级上下文窗口、原生多模态、超强代码能力——这些技术特性天然面向Agent开发、代码仓库级理解和长文档处理场景。如果V4能成为Agent开发者的首选基座,DeepSeek将从“模型提供商”升级为“生态构建者”。
但挑战同样严峻。六小虎已在海外市场建立先发优势,Anthropic的Claude Code正在吞噬开发者心智,OpenClaw等接管型智能体重新定义了应用OS的形态。开源生态的第三次转折,需要的不仅是更强的模型,更是开发者关系、工具链支持和产业协同能力的全面升级。
DeepSeek V4的开源,是起点而非终点。真正的考验在于:能否在国产算力的底盘上,跑出一个足以抗衡全球的AI开发生态。这个问题的答案,将决定开源AI的竞争格局是“技术为王”,还是“生态为王”。