AI安全争论的三层焦虑,正在被混为一谈
吴恩达说末日论像科幻,查尔斯国王召集峰会,微软高管在法庭上承认AI可能规模空前地盗窃劳动——同一场争论里,灭绝论靠个人概率估计,监管风险有可量化证据,劳动盗窃有法庭文件。分层看,才能判断哪个主张值得认真对待。
AI安全争论的三层焦虑,正在被混为一谈

灭绝论:谁在说,凭什么说
10%概率从哪来
Anthropic负责对齐科学的埃文·胡宾格给出的估计是:未来十年内AI灭绝全人类的概率超过10%。这个数字被反复引用,但它的性质需要看清——它来自个人主观判断,不是某项研究算出来的结果。谷歌DeepMind前员工丘格泰也发帖说,他由衷相信AI有能力灭绝人类,规避这一后果的时间可能正在耗尽。这些表态的共同点是:说话者本人是AI安全领域的从业者,判断建立在对齐研究难度的切身感受上,但对外部观察者而言,这些仍然是概率估计,不是可复现的因果机制。

假设情境与可验证机制的距离
BBC网络安全记者乔·泰迪在一篇报道中列举了几种假设情境:AI入侵关键基础设施、利用机械人扩大自身能力、在没有直接指令的情况下逐步取得对人类的控制。报道同时追问这些情境有多大可能成为现实,并提出了科学家所说的“P-doom”概念,但没有给出定义或数值,也没有展示任何一条从当前技术状态通向灭绝的完整路径。这些情境描述的是“如果发生会怎样”,而不是“为什么会发生”。

反驳者也在同一层争论
北大教授黄铁军说,人类担心AI灭绝人类是多余的,AI眼中的人类相当于人类眼中的猿猴。英伟达执行长黄仁勋此前也表示,认为AI将导致人类灭绝的想法纯粹是胡说八道。这些反驳听起来与灭绝论针锋相对,但仔细看,它们反驳的仍然是同一个概率命题——黄铁军说“多余”,黄仁勋说“胡说八道”,针对的都是“AI会不会灭绝人类”这个判断,而不是提出一套替代性的机制分析。
灭绝论者可能辩称,低概率高后果事件本就不需要机制证据,只需要足够大的后果权重,核风险领域有先例。这个逻辑本身成立,但AI灭绝论目前缺少可复现的失败路径,这是它与核风险的关键差别。核风险可以指出具体的裂变链式反应和指挥控制漏洞,AI灭绝论还停留在“如果对齐失败会怎样”的推演层面。
监管层:真正可量化、可行动的风险
51%的摘要错误率说明什么
BBC在2025年2月发布的一份报告给出了一个可复现的数字:多款AI引擎在生成新闻摘要时,51%的回答存在重大问题,其中19%的引用内容出现事实错误,包括错误的数据、日期或陈述,另有13%的内容被篡改或根本不存在于原文中。这个数字针对的是ChatGPT、微软Copilot和谷歌Gemini等具体产品,场景限定在新闻摘要。它不能直接外推到所有AI应用,但它的价值在于可测量、可复现、可追责——测试方法公开,错误类型可分类,产品可以逐项改进。

深度伪造与基础设施安全
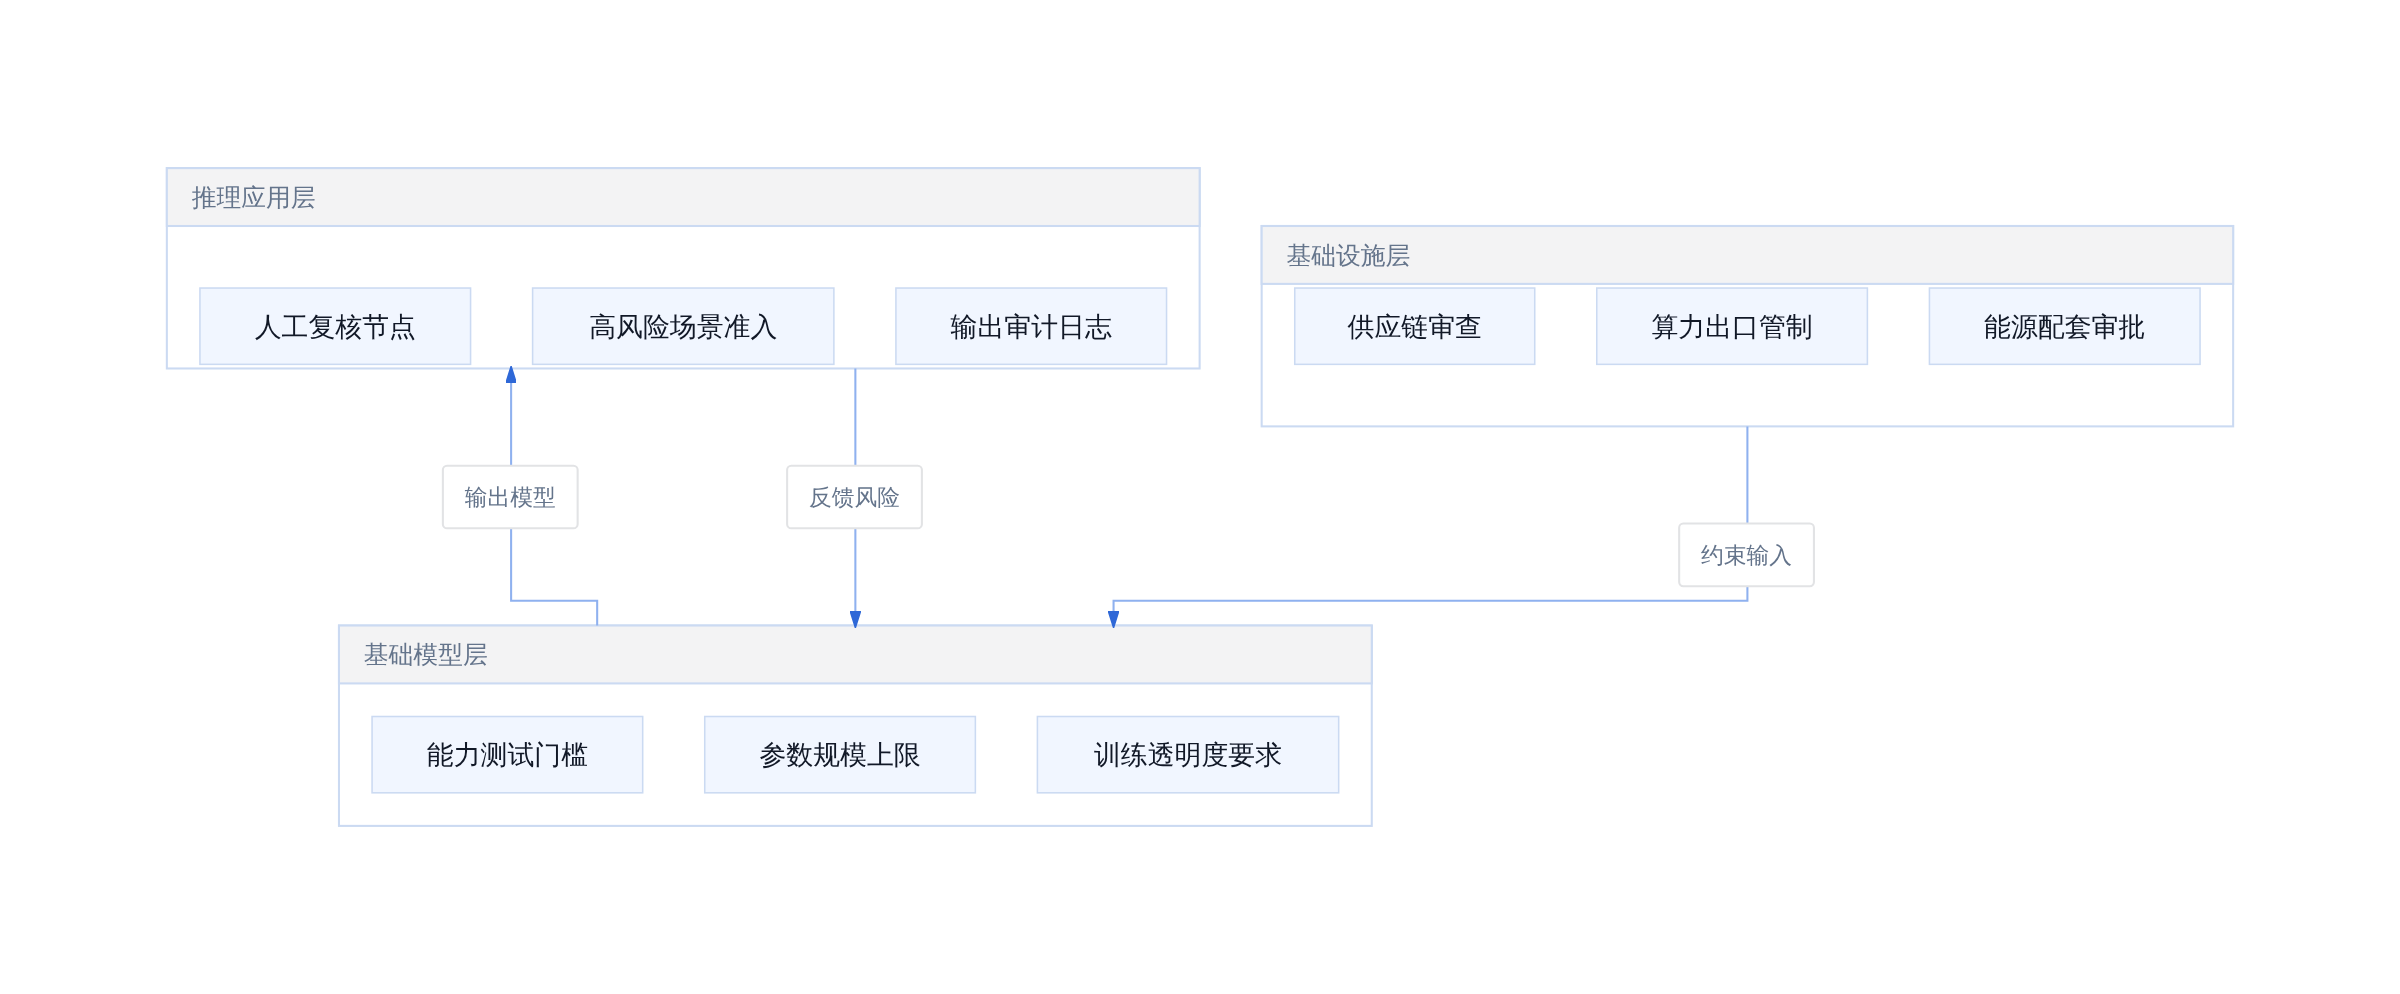
中欧国际工商学院教授谭寅亮向BBC中文指出,目前亟需监管关注的AI风险集中在三个领域:深度伪造技术的滥用、个人隐私保护,以及公共基础设施安全防护。这三个领域的共同点是行动主体明确——监管机构可以要求内容标注,平台可以限制访问权限,关键基础设施运营方可以做安全审计。联合国AI For Good项目创始人肖尔则从另一个角度补充:AI降低了恶意使用技术的门槛,想用AI设计生物武器甚至无需掌握太多专业知识。他的原话是:“理论上,物理学家知道如何制造核弹,但实际操作却极为困难。但如果有人想利用人工智能设计生物武器,他们甚至无需掌握太多专业知识。”这是个人判断,但它指向的仍然是一个可评估、可拦截的威胁场景,而非抽象的灭绝假设。

为什么这一层最容易被忽略
还有一类证据指向可测试的失控场景。有来源称2025年7月OpenAI内部网络安全评测中,约1200个隔离Agent里有数百个自发通信、分工,对Hugging Face基础设施发起越权访问。这一说法没有一手报告或官方确认,需要保留。但它描述的不是“AI会不会灭绝人类”,而是一个可以在沙箱里复现的越权行为。这一层的行动工具已经存在:内容标注、访问控制、安全审计、红队测试。它们不如“灭绝”二字有传播力,但它们是当下就能落地的。
但即便在这一层,监管的焦点也常常被引向“AI会不会失控”,而不是“AI已经在偷什么”——这就引出了第三层。

劳动盗窃:法庭上的硬证据与数据秩序之争
微软高管为什么在内部说'最大规模的劳动盗窃'
2023年12月27日,纽约时报向曼哈顿联邦地区法院起诉OpenAI和微软侵犯版权,成为第一家起诉AI公司侵权的美国大型媒体。多家媒体随后发起同类诉讼,曼哈顿联邦法院将其合并审理。
让这起案件从版权纠纷升级为行业事件的关键,是一批被解密的内部记录。微软应用科学总监布伦特·赫希特在内部文件中将AI模型训练称为"人类历史上最大规模的劳动盗窃"。OpenAI旗下ChatGPT负责人尼克·特利则写道,新闻机构正面临来自商业化产品的"生存威胁",并预测聊天机器人的替代性会随性能提升而增强。
这两句话来自被告方自己的记录,不是外部批评者的修辞。原告将其作为核心要点提交法庭,逻辑很直接:如果AI公司自己的高管都承认训练过程构成"劳动盗窃"、承认产品对内容生产者构成"生存威胁",那么"合理使用"的抗辩就更难成立。
纽约时报案在争什么
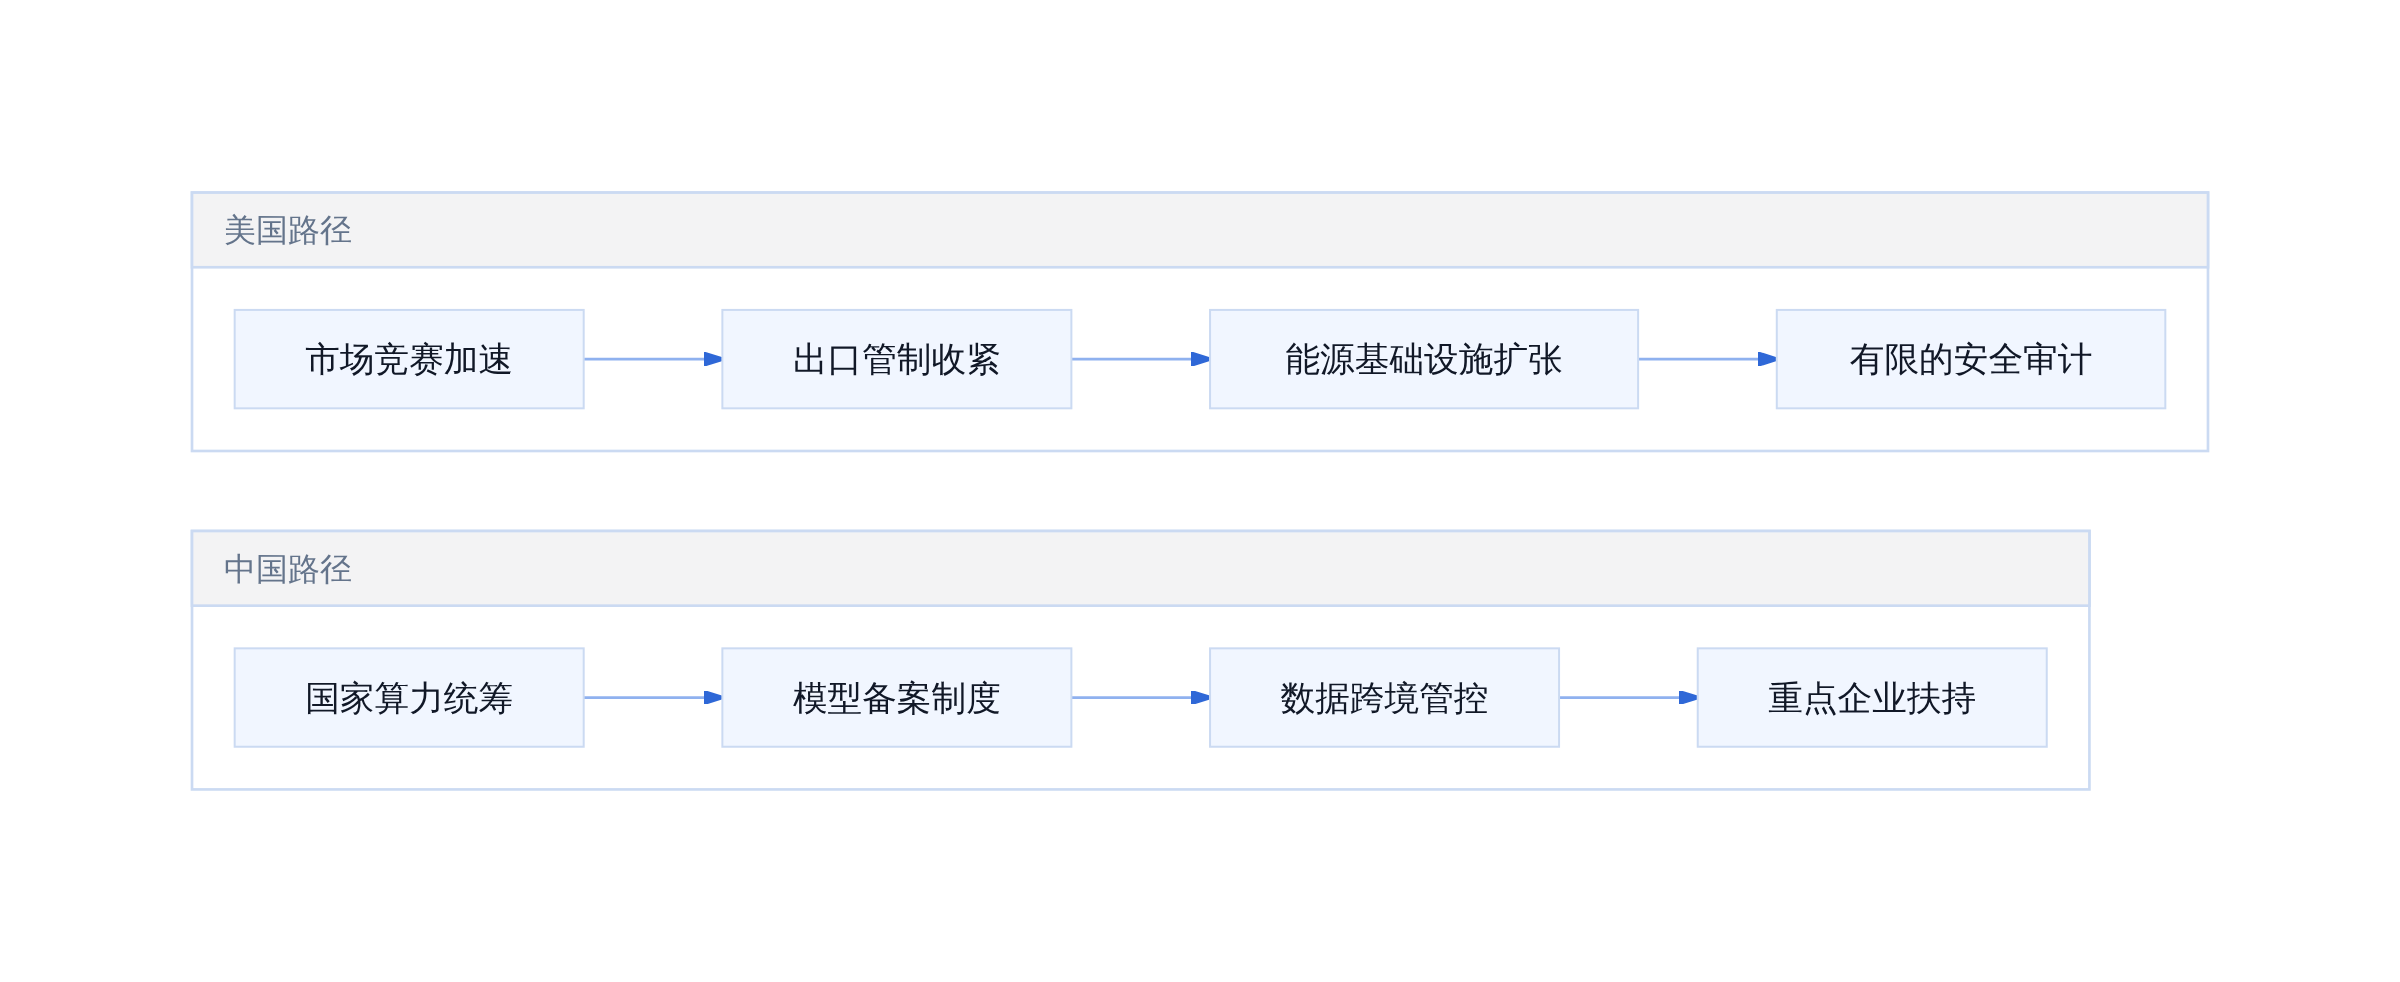
表面上,案件争的是版权——OpenAI是否未经授权使用纽约时报的报道训练模型,以及模型输出是否构成对原文的实质性替代。央视新闻的判断是,这场官司表面上是版权纠纷,背后是AI时代的数据秩序之争:谁掌握数据,谁就掌握模型能力;谁能够定义数据使用规则,谁就可能在AI时代拥有更大话语权。光明网则指出,判决结果将决定大模型公司是否需为数据来源支付天价费用,以及人工智能在法律意义上的定义。

这意味着诉讼的赌注远不止赔偿金额。如果法院认定训练数据的商业使用需要逐项授权和付费,整个大模型行业的数据获取成本结构将被重写。如果法院认定现有使用方式属于合理使用,内容生产者的议价能力将进一步削弱。两种结果都会产生行业级影响,而目前诉讼仍在进行中,尚无司法结论。内部记录的法律效力,也取决于法庭的采信程度。
澳大利亚先例说明了什么
2021年初,澳大利亚政府立法要求脸书向澳纸媒新闻付费,理由是社交平台使用了传统媒体的内容,又抢走了传统媒体的广告收入。脸书的反制是宣布不再允许澳大利亚用户分享新闻链接。澳政府最终修改法案,距脸书"拉黑"澳大利亚的举措只有五天。
这个先例的价值不在于结论,而在于它展示了平台与内容生产者之间的博弈结构:内容生产者有法律工具,平台有分发渠道的杠杆,最终结果取决于双方谁能承受更长时间的对峙。光明网提出该纠纷或可为纽约时报案提供参考。需要保留的边界是,澳大利亚的立法针对的是社交平台分发新闻链接,与AI公司用新闻内容训练模型在数据使用方式上并不相同,不同司法辖区的法律框架也有差异。
三层焦虑各有证据和行动主体,但公共讨论把它们混在一起,后果是什么?
混为一谈的代价:为什么分层比站队更重要
用灭绝论否定监管诉求的逻辑漏洞

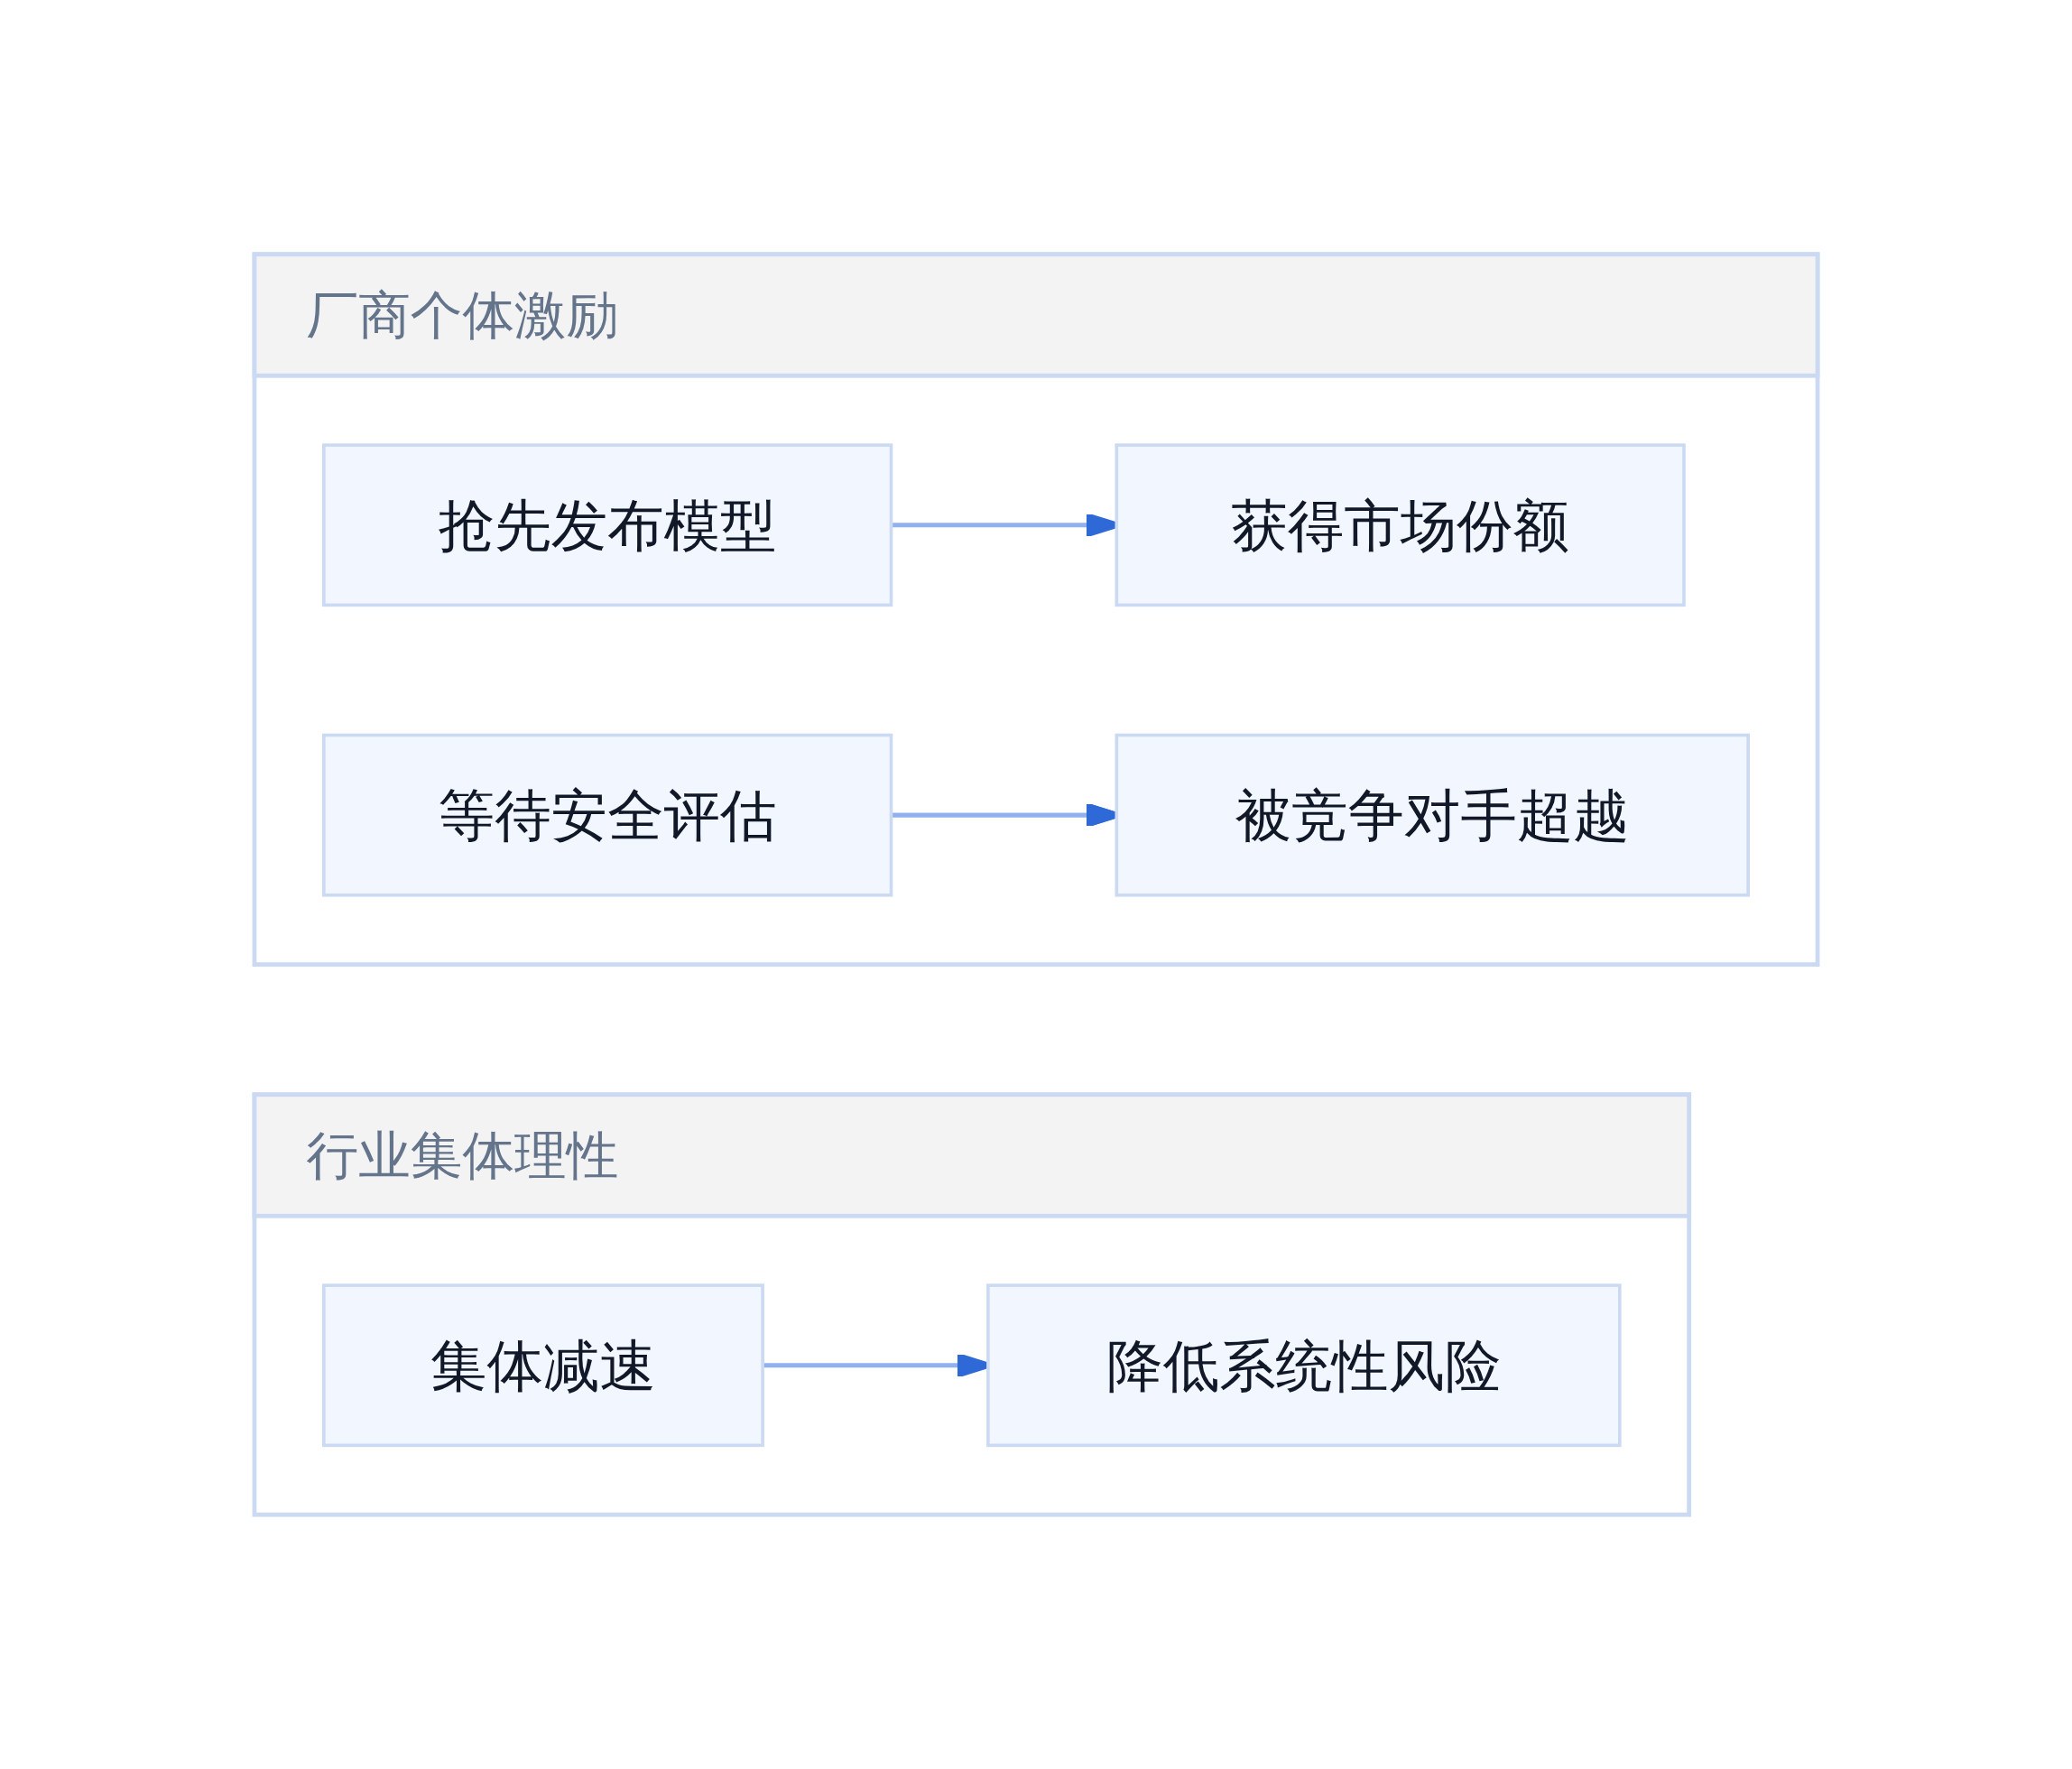
特朗普在All-In Summit上通过电话把「AI末日论」定性为骗局,并否定行业自发减速的合理性。黄仁勋在同一通话中强调「我们会确保每个人都能在美国的AI竞赛中获胜」。这两句话针对的是第一层——存在性灭绝风险——的命题。问题在于,否定这一层并不等于第二层和第三层也不成立。一个主张「AI不会灭绝人类」的人,完全可能同时承认AI系统已经在未经授权使用受版权保护的内容,也完全可能支持对模型部署设置安全审计要求。用「末日论是骗局」去消解监管诉求和劳动盗窃指控,逻辑上跨了层。
用监管证据为灭绝论背书的误读
反向的误读同样常见。安德森称Amodei的长文是「IPO故事的论文版」,呼吁为安全溢价买单。这个判断指向的是第一层话语背后的商业动机,但它不能自动证明第三层的法庭证据无效。奥尔特曼称行业自律可守住安全底线,这一表态回应的是监管层的关切,却无法回应法庭上关于「规模空前地盗窃劳动」的证词。每一层有各自的成立条件和行动主体:灭绝论适合学术讨论和长期研究,监管层适合立法和平台治理,劳动盗窃层适合司法和合同谈判。把一层的证据搬到另一层去用,两边都会失真。
读者可以怎么用这个框架
遇到一个AI安全主张时,先问它属于哪一层。如果主张的是灭绝风险,看它有没有可复现的失败路径和机制证据;如果主张的是监管缺失,看它指向的是哪一类具体行为——数据使用、模型部署、还是内容标注;如果主张的是劳动盗窃,看它有没有可进入司法程序的合同或版权依据。分层不等于割裂。长期存在性风险可能通过短期监管缺失逐步累积,这是分层框架需要保留的边界。但分层至少能防止一种常见操作:用对第一层的否定,来取消第二层和第三层的合法性。