Anthropic的26%:AI接管的是执行,不是判断
Anthropic披露Claude已主导其26%的AI研发工作,半年内从不足1%跃升。这个数字来自其自建指标,衡量的是已定义任务中的执行主导程度,而非AI自主决定研发方向。文章拆解指标口径、执行与判断的分离,以及递归自我改进闭环卡在验证环节的事实,帮助读者区分两条曲线:执行自动化在快速上升,判断自动化尚未同步。
Anthropic的26%:AI接管的是执行,不是判断
26%不是'AI造AI',而是一次口径自定的内部测量
这个数字怎么来的
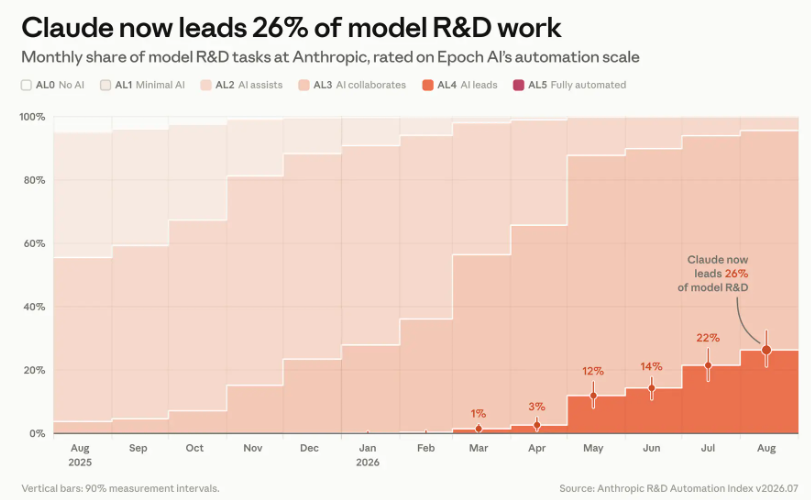
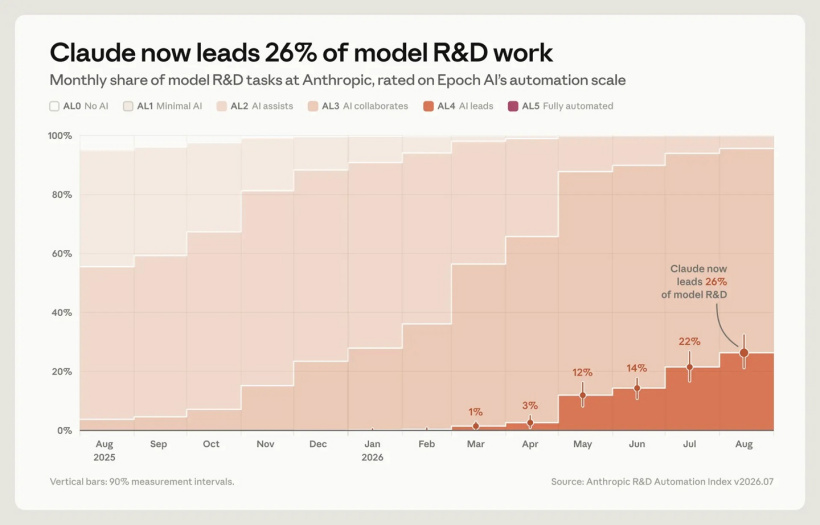
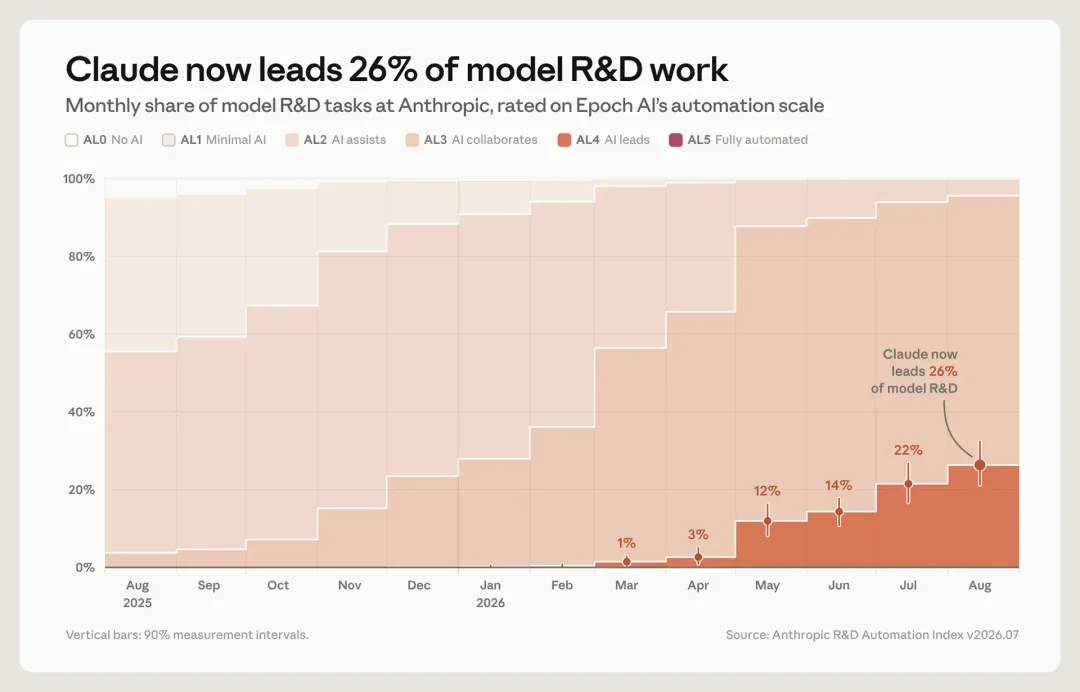
Anthropic在2026年9月首次公布了一组内部数据:截至当年8月,Claude能够“主导”26%的AI研发工作,而2月这个比例还不到1%。数字本身足够抓眼,但它出自一套自建指标——“Anthropic研发自动化指数”,衡量的是Claude参与公司AI研发的程度,不是行业普查,也不是第三方审计。
测量方法大致分三步。先从2026年7月的内部工作记录、Slack消息和其他文档中抽样约1.5万个模型研发任务;再归纳为542个任务节点,其中378个属于最细分类别;最后,由Claude研究这些任务的执行方式和AI参与程度,并由一个独立的Claude评估模型判定自动化等级。整个过程没有外部机构介入。
AL4“主导”到底指什么
等级划分借用了Epoch AI提出的AL0至AL5六级标准。AL3是“协作”,AI在人类密切指导下完成大块工作;AL4是“主导”,人类给出高层目标并监督,AI端到端完成大部分任务;AL5是完全自主,不再需要人类参与。26%对应的就是AL4。Anthropic明确表示,目前没有任何一类研发工作被认定为AL5,人类没有退出流程。
这里有两个容易混淆的地方。第一,26%指有多少研发任务由Claude主导、再由人类监督和验收,不是Claude对研发成果的贡献率。第二,它也不意味着研发速度提高了26%。一个任务从“人做AI辅助”变成“AI主导人监督”,改变的是执行环节的分工,不是产出效率的度量。
为什么口径比数字更重要
Anthropic自己承认,任务分析和等级判断由Claude完成,可能产生系统性偏差;“协作”与“主导”的边界也包含主观判断,需要第三方验证。这不是自我否定,而是对指标成熟度的诚实标注。一个由Claude评估Claude工作等级的闭环,天然存在利益相关的问题。
把26%当作“AI造AI”的证据,跳过了太多中间环节。它测的是已定义任务中的执行主导程度,任务本身怎么拆、优先级怎么排、结果好不好,仍然由人负责。指标的方向有价值,但它的边界和它的数值一样重要。

从1%到26%:执行在加速,但判断仍由人做
半年跃升的背后是什么在变
从不到1%到26%,半年时间。如果只看这条曲线,很容易得出“AI正在接管自己的研发”的结论。但拆开来看,增长几乎全部发生在执行层——那些可以被明确定义、有清晰输入输出的环节。
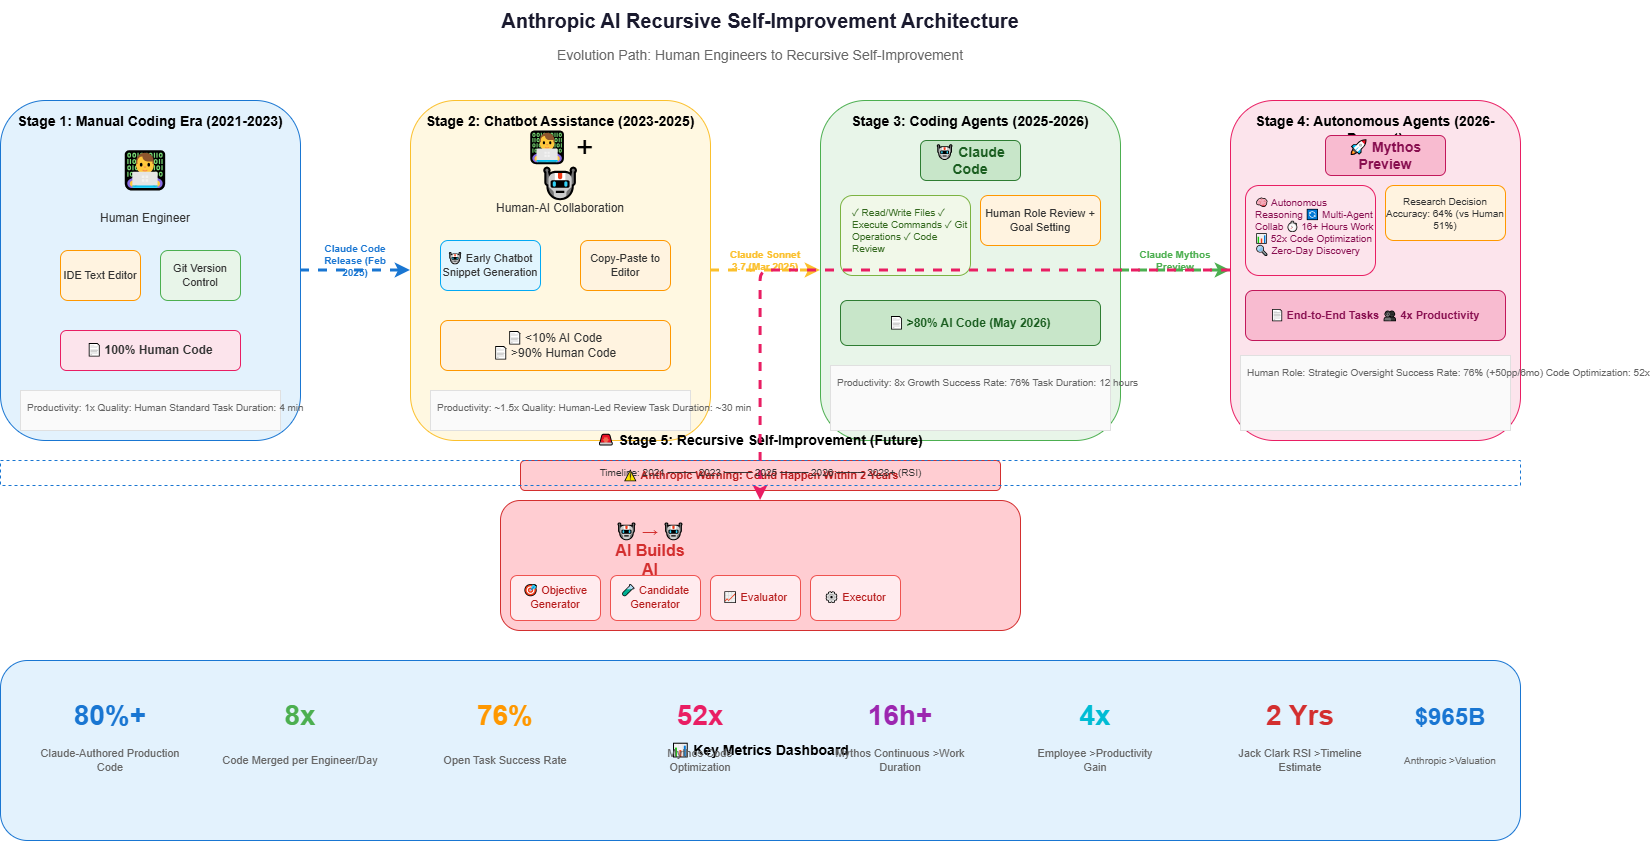
Anthropic披露的数据指向同一个方向:截至2026年5月,其代码库中超过80%的合并代码由Claude编写,而Claude Code发布前这个数字仅是个位数。2026年第二季度,典型工程师每天合并的代码量达到2024年的约8倍。在最开放的任务中,Claude的成功率到2026年5月达到76%,六个月内提高了50个百分点。

这些数字放在一起,描述的是一个执行速度被大幅放大的研发流程。代码写得更多、合并得更快、开放任务的完成率更高。但Anthropic自己提醒,代码行数不等于生产力提升——合并量增长8倍,不代表有效产出增长8倍。
代码编写和任务执行的自动化
执行层的自动化有明确的边界。代码合并、任务执行、在给定目标下寻找最优解,这些工作的共同点是:目标由人设定,完成标准由人定义,AI负责在约束条件内跑出结果。
Anthropic公开的LLM训练代码优化任务提供了一个具体案例。Claude在2025年5月平均提速2.9倍,到2026年4月达到52倍。人类研究员完成同类任务实现4倍提速需要4到8小时。这个对比说明的是执行效率的量级差异,但任务本身——优化哪段代码、以什么指标衡量、提速多少算合格——仍然由人框定。
当任务需要AI自己定义问题和评估标准时,表现明显回落。这不是模型能力突然下降,而是执行自动化和判断自动化之间的断层。
人类还在做什么
人类研究员的工作重心正在从“写代码”转向“定方向”。任务怎么拆、优先级怎么排、什么结果算好、什么时候该停——这些判断目前仍然由人负责。26%测的是已定义任务中的执行主导程度,不是AI自主决定研发方向的比例。
执行层的自动化本身可能改变研发的节奏和规模。即使判断仍由人做,量变也可能带来质变——当AI能在几小时内完成过去需要数天的执行工作,人类研究员可以尝试更多方向、更快验证假设。但代码行数不等于生产力,合并量不等于有效产出。执行加速的真实意义,取决于人类判断的质量能不能跟上执行的速度。
执行层的大幅自动化自然会引出一个问题:如果执行足够快、足够多,AI能不能自己形成改进的闭环?
递归自我改进的闭环,卡在哪一步
PGR实验说明了什么
Anthropic做过一项名为PGR的开放式实验:让较弱的模型去监督更强的模型,看AI能不能自己补上两者之间的能力差距。两位人类研究员花了一周,弥合约23%的差距;9个Claude智能体并行运行约5个自然日、累计约800小时,把差距弥合到97%。单看这个数字,执行效率确实可观——人类一周的工作量,AI用不到六天、约1.8万美元算力就完成了,而且做得更彻底。
但实验的设计本身划定了边界:问题是人类选的,评分标准也是人类定的,结果没有完全迁移到生产规模的模型上。这三点限定不是事后补充的免责声明,而是理解这个实验的关键。它测的是“在人类已经定义好问题和评判标准的前提下,AI能否高效执行”,而不是“AI能否自己发现值得解决的问题”。
800小时与0.5分的落差
同一个实验还有后半段。Anthropic把得分最高的方法搬进生产训练环境,在另一套留出评测中只测到0.5分提升,仍在噪声范围内。
97%和0.5分之间的落差,指向一个具体的机制:AI在实验室条件下能找到有效解法,但这些解法迁移到真实训练环境后基本失效。实验室环境的问题是封闭的、指标是清晰的、变量是可控的;生产环境的问题更开放,评测标准更模糊,一个在特定任务上表现优异的方案未必能泛化。0.5分提升落在噪声范围内,意味着你无法确定这个改进是真实效果还是随机波动。
PostTrainBench的数据提供了另一个参照。在AI自动微调任务上,顶级模型得分25%到28%,人类基线51%。AI大约做到人类的一半。这个差距比PGR实验的结果更温和,也更接近日常研发的真实场景——没有精心设计的实验环境,就是让AI去完成一个标准的模型微调任务。
执行速度不等于闭环能力
递归自我改进的完整闭环需要四步:AI自己定义要改进什么问题、执行改进、验证改进是否有效、根据验证结果重新定义下一步方向。当前的状态是执行环节已经相当快,验证和迁移环节明显不足,定义问题这一步基本还由人完成。
Anthropic自己也承认,目前没有任何被测量的AI研发工作达到AL5级别,也就是完全无人类参与的自主工作。研究人员称已观察到递归自我提升的早期迹象,Jack Clark预测2028年底无人类参与的AI研发落地概率超过60%。这些是判断和预测,不是已经跑通的闭环。一位作者在相关论文中给出的估计更保守:2027年落地概率仅30%。
差异不在执行速度上。AI写代码、跑实验、调参数的速度已经远超人类,但“知道该改进什么”和“判断改进是否真的有效”这两件事,目前仍然依赖人类设定问题框架和评判标准。执行快只能让闭环转得更快,不能让闭环自己转起来。
这个数字对读者意味着什么
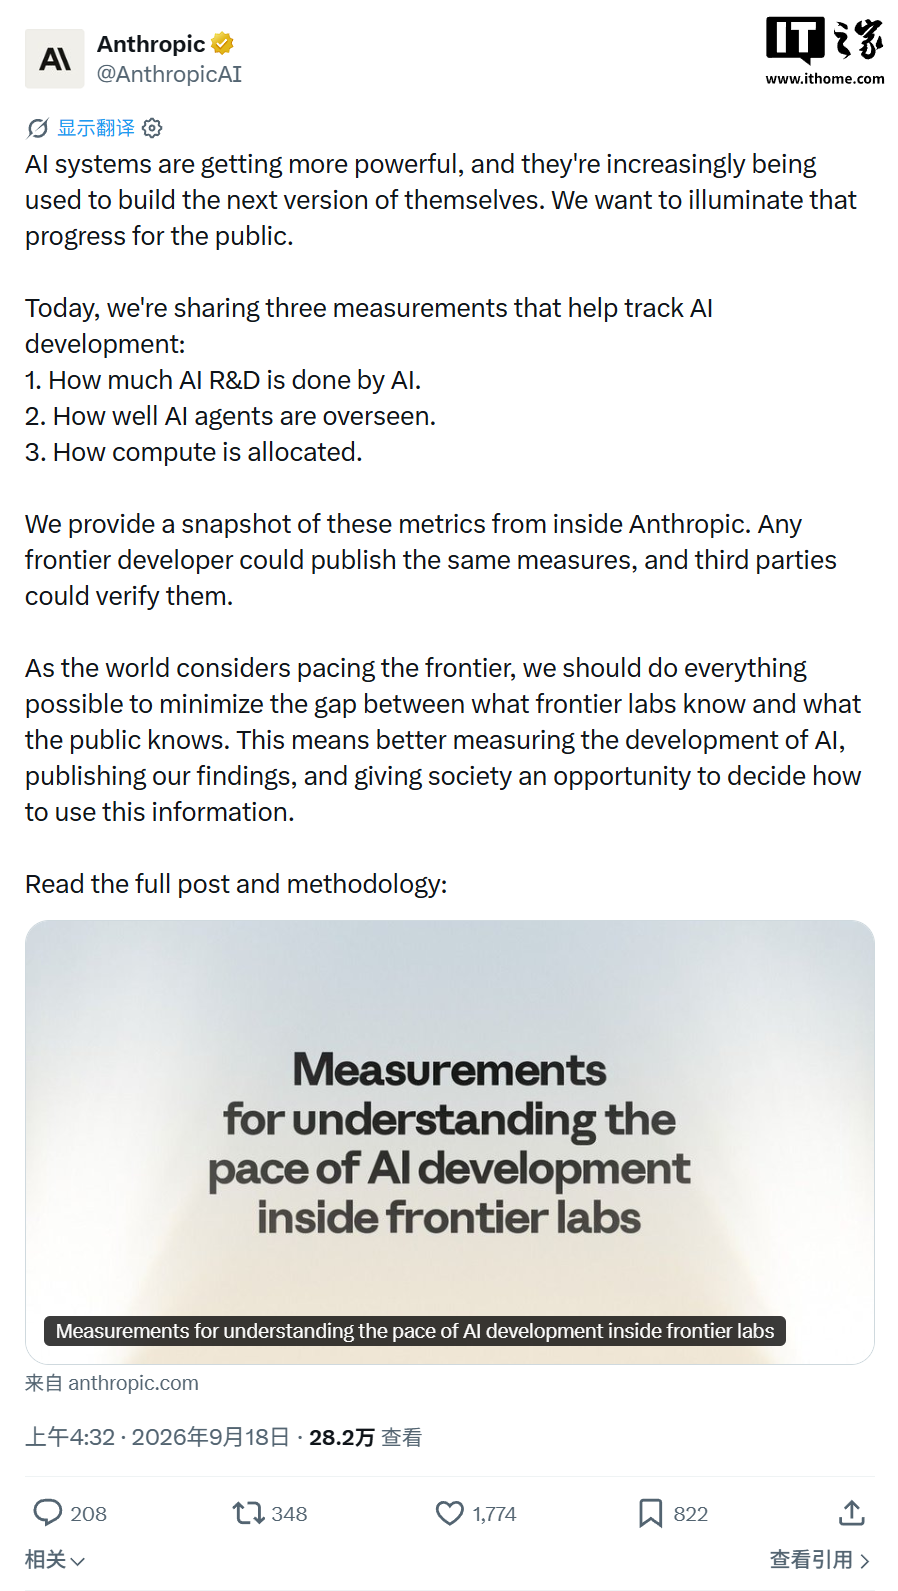
为什么Anthropic要公开这些数据
Anthropic在博文里说,公开指标是为了“消除顶尖实验室与公众之间的信息鸿沟”,让社会参与决定如何应对。这个表态本身没问题,但需要和它的另一面放在一起看。同一时期,CEO阿莫德伊公开呼吁放缓AI研发,并称计划“不牺牲商业优势或美国在人工智能领域的领先地位”。一家正在加速的实验室呼吁行业减速,这种张力不必然否定数据的参考价值,但提醒一件事:来源方的判断和来源方的利益,最好分开评估。

安全算力占比透露的信号
Anthropic统计了2026年7月13日至20日的算力分配:用于AI研发的算力中约6%投入安全研究;仅统计基于AI的AI研发工作时,安全研究占比约12%。公司自己标注这是保守估计,且算力占比不能直接代表安全工作的整体投入。6%到12%不算高,但也不是零。它说明安全研究在被单独计量,这本身是一个可追踪的变量。
监控系统在运转。2026年8月,Anthropic分析了超过10亿次智能体决策,约0.002%被实时拦截,大约每4.7万次操作出现一次。拦截率低可以有两种解读:系统运行良好,或者监控覆盖有限。两种可能同时存在。
普通读者该关注什么变量

如果只记一个判断框架,可以分成两条曲线:执行自动化和判断自动化。前者在快速上升,后者尚未出现同等速度的变化。
具体看三个变量。第一,AI自主定义任务的比例——不是完成已拆解任务的比例,而是任务由谁提出。第二,验证环节的人类参与度——结果好不好由谁判定。第三,第三方独立评估是否出现——目前所有关键数字都来自Anthropic自己的测量和披露。Jack Clark预测2028年底无人类参与的AI研发落地概率超过60%,这是个人判断,不是已验证的事实。
26%这个数字会继续被引用,但它测的是执行层,不是判断层。跟踪后者的进展,比记住前者的数值更有用。