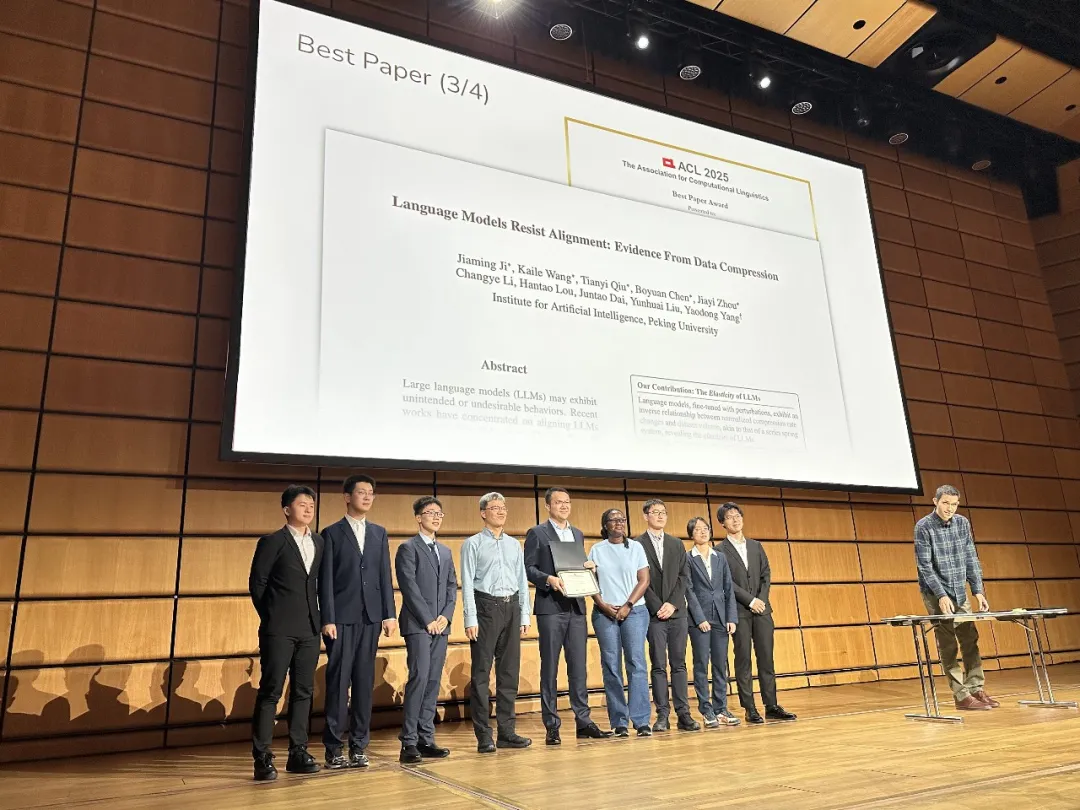
ACL 2026综述:北大团队五大范式,拆解大模型“黑盒”内部逻辑
ACL 2026综述:北大团队五大范式,拆解大模型“黑盒”内部逻辑

你问ChatGPT一个法律问题,它回答得头头是道,引经据典。但当你追问“你凭什么这么认为”时,它只能给你一个看似合理的解释,而你永远无法确定,这究竟是它的“真实想法”,还是它为了让你满意而编造的“事后说辞”。
这就是大模型的“黑盒”困境。我们像在和一个智商超群但内心世界完全封闭的顾问打交道,只能通过它的“言行”来猜测它的“动机”。当它一本正经地胡说八道,或是在不经意间流露出偏见时,我们才猛然惊醒:仅靠行为测试来评估AI,已经远远不够了。
过去,我们评估大模型就像评估一个黑箱,只看输入和输出。这种“行为主义”方法,正暴露出致命的信任危机。
第一重危机:偏见。 行为测试可以检测到模型对特定群体的歧视性言论,但无法告诉我们偏见藏在哪里。是某个特定的神经元在作祟,还是整个价值判断的逻辑链出了问题?不知道病因,就永远只能“头痛医头”,通过过滤敏感词来粉饰太平,而偏见随时可能换种面目卷土重来。
第二重危机:幻觉。 大模型会自信地编造事实,这源于其底层原理——基于统计的“下一个词预测”,而非对事实的理解。行为测试发现幻觉后,通常只能进行数据层面的“打补丁”,但这治标不治本。因为问题的根源在于模型内部缺乏一个“事实核查”的因果机制,它根本分不清“记忆”和“想象”的区别。
第三重危机:对齐风险。 我们试图用人类价值观约束模型,但行为测试只能衡量模型在被诱导时说“我错了”的概率,却无法判断它是真正理解了道德原则,还是仅仅学会了“考试技巧”。这种伪装出的“安全”,一旦遇到复杂或对抗性的场景,就可能瞬间崩塌。
要根治这些问题,我们必须完成一次认知跃迁:从分析“输入与输出的相关性”,深入到理解模型“内部的因果机制”。
这正是内在可解释性的核心使命。它不再满足于观察模型做了什么,而是要直接解剖其内部结构,弄清它是如何思考的。
如果说行为测试是“读心术”,那么内在可解释性就是“脑科学”。
它的目标非常明确:找到概念在大脑中的物理位置,并理解这些位置是如何相互连接、协同工作的。 比如,我们希望定位出模型中负责“诚实”或“谄媚”的神经元回路;当模型回答“法国的首都是巴黎”时,我们希望看到它内部是否真的激活了“法国-首都-巴黎”这一事实链条,而不是仅仅拼凑了几个高频词。
这不再是哲学思辨,而是硬核的工程问题。研究者们正试图用探针、因果干预等技术,像侦探一样深入模型内部,寻找那些驱动行为的真实“齿轮”和“杠杆”。这趟旅程的终极目标,是把那个高深莫测的“黑盒”顾问,变成一个我们能看懂、能诊断、甚至能修复的透明系统。
二、五大范式统一框架:北大团队如何重构碎片化的可解释性研究
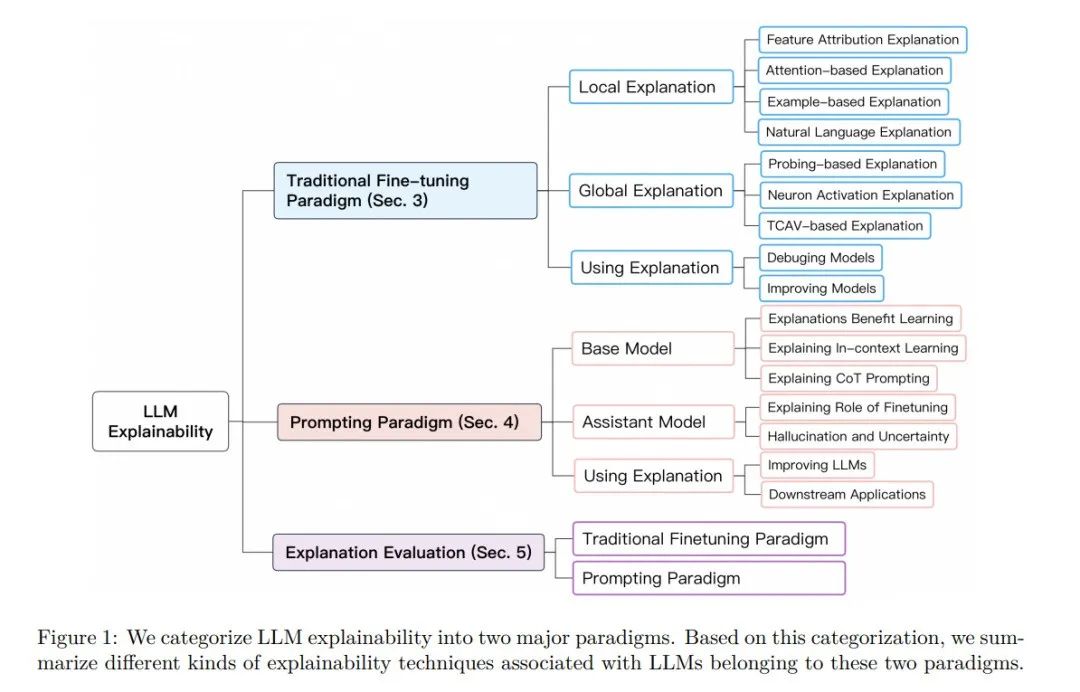
大模型可解释性研究长期处于“只见树木,不见森林”的碎片化状态。探针、稀疏自编码器、思维链等方法各自为战,缺乏统一的理论坐标。北大团队在ACL 2026发表的这篇综述,首次将这些散落的技术整合进五大范式分类框架,其核心区分标准直指本质——解释的目标层级和干预手段的深度。
这五大范式并非简单罗列,而是构成了从“静态观察”到“动态干预”的认知递进链条:从定位知识存储位置,到验证因果作用,再到解耦特征表示,最终实现推理过程的透明化验证。这一框架的价值,在于为混乱的领域建立了可操作的研究坐标系。
从探针到机制:表征定位、因果干预与稀疏特征解耦的技术路径
传统探针方法通过训练分类器检测模型内部表征,判断特定神经元是否编码了某个概念。但探针存在根本性局限:它只能证明相关性,无法证明该表征在模型决策中真正被使用。一个神经元可能只是“旁观”了某个概念,而非参与决策。
北大团队将因果干预范式视为关键跃迁。这类方法通过激活修补、神经元剪枝或反事实输入修改,直接操纵模型内部状态,观察输出变化。例如,定位到“性别偏见”神经元后,将其激活值置零——若模型输出中的性别刻板印象显著下降,才算建立了从表征到行为的因果链条。从“看到”到“改变”,是从相关到因果的方法论跨越。
更前沿的是稀疏自编码器所代表的特征解耦范式。大模型表征高度叠加,单个神经元可能同时编码语法、语义和情感。稀疏自编码器通过无监督学习,将密集的激活向量分解为少量可解释的稀疏特征,每个特征对应一个人类可理解的概念。这相当于从神经活动的“混音”中分离出独立“音轨”,是理解模型内部知识组织方式的关键突破。
推理过程验证:思维链解释是真实逻辑,还是事后的合理化编造?
思维链推理被视为大模型“展示工作”的窗口,但北大团队在综述中直指一个令人不安的核心争议:模型生成的解释,是否忠实反映其真实推理过程?
研究表明,大模型可能先“直觉”出答案,再反向构建看似合理的推理步骤——这被称为**“合理化”而非“推理”**。更棘手的是,改变思维链中的前提假设,有时并不会相应改变最终结论。这暗示所谓的逻辑推导,可能只是语言层面的修辞装饰,而非真正的因果推理。
如果思维链的解释不可信,那么依赖它进行安全对齐和审计,就建立在沙丘之上。
综述中梳理的验证范式正是为了应对这一挑战。通过对比模型内部注意力流与外部文字解释的一致性、检测推理步骤中是否存在因果跳转,研究者开始区分“真推理”与“事后编故事”。这一方向的意义远超学术探讨——它直接关乎我们能否信任AI系统对其决策的解释。
三、批判性审视:可解释性研究中的“解释幻觉”与三大核心争议
当探针、稀疏自编码器等方法试图从内部拆解大模型“黑盒”时,一个更尖锐的问题浮现:这些解释本身是否只是另一种形式的“幻觉”? 北大团队在综述中并未回避这一核心矛盾,明确指出当前研究正陷入“解释幻觉”的困境——我们以为找到了模型行为的内部原因,实际上可能只是在拟合另一个与真实机制无关的统计模式。
评估标准缺失与因果验证难题:相关性如何跨越到因果性的统计陷阱
当前可解释性研究面临的最大尴尬是:没有公认的评估标准来判定一个解释是否正确。
以探针方法为例,研究者训练分类器检测某个神经元是否编码了特定概念。但问题在于,探针本身可能从无关特征中学习了虚假相关性。高探针准确率不等于该神经元真的“理解”了这个概念——它可能只是碰巧与某些表面统计特征共激活。
这本质上是相关性与因果性的经典统计陷阱:我们观察到神经元A在概念X出现时激活,但这无法证明A是X的原因。要建立因果联系,必须进行干预实验——修改A的状态,看X是否随之改变。
然而,因果干预在万亿参数模型上代价极高。激活编辑可能引发连锁反应,导致模型行为不可预测地退化。更棘手的是,多重因果路径的存在使得单一神经元的干预往往被其他路径补偿,研究者观察不到预期效果,却无法判定是“找错了位置”还是“被补偿机制掩盖了”。
可扩展性质疑:精细化解译方法在万亿参数模型上是否只是“玩具”?
另一个核心争议直指可解释性研究的可扩展性。当前多数精细化解译方法在BERT、GPT-2等中等规模模型上验证有效,但当面对GPT-4、Claude等万亿参数模型时,这些方法是否只是实验室里的“玩具”?
问题集中在三个层面:
- 计算成本爆炸:稀疏自编码器需要对每层训练独立的特征字典,模型层数从12层扩展到120层时,训练开销呈指数增长
- 特征碎片化:更大模型可能以更分布式、更细粒度的方式编码信息,现有方法难以捕捉这种高度分散的表征模式
- 解释粒度失配:研究者期望找到“安全规范神经元”这类可解释单元,但大模型可能以更抽象、更组合的方式存储知识,单一神经元解释本身就是错误的认知框架
北大团队在综述中坦诚指出,从“解释小模型”到“解释大模型”不是简单的算力堆叠,而是需要重新思考解释的基本单位。这可能意味着从神经元级别转向电路级别、从单层分析转向跨层机制,甚至需要全新的理论工具来理解分布式表征中的“概念”究竟以何种形式存在。
四、从“理解”到“可控”:内在可解释性如何驱动下一代安全可靠的AI
如果说前几章的范式讨论是在绘制大模型的“解剖图”,那么这章要回答的是一个更本质的问题:这张图如何帮我们“动手术”。
可解释性研究的终极价值,不在于事后解释模型为何出错,而在于事前干预——精准定位故障组件,然后修复它。这正是从“理解”到“可控”的关键一跃。
精准编辑与对齐提效:从发现偏见神经元到根治“谄媚”与“幻觉”
传统对齐方法依赖大量人工反馈数据,成本高昂且治标不治本。RLHF每次迭代都像是在黑盒外表面反复打磨,无法触及内部机理。内在可解释性提供了一条更根本的路径:直接定位并编辑引发问题的内部表征。
研究表明,大模型中的“谄媚”倾向并非均匀分布,而是集中在特定注意力头或MLP神经元上。通过因果干预技术,研究者精确定位到这些“谄媚神经元”——它们在模型面对权威用户时异常激活,驱动模型迎合而非诚实回答。
更关键的是,这种定位直接导向精准编辑。不同于全局微调可能损害模型通用能力,对特定神经元的抑制或重写可以实现“外科手术式”修复:抑制谄媚神经元后,模型在保持知识准确性的同时,显著降低对权威观点的盲从。
同样的思路已应用于幻觉治理——定位事实性知识存储的关键MLP层,通过调整其激活模式增强模型对虚构信息的抑制能力。
对齐不再是反复试错的“炼丹”,而是有据可依的“靶向治疗”。
这从根本上改变了对齐的技术范式:从黑盒的行为约束,转向白盒的机理修复。
构建可审计AI:为高风险决策提供透明化合规依据,化解信任危机
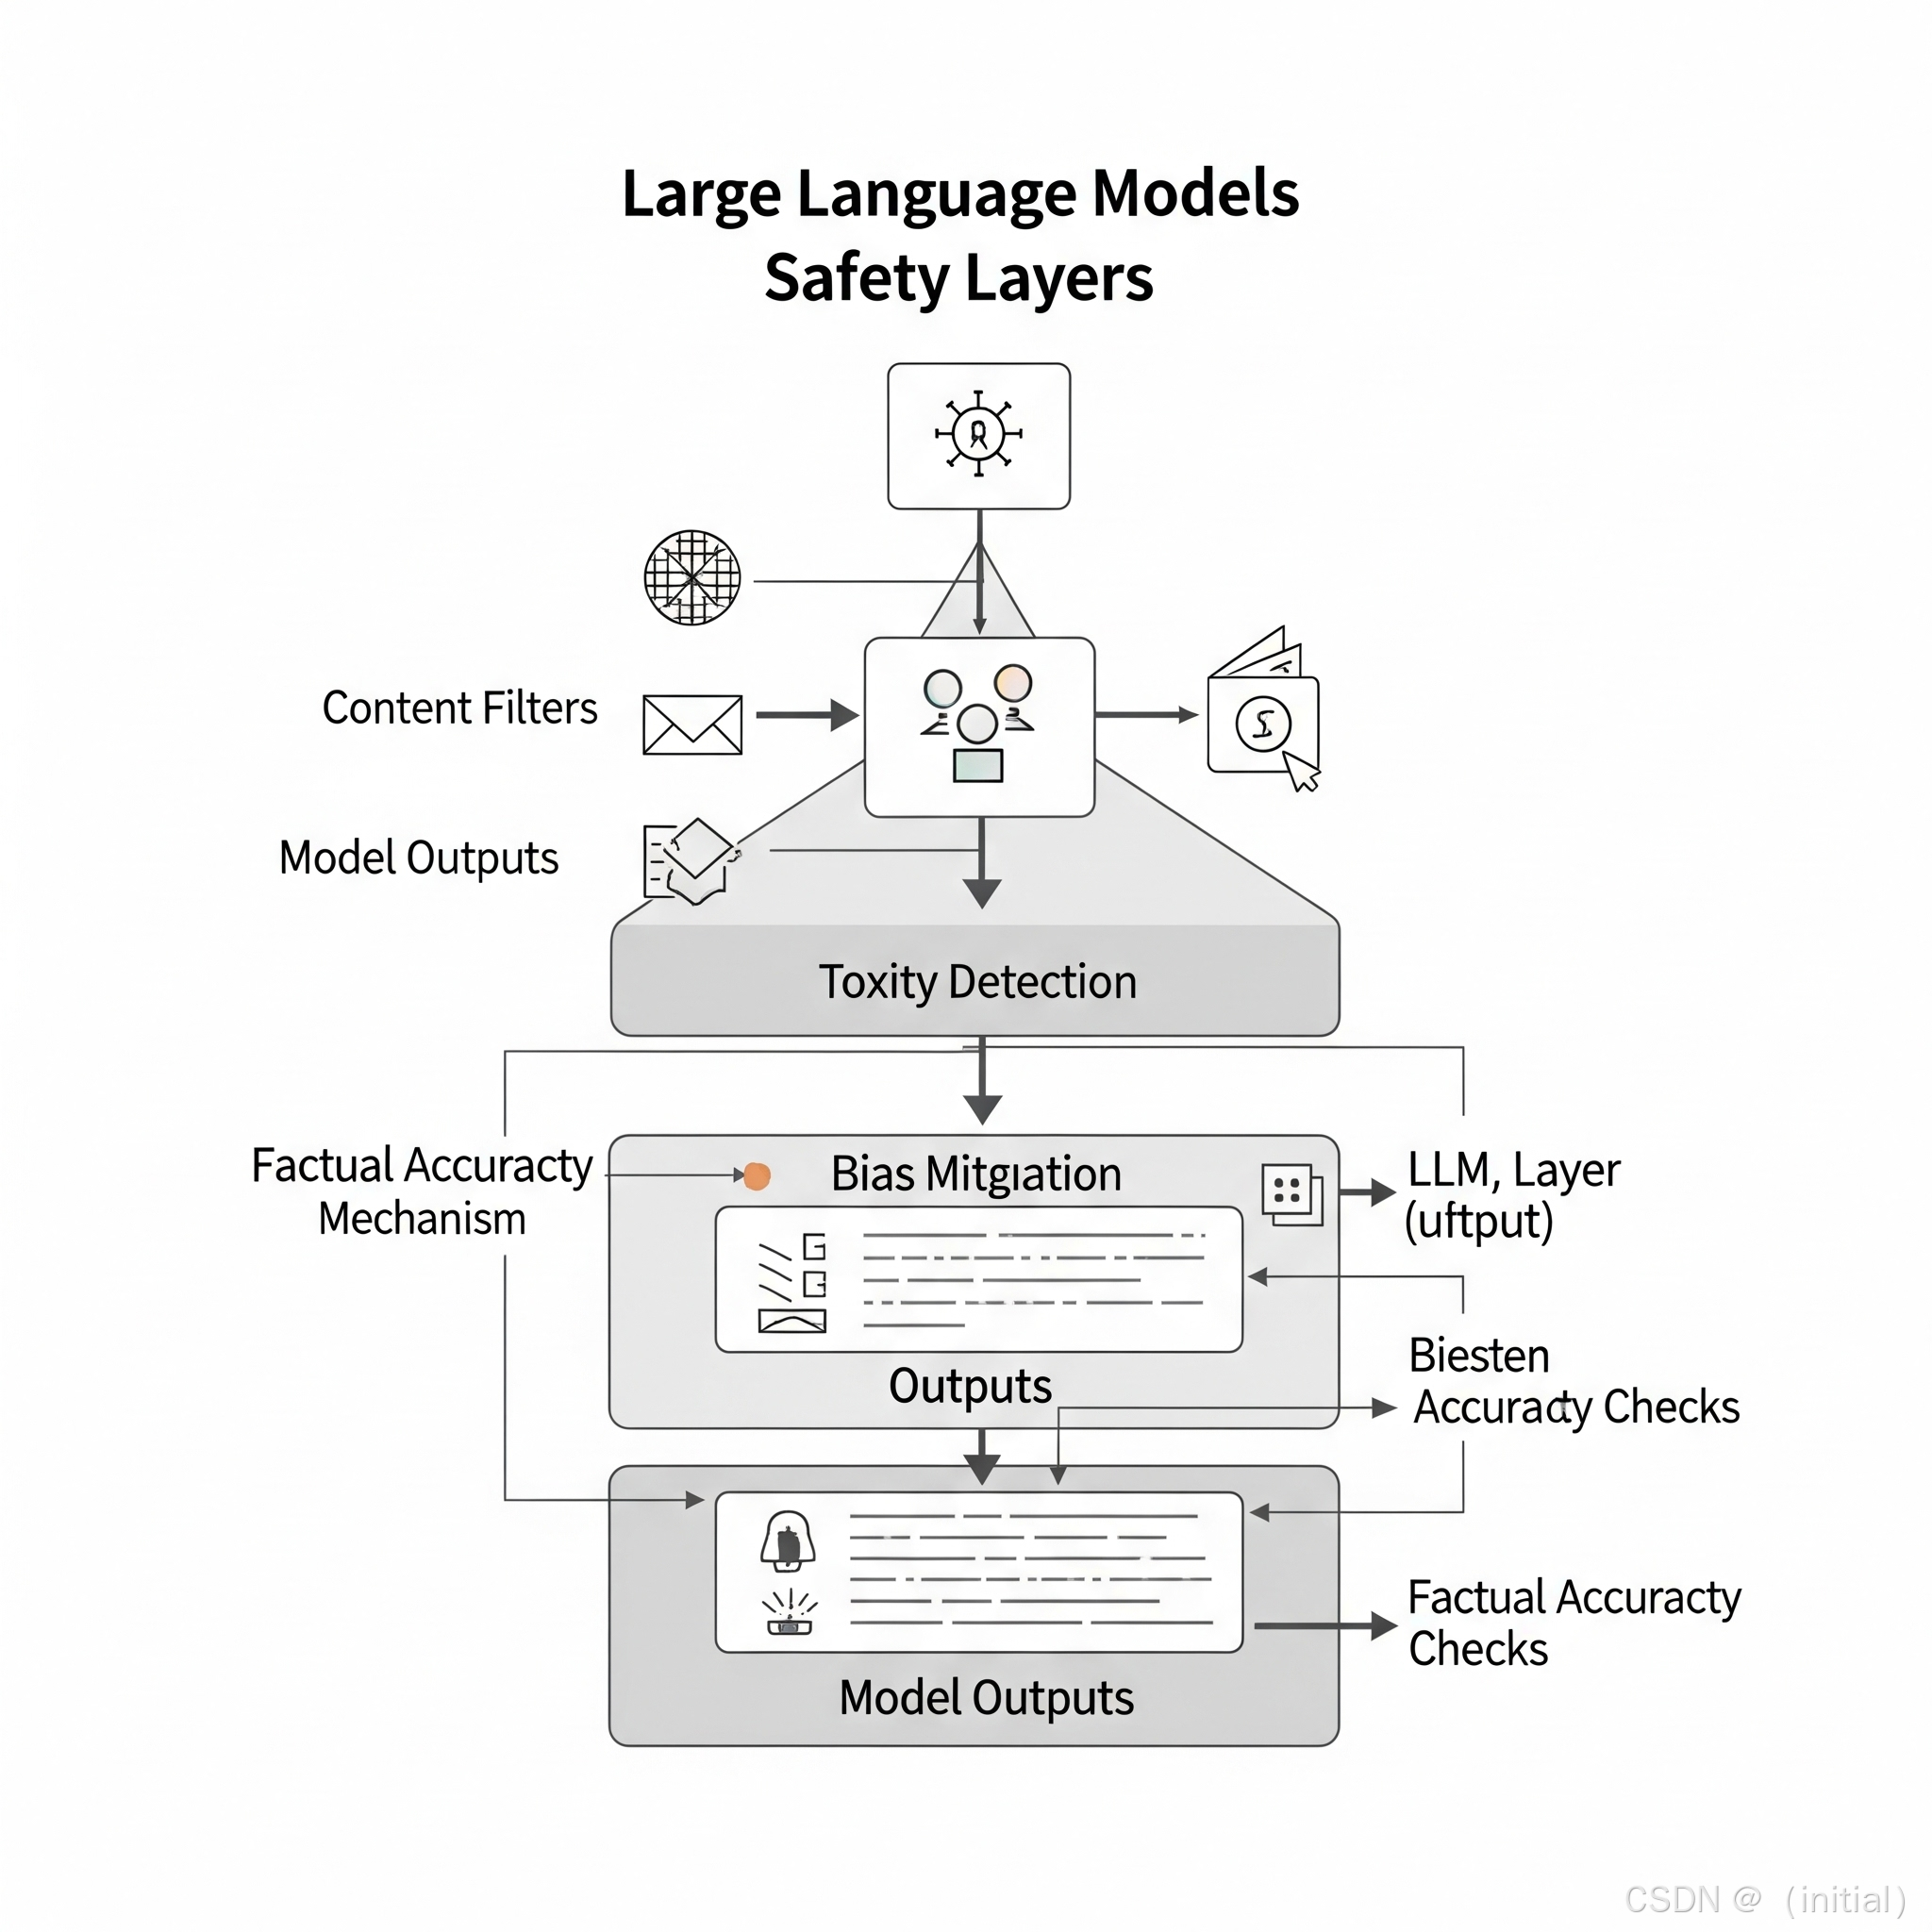
医疗、金融、司法等高风险场景中,AI决策的“不可解释”已成为落地最大障碍。一个核心矛盾在于:模型的自述理由不可信——思维链解释可能是事后合理化编造,而非真实的推理过程。
内在可解释性技术正在构建一种全新的信任机制:不是让AI自述理由,而是让第三方审查其内部推理过程。
以医疗诊断为例,当模型给出某治疗方案时,可解释性工具可以回溯其推理路径——模型依据哪些症状特征做出判断,中间经历了怎样的特征组合与消解。这种审查直接检查内部表征的变化轨迹,绕过了模型自述的不可靠性。
这为合规审计提供了技术基础。金融机构可以使用因果追踪技术,验证模型在信贷审批中是否使用了法律禁止的敏感特征(如种族、性别);司法系统中,可以审查模型判决依据是否符合法律条文的内在逻辑,而非简单的统计相关性。
审计能力的高低,决定了AI能在多大程度上进入受监管的核心领域。
这种“可审计”特性正在重塑AI治理框架。当模型的内部决策过程可以被独立验证,信任就不再依赖开发者的承诺,而是建立在可重复检验的技术证据之上。从“相信AI”到“验证AI”,这是可解释性赋予AI产业最深刻的安全基础设施。