小米开源「方言克星」模型:吴语粤语全听懂,中英混说无死角
小米开源「方言克星」模型:吴语粤语全听懂,中英混说无死角
对着车载导航字正腔圆地喊“去陆家嘴”,屏幕弹出“卢家嘴”;开会时同事一句“这个case的deadline我们hold不住”,录音转写直接乱码——这不是你的普通话不够标准,而是传统语音识别一直活在“静音实验室”里,一碰到真实世界的方言口音和中英混说,立刻“识别宕机”。
2026年4月24日,小米开源的MiMo-V2.5-ASR模型,首次在模型层面同时啃下了吴语、粤语、闽南语、四川话等8种中文方言,以及中英混说这两块硬骨头。
告别“语种预设”:吴语、粤语、闽南语与中英混说如何被一次性解决

过去ASR系统最大的痛点,是需要你先告诉它“接下来要说什么话”。切换到粤语模式,它听不懂普通话;开启英文识别,方言就变成乱码。一旦说话者自由切换,系统立刻“懵了”。
MiMo-V2.5-ASR的颠覆性在于——完全取消了语种预设标签。用户从普通话无缝切换到上海话,再掺杂英文术语,模型都能自动识别、流畅转录。这背后的技术逻辑,是将方言和混说场景纳入统一的端到端训练框架,让模型自己学会在不同语种间自由“跳转”,而不是依赖外挂的语种分类器。
这意味着什么?一个真实的商务场景:会议中A用普通话讲市场策略,B用粤语补充细节,C突然冒出一句“这个ROI我们需要re-calculate一下”——传统系统至少要切换三次模式,而MiMo-V2.5-ASR全程无感转录。这种“无边界”的语音交互,才是AI落地真实世界的应有姿态。
技术亮点拆解:高知识密度内容的精准转写能力

如果说方言识别解决了“听得懂”的问题,那高知识密度内容的转写能力,则决定了AI是“听了个大概”还是“真正能落笔成文”。
古诗词、专业术语、人名地名,一直是语音识别的重灾区。“氢氦锂铍硼”可能被记成“青海里边蹦”,“苏轼”变成“舒适”。MiMo-V2.5-ASR在这类场景下展现了极强的知识关联能力——它能结合语义和韵律,精准识别容易混淆的专有名词。
更实用的是,模型原生输出带标点符号的结构化文本,转写结果即拿即用,直接省去人工校对时间。一场学术会议、一堂古文课、一次医疗会诊,语音记录不再是模糊的“听写草稿”,而是可以直接存档的精准档案。这背后考验的不仅是声学模型,更是语言模型对知识图谱的理解深度——而这一点,恰恰是大多数开源ASR模型的短板。
二、走出“静音实验室”:真实复杂场景下的硬核抗压测试
实验室的99%识别率早已是行业标配,但一进真实场景,方言口音、环境噪音、多人抢话瞬间让模型“耳聋”。MiMo-V2.5-ASR的真正分水岭,在于它直面了这些混乱。
强噪音与远场交互:高鲁棒性背后的抗噪机制与多人对话分离技术
大多数ASR模型在咖啡馆、地铁站等场景下,准确率会断崖式下跌。MiMo-V2.5-ASR的突破在于,在强噪音环境下仍能保持92%以上的识别率。这个数字背后,是一套仿生学思路的工程实现。
核心技术是多通道声源分离。它不像传统降噪那样简单“减去”噪音,而是模拟人耳的“鸡尾酒会效应”——在多声源叠加的混乱波形中,分离并锁定目标说话人的声音。这意味着模型不是在“去噪”,而是在“选择性聆听”。
更具实战价值的是最多6人同时对话的实时转写能力。会议纪要、焦点小组访谈、多人播客这些场景,不再需要强制“轮流发言”的对话规则。模型能同时追踪多个声源,输出带说话人标签的结构化文本。
一个容易被忽视但直接影响效率的细节:原生输出标点符号。传统ASR输出的是一串无标点的连续文本,需额外后处理。MiMo-V2.5-ASR结合语音韵律与语义,自动添加逗号、句号,转写结果即拿即用,直接对接下游文档处理或NLU流程。
语音识别的真正门槛不是标准普通话,而是那些“不标准”的真实场景。谁能填平这条鸿沟,谁就掌握了语音交互落地的关键钥匙。
三、开源“听觉基座”:小米避开TTS红海的差异化生态阳谋
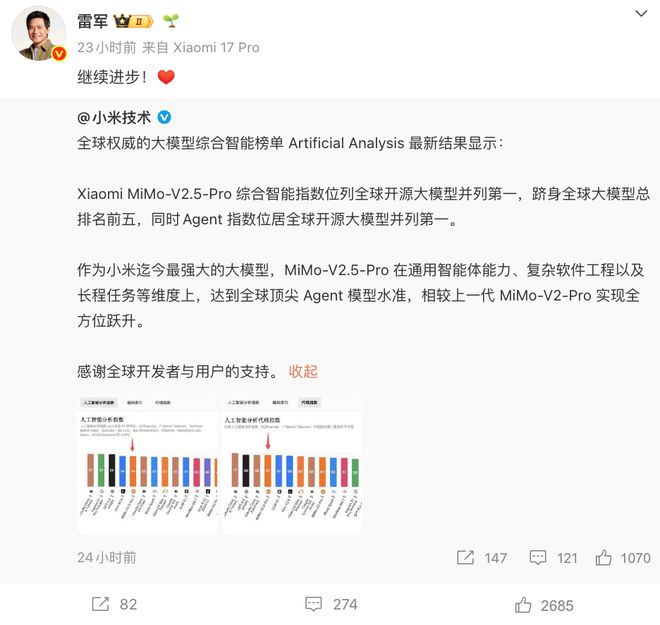
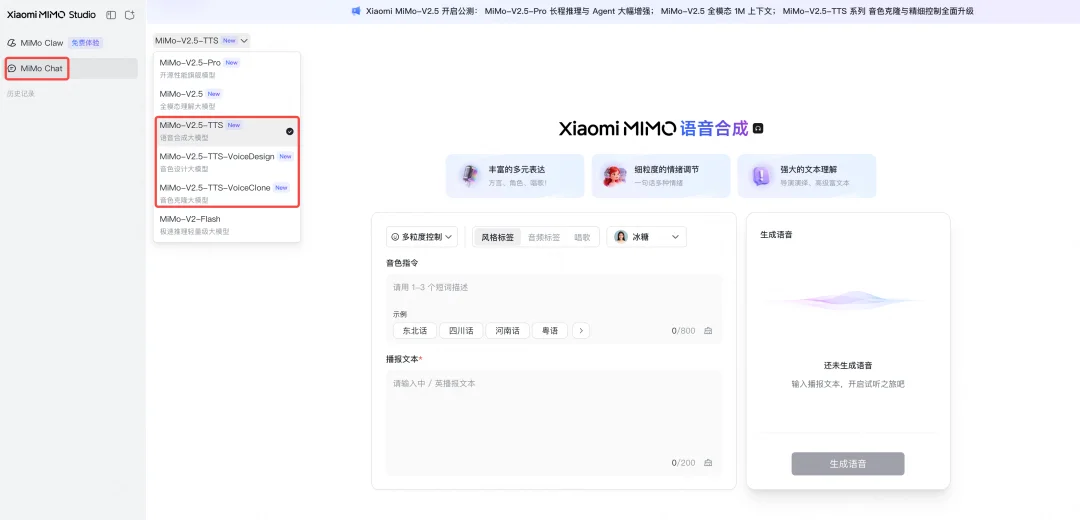
在语音合成(TTS)赛道已被阿里、字节等巨头卷成“红海”的当下,小米选择了一条更聪明的路径:将ASR作为全链路语音的“听觉基座”彻底开源。三款TTS模型虽然功能亮眼,但闭源且“限时免费”意味着中长期成本不可控。而ASR的完全开源,才是真正撬动开发者生态的支点。
Apache-2.0协议全开源:支持本地私有化部署带来的开发者吸引力
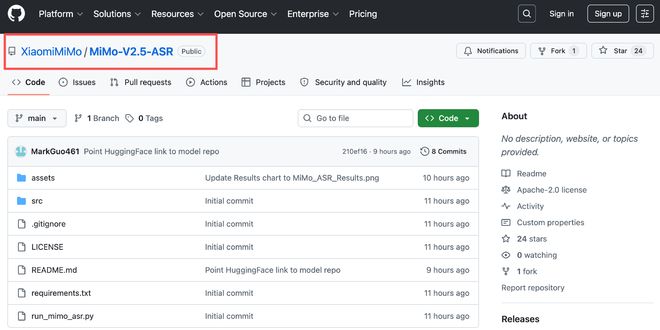
MiMo-V2.5-ASR采用Apache-2.0许可证,同步公开模型权重与训练代码,支持PyTorch与TensorFlow双框架部署。这对开发者意味着三件事:
- 本地私有化部署:敏感语音数据不出企业内网,满足金融、医疗、政务等强合规场景
- 二次开发自由:可基于模型微调特定领域的方言或术语,无需绑定云端API
- 零成本接入:直接通过GitHub或HuggingFace获取,上手门槛极低
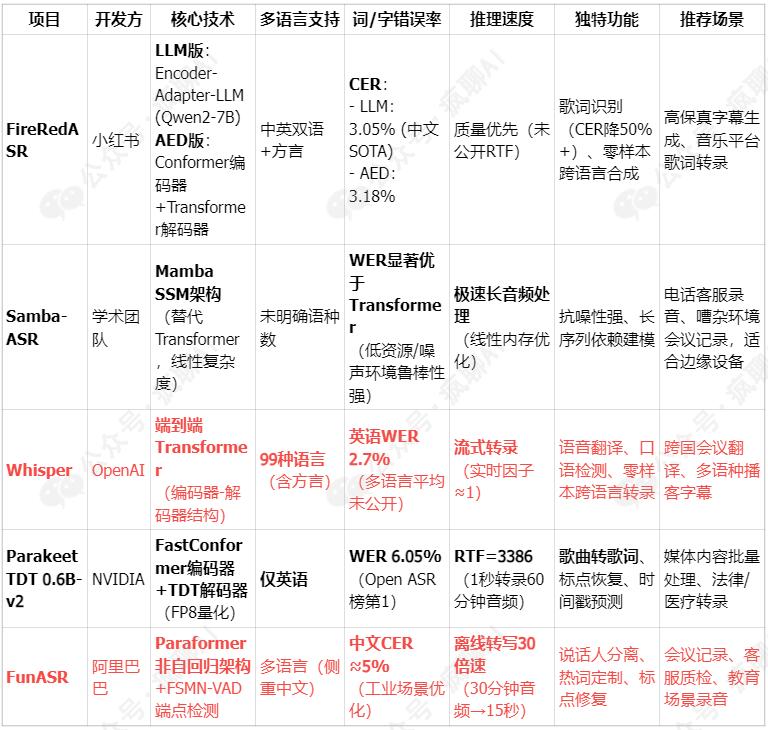
对于会议转写、客服质检、车载语音等需要数据安全与低延迟的场景,本地部署ASR是刚需。小米此举直接对标阿里FunASR的开源路线,但与字节、MiniMax的闭源API模式形成鲜明区隔。在开发者生态的争夺中,开源ASR比闭源TTS更具长期粘性——毕竟,没有人愿意把核心业务构建在“随时可能收费”的限免API上。
待验证的争议:关键指标缺失下的实际落地效果与潜在翻车风险
然而,这份“慷慨”背后藏着不容忽视的隐忧。
小米未公布任何量化评测数据。词错率(WER)、字错率(CER)、实时率(RTF)等关键指标一概缺失。对比VoxCPM2公开四项核心指标的做法,MiMo-V2.5-ASR的“业界领先”更像一句缺乏支撑的自我宣言。
更关键的是,官方演示音频已暴露明显瑕疵。在Agent链路生成的样本中,爷爷角色的声音特征未能贯穿始终,中途突然背离“嗓门哑、拖长音”的需求,语气出现异常加速。这暴露出模型在长时一致性与复杂指令遵循上可能存在的短板。
另外,TTS闭源与ASR开源的不对称组合,对需要完整语音链路的开发者而言仍是半成品——部署了开源ASR后,TTS侧仍需依赖小米限免API或另寻方案。这种割裂能否真正构建起生态闭环,还需要实际落地案例的检验。
开源是诚意,但缺少数据支撑的“诚意”更像一场豪赌。开发者接入前,值得先在自有场景中跑一遍真实录音测试。