阿里开源LOGOS:1/56参数超越微软,科学语法重构AI科研范式
阿里开源LOGOS:1/56参数超越微软,科学语法重构AI科研范式
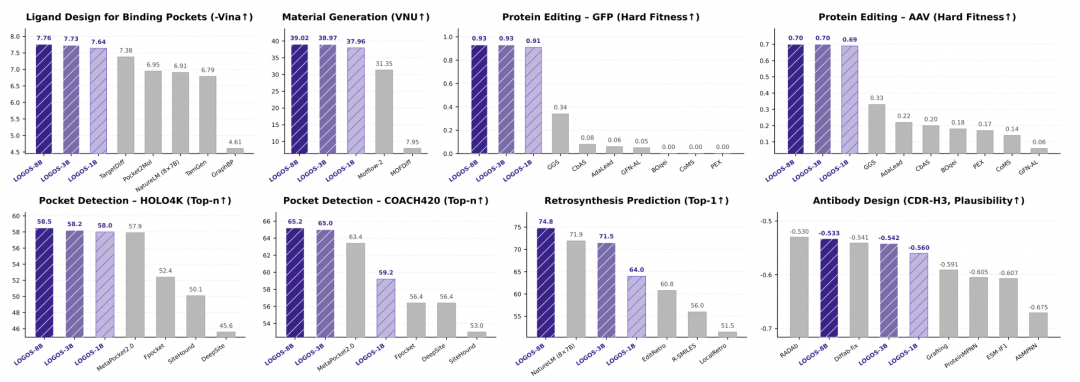
在AI圈,我们见过太多“大力出奇迹”的故事——参数越多,算力越强,模型就越聪明。但这一次,阿里LOGOS用一组数据彻底颠覆了这种认知:1B参数,干翻了56倍于自己的巨无霸。
这不是标题党,而是发生在六大代表性科学任务中的真实对决。LOGOS-1B仅凭10亿参数,就在蛋白质结构预测、分子生成等核心任务上,一致性地匹配甚至超越了微软的NatureLM——一个拥有8×7B参数的“科学巨兽”。
这意味着什么?效率的天花板被捅破了。

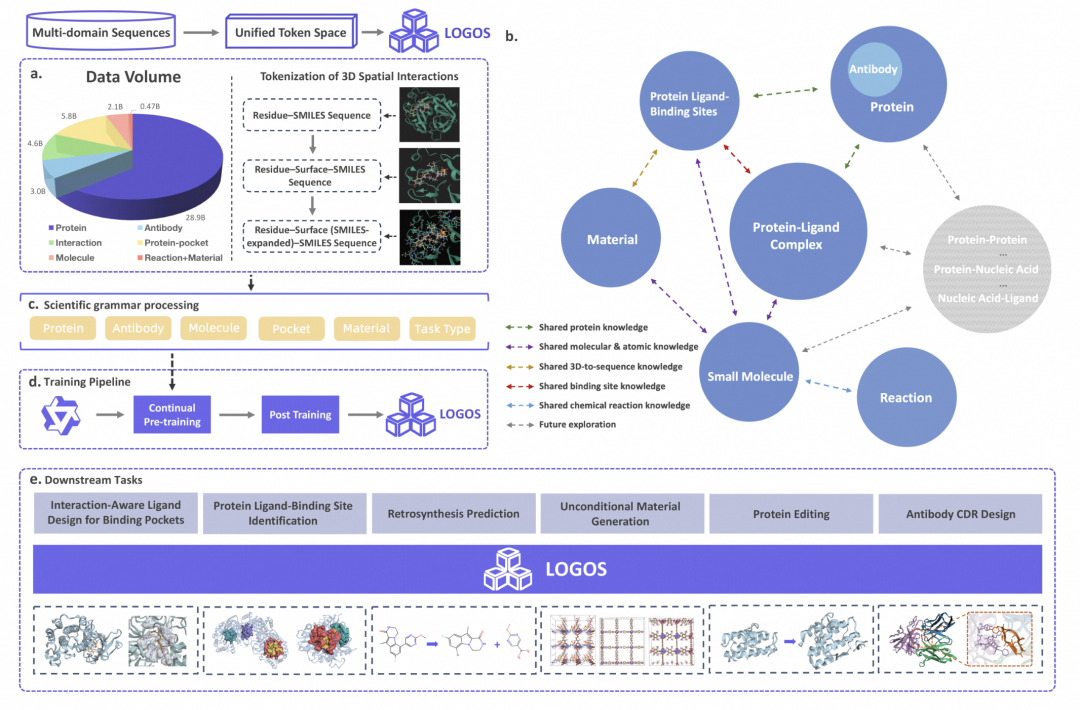
传统科学AI的困境在于:为了在特定任务上提升1%的精度,往往需要堆砌数十倍的计算资源。而LOGOS证明,真正的突破不在于把模型做大,而在于让模型“想得更聪明”。这种参数效率的质变,背后是范式级的重构——它不再把蛋白质、小分子、材料当作需要不同模型处理的独立问题,而是用一套“科学语法”统一编码为Token序列。
更令人拍案的是它对3D坐标的处理方式。传统方法要让AI理解蛋白质口袋如何嵌合小分子,必须输入精确的三维坐标,再通过复杂的几何神经网络进行空间建模。这就像让一个人必须拿着精确的GPS坐标才能理解“杯子放在桌子上”这个动作。
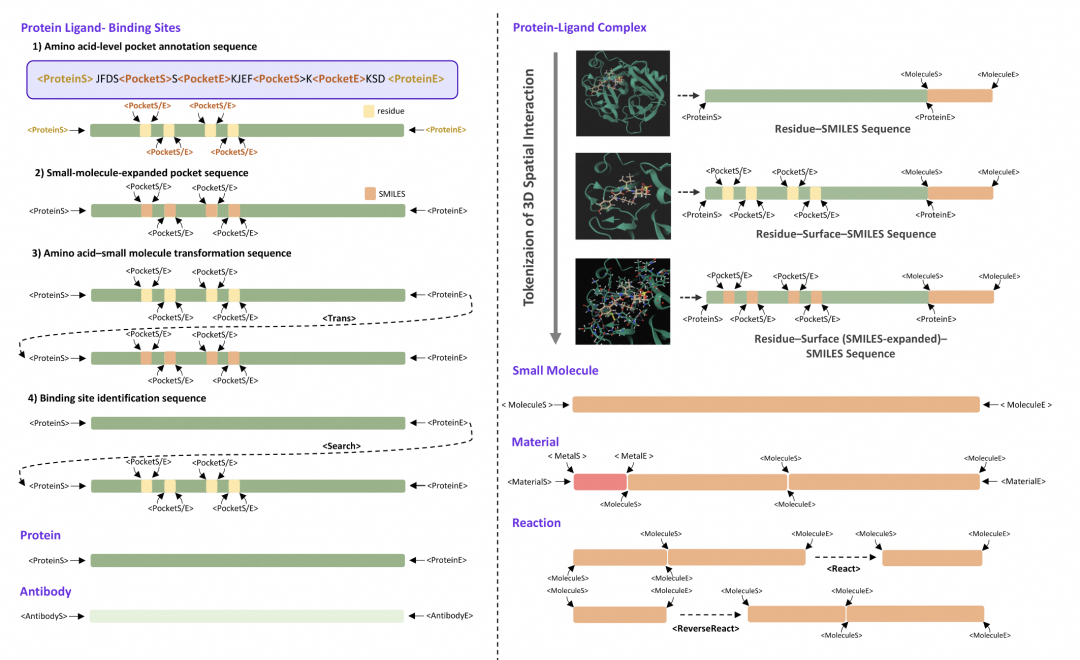
LOGOS发明了一种**“文字描述法”**:它把3D空间接触模式直接“语法化”为离散Token。模型不输入任何3D坐标,仅靠“读文字”——也就是序列预测——就能在参数空间内隐式构建出复杂的空间互作规律。
这种巧思的妙处在于:它把显式的几何约束转化为了隐式的序列规律。模型不需要“看见”三维结构,而是通过海量预训练“学会”了什么样的氨基酸序列会对应什么样的空间折叠模式。这就像经验丰富的化学家,看一眼分子式就能在脑中勾勒出三维构型——不是因为他算出了坐标,而是因为他内化了规律。
用文本的方式解决几何问题,这才是LOGOS效率革命的真正内核。

二、打破学科壁垒:LOGOS的“科学语法”如何统一异构数据
AI for Science长期陷入一个尴尬的悖论:模型越来越强,却越来越“孤独”。蛋白质预测用几何深度学习,分子生成用图神经网络,材料设计用扩散模型——每个学科都发展出独立的技术栈,但彼此之间无法对话。一个药物研发团队可能需要同时维护三套模型、三种数据格式、三类训练流程。
这不是技术不够先进,而是科学数据本身被学科边界切割成了“方言孤岛”。LOGOS的破局点,正是发明了一套让所有科学对象都能说的“通用语言”。
2.1 从蛋白质到小分子:统一Token序列消除“鸡同鸭讲”
传统科研AI的技术割裂,根源在数据形态的天然异构。蛋白质用氨基酸序列,小分子用SMILES字符串,MOF材料用晶格参数——这些对象不仅格式互不兼容,背后的物理化学规律也完全不同。结果是:蛋白质结构预测和药物分子生成,从模型架构到训练数据,几乎没有任何可复用性。
LOGOS的解法堪称优雅:构建共享词表,将所有科学对象统一编码为离散Token序列。它整合了7类模态、总计44.87B tokens的异构数据,让蛋白质口袋和小分子配体在模型眼中变成了同一套“语言”的不同句子。
但这不只是形式上的“硬拼”。真正的突破在于——当模型看到蛋白质的氨基酸口袋序列,能直接“翻译”出对应小分子的SMILES结构。这说明它不是在做模式记忆,而是真的学会了跨模态的语义对应。就像一个人学会了中英互译,而不是背下了所有平行语料。
这种知识共享能力,是碎片化专用模型无法企及的。当蛋白质和分子终于能“对话”,药物设计、蛋白质工程等交叉学科问题,才有了统一的建模基础。
2.2 预训练与下游任务对齐:弥合学用断层的关键设计

AI模型落地科研的最大痛点,不是性能不够,而是**“学用脱节”**。预训练阶段学的是通用表征,下游任务却需要特定输出格式——中间必须插入适配层、微调步骤,既消耗算力,又容易过拟合。很多模型在榜单上分数很高,一到真实实验场景就“水土不服”。
LOGOS通过科学语法设计,实现了形式与目标的双重对齐:
- 形式一致:预训练数据的序列形式,与下游任务的输入输出完全一致
- 目标一致:预训练的next-token prediction,就是下游的条件生成目标
这意味着什么?模型无需任何适配层,训练完就能直接激活生成能力。无论是预测蛋白质结构、生成候选分子,还是分析界面互作,都用同一套序列建模范式完成。研究者不再需要为每个新任务重新设计模型架构、调整损失函数。
从“一任务一模型”到“一模型多任务”,这个跨越才是效率革命真正的底层逻辑。它不只降低了技术门槛,更让交叉学科研究成为可能——一个统一模型,一套训练流程,覆盖多个科学问题。当模型学会了科学的“语法”,它就能在不同学科间自由“翻译”。
三、范式转移还是跑分狂欢:跨领域迁移的突破与隐忧
当“蛋白质方言”能被直接翻译成“小分子方言”,这已不仅是性能指标的跃升,而是认知范式的根本动摇。但跑分之外,更需审视的是:这种统一语法究竟是触及了科学规律的深层结构,还是仅仅学会了统计层面的模式匹配?
3.1 跨学科知识共享:模型是否真学会了底层科学逻辑
LOGOS最具颠覆性的演示,是让模型看到蛋白质的氨基酸口袋序列后,直接生成对应的小分子SMILES结构。这种跨模态“翻译”能力,证明共享词表确实在底层建立了实体间的对应关系。
但这与真正理解物理规律存在本质区别。 模型学到的是训练语料中蛋白质-配体配对模式的统计分布,而非热力学上的结合自由能计算。当面对训练分布之外的罕见氨基酸组合或非天然配体时,这种统计映射可能产生看似合理、实则物理上不可能的结果。
然而,即便仅是统计层面的知识共享,对AI for Science的碎片化现状已是重大突破。传统范式下,蛋白质结构预测和分子生成分属不同模型体系,预训练表征无法复用。LOGOS的统一Token空间让跨任务知识迁移成为可能——模型在蛋白质数据上学到的“语法规则”,能直接约束小分子生成时的“遣词造句”,这种底层表征共享,是此前任何领域专用模型都无法实现的。
3.2 纯序列建模的代价:显式几何约束丢失带来的物理风险

LOGOS最激进的设计,是彻底抛弃3D坐标,将空间互作“语法化”为离散Token。这种“文字描述法”带来了极致的灵活性和效率,但也埋下了物理一致性的隐患。
分子互作本质上是连续空间的物理过程。 范德华力、静电作用、氢键方向性都严格遵循量子力学约束。将连续几何离散化为Token序列,意味着键长、键角、二面角等关键物理量失去了显式约束。模型生成的分子结构可能在序列层面“语法正确”,但在3D空间中却存在原子碰撞或键长畸变。
这是效率与精度之间的根本性取舍。传统几何深度学习虽然计算昂贵,但通过等变神经网络天然保证了旋转平移不变性和物理对称性。LOGOS的纯序列路径虽然优雅,却需要模型在海量数据中隐式学习这些约束——当数据充分时,统计规律可能逼近物理规律;当数据稀疏时,物理谬误就会浮现。
这决定了LOGOS当前更适合作为高通量筛选的生成引擎,而非高精度物理模拟的替代品。其真正价值不在于取代第一性原理计算,而在于用极低的计算成本,快速缩小搜索空间,为精细计算提供候选方向。
四、开源阳谋:重构AI驱动科研的“通用语言”底座
4.1 完整开源倒逼行业告别“一任务一专家模型”的碎片化
AI for Science领域长期陷入一种昂贵的碎片化:蛋白质结构预测用AlphaFold,分子生成换另一个模型,材料设计再切一套系统。每个环节都需要独立训练、独立维护、独立优化,团队之间“鸡犬之声相闻,老死不相往来”。
这种模式的致命缺陷不在于成本,而在于知识无法跨任务流动。一个精通蛋白质折叠的模型,面对小分子生成时完全是“门外汉”——因为它们的底层表征语言就不互通。
LOGOS的完整开源——模型权重、推理代码、技术报告全部公开——本质上是在搭建一个可复用的基础设施层。当蛋白质、小分子、化学反应、MOF材料被统一编码进同一套科学语法体系,下游研究者不需要从零开始训练专有模型,只需在LOGOS底座上进行轻量适配。
开源不只是技术选择,更是一种生态战略:用统一语法降低准入门槛,用开放权重加速迭代速度。
对中小型科研团队而言,这意味着可以用更少算力、更短周期进入前沿研究。预训练与下游目标天然对齐,无需大量微调即可激活生成能力。这不是简单的“开放代码”,而是用一套通用语言瓦解了碎片化的根基。
4.2 竞争格局重塑:当科学模型开始拼写通用语言,护城河何在
微软NatureLM的56倍参数量被反超,已经给出部分答案。传统模式下,堆参数、堆专家、堆特定模块是构建竞争力的主要手段。但LOGOS证明,通过科学语法实现的形式-目标对齐,可以带来质变的参数效率——竞争重心正在从“谁能设计更复杂的专用架构”转向“谁能定义更通用的科学语言”。
但这里存在一个值得警惕的维度。统一语法虽然消除了异构对象间的“鸡同鸭讲”,却也带来了知识产权的重新定义问题。当蛋白质序列和小分子结构能在同一生成空间被自由“翻译”,传统基于数据壁垒建立的护城河可能被瓦解。开源加速了这一进程——阿里选择公开完整技术栈,既是在构建生态引力,也是在逼迫行业重新思考:未来的竞争力究竟建立在什么之上?
答案指向两个方向:一是对特定科学领域的深度理解,通用模型仍需领域知识指导其生成方向;二是对统一语法体系本身的持续迭代能力。谁能定义下一个版本的“科学通用语言”,谁就掌握话语权。这场开源阳谋,正在把AI for Science拖入一个护城河随时可能被重写的竞争维度。