ICLR 2026新方案ViF:终结多智能体“以讹传讹”的视觉幻觉滚雪球
ICLR 2026新方案ViF:终结多智能体“以讹传讹”的视觉幻觉滚雪球
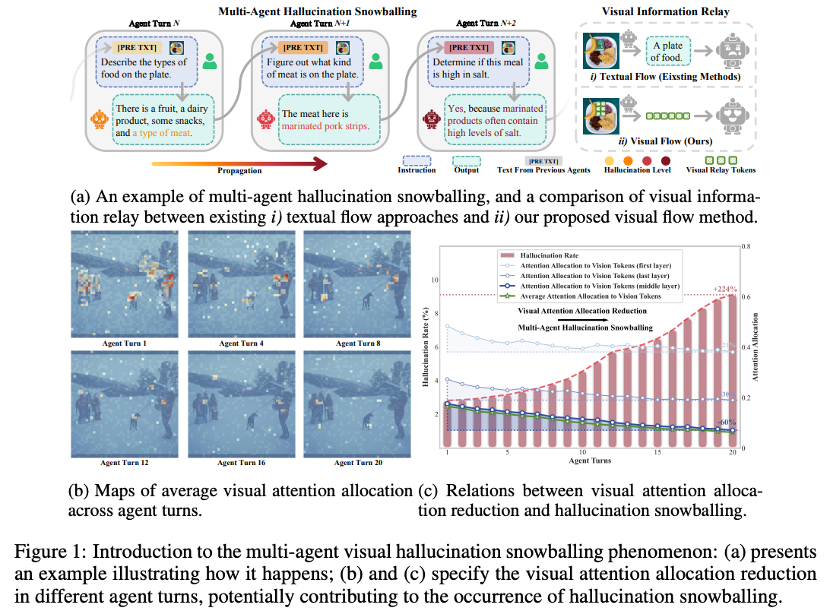
多智能体协同做视觉任务,常常出现一个诡异的现象:模型能力明明不差,但轮次越多,错得越离谱。就像一个传话游戏,第一个人说“桌上有个苹果”,传到第十个人变成了“桌上有只企鹅”——根源不在谁听力不好,而在于传话的方式本身就有缺陷。
当前VLM多智能体协作全程依赖文本流传递视觉信息,这一设计存在两个无法规避的硬伤。
第一层是“内在幻觉”:单个智能体自身就会生成与图像不符的错误视觉描述。这并非模型故意撒谎,而是视觉-文本转换天然存在信息损耗——画面里的光影、遮挡、模糊边缘,转成文字后必然丢失细节,甚至被模型“脑补”出不存在的东西。
第二层更致命,叫“幻觉传播”:后续智能体过度依赖前置文本,将早期错误当作先验知识。第一个智能体看错了物体颜色,第二个基于错误颜色做推理,第三个再叠加新的误判——视觉-文本转换的损耗与偏差被逐级放大,形成典型的“滚雪球”效应。
此前几乎所有优化方案都只聚焦“单智能体幻觉抑制”,试图让每个个体看得更准。但问题在于,即便单个智能体的幻觉率降到了极低,跨智能体的错误传播链路依然完整存在。长轮次协作中,模型性能被“滚雪球”越拖越垮,最终可能导致无法胜任复杂视觉任务。
研究团队从轮次、层级、令牌三个维度做了深度注意力拆解,首次系统性地锁定了幻觉滚雪球的本质机制。
数据令人警醒:随智能体轮次增加,视觉令牌的平均注意力分配在第20轮暴跌62%,中层视觉注意力的峰值直接消失。这意味着随着协作深入,模型越来越不“看”图像,而是依赖前文文本做判断。
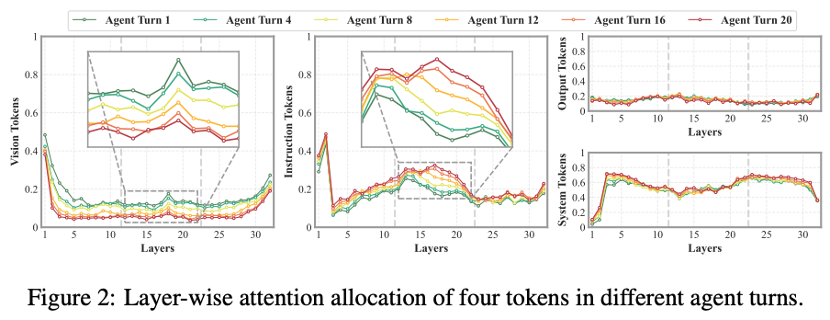
更关键的是中层单峰注意力视觉令牌的退化。这类令牌是保存原生视觉证据的核心载体,对视觉理解起决定性作用——它们占比从首轮的1.22%骤降至第20轮的0.10%。换句话说,到协作后期,视觉信息几乎被文本信息完全压制,模型本质上是在“盲猜”。
不是模型不够聪明,而是它越来越“懒得看”原始图像。
这些发现揭示了一个残酷真相:纯文本流本质上是一套鼓励“以讹传讹”的机制。文本一旦生成就具有了权威性,后续智能体会默认前置输出是可靠的,而原始视觉证据反而被边缘化。要阻断滚雪球,必须从信息流的底层重构入手——这正是ViF方案的切入点。
ViF的破局之道:用“视觉流+注意力重分配”重构信息传递
既然问题根源在于纯文本流不可避免地造成视觉证据丢失,ViF的设计逻辑就非常直接——让原生视觉信号绕过文本转换,直接在智能体间传递。
视觉中继流与分层注意力重分配:让视觉信号贯穿长轮次协作
ViF的核心设计包含两个互相咬合的机制。
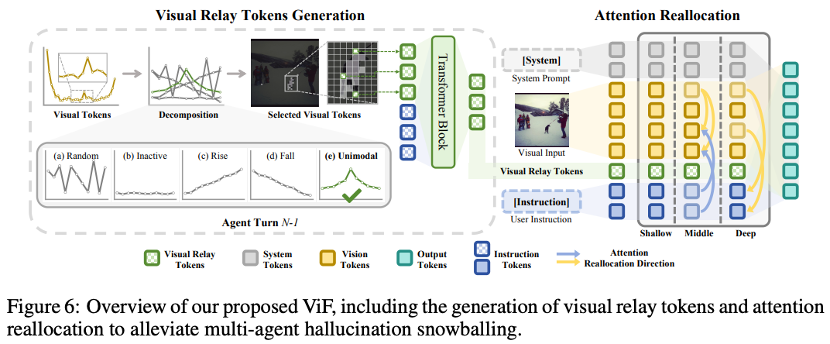
视觉中继流负责筛选和传递视觉证据。研究团队发现,中层单峰视觉令牌是保存原生视觉信息的核心载体,但这类令牌在首轮协作中占比仅1.22%,到第20轮骤降至0.10%——视觉信息被文本彻底压制。
ViF的做法是精准筛选这些中层单峰视觉令牌,结合指令做轻量化上下文编码后,直接传递给下游智能体。这意味着后续智能体看到的不是“前人用文字描述的图像”,而是经过编码的原生视觉证据本身,从根源上切断了“视觉→文本”转换带来的信息损耗。
分层注意力重分配则解决了视觉信号在长轮次中衰减的问题。中间层放大关键视觉令牌的注意力权重,同时回收无效注意力;深层优化注意力分布,确保视觉信号持续贯穿整个协作链路。
传统方案只从单智能体出发抑制幻觉,ViF从底层切断了跨智能体的错误传播路径。
模型无关与工程兼容:无需改造基座模型,即插即用
一个容易被忽视的工程亮点是,ViF并不要求修改VLM本身的结构或重新训练模型。
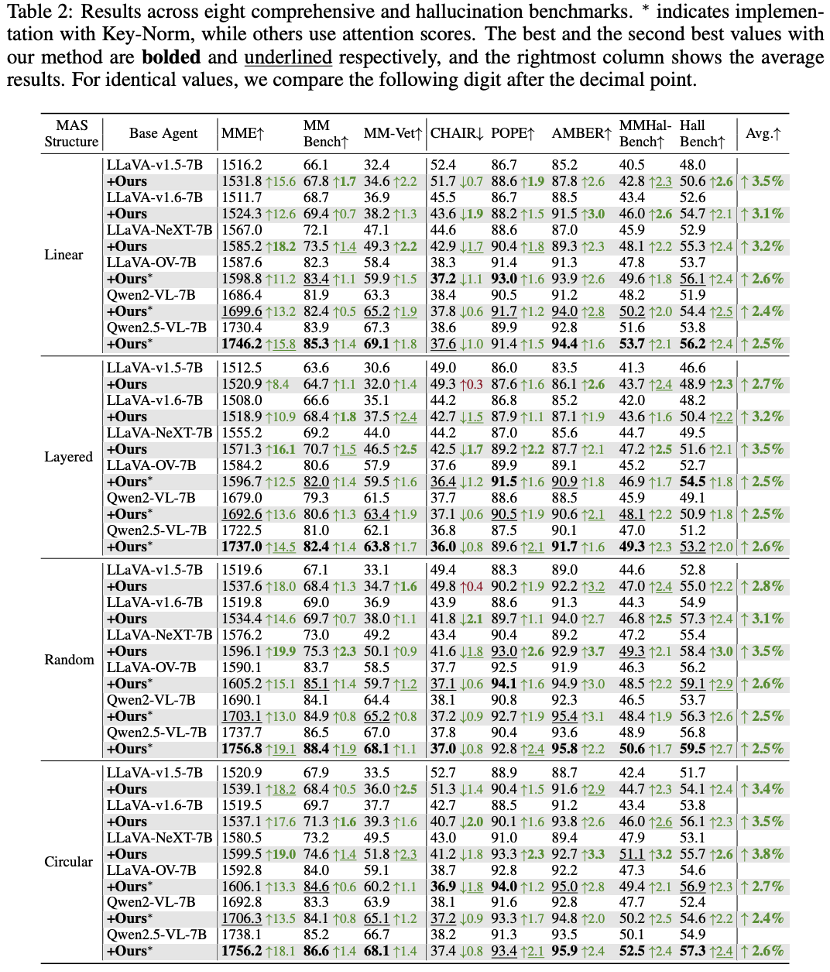
它本质上是一套轻量级的视觉传递范式,可以无缝适配LLaVA、Qwen2-VL、Qwen2.5-VL等10款主流VLM,覆盖线性、分层、随机、环形4种多智能体结构。
针对现代模型普遍使用的FlashAttention 2/3(无法直接获取注意力分数),团队设计了Key-Norm替代策略——用键向量的范数近似注意力权重,兼顾了计算效率与落地兼容性。
这种“模型无关”的设计意味着,研究者不需要为不同基座模型定制不同方案,也不需要承担重新训练大模型的高昂成本。即插即用的特性,让ViF从实验室到实际部署的路径大幅缩短。
实测效果与代价:幻觉滚雪球降近40%,大模型增益更显著
任何方案最终都要用数据说话。ViF的论文在8大综合与幻觉基准、4种MAS结构、10款主流VLM上做了全覆盖测试,平均性能提升2.4%到3.8%。
单看这个数字似乎不够惊艳,但放到多智能体场景里就值得深究了——传统单智能体幻觉抑制方案管得住单个模型的“嘴”,却管不住智能体之间的“传话”。ViF是直接从信息流底层切断错误传播路径,这比事后纠错高了一个维度。
8大基准全面领先:环形结构幻觉降幅最高,34B以上模型提升超4%
论文专门定义了一个幻觉滚雪球分数(HS)来量化多轮协作中的错误累积程度。ViF介入后,所有MAS结构下HS平均下降超过30%。
结构差异的数据更值得关注。交互最密集的环形结构中,HS降幅逼近40%,远超其他结构。这背后的逻辑很清晰——环形结构里每个智能体既接收前置信息、又向后置传递,纯文本流下的错误放大效应最严重,ViF的视觉流替代正好打在最痛的地方。
关键发现:错误传播最严重的结构,恰恰是ViF收益最大的结构。
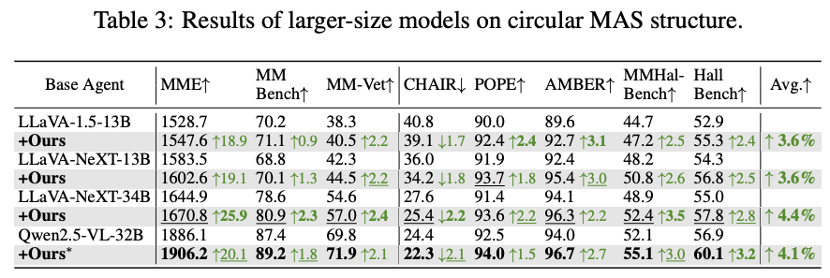
另一个被很多人忽略的发现是模型规模带来的增益分化。34B/32B级别的大参数模型使用ViF后,性能提升超过4%,显著高于小模型。大模型本身的视觉理解能力更强,但纯文本流让这些能力在传递中被白白浪费——ViF相当于把大模型被封印的视觉潜力释放了出来。
效率与开销:推理延迟仅增8.1%,大模型下开销几乎可忽略
任何“即插即用”的方案,都得回答一个现实问题:代价有多大?
ViF交出的答案是:推理延迟增加8.1%到13.4%,计算开销增加4.8%到11.9%。对于动辄几十轮的多智能体协作流程,这个增量完全在可接受范围内。
更关键的趋势是,模型越大,相对开销越小。大模型本身的推理成本基数高,ViF轻量级视觉中继流和注意力重分配模块带来的额外计算,在总成本占比中被持续稀释。这与“大模型增益更显著”形成了双重合力——大模型用ViF,效果好、代价低,性价比反而最高。
这背后的性价比逻辑不是“花小钱办大事”,而是**“花更少的代价,解锁更大的模型潜力”**——或许这才是ViF在产业落地中最具说服力的卖点。
争议与边界:ViF是终极解药,还是长轮次协作的起点?
ViF将多智能体协作从“越做越错”的泥潭中拉了出来,但它并非万能灵药。一个核心争议在于:它解决的究竟是“看见”的问题,还是“理解”的问题? 答案更偏向于前者,而这恰恰暴露了它的能力边界。
从“看见”到“理解”的鸿沟:视觉流能否应对更复杂的推理退化?
ViF的核心机制是通过视觉中继流直接传递原生视觉证据,避免文本转换的信息损耗。这在物体识别、文字读取等感知驱动型任务上效果显著。但当任务涉及复杂推理时,情况就变得微妙起来。
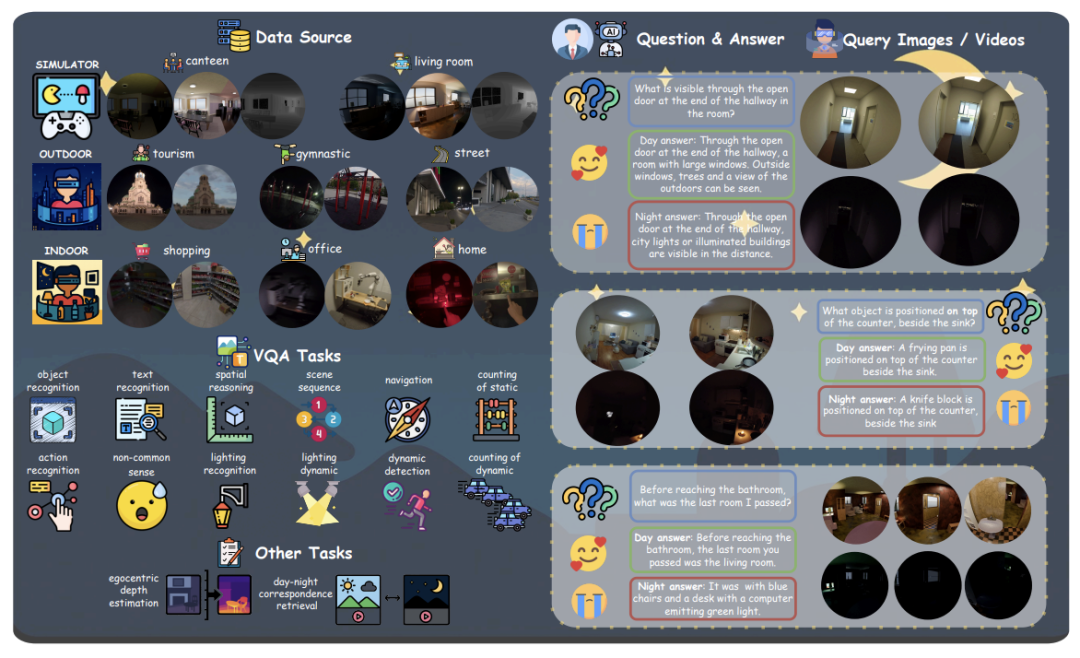
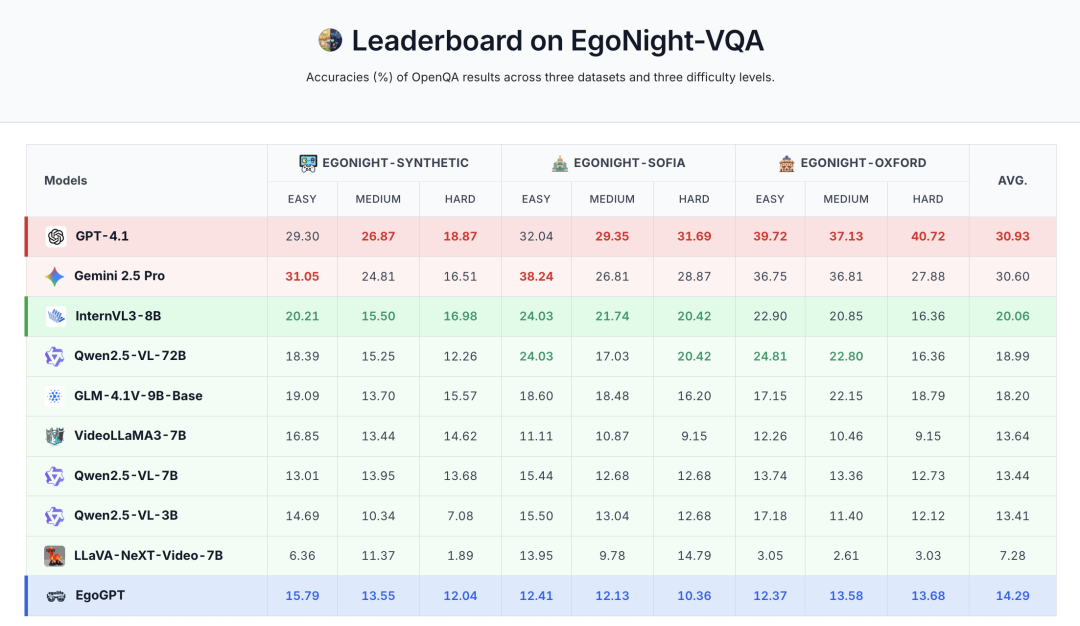
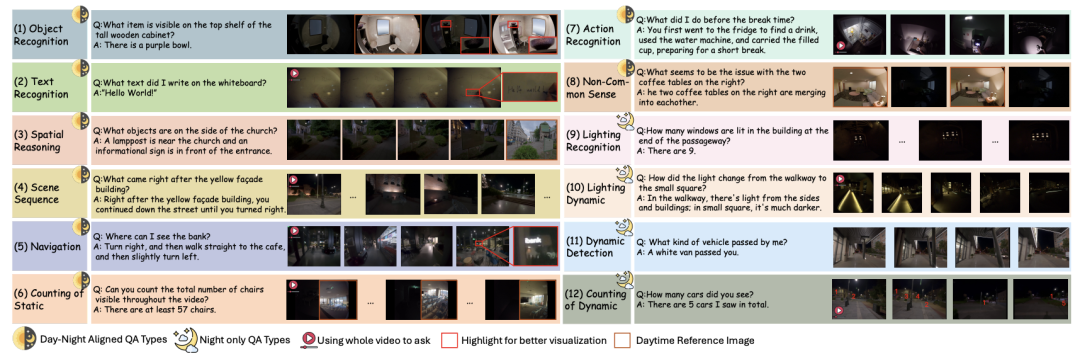
根据EgoNight等基准测试,多模态模型从白天场景迁移到夜晚时,感知驱动任务的性能跌幅通常远超推理导向任务。这意味着,即便ViF保证了智能体“看见”了正确的像素,也无法直接保证它能“理解”这些像素背后的逻辑关系。
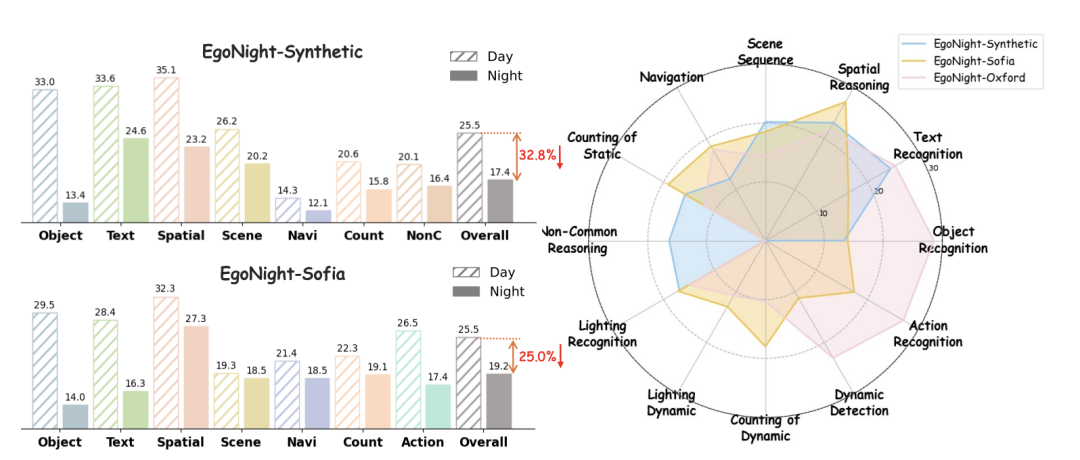
视觉流传递的是一张清晰的“照片”,但智能体如何解读这张照片——尤其是在光照、遮挡等条件变化下——仍然依赖于模型自身的推理能力。
更深层的问题随之浮现:当视觉信号本身就不稳定时,单纯传递原生证据是否足够? 在夜间第一人称视觉场景中,昏暗、反光和运动模糊会同时改变目标可见性与纹理细节。ViF的视觉流能确保后续智能体看到的是未经文本“污染”的模糊画面,但这幅模糊画面本身,就可能让所有智能体的推理同时卡壳。
视觉幻觉被压制了,但“理解幻觉”依然存在。
ViF让信息传递更可靠,却无法替代模型去理解复杂环境。
合成数据与极端场景:ViF范式在夜间等条件下的迁移潜力与局限
ViF的“即插即用”特性让它理论上可以快速迁移到各种极端场景,但实际效果高度依赖视觉中继令牌的筛选质量。
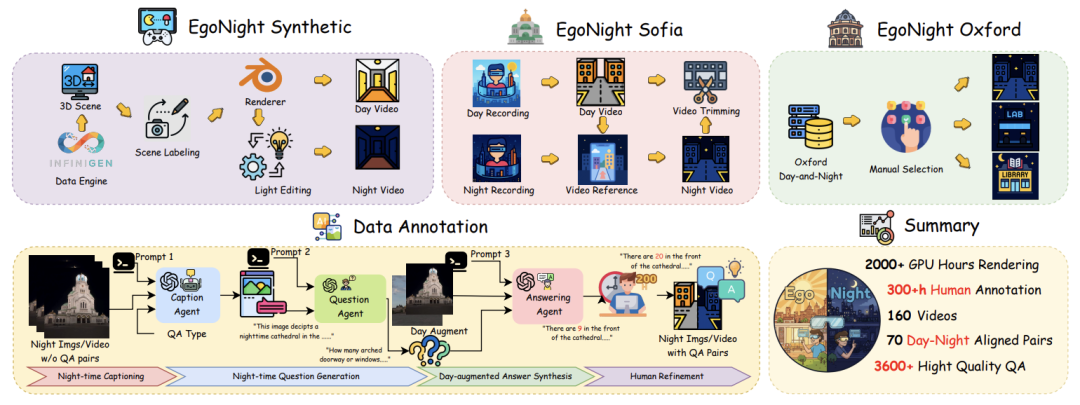
在正常光照下,中层单峰视觉令牌是保存原生视觉证据的可靠载体。但在夜间或合成数据场景中,这些关键令牌的分布和可靠性可能发生剧烈变化。一个可供参照的案例是EgoNight的合成数据实验:用合成夜间数据训练的模型,确实能迁移到真实夜间场景。这暗示着,如果能针对特定极端场景微调ViF的令牌筛选策略,其范式完全具备迁移潜力。
但局限同样明显:在视觉信号极度稀疏的条件下,中层单峰视觉令牌本身就可能接近消失。
研究显示,纯文本流模式下,关键视觉令牌占比从首轮的1.22%骤降至第20轮的0.10%。如果初始视觉质量就极差,ViF筛选出的“最佳令牌”也可能携带大量噪声,此时视觉流的增益会被大幅稀释。它把“传话游戏”变成了“传照片”,但如何让所有智能体都真正看懂这张照片,仍是下一个需要攻克的战场。