70万次笔触与砍半的Token:我们测评Agent时,真正该看什么
Claude用70万次笔触画画、开发者用550美元做出FPS游戏,表面是模型能力飙升,实际暴露的是测评范式错位:单点跑分无法回答“它能不能稳定完成一项长程任务”。本文拆解笔触数为何是成本信号而非能力指标、模拟基准高分为何不等于实机可用,并给出真正值得测评的三个变量:工具编排、状态管理、成本控制。
70万次笔触与砍半的Token:我们测评Agent时,真正该看什么
70万次笔触不是能力证明,而是成本账单
为什么“笔触数”这个指标本身就在误导
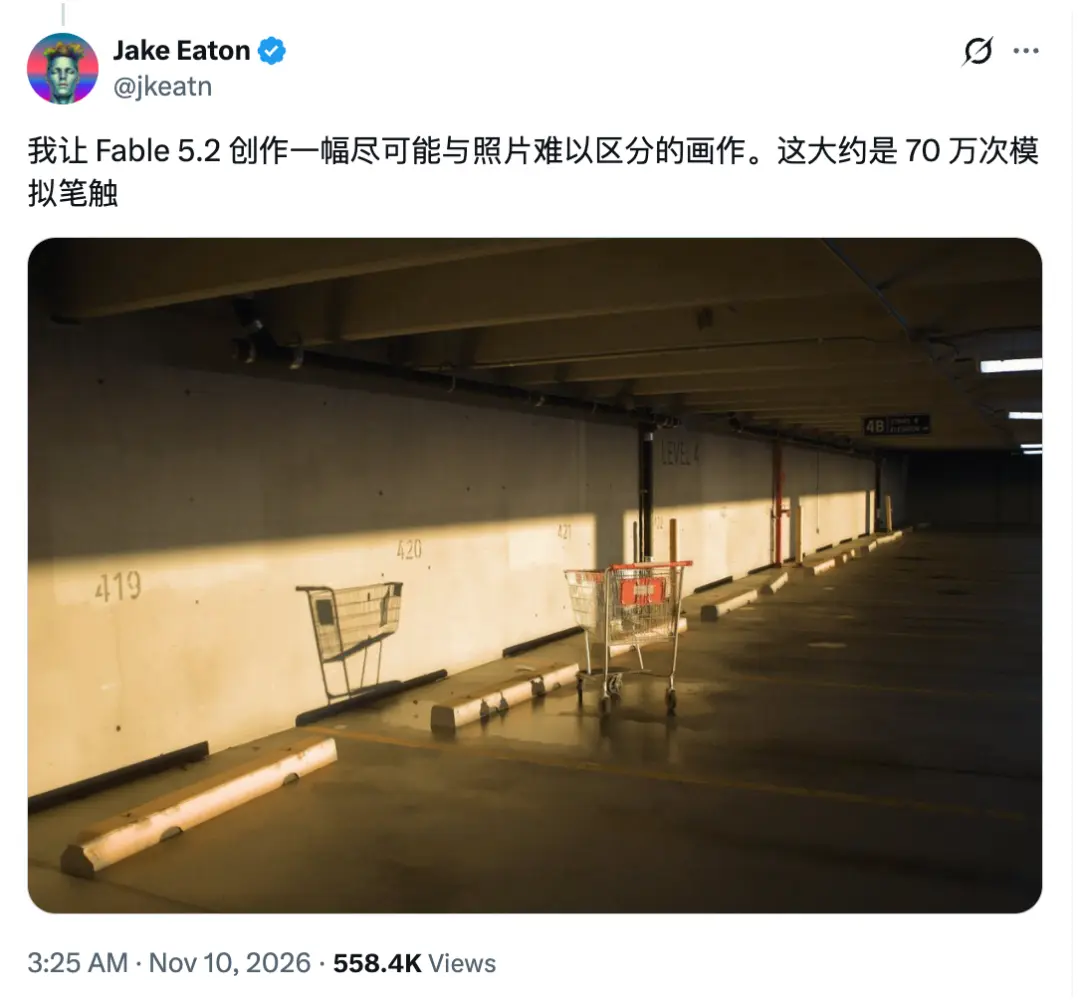
70万次笔触这个数字,最容易被读成能力证明。但它的真正含义在成本侧:Claude Fable 5.2 的作画方式不是扩散模型式的去噪生成,而是先写出1000至2000行Python程序,再让程序在虚拟画布上执行一笔笔坐标指令。所谓笔触,本质上是模型生成的代码在运行时产生的执行步骤。笔触越多,意味着代码越长、生成时的token消耗越大、运行时的算力开销越高。
这条传导链在传统模型测评中几乎不被触及。标准跑分回答的问题是“这张图像不像照片”,而不是“生成这张图要写多少代码、花多少token、跑多久”。前者是质量指标,后者是成本指标。70万次笔触恰恰把后者推到了台前:一个单张图片的生成任务,消耗了足以让传统文生图模型完成数十次推理的资源量级。Anthropic员工Jake Eaton展示的同一系列作品中,另有111笔完成的日出之鸟和280笔的黄昏双人场景,说明笔触数并非固定值,而是随任务复杂度剧烈变化。
把笔触数当成“画得精细”的证据,是测评框架的错位。精细度可以用分辨率、细节保留度或人眼评估来衡量,不需要通过执行步骤数来间接证明。笔触数真正能告诉我们的,是这个任务在长程执行中积累了多少状态、产生了多少中间步骤、最终转化为多少可计量的资源消耗。
从“能不能画”到“画完要花多少钱”
单点能力测评的隐含假设是:只要模型能完成某个任务,成本就是次要的。但Agent场景下的长程任务恰恰不满足这个假设。一个需要70万次笔触才能完成的绘画任务,如果放进批量生产流程,成本会线性放大;如果放进实时交互场景,延迟可能直接让产品不可用。
有来源在总结Fable 5.2的能力边界时明确指出,70万笔意味着可观的代码量与token、算力开销,且实体机械臂的精细动作仍有短板,部分任务的速度与稳定性不及对手。这并非否定模型能力,而是把讨论拉回工程现实:演示性突破可以容忍高成本,工作流级应用不能。
反过来说,如果任务本身对成本不敏感——比如一次性艺术创作,创作者愿意为一张图等待更长时间、支付更高费用——那么笔触数就不构成问题。成本敏感型场景才是这个指标真正重要的地方:批量生成、自动化流水线、需要频繁迭代的设计工作。在这些场景里,测评者必须从“能不能画”转向“画完要花多少钱”,否则跑分再漂亮也无法指导实际部署。
笔触数因此不该被理解为能力标签,而应被看作成本信号。它暴露的是长程生成任务的真实资源结构——这正是传统单点跑分测不出来的东西。
模拟基准的64.9%与实机测试的差距,才是测评的真相
RoboDojo Sim高分为何没能转化为实机优势
RoboDojo Sim基准中64.9%对29.8%的得分差,指向的是模拟环境与物理世界之间一条不易跨越的鸿沟。多个来源都记录了同一组数字:在Anthropic内部的双臂模拟基准上,Claude Fable 5.2控制机械臂画《星月夜》得分为64.9%,GPT-6 Astra为29.8%。但同一批测试的实机环节给出了相反方向的信号。研究人员Aris Zhu分享的实验记录显示,Fable 5.2在精细动作控制上仍有不足,GPT-6 Astra绘画速度更快;截至目前,只有OpenAI的模型成功让一枚多米诺骨牌竖直站立。
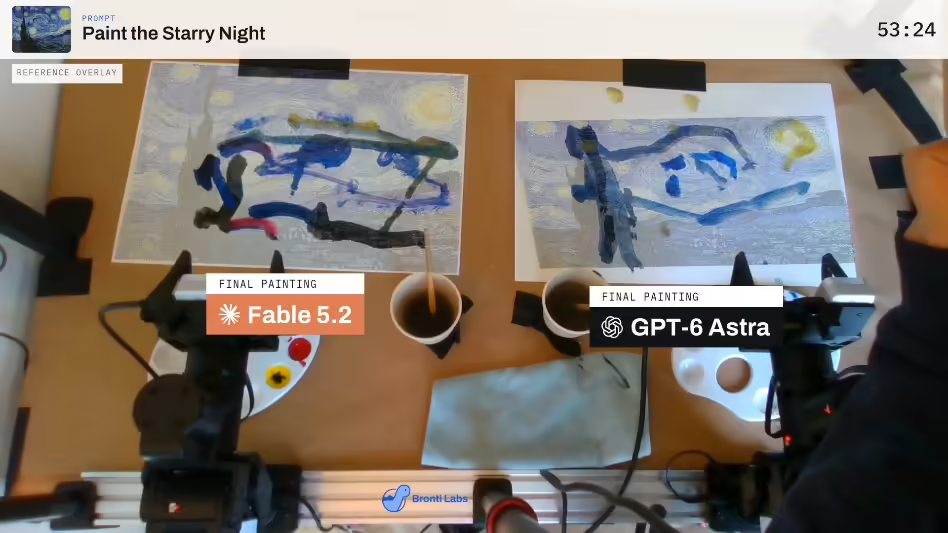
这个反差不是偶然的。模拟环境简化了物理约束和状态干扰:机械臂的惯性、关节摩擦、视觉反馈延迟、材料接触时的微小形变,在模拟器中要么被抽象掉,要么被理想化。模型在模拟中可以用大量试错换取高完成度,因为试错没有物理成本。实机测试则不同,每一次错误都意味着真实的时间消耗、设备磨损或任务失败。长程任务中,错误会累积。前一步的微小偏差进入下一步后可能被放大,最终导致整条动作链断裂。模拟高分测出的,是模型在无摩擦环境里的规划能力;实机测试暴露的,是它在有摩擦环境里的状态管理能力。
测评者需要区分“演示性突破”与“工作流级可靠性”
两者之间的落差,正是Agent测评范式转变的核心证据。单点跑分的逻辑是:给定一个标准任务,看模型能否完成。但长程任务的逻辑不同:模型需要在几十甚至上百个步骤中持续做出正确决策,任何一个步骤的失败都可能使整个任务归零。模拟基准能回答“模型是否具备完成该任务的基本规划能力”,却无法回答“模型在真实环境中能否稳定地重复完成该任务”。
这不是说模拟基准没有价值。它能在早期快速筛掉完全不可用的模型,成本远低于实机测试。但高分不能反向证明实机可用。测评者必须同时看两类数据:模拟得分用于判断能力下限,实机表现用于判断部署上限。把模拟基准的64.9%当作“能力超过对手两倍多”的证据,恰恰混淆了这两件事。
对测评者而言,真正的分界线不在“能不能完成一次”,而在“跨步骤、跨环境能否保持稳定”。一个模型可以在演示视频里画出一辆购物车,但如果换一个机械臂型号、换一种光照条件、把任务从单次创作改为连续十次执行,其表现是否还能维持?这才是工作流级可靠性的含义。演示性突破可以容忍高失败率,因为只需要成功一次;工作流级应用不能,因为失败一次就意味着流程中断。
模拟-实机鸿沟因此不该被理解为“模拟数据造假”,而应被理解为测评对象发生了位移:从单次任务完成度,转向跨步骤、跨环境的稳定性。这个位移决定了后续所有测评维度的优先级——工具编排、状态管理、成本控制,都是在稳定性这一前提之下才获得意义。
真正该测的三个变量:工具编排、状态管理、成本控制
工具编排:模型能否在正确的时间调用正确的工具
工具编排测的不是“模型会不会用某个工具”,而是它在多步任务中能否按正确顺序选择正确工具,并在工具失败时切换策略。openPangu-2.1-Pro 的升级方向提供了一个参照:官方称其基于 10 万余条专项数据优化了 Skills 触发、工具选择与调用能力,目标直指复杂任务的规划和执行。这说明厂商已经开始把“工具编排”当作一个独立的优化对象,而不是模型能力的附属品。
但编排能力的测评不能只看模型是否调用了工具,还要看调用的时机和组合。一个编码 Agent 如果该读文件时先改代码,该跑测试时先提交,单步能力再强也会把任务带偏。少数派作者同时运行 Claude Code、Codex 和 Kimi Code 时,靠像素时钟的灯色判断各自状态——蓝灯运行、绿灯完成、红灯出错——这其实是一种粗粒度的编排监控:它不衡量单次工具调用的质量,只暴露 Agent 是否在正确的阶段做正确的事。
状态管理:长任务中的错误累积与自我纠偏
长程任务最容易被单点测评忽略的,是错误如何随时间累积。一个模型在单轮问答中答对率很高,不代表它在三十轮连续修改后还能保持同样的判断质量。少数派作者在 Kimi Code 执行窗口里来回改了三十多轮,每一轮都要读代码、改代码、在真机上测试。这个“三十多轮”本身就是状态管理的压力测试:模型必须持续记住此前改了什么、为什么改、哪些部分已经验证过,否则就会在后续轮次中引入新错误或推翻旧修复。
状态管理的核心指标不是“是否出错”,而是“出错后能否回到正轨”。Anthropic 对 Fable 5.2 的描述——可协调子智能体反复验证——指向的正是这一点。反复验证意味着模型不仅执行任务,还对中间结果做交叉检查。社区案例中,@Tech Friend AJ 用 Fable 5.2 写了 4800 行 Python 代码调用 Blender API 完成 3D 场景、动画和渲染,@camperaigg 用 Three.js 写了 2000 行代码耗时 83 分钟制作动画视频。这些案例的看点不在于代码总量,而在于长代码生成过程中没有因状态丢失而崩溃。但必须注意,这类社区案例只展示了成功样本,失败样本和重试次数未被记录,不能直接等同于稳定状态管理能力。
成本控制:Token砍半与550美元FPS背后的经济学
成本控制是工作流级可靠性中最容易被情绪化讨论的变量。openPangu-2.1-Pro 的定价——推理输入 0.8 元/百万 tokens,输出 3.2 元/百万 tokens,缓存命中输入 0.016 元/百万 tokens——给出了一种成本结构的参考:缓存命中价格远低于首次计算,意味着重复调用相同上下文时成本可以大幅下降。这对 Agent 场景尤其重要,因为长程任务天然包含大量重复读取的上下文。
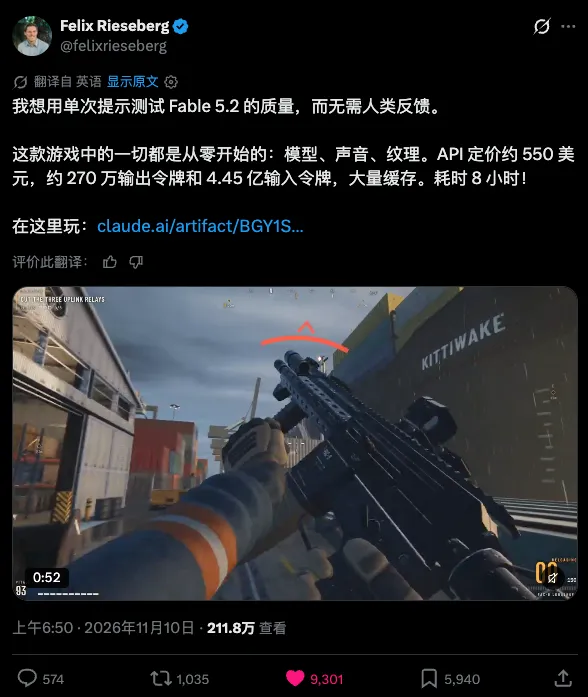
另一个极端是那个 550 美元、8 小时跑出来的 FPS 游戏。这个数字看起来便宜,但来源只转述了 X 用户 felixrieseberg 的案例,未说明 550 美元是否包含全部算力、人工介入或重试成本。把它当作“Agent 成本已经低到可以忽略”的证据是不成立的。恰恰相反,它暴露了成本测评的难点:真正的成本不是单次 API 账单,而是完成一个可用成果所消耗的全部资源,包括失败重试、人工修复和等待时间。
三个变量之间存在先后关系:工具编排决定任务能否启动和推进,状态管理决定任务能否在错误累积中存活,成本控制决定任务在经济上是否可行。三者共同构成工作流级可靠性的必要条件。但这不是一个普适框架。对于短平快的单次生成任务,传统质量评分仍然有效;只有当任务链条足够长、工具调用足够多时,这三个变量才成为决定性因素。测评者需要先判断任务类型,再选择对应框架,而不是用一套标准覆盖所有场景。
对普通用户而言,测评的终点是“它能不能替你扛住长任务”
从“看热闹”到“看门道”:如何判断一个Agent是否值得投入
普通用户判断一个 Agent 是否值得投入,最终标准只有一条:它能否在可接受的成本内,稳定地完成你交给它的长程任务,而不是它在某个演示里有多惊艳。这个判断听起来朴素,但它要求一次认知上的转变——从“它能做什么”转向“它能替我扛住什么”。单次惊艳几乎每个主流模型都能做到,持续可用才是分水岭。
落到操作层面,有三个观察点可以直接使用。第一,看工具调用频率是否合理。一个 Agent 在长任务中反复调用同一工具、频繁读取相同上下文,往往意味着编排逻辑粗糙。少数派作者在 Kimi Code 里修改三十多轮才完成一个时钟改造项目,每一轮都要重新读代码、改代码、真机测试。这个轮次本身不构成失败,但它说明:如果任务再复杂一些,编排效率的差距会迅速放大。第二,看错误恢复能力。真正值得投入的 Agent 不是不犯错,而是出错后能否自行回到正轨,而不是把烂摊子交还给用户。第三,算单位任务成本。不要只看单次 API 账单,要把失败重试、人工修复和等待时间全部计入。华为云 openPangu-2.1-Pro 的缓存命中输入价格仅为 0.016 元/百万 tokens,远低于常规输入的 0.8 元,这种定价结构本身就是为长程、重复调用场景设计的——它暗示了成本控制的真实战场在哪里。
这个标准并非放之四海皆准。对于探索性、一次性的创意任务,稳定性和成本可能不是首要考量。一个人愿意花 550 美元、等 8 小时让 Claude 生成一个 FPS 游戏,看重的是单次成果的冲击力;但若要把这个生成过程变成每天运行的工作流,550 美元的单次成本就完全不可接受。用户需要先明确自己的任务类型:是要一次惊艳,还是要持续产出。只有后者才适用上述判断框架。
FAQ:关于Agent测评的常见疑问
问:Agent 跑分高,是不是就代表它适合我的任务?
不完全是。跑分通常衡量的是单点能力,比如代码生成正确率、工具调用准确率。但长程任务中,单点能力只是起点。一个 Agent 可能每一步都做对,却因为上下文管理混乱而在第十步崩溃。跑分可以作为初筛,但不能替代工作流级测试。
问:工具调用次数越多越好吗?
恰恰相反。工具调用次数多可能意味着编排效率低。值得关注的是“有效工具调用”——每次调用是否推进了任务状态,而不是重复读取或无效尝试。少数派案例中的三十多轮修改,如果拆开看,很多轮次是在处理同一个问题的不同侧面,这暴露的是状态管理负担,而非能力不足。
问:成本到底该怎么算?
把完成一个可用成果所消耗的全部资源加总:API 费用、算力、人工介入时间、等待时间、失败重试成本。70 万次笔触的画作意味着可观的代码量、token 与算力开销,但单看笔触数没有意义,要看它对应的是什么样的任务类型。成本敏感型场景才需要严格核算;一次性创作可以放宽。
问:如果 Agent 在演示里很惊艳,但实际用起来不稳定,问题出在哪?
问题通常出在状态管理和环境依赖上。少数派时钟改造方案的最终效果依赖电脑程序持续运行,电脑关机或合盖休眠后时钟就不再更新,断电重启后自定义页面全部消失。这不是 Agent 能力问题,而是工作流设计问题。测评时必须区分“能力边界”和“部署条件”,后者往往才是普通用户实际遇到的障碍。
问:我该先测什么?
先测错误恢复。给 Agent 一个会中途出错的任务,观察它能否自行发现并修复,而不是直接中断或输出错误结果。错误恢复能力是长程任务存活率的直接指标,比任何单点跑分都更接近真实使用体验。