DeepSeek V4发布:万亿参数+原生多模态,开源王座再易主
DeepSeek V4发布:万亿参数+原生多模态,开源王座再易主
参数量不等于智能量,这是大模型领域一个残酷的“公开秘密”。很多千亿级模型在实际推理时,要么“思考十分钟才吐一个字”,要么面对复杂逻辑链直接“死机”。DeepSeek V4的万亿参数,会不会也掉进这种“规模不经济”的陷阱?
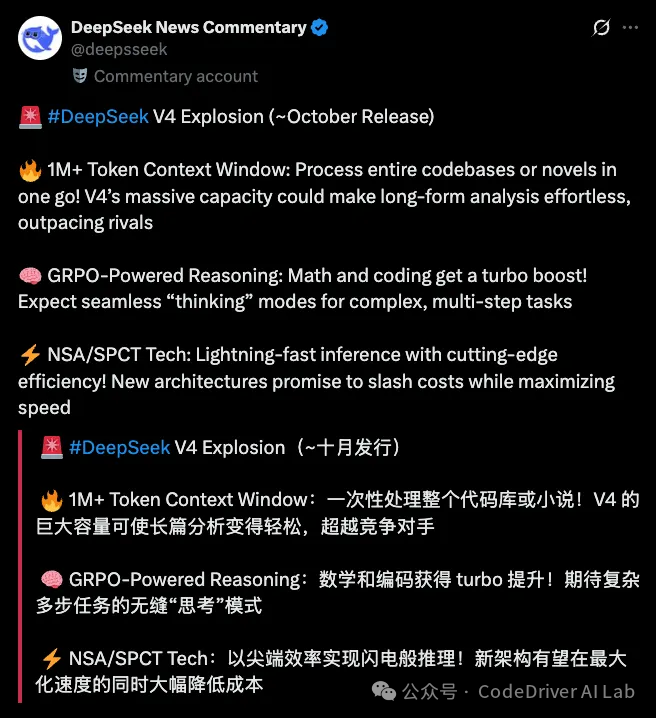
答案藏在架构里。DeepSeek V4最核心的变革,是告别了前代V3赖以成名的MoE(混合专家)架构,转向了传闻中的“MODEL1”新架构。传统MoE虽然通过“稀疏激活”降低了训练成本,但在推理时,参数调度如同“大锅饭”——总有一部分专家在“摸鱼”,计算资源浪费和延迟无法避免。

而V4的新架构,据爆料融合了稀疏与稠密混合推理模式。这相当于给万亿参数装上了智能交通调度系统:处理简单闲聊时,只唤醒少量核心参数,实现毫秒级响应;面对高难度数学证明或长链逻辑推理时,则动态组建“稠密专家团”协同攻坚。这种“按需分配”的机制,直击了大模型推理效率的痛点——既保留了万亿参数的深厚度,又避免了“杀鸡用牛刀”式的算力浪费。
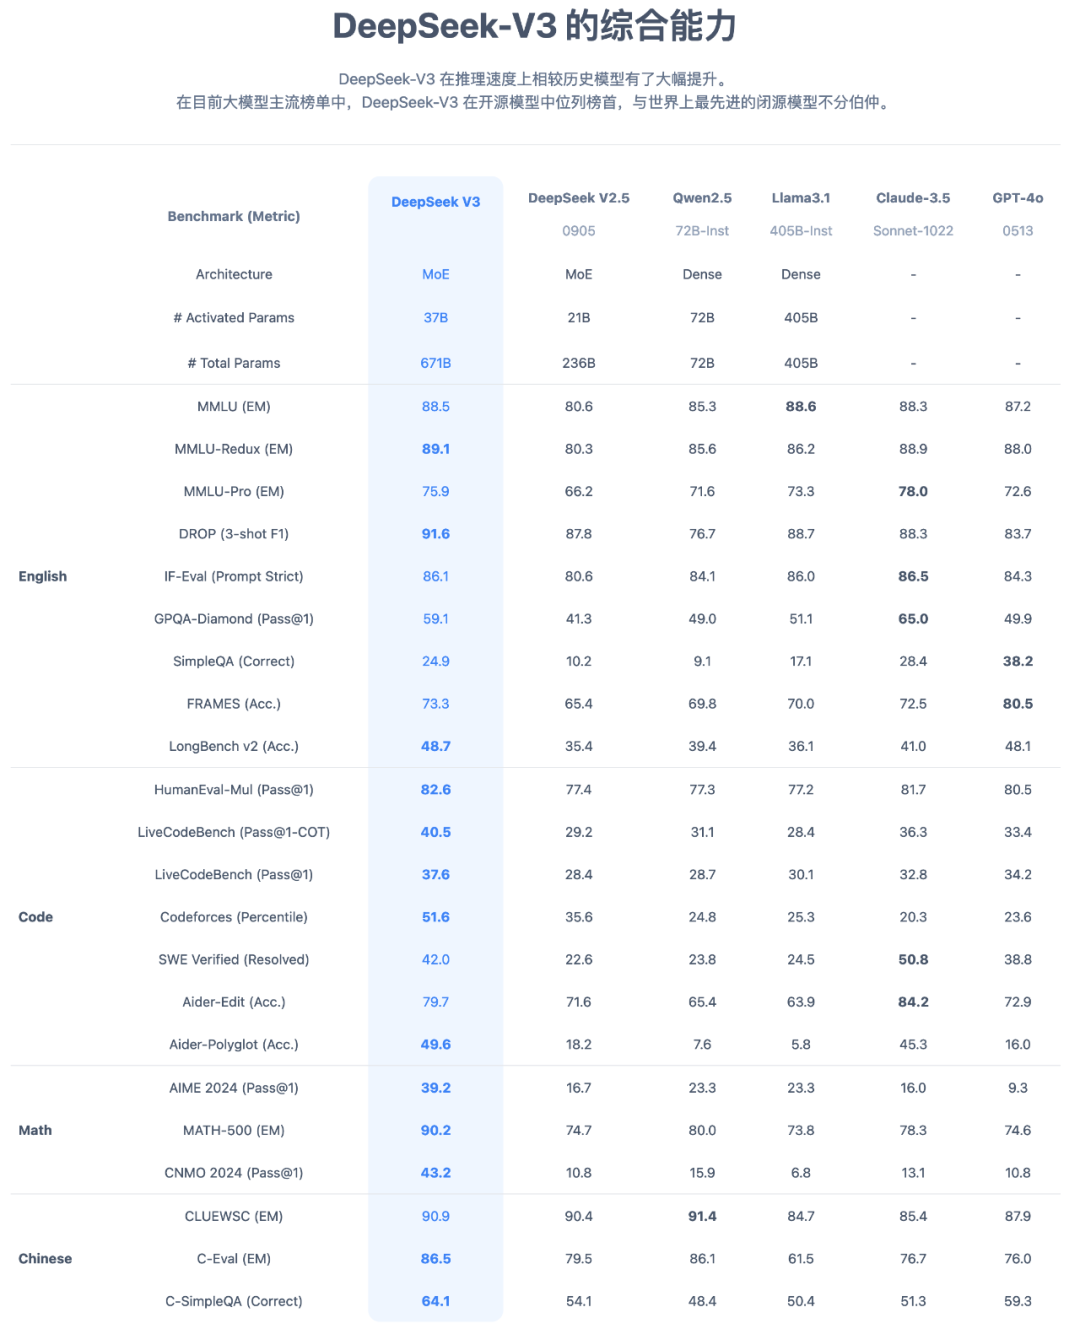
从DeepSeek在数学博士资格考试(88.4分)等复杂基准上的表现来看,这套新架构确实让参数真正“物尽其用”了。它不是靠蛮力堆砌,而是靠更聪明的调度逻辑,让每一份算力都花在刀刃上。
如果说新架构解决了“思考深度”,那么百万级Token上下文窗口,则解决了“记忆广度”的难题。过去处理几万字的论文或项目文档,得像切香肠一样分段投喂,AI经常读了后面忘前面,逻辑脱节是常态。这只能叫“可用”,远谈不上“好用”。
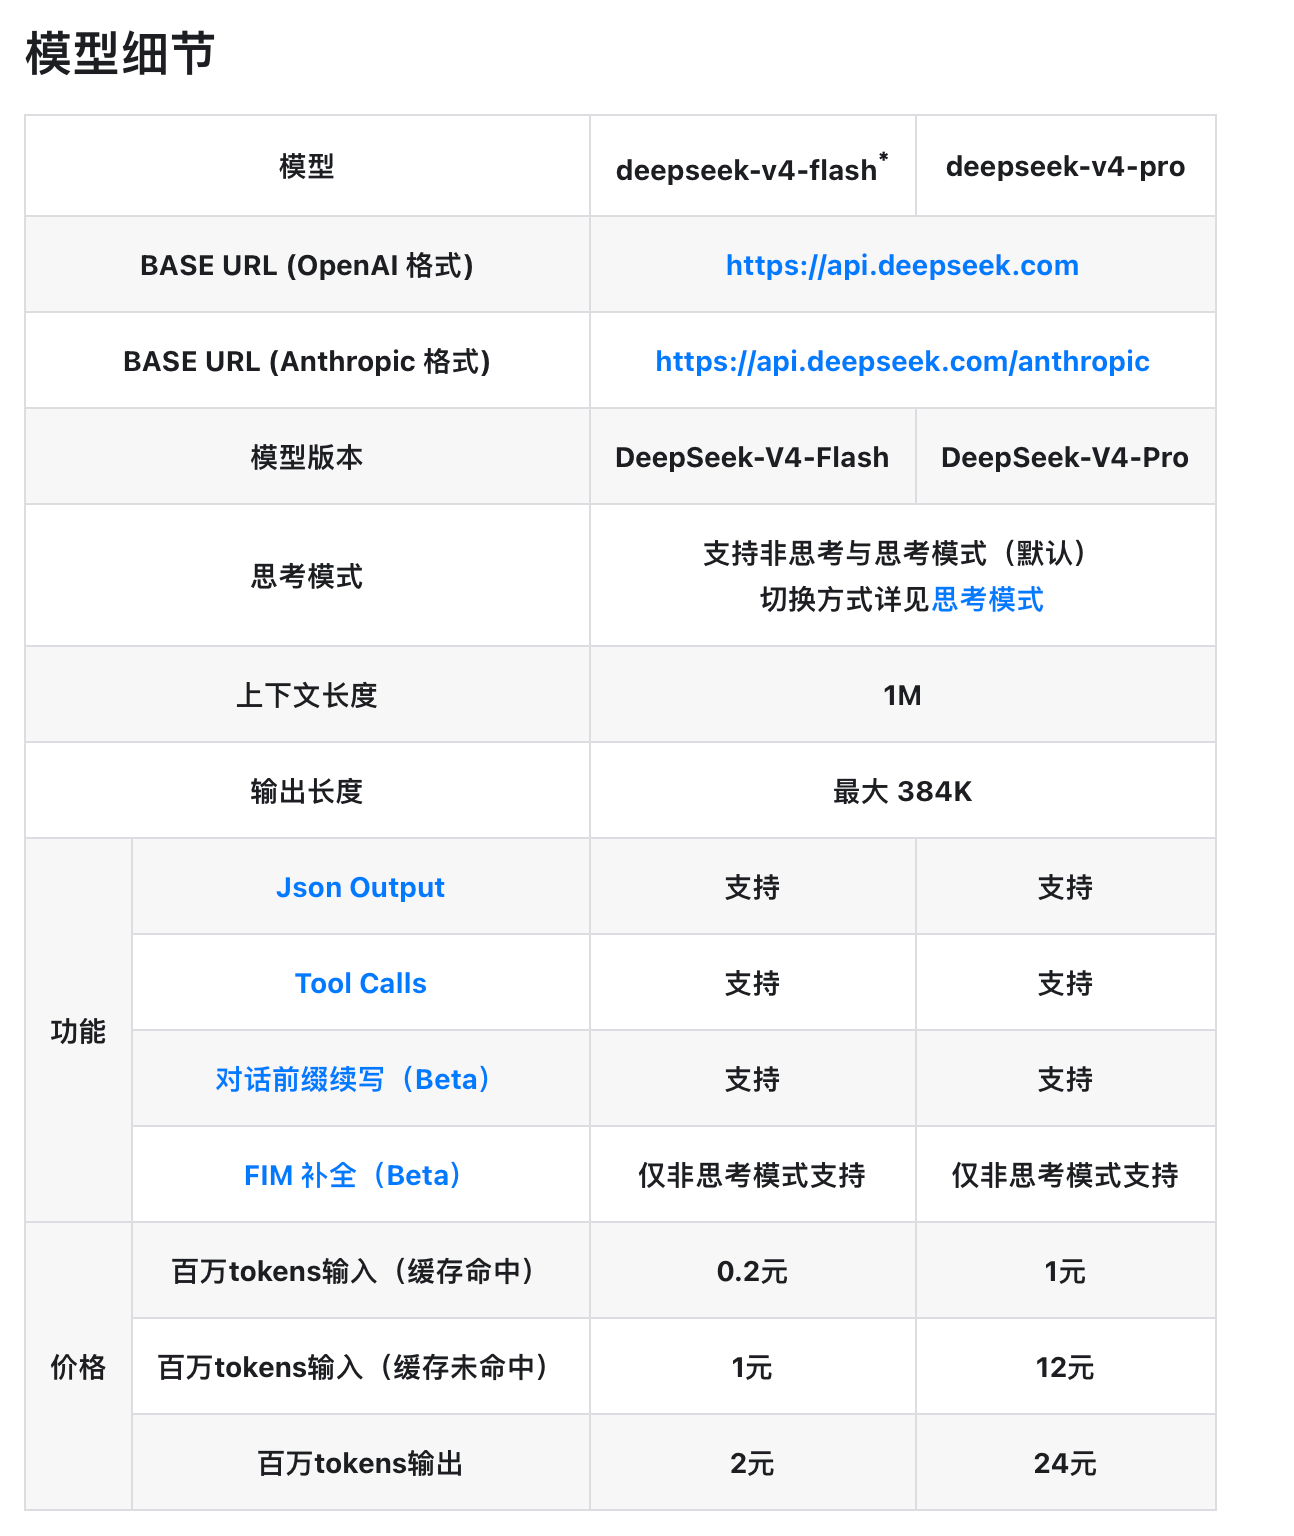
V4的百万字超长上下文,让AI第一次拥有了仓库级的记忆连贯性。你不再需要手动分块,可以直接把整本几十万字的书籍、整个项目的代码仓库或全量法律合同扔进去。结合DeepSeek创始人提出的“痕迹记忆”机制,模型能像人脑一样高效区分“长期记忆”与“短期运算”,在极长的上下文中精准锁定关键依赖。
这意味着AI辅助不再只是写写小作文,而是真正能帮你梳理长篇巨著、重构遗留系统的复杂逻辑。从“切香肠”到“整块吞”,这才是长文本处理该有的样子。当记忆不再断裂,推理才能连贯到底。
二、能力升维:原生多模态如何重塑创作与开发?
架构升级是V4的“内功”,那么多模态能力就是它伸向现实世界的“触手”。DeepSeek V4首次原生支持图像与视频生成,这标志着它不再只是一个处理文本的“对话大脑”,而是一个能理解并创造视觉内容的“多面手”。对于开发者和创作者而言,这意味着工作流将发生根本性重构——不是效率的提升,而是生产方式的彻底改变。
从文到图再到视频:一站式创作闭环的落地
DeepSeek V4的原生多模态能力,最直接的冲击是打破了“文生文”的单一格局。根据已上线信息,V4预览版可直接进行图像和视频生成,让自媒体博主、设计师和产品经理得以在一个模型内完成从脚本撰写到视觉素材产出的全流程。

核心价值在于上下文一致性。
过去用不同模型分别生成文案和配图,风格割裂是常态。你用GPT-4写文案,再用Midjourney生成配图,两者之间的理解是断裂的——模型A不知道模型B生成了什么,模型B也不理解模型A的创作意图。V4的原生整合意味着模型对创作意图的理解贯穿始终,生成的图文或视频在逻辑和风格上更加统一。
这背后是技术架构的根本转变。不同于在文本模型外“嫁接”图像模块,V4的多模态能力是预训练阶段就深度融合的。它不是“翻译”语言为图像,而是真正理解了视觉与文字之间的关联。对于需要快速产出高质量内容的自媒体和营销团队来说,这相当于拥有了一个“全能创作助手”,省去了在不同工具间反复切换和调整的时间成本。
代码仓库级理解:从辅助编码到架构重构的跨越
如果说多模态创作面向的是内容生产者,那么代码仓库级理解就是为开发者量身定制的“工程利器”。DeepSeek V4专门针对代码智能和仓库级推理进行了优化,其能力远超简单的代码补全。

具体来说,V4能实现三个层级的突破:
- 跨文件依赖推理:理解整个项目的架构,而非孤立地处理单个文件
- 大规模重构与缺陷定位:在不破坏系统稳定性的前提下提出重构建议
- 自动化测试与文档生成:根据代码逻辑自动生成测试用例和说明文档
这解决了一个长期痛点:当前AI编程工具大多只能理解当前打开的文件,一旦涉及跨模块调用或系统级修改,就容易产生幻觉或逻辑断裂。V4的极大型上下文窗口(据报道达到百万token级别)使得它能够一次性摄取整个代码仓库,并在全局视角下进行推理。
这意味着开发者不再只是获得一个“代码补全器”,而是拥有了一个能理解遗留系统、维护大型代码库一致性的“架构级助手”。对于后端工程、DevOps和企业软件维护而言,这种能力的提升是质的飞跃——从“帮你写代码”到“帮你理解系统”。
三、成本与生态:极致普惠是颠覆还是理想?
如果说架构与多模态是DeepSeek V4的“矛”,那么成本控制与开源生态就是它的“盾”。在AI竞赛进入“白菜价”时代的2026年,仅有技术领先已不足以称王——能否让技术真正普惠,才是决定商业格局的关键。V4在这方面的布局,比它的参数规模更值得深究。
成本再降与国产算力适配:打破垄断的“基建”布局
DeepSeek V4的成本优势并非简单的“降价”,而是一场从底层架构到硬件适配的系统性工程。
据爆料,V4将采用FP8混合精度推理技术,预计成本比V3再降30%以上。回顾DeepSeek的成本优化史:V2曾将训练成本降低42.5%,V3的API价格仅为GPT-4o的十分之一。V4延续了这一基因,但更深层的突破在于算力生态的自主可控——它已完成与华为、寒武纪等国产AI芯片的深度适配。
这意味着什么?过去,大模型推理高度依赖英伟达GPU,算力成本受制于外部供应链。而V4的国产算力适配,本质上是在基础设施层面打破垄断:企业可以选择成本更低的国产芯片部署模型,无需为高昂的硬件溢价买单。对于追求规模化的AI应用来说,这种“基建”层面的成本重构,远比API降价更具颠覆性——它让大模型从“奢侈品”真正走向“基础设施”。
然而,成本优势也伴随着隐忧。FP8混合精度虽然高效,但在某些极端推理场景下可能牺牲精度;国产芯片的生态成熟度与英伟达CUDA仍有差距,实际部署的稳定性还需时间验证。低价是敲门砖,但可靠性才是企业级应用的底线。
开源免费商用:能否持续“卷”赢闭源商业帝国?
DeepSeek从V1到V4,始终坚持开源策略,V4更是开放权重、支持免费商用。这一策略直击闭源模型的商业软肋:当开发者可以零成本获取万亿参数模型时,为何还要为GPT-5或Claude的API付费?
但开源不等于无敌。闭源模型的护城河有三层:
- 生态整合:OpenAI、Anthropic已构建起从模型到插件、从云服务到企业套件的完整闭环,这不是单个模型能轻易撼动的
- 合规保障:企业级客户对数据安全、法律合规有刚性需求,闭源模型能提供更清晰的责权边界
- 持续服务:开源模型“用起来免费,维护起来贵”,企业自部署需要投入大量工程资源,隐性成本不容忽视
DeepSeek V4的真正挑战在于:如何将技术开源转化为商业可持续。目前它通过Atlas Cloud等平台提供API服务,试图在开源与商业化之间找到平衡——模型免费,但便捷的云服务收费。这种模式能否持续“卷”赢闭源帝国,取决于它能否构建起足够强大的开发者生态,让“免费”成为商业飞轮的起点,而非终点。
一个不容忽视的现实是:即便V4在基准测试中比肩GPT-5,企业客户的迁移成本依然高昂。技术领先是门票,但生态壁垒才是护城河。这场开源与闭源的对决,远未到终局。