Kimi K2.6并发能力爆发:300子代理军团如何颠覆软件开发效率?
Kimi K2.6并发能力爆发:300子代理军团如何颠覆软件开发效率?
想象一下,你有一个顶级的程序员,他思维敏捷,但一次只能处理一个任务。现在,把这个程序员复制300份,让他们同时开工,并且能无缝沟通、互相协作。这不是科幻,而是Kimi K2.6带来的现实。从“单线程思考”到“300子代理并行”,这不仅是量的叠加,更是软件开发范式的质变。
过去,AI编码助手更像一个“超级实习生”,你给出指令,它生成代码。但面对一个包含多个模块、需要跨文件调试、涉及前后端联调的复杂项目时,它往往力不从心。Kimi K2.6的 “Agent Swarm 2.0”架构,正是为了解决这一核心痛点而生。
Agent Swarm并非简单的“多开几个AI窗口”。其2.0版本的核心在于高并发、大规模的任务编排与通信机制。它支持最多300个子代理并行运行,总共最高4000个协作步骤。
这背后的逻辑是一个三层架构:
- 任务分解与动态调度:系统能将一个宏观的工程任务(如“开发一个电商网站”)自动分解为数百个原子性子任务(设计数据库Schema、编写用户认证API、实现商品列表组件等)。
- 专业化子代理分工:不同的子代理被赋予不同的“角色”和“专长”,有的擅长前端逻辑,有的精于后端算法,有的负责单元测试,像一支训练有素的工程团队。
- 高效的内部通信与状态同步:这是实现真正“协作”而非“混乱”的关键。子代理之间需要共享上下文、传递中间结果、解决依赖冲突。Agent Swarm 2.0的通信层优化,确保了这300个“大脑”能朝着同一个目标高效推进。
这本质上构建了一个虚拟的、高度自动化的“微型软件公司”,其执行引擎就是这300个并行思考的AI代理。
传统开发模式,无论是人工还是借助初级AI工具,都遵循着线性的、串行的任务流。产品经理出需求,前后端开发、测试、部署依次进行。300子代理的并行模式,将这种“流水线”彻底打散,重组为一张动态的、并发的“任务网”。
其颠覆性体现在三个层面:
- 从“顺序执行”到“并发探索”:当遇到一个模糊需求时,系统可以同时派出多个子代理去探索不同的技术方案(如用Vue或React实现前端),并行进行原型构建和评估,快速收敛到最优解,极大缩短技术决策周期。
- 从“局部优化”到“系统级协同”:修改一个核心API接口,传统模式下需要手动检查所有依赖模块。而在Agent Swarm中,相关子代理会被自动唤醒和联动,同步更新调用方代码、调整测试用例、更新文档,实现跨模块的原子化重构。
- 对复杂问题的“饱和式”攻坚:结合其领先的深度检索能力,当系统在庞大代码库中定位一个隐秘的Bug时,它可以发动数十个子代理,同时从日志分析、代码回溯、依赖图谱、历史提交等不同维度进行“地毯式”检索与交叉验证,这是单体智能难以企及的效率。
然而,这种强大能力并非没有代价。 管理300个并行代理的复杂度呈指数级上升。如果任务分解逻辑存在缺陷,或通信协调机制不够健壮,就可能产生“代理内耗”——大量计算资源被浪费在内部协调甚至得出矛盾结论上。这既是Kimi K2.6展现的技术高度,也是其从实验室演示走向稳定生产环境所必须攻克的核心挑战。
实战效能:并发能力如何攻克复杂开发难题?
模型参数的堆叠与架构的升级,最终要落到解决实际问题的能力上。Kimi K2.6宣称的300子代理并发,并非实验室里的理论峰值,而是直接指向了软件工程中最棘手的现实挑战。其效能究竟如何,需要从权威基准测试和核心能力两个维度进行审视。
SWE-Bench Pro 58.6分:代码能力与效率的双重验证
在衡量AI编程能力的“硬核”考场——SWE-Bench Pro上,Kimi K2.6交出了58.6分的成绩单。这个分数不仅持平或超越了GPT-5.4、Claude Opus 4.6等顶级闭源模型,更关键的是,它验证了并发架构在解决真实世界软件工程问题上的有效性。
SWE-Bench Pro的挑战在于,它要求模型理解一个真实GitHub仓库的完整上下文,修复具体Bug或实现新功能,并确保代码能通过项目原有的测试套件。这通常涉及多文件理解、依赖推理等高难度操作。
传统的单体大模型在处理此类任务时,容易陷入“思维隧道”,一次性生成大量可能不完善的代码。而K2.6的Agent Swarm 2.0架构在这里发挥了决定性作用,它将任务分解为可并行执行的子任务:
- 诊断代理分析问题根因,定位关键文件。
- 检索代理并行搜索代码库,收集相关函数和依赖信息。
- 实现代理分工编写不同模块的修复代码。
- 验证代理模拟运行测试,检查代码逻辑。
这种分工协作、并行验证的模式,将“思考-行动-验证”的循环从串行变为并行,极大地提高了首次尝试的成功率与代码质量,这正是其效率跃迁的核心逻辑。
长程编码与深度检索:并发协作下的工程问题解决新范式
除了修复已知问题,K2.6更展示了在长程编码和深度检索任务上的突破,这指向了更复杂的工程场景。
1. 长程编码:从“写片段”到“驱动设计”
传统代码生成工具擅长完成一个函数或一个类。而K2.6的并发能力使其能够处理需要数千行代码连贯设计的任务。例如,给定一个高层设计文档,其子代理可以并行工作:
- 一组代理负责设计数据库Schema和API接口。
- 另一组代理同时编写业务逻辑层代码。
- 还有代理负责生成对应的单元测试和集成测试。
所有工作同步推进,并通过内部通信机制保持设计一致性,最终输出一个结构完整、可运行的模块。这标志着AI从“高级助手”向“初级系统架构师”的角色演进。
2. 深度检索:信息整合与决策支持
在DeepSearchQA等深度检索基准上的领先表现,揭示了K2.6解决复杂问题的另一面:强大的信息整合能力。面对一个模糊的需求(如“优化系统响应速度”),K2.6可以:
- 同时派出多个“调查”子代理,在代码库、文档、日志中并行搜索相关信息。
- 快速归纳出可能瓶颈:是数据库查询慢、缓存失效,还是算法复杂度高?
- 基于整合的信息,生成包含具体优化方案、代码修改建议和预期收益评估的综合报告。
然而,这种并发范式也并非没有代价。 其效能严重依赖于任务分解与协调机制的设计。如果任务本身耦合度过高,难以清晰拆解,或者代理间的通信、冲突解决机制出现瓶颈,并发带来的效率增益可能会被内耗抵消。此外,高达4000个协作步骤的复杂流程,对错误传播的控制提出了极高要求,一个子代理的微小偏差可能在后续步骤中被放大。这既是工程能力的体现,也构成了新的可靠性挑战。
因此,Kimi K2.6的实战效能揭示了一个趋势:AI解决复杂工程问题的关键,正从追求单一的“智力巅峰”(模型参数),转向构建高效的“协作网络”(智能体架构)。
部署与应用:如何让子代理军团为你高效开发?
当Kimi K2.6的300子代理并发能力展现出颠覆性的工程潜力时,一个现实问题随之而来:如何将这套“智能体军团”部署到实际的生产环境中,并使其高效运转?这不仅关乎技术实现,更直接决定了其革命性能力能否转化为可落地的生产力。
硬件门槛与部署实践:CPU+GPU异构推理方案解析
部署一个万亿参数的模型,传统认知需要庞大的GPU集群和巨额成本。然而,Kimi K2.6的开源生态提供了更具可行性的路径。
核心方案是CPU+GPU异构推理。根据社区实践,通过KTransformers等优化框架,仅需8张L20 GPU配合Intel CPU即可成功运行Kimi K2.6。在48并发场景下,其解码速度能达到24.5 tokens/s,预填充速度达640 tokens/s。这大幅降低了企业和研究机构的入门门槛,使得在中等规模的算力基础设施上体验顶级Agent能力成为可能。
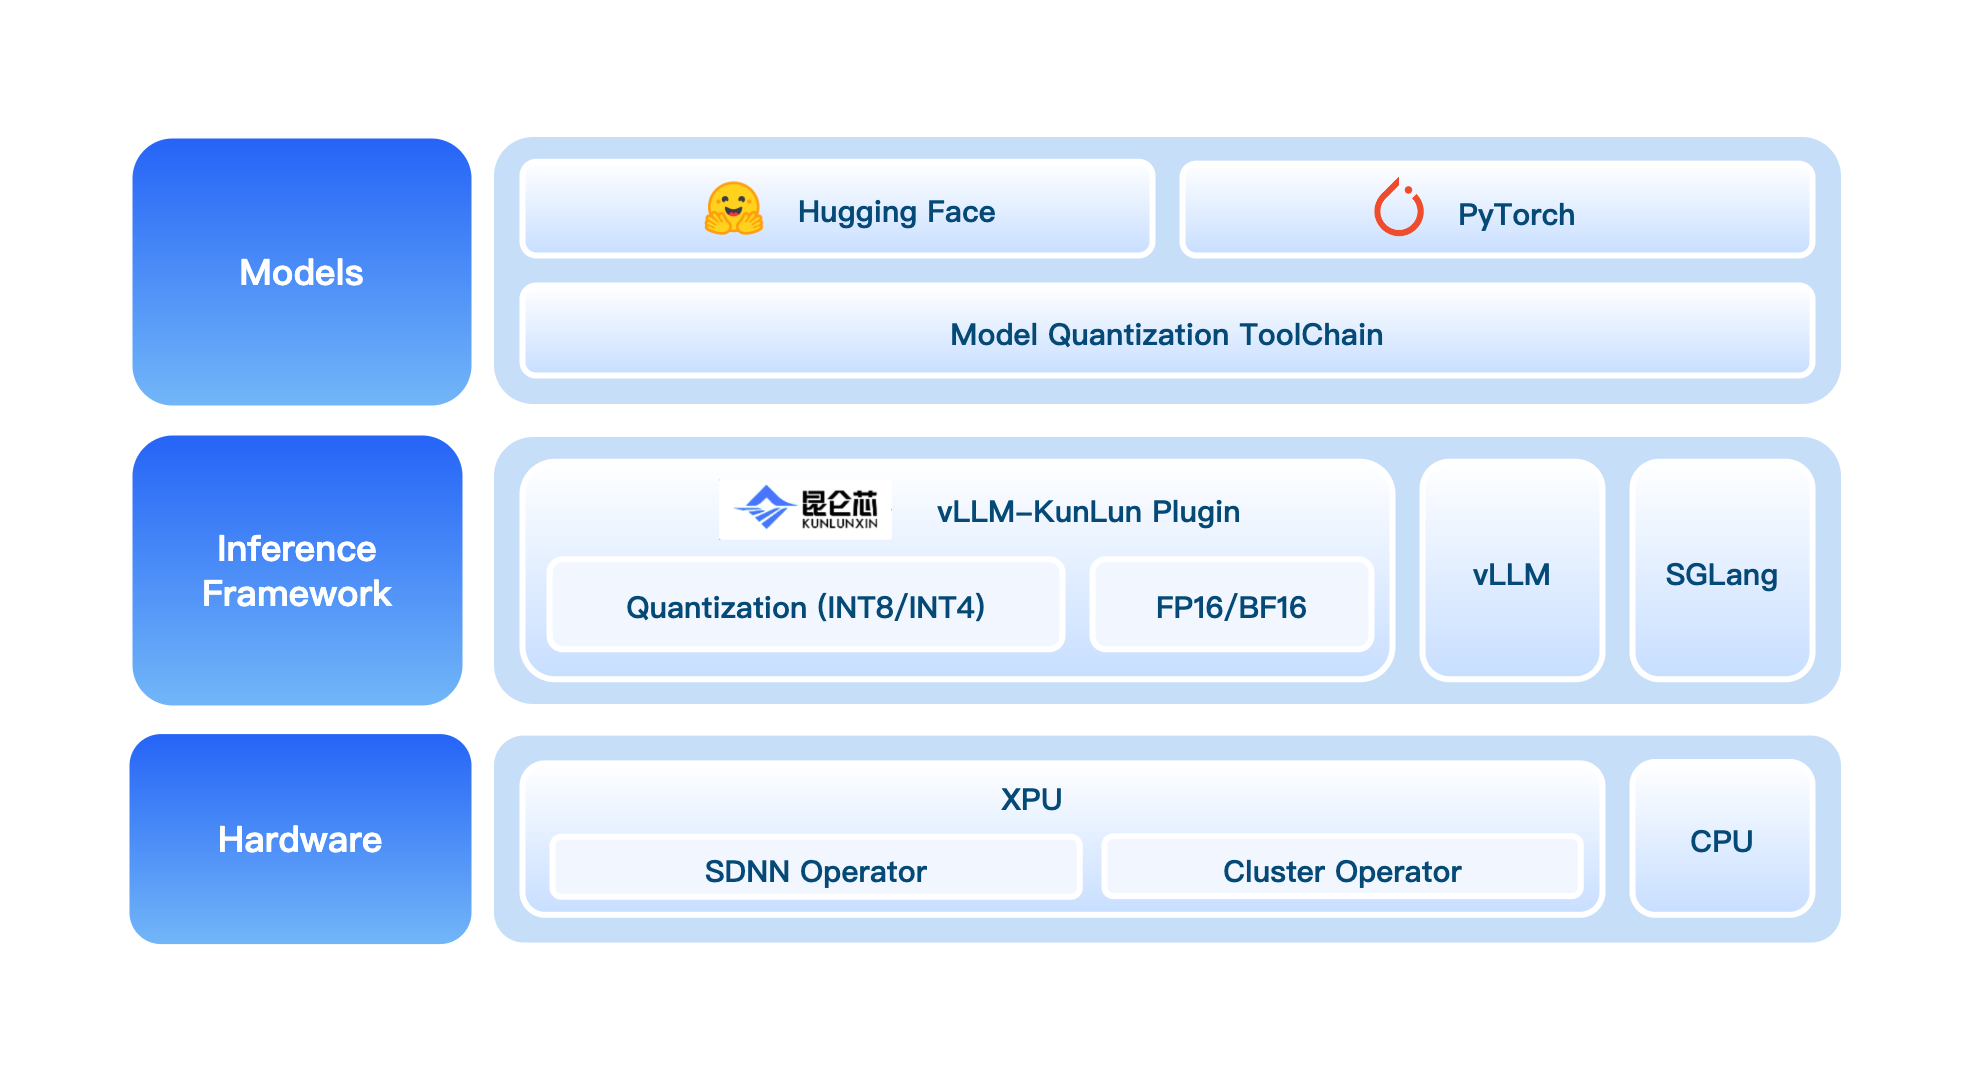
更值得关注的是国产化部署的快速进展。百度百舸联合昆仑芯,实现了Kimi K2.6的“Day0”快速适配。其关键在于:
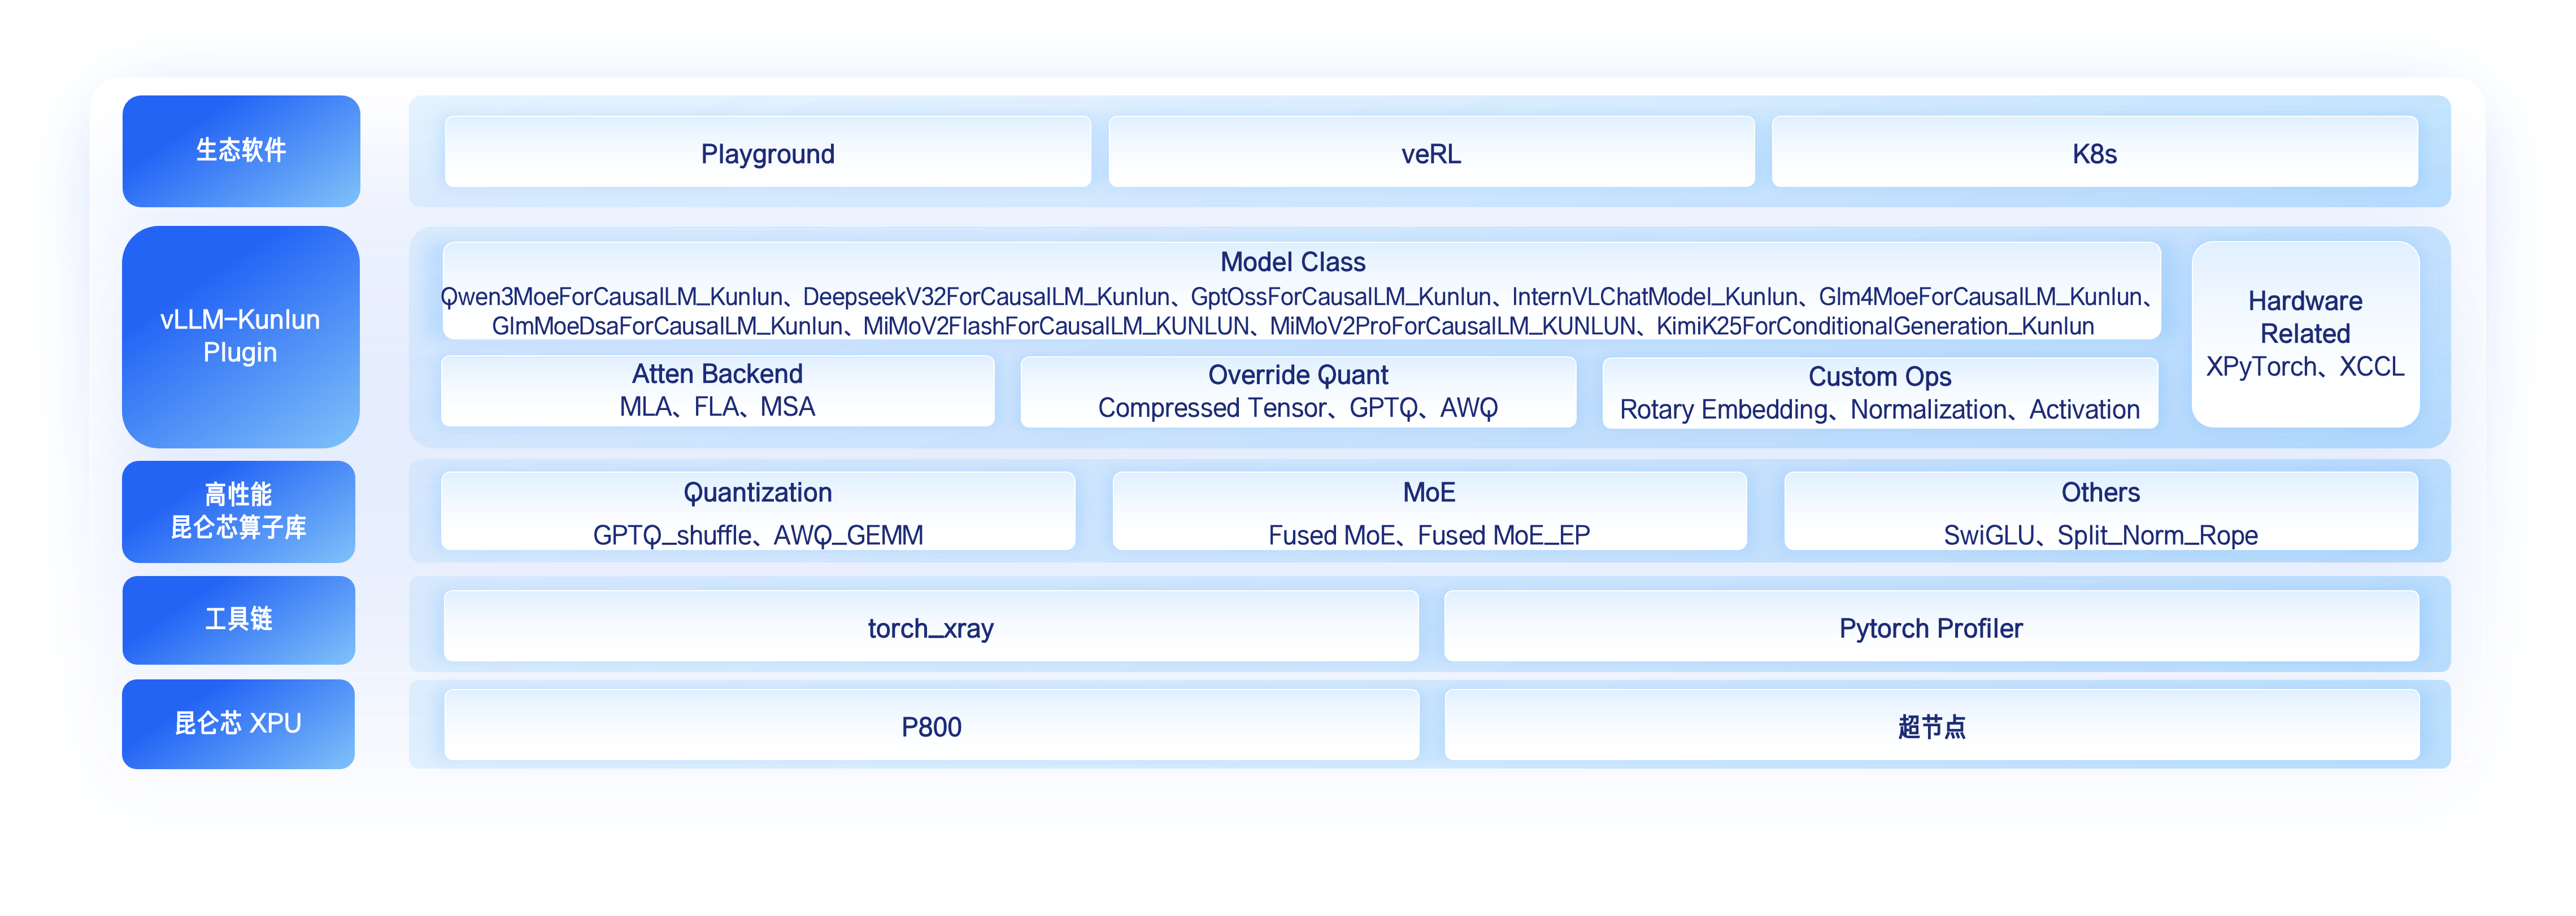
- 软件层解耦:通过 vLLM-Kunlun Plugin,将推理框架与昆仑芯XPU硬件后端解耦,利用CUDA-like特性“抹平”硬件差异,开发者可以像使用通用GPU一样便捷操作。
- 高效量化支持:支持INT4权重量化,使得单台昆仑芯P800服务器即可跑通这个万亿参数模型,显著降低了单次推理的显存占用和计算成本。
- 全链路性能优化:从算子、内核启动到框架系统进行定制优化,并构建了精细化的KVCache调度引擎,将长序列(如64K)的首次令牌生成时间(TTFT)缩短了6.2倍,这对于高并发、长文本的Agent任务至关重要。
这些部署方案表明,Kimi K2.6的能力虽强,但其落地应用正通过软硬件协同优化变得日益亲民和高效。
效率提升的边界:大规模并发应用的成本与挑战
然而,将300子代理的并发能力转化为稳定的生产效率,并非毫无代价。大规模Agent集群的应用,面临着一系列成本与挑战的边界。
首先,显性成本与隐性成本并存。
- 显性算力成本:即使通过量化降低了单次请求成本,但当300个子代理真正高并发执行复杂任务(如涉及4000个协作步骤)时,对计算资源和内存带宽的消耗是指数级增长的。持续运行这样的集群,电力和硬件折旧成本不容小觑。
- 隐性协调成本:Agent Swarm并非简单的“人多力量大”。300个智能体之间的任务分解、结果汇总、冲突消解、状态同步本身就需要消耗可观的系统开销。协调逻辑的复杂度可能成为新的性能瓶颈,不当的任务编排甚至可能导致效率低于少量精干的代理。
其次,稳定性与可靠性挑战凸显。
- 长程任务的风险:Kimi K2.6擅长“长程编码”,但一个由数百子代理协作、持续数小时甚至数天的开发任务,如何保证中间不出现状态丢失、逻辑死锁或累积性错误?系统的容错和回滚机制变得极其关键。
- 结果的可预测性:并发提升了探索广度,但也可能增加输出的不确定性。如何确保数百个并行探索的代码路径最终能收敛到一个正确、优雅且可维护的解决方案,而非一堆需要人工二次整合的碎片,是对其“工程级”能力真正的考验。
最后,开源许可的商业化约束。Kimi K2.6采用修改版MIT许可,规定月活超过1亿或月收入超过2000万美元的商业产品需在界面署名。这对大型商业应用构成了一层合规性门槛,企业在规划大规模部署时必须将此纳入考量。
因此,Kimi K2.6带来的效率革命,其边界不在于技术能力的上限,而在于应用场景与成本效益的精准匹配。 它最适合的是那些任务可高度并行化、探索价值大于确定性、且对成本相对不敏感的复杂问题求解场景。对于常规、确定性的开发任务,动用“代理军团”可能如同“高射炮打蚊子”,得不偿失。
真正的效率提升,源于对“并发能力”的审慎运用,而非盲目追求规模。