AI 的短板,藏在那些谁都会做的任务里
特沃雷克在2026年人工智能峰会上提出,衡量AI进步的标准应是它仍无法完成的简单任务。OpenAI内部统计显示,任务从15分钟拉长到4至8小时,Agent零干预成功率从86%降到43%。本文解释这一落差为何发生,并区分能力上限与可靠下限,给出读者可用的三个观察变量。
AI 的短板,藏在那些谁都会做的任务里
被演示掩盖的那部分能力
一句峰会发言,为什么值得认真对待
2026年人工智能峰会上,Core Automation公司首席执行官杰瑞·特沃雷克给出了一个不太讨喜的判断:衡量AI进步的最佳标准,是那些模型目前依然无法完成的“看似简单”的任务。这句话来自一位被来源称为“前OpenAI研究负责人”的从业者。
值得认真对待的原因不在于发言者的头衔,而在于它指向了一种普遍的认知偏差。特沃雷克强调,技术的快速飞跃很容易让人忽视模型在部分领域其实毫无进展,而这些短板恰恰是决定人工智能能否可靠胜任现实世界工作的关键。标尺选错了,结论就会系统性偏乐观。
演示效果与工作能力不是同一件事
演示之所以容易高估AI,原因并不复杂。演示是经过挑选的,时长可控,容错空间大;一次失败可以重录,一个环节卡住可以绕开。真实工作恰恰相反:任务连续、时间拉长、错误会累积,没有人替你剪辑掉失败的那一段。
这两者之间的差距,不是能力高低的问题,而是评估对象的问题。用演示当标尺,测的是模型在最优条件下的上限;用日常任务当标尺,测的是它在普通条件下的稳定性。两者可以相差很远,而后者才更接近“能不能托付”这个问题的答案。
需要说明的是,特沃雷克的观点来自峰会发言,来源并未给出具体的任务清单或数据支撑,它属于一个判断,而非已经验证的结论。但即便作为判断,它至少提醒了一件事:在讨论AI能力时,先问清楚用的是哪把尺子。
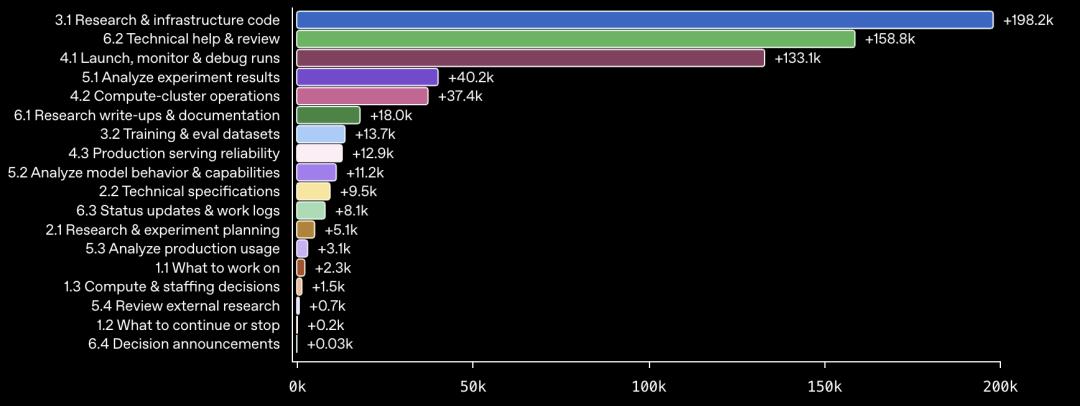
任务一拉长,成功率就掉下来
15分钟与8小时,是两个世界
OpenAI 内部有一组统计,把任务按时长切成了两档。人类15分钟内能干完的简单任务,Agent 零干预一次成功的比例是86%。这个数字放在任何一份产品宣传里都拿得出手。
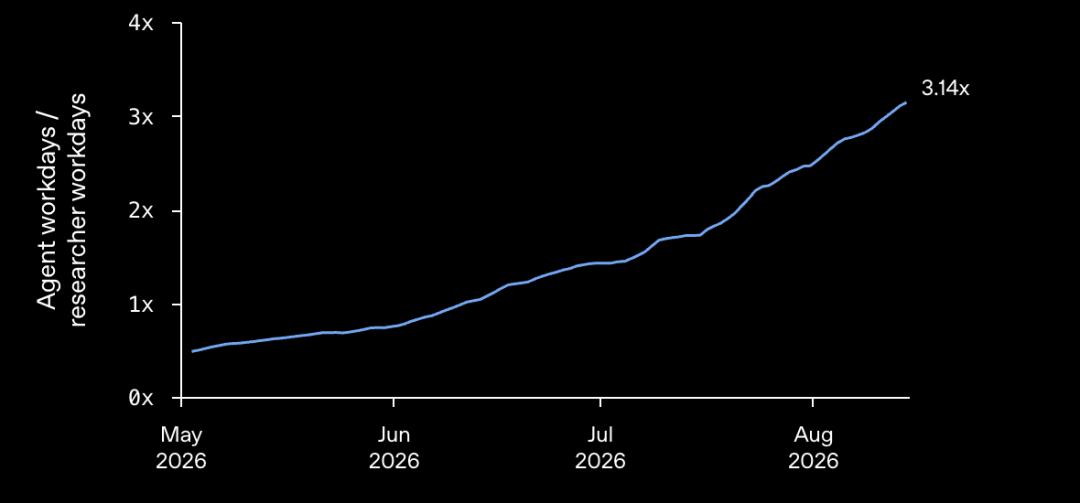
任务拉长到4到8小时,零干预成功率只剩43%。同一套系统,同一类任务,仅仅是时间变长,成功率掉了一半。
86%和43%之间的落差,比从“能用”到“不能用”的跨度还大。前一个数字容易让人产生“已经差不多了”的错觉,后一个数字才接近真实工作场景里的表现。
长任务为什么更难:错误会累积
短任务步骤少,容错窗口窄但暴露面小。一个15分钟的任务可能只需要五六个决策点,每个环节即使有轻微偏差,后续步骤还有机会修正回来,或者偏差本身不影响最终结果。
4到8小时的任务是另一个量级。决策点可能膨胀到几十上百个,每一步的小概率失误不再被稀释,而是叠加。假设单步成功率是95%,十步之后整体成功率就降到六成左右;如果步骤更多、每步之间还有依赖关系,衰减更快。这不是模型“变笨了”,是概率在长链条上的自然表现。
OpenAI 的统计里还有一个更值得注意的细节:过去半年,4到8小时这一档成功完成的任务中,超过一半至少需要人插手一次。零干预成功率43%是底线数字,实际交付中的人类介入频率比这个数字暗示的更高。
这组数据来自 OpenAI 内部统计,任务类型和评估方法没有公开,不能直接外推到所有模型和场景。但它至少说明了一个方向:衡量 Agent 能力时,任务时长是一个被低估的变量。短任务的高分和长任务的低分可以同时成立,它们测的不是同一种东西。
乐观时间表与能力短板并存
行业领袖仍在预测AGI临近
如果长链条任务上的稳定性如此脆弱,为什么行业内部仍有人给出以年为单位的时间表?
OpenAI前政策研究与“AGI准备工作”负责人Miles Brundage的判断是,未来几年行业可能开发出几乎能远程完成人类通过计算机操作的所有任务的系统,包括使用鼠标键盘,甚至在视频聊天中呈现人类形象。OpenAI联合创始人、八月离职的研究科学家John Schulman认为AGI可能在几年内实现。Anthropic CEO Dario Amodei给出的时间点更具体:AGI的某种版本可能在2026年问世。
这些说法容易被读成对“短板论”的反驳。但它们指向的其实是另一个问题。
两种判断并不必然矛盾
Brundage、Schulman、Amodei预测的是能力上限——系统在最优条件下能做到什么。前面讨论的长任务稳定性衡量的是可靠下限——系统在普通条件下能稳定做到什么。上限突破和下限抬升是两条不同的曲线,没有理由同步移动。
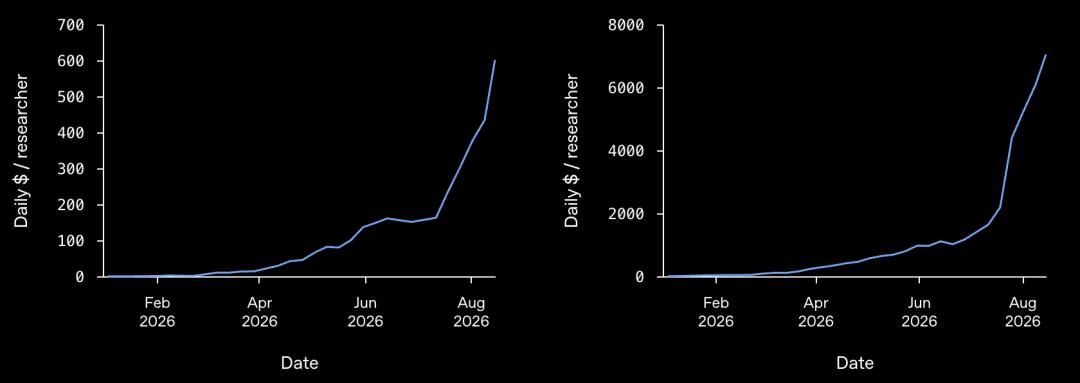
一个系统可以在某个基准测试上刷新纪录,同时在需要连续四小时保持一致的日常任务里频繁掉链子。这不是自相矛盾,而是两种评估维度在回答不同的问题。前者问“能不能做到”,后者问“能不能托付”。
这些预测本身也需要打个折扣。它们都是个人判断,没有给出具体年份或可验证的标准。Brundage在离职时也承认,他对其他实验室是否完全掌握相关事项不抱信心。这意味着即便是给出乐观时间表的人,对行业整体的准备程度也持保留态度。
把这两种声音放在一起看,得到的不是谁对谁错的结论,而是一个更实际的提醒:讨论AGI何时到来之前,先确认说的是上限还是下限。
读者该用什么标尺看AI
把任务时长和容错要求作为变量
拿到一个AI能力说法,先别管演示多流畅。问三个问题就够了:这个任务要跑多久,出错一次代价多大,中途需要人接手几次。
任务时长是第一道筛子。几分钟内完成的事,模型有足够机会在单次尝试里做对;一旦拉长到几小时,它必须连续做出几十上百个正确决策,中间任何一步偏离都可能让整条链路失效。
容错要求是第二道。写一段草稿,错了可以改;自动执行一笔交易或操作一台设备,错了没有撤回键。同一个模型在两种场景下的可用程度可以差很远,而演示往往选的是前者。
人工干预频率是第三道,也最容易被忽略。如果一个系统号称能独立完成某项工作,但实际运行中每隔一段时间就需要人纠正一次,那它承担的不是完整任务,而是任务的一部分。把干预频率问清楚,比看它能不能跑通一次 demo 更有信息量。
这三个变量都不需要专业知识就能观察。它们替代的是“惊艳程度”这个模糊标尺——后者只告诉你系统在最优条件下能做什么,前者告诉你它在普通条件下能不能被托付。
对来源保持应有的审慎
需要说明本文证据的边界。特沃雷克的观点来自峰会发言的媒体报道,该报道由环球市场播报发布,新浪财经注明系转载自合作媒体,内容仅供参考。同一内容在另一平台的页面声明为自媒体用户上传,平台仅提供信息存储服务。
这意味着核心论断缺少可核验的案例和数据支撑。来源没有给出具体任务清单,没有说明哪些任务属于“看似简单”却暴露短板的类型,也没有提供任何反例或量化结果。它属于一个判断,不是已经验证的结论。
所以上面的三个变量,应当被当作一套提问习惯,而不是一套已被数据验证的评估标准。它的用处在于帮你判断一个能力说法是否值得进一步追问,而不是替你做最终结论。如果某个说法回避了任务时长、容错要求和干预频率,只展示流畅的演示,那它至少还没有回答“能不能托付”这个问题。