3分钟消化2800万行代码,AI编程的Token消耗暴降99%
3分钟消化2800万行代码,AI编程的Token消耗暴降99%
AI编程Agent探索代码库的方式,本质上是“盲人摸象”式的暴力穷举。你问它“谁调用了这个支付函数”,它不会直接告诉你答案,而是开始一场低效的寻宝游戏:先grep搜索函数名,找到15个文件;然后逐个读取,每读一个文件就消耗几千Token;读到调用链相关的文件,又发现新的引用,继续grep,继续读……循环往复。
这场寻宝的代价有多大?根据codebase-memory-mcp团队的实测数据:5个常见的结构化查询(找函数、追调用链、检测死代码、列路由、看架构),传统逐文件搜索消耗了约412,000个Token。按当前主流模型API价格(每百万Token 3-15美元),仅理解代码结构这一项,单次会话就可能烧掉几美元。
更致命的是,这种浪费会引发连锁反应。海量无关代码塞进上下文窗口,模型很容易产生“迷失在中间”的问题——关键信息被淹没在噪音里,回答质量断崖式下降。这就是为什么你在用Cursor改老项目时,AI总是“发明”不存在的类名和方法:它被无关代码淹没了,只能靠猜。
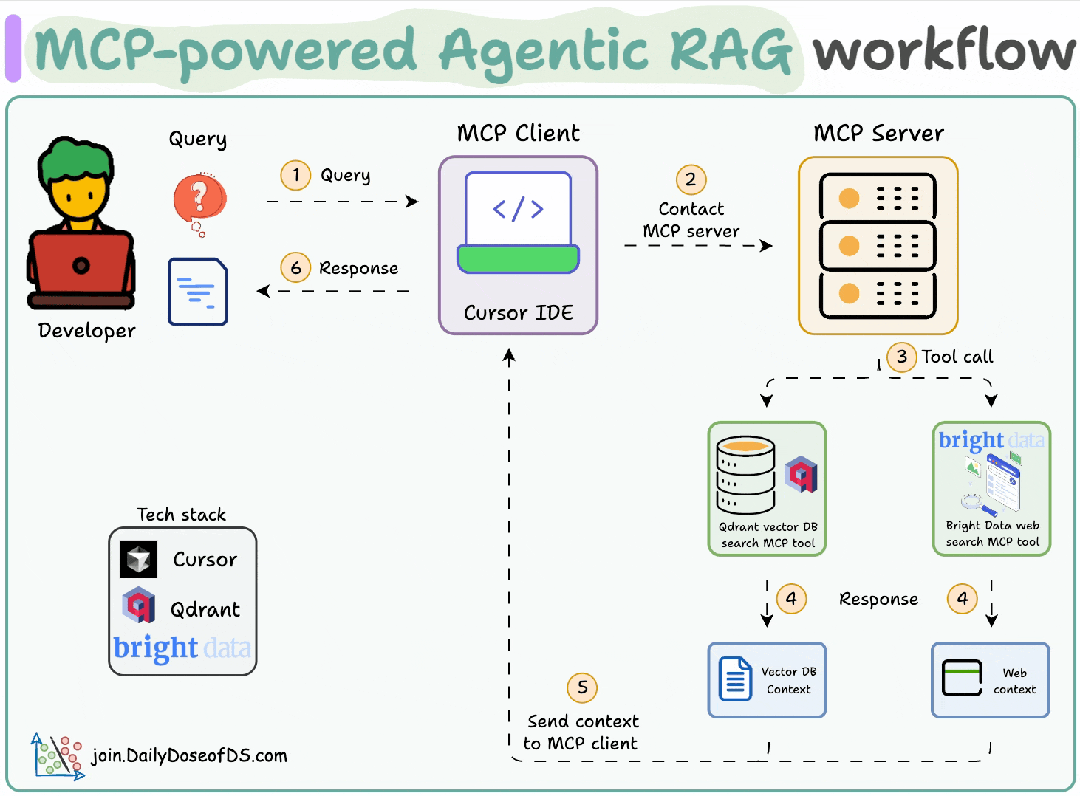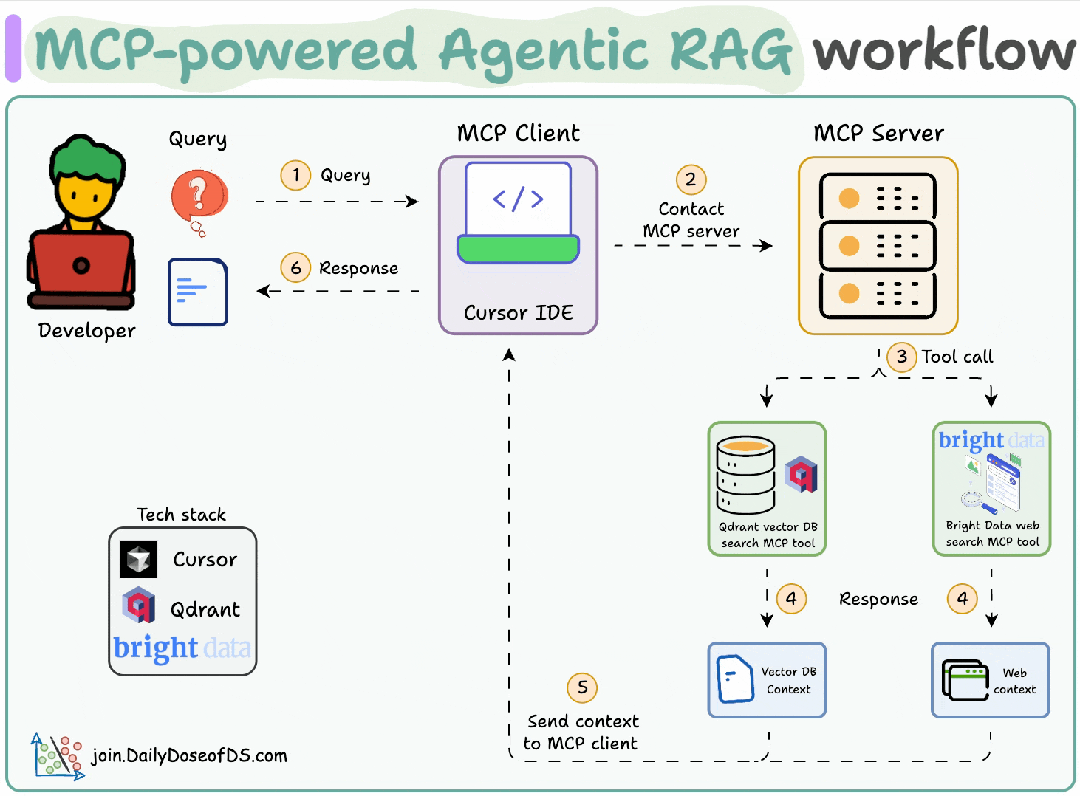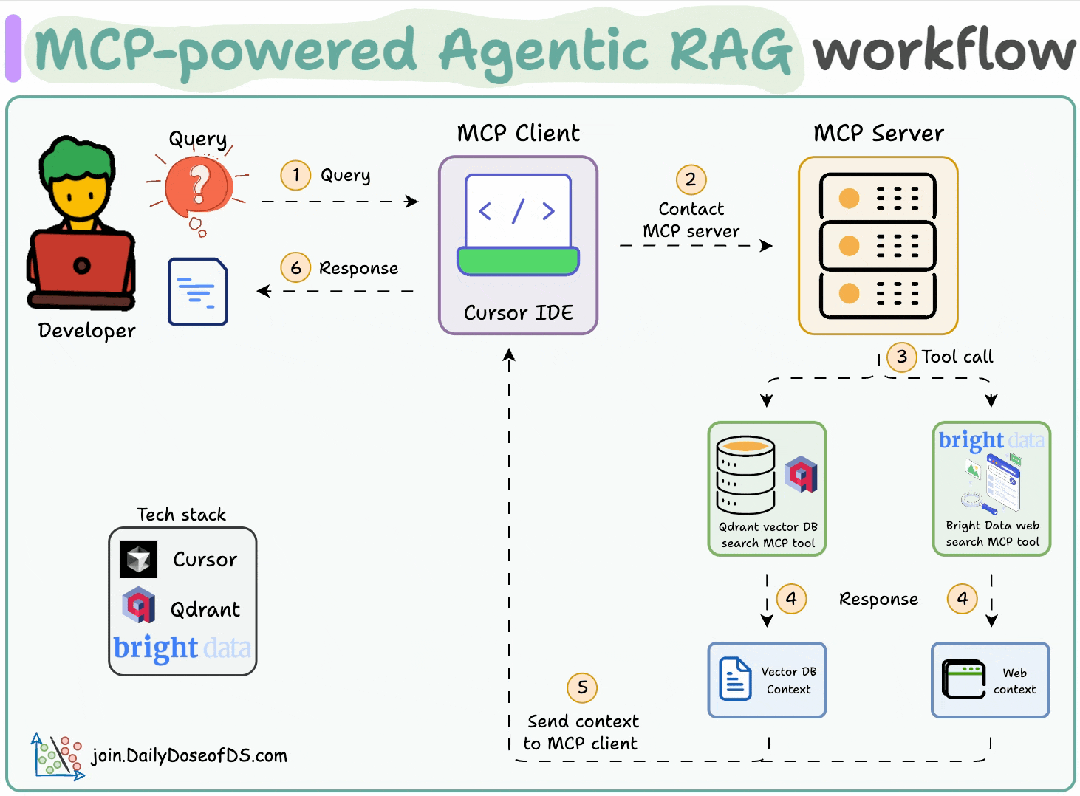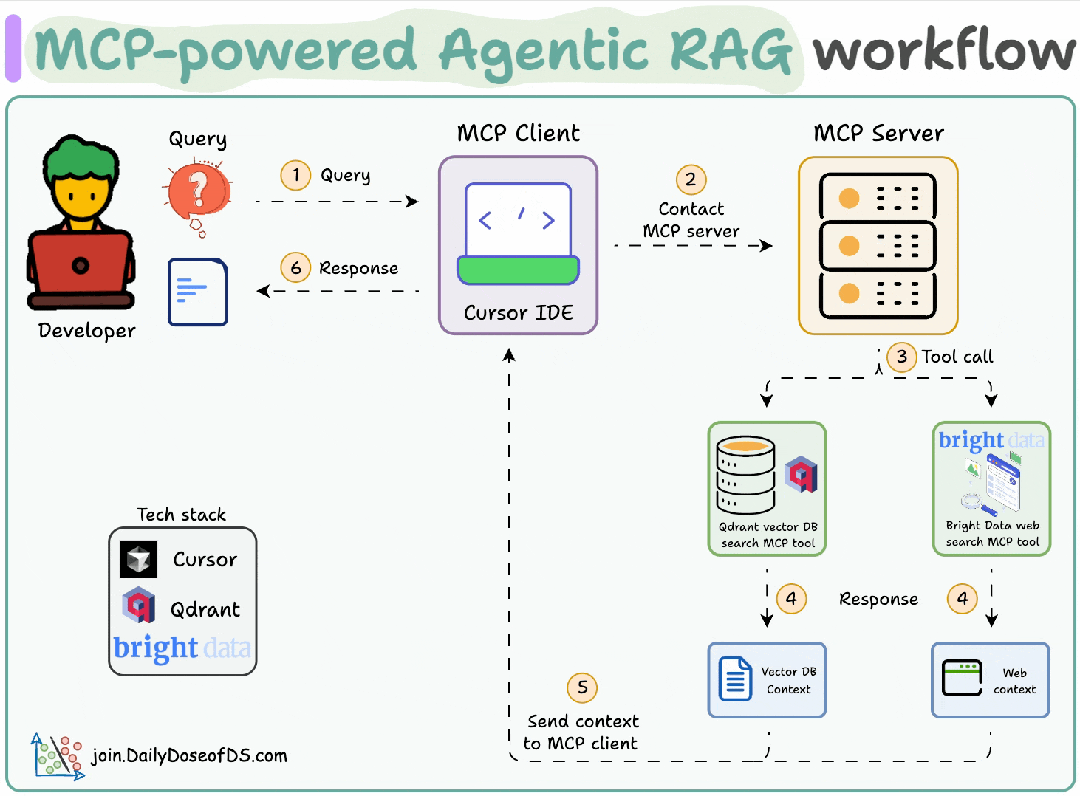
而且,这种浪费是重复发生的。每次新会话,Agent都要重新走一遍这个流程。代码库越大,浪费越惊人。传统方案的本质缺陷在于:把代码当文本处理,而不是当结构化知识理解。
面对Token黑洞,业界的主流解法是RAG(检索增强生成)——先向量化代码片段,再按相似度检索。这比全量投喂进步了,但仍停留在“泛读”层面。RAG能找到语义相似的代码块,却无法理解函数之间的调用拓扑、类继承的层级关系、模块间的依赖图谱。它能回答“哪里有个类似的实现”,但回答不了“这个改动会影响多少调用者”。
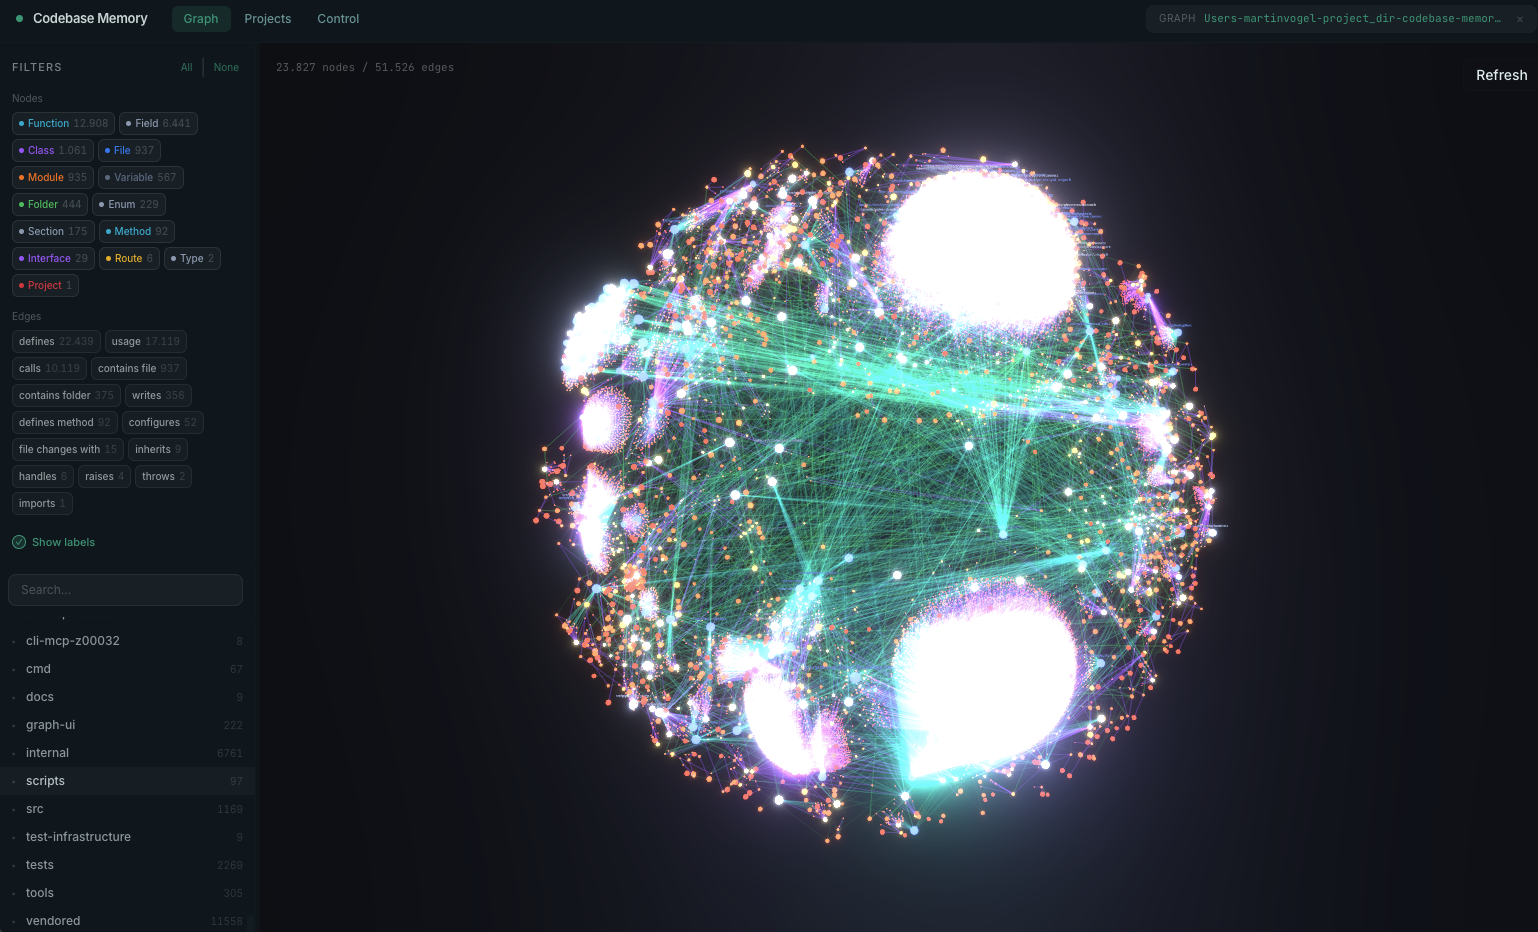
codebase-memory-mcp的思路完全不同:先把代码库的结构信息提取成持久化的知识图谱,存进SQLite;Agent需要了解代码结构时,不读文件,查图谱。同样是那5个结构化查询,从知识图谱中直接检索只需要约3,400个Token——120倍的Token节省,99.2%的降幅。
从“每次重新探索”变成“查询已有的结构记忆”,这才是AI编程真正需要的底层基础设施。
这不仅仅是省钱。更重要的是,图谱查询是毫秒级的(Cypher查询小于1毫秒),而逐文件搜索需要数十秒。当AI能“确知”代码结构而非“猜测”时,幻觉问题才真正有了根治的可能。

二、 内核级架构:Rust内核与AST如何炼成158语言的毫秒索引能力?
面对Linux内核2800万行代码、7.5万个文件的庞大体量,codebase-memory-mcp在Apple M3 Pro上仅用3分钟即完成全量索引,生成481万个节点和772万条边。而对于Django这类常规项目,索引时间更是压缩到约6秒。
这一性能背后,是Rust语言赋予的底层优势——零成本抽象、无GC停顿、编译期内存安全。但更关键的,是其独创的双层解析架构与双时态图谱设计,让AI编程代理不再停留在“看代码”的浅层,而是真正“理解代码”。
2.1 双层解析机制:Tree-sitter语法层与混合LSP语义层的协同工作原理
传统代码索引工具通常在单层运作——要么纯文本匹配,要么浅层AST解析。codebase-memory-mcp则构建了语法与语义的双层穿透机制。
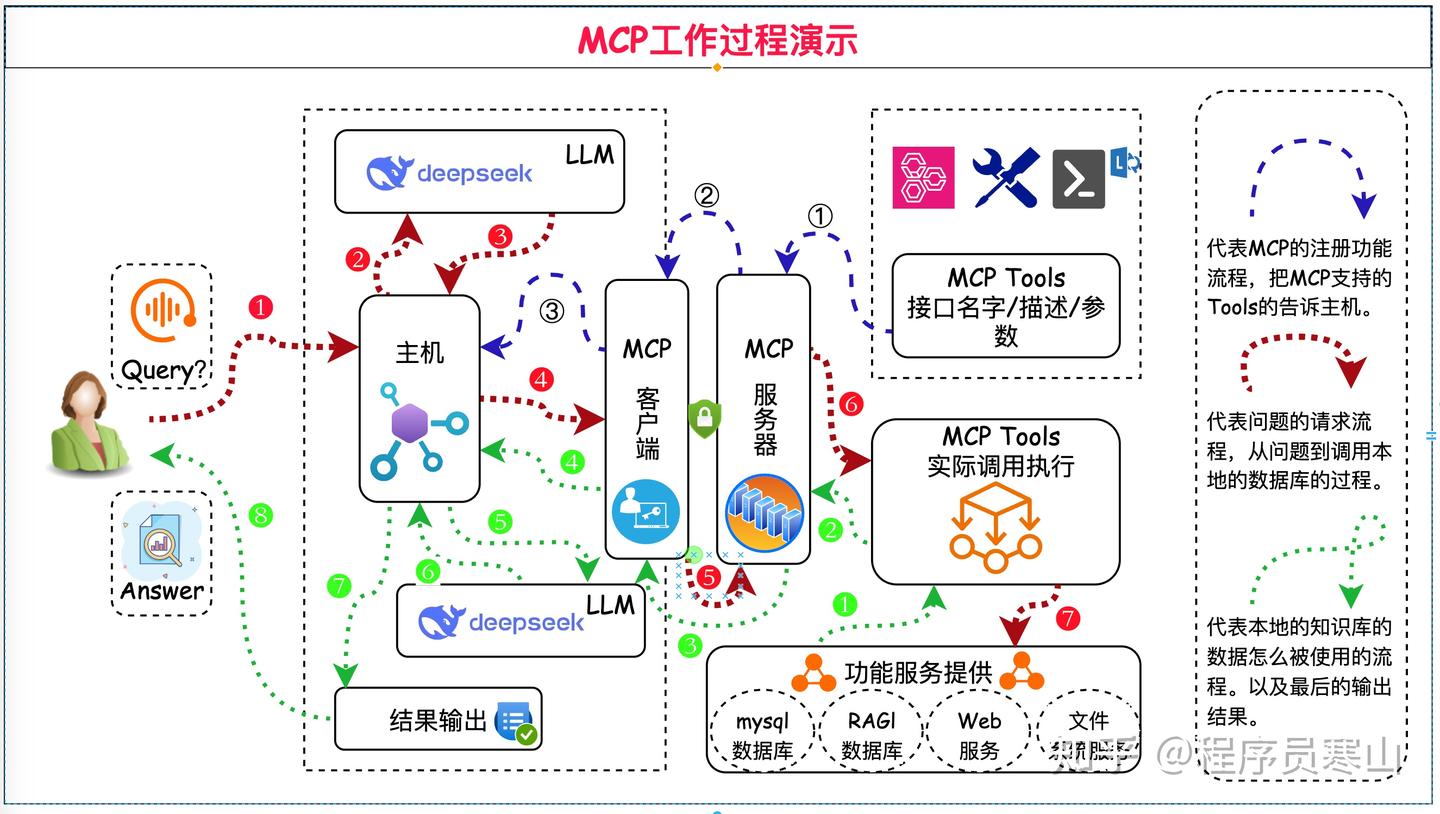
第一层是Tree-sitter语法层,负责将158种语言的源代码实时转化为具体语法树(CST)。Tree-sitter的增量解析能力意味着,即使代码库发生局部修改,也无需重建整个树结构,这为毫秒级响应奠定了基础。
但语法层的局限在于:它只能回答“代码长什么样”,无法回答“代码意味着什么”。
于是第二层混合LSP语义层介入。它在纯C进程中实现了一套轻量级的类型解析算法,兼容主流语言服务器的推导逻辑,但无需启动任何外部进程。当AI代理询问“这个函数被哪些模块调用”时,系统并非简单做文本grep,而是通过语义层遍历导入图、继承链和泛型约束,精准定位跨文件的符号引用链。
双层解析的本质差异在于:语法层提取结构,语义层追踪意图。
这一设计的性能收益在复杂项目中尤为显著。在TypeScript编译器这类大型代码库中,Hybrid LSP的引入使索引时间从5100秒骤降至50秒,实现100倍性能提升。目前,Python、TypeScript、Go、Rust等9种主流语言已获得语义层增强,其余149种语言则依赖Tree-sitter提供基础但广泛的结构图谱。
2.2 双时态图谱设计:兼顾代码历史演进与实时快照的混合存储策略
代码库是动态演化的生命体,单一时态的索引无法满足AI编程的深层需求。codebase-memory-mcp创新性地引入了双时态知识图谱架构。
第一个维度是版本快照图,捕获当前代码库的完整结构关系——类继承链、函数调用图、模块依赖网。这为AI代理提供了“此刻的代码真相”,消除因上下文缺失导致的幻觉。
第二个维度是历史演进图,追踪代码随时间的变更轨迹。当AI被问及“这个接口为何被废弃”时,系统能从历史图谱中追溯该符号的完整生命周期。
在存储层面,两个图谱共享同一套底层架构:SQLite数据库配合WAL模式保证ACID安全与跨会话持久化,而RAM-first流水线利用LZ4压缩与Aho-Corasick模式匹配算法在内存中极速完成图计算,索引完成后立即释放内存,确保亚毫秒级的Cypher图查询成为可能。
更具工程智慧的是其团队共享方案。图谱可导出为Zstandard压缩的SQLite快照文件(graph.db.zst),直接提交至Git仓库。团队成员拉取后无需重新索引,仅做增量更新即可。这一设计将“代码记忆”真正纳入了版本控制体系,随代码一同演进。
三、 实战接入:作为MCP服务,如何将代码记忆融入AI编程工作流?
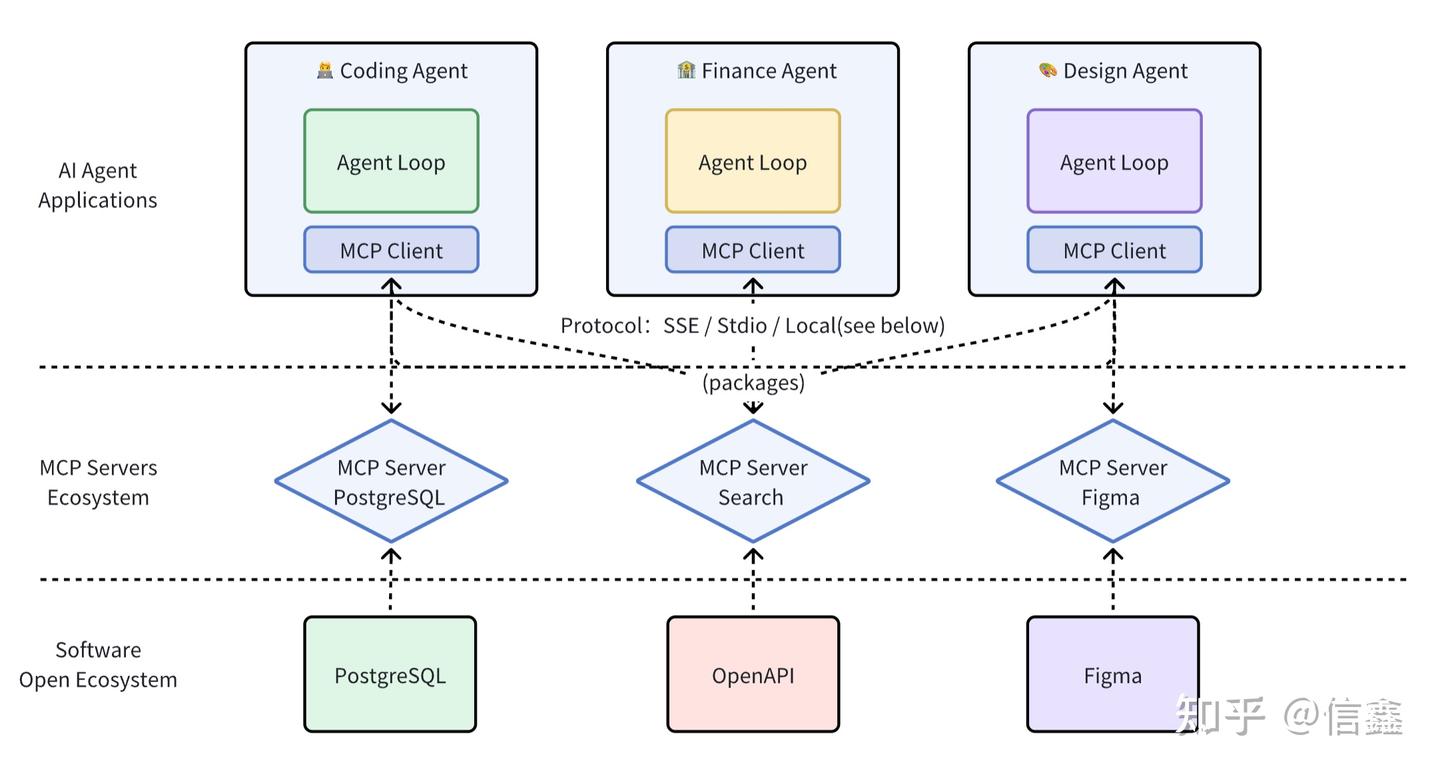
将代码库转化为结构化知识图谱后,如何让AI编程助手真正用上这份“记忆”?codebase-memory-mcp选择以MCP服务形态交付——一个轻量级的协议层,让Claude Code、Cursor等客户端像调用工具一样查询代码知识。这种设计意味着零侵入:不需要改造现有IDE,不需要更换编程Agent,只需在MCP配置中添加一行连接即可。
与传统代码检索工具不同,该服务提供的是语义级理解而非关键词匹配。当你询问“这个项目的认证逻辑在哪”,它返回的不是文件列表,而是函数调用链、数据流向和上下文关联。这种“记忆中枢”模式让AI编程从“盲写”进化到“确知”——Agent在生成代码前,已经掌握了整个项目的骨架。
3.1 低延迟配置:在Claude Code、Cursor等客户端中的无缝集成与团队共享方案
接入设计遵循一个原则:不折腾用户。一行命令即可完成安装,且自动检测系统中已安装的编码代理——Claude Code、Cursor、Codex CLI、Gemini CLI、Zed、Aider、KiloCode、VSCode、OpenClaw、Kiro等11种客户端——并逐一写入MCP配置条目、指令文件和预置工具钩子。
安装后只需重启Agent,说一句“Index this project”,索引便在几秒到几分钟内完成。对于Django这类中型项目,全量索引仅需约6秒;即便是Linux内核级别的庞然大物,也只需3分钟。
团队协作场景下,该项目提供了一个巧妙设计:共享图谱制品。索引完成后,系统会将SQLite知识图谱压缩为.codebase-memory/graph.db.zst文件,可直接提交到Git仓库。团队成员拉取代码后,本地若没有数据库,index_repository会先导入该制品,再执行增量索引——避免每个人都从零重建图谱。
压缩采用zstd 1.5.7,典型压缩比在8-13:1,且自动创建.gitattributes配置merge=ours,杜绝二进制文件的合并冲突。对于偏好命令行的开发者,每个MCP工具均可通过CLI直接调用,既能作为Agent的静默后端,也能融入自动化脚本和CI/CD流水线。
3.2 能力边界审视:无内置LLM、部分语言解析偏科及不支持写操作的局限
尽管性能表现亮眼,codebase-memory-mcp并非无懈可击。客观审视其能力边界,有助于在实际场景中做出准确取舍。
无内置LLM是设计选择,而非缺陷。 该项目定位为结构分析后端,不包含任何大语言模型,也不发送代码到外部服务。这带来两个直接后果:其一,它无法独立回答自然语言问题,必须依赖上游Agent充当“查询翻译器”;其二,省去了额外的API Key配置和模型调用成本。对于已有MCP客户端的用户,这是干净的职责分离;但对于希望开箱即用、独立运行的场景,则意味着必须搭配Agent使用。
语言解析存在明显的分层差异。 虽然支持158种语言,但解析质量分为三个等级:Lua、Kotlin、C++、C、Bash、Swift等达到“优秀”(≥90%);Python、TypeScript、Go、Rust、Java等主流语言处于“良好”(75-89%);而OCaml、Haskell等函数式语言仅“可用”(<75%)。更关键的是,Hybrid LSP语义层仅覆盖9种语言(Python、TS/JS、PHP、C#、Go、C/C++、Java、Kotlin、Rust),其余149种语言只有Tree-sitter语法层,这意味着它们的调用关系解析停留在文本匹配层面,无法处理跨模块引用、泛型实例化等复杂语义。
查询能力也有明确限制。 query_graph仅支持只读Cypher子集,不支持WITH、COLLECT、OPTIONAL MATCH等高级子句,也不支持任何写操作(CREATE、DELETE、MERGE)。对于需要动态修改图谱或执行复杂多跳查询的场景,这会构成硬性约束。
此外,Windows用户可能遇到SmartScreen未签名软件警告,需手动点击“仍要运行”;首次索引大型仓库时会占用数GB内存(索引完成后释放);自动索引默认限制5万个文件,超出需通过config set auto_index_limit调整。这些并非致命缺陷,但在实际部署中需要纳入考量。
核心启示:codebase-memory-mcp解决的是“让AI看见代码全貌”的问题,而非“让AI写对代码”的问题。它是基础设施,不是银弹。