双头虾进科普书、57%儿童视频是AI泔水:垃圾内容污染知识库
中国农业出版社科普丛书因AI生成“双头虾”配图被下架召回,Kapwing抽查显示TikTok儿童类内容57.4%被判定为AI泔水。AI把内容制作边际成本压到接近零,传统审校流程却拦不住这些“看起来像知识”的错误内容,它们正通过训练语料回流形成不可逆的知识污染循环。
双头虾进科普书、57%儿童视频是AI泔水:垃圾内容污染知识库
双头虾进了科普书,AI泔水从猎奇变成污染源
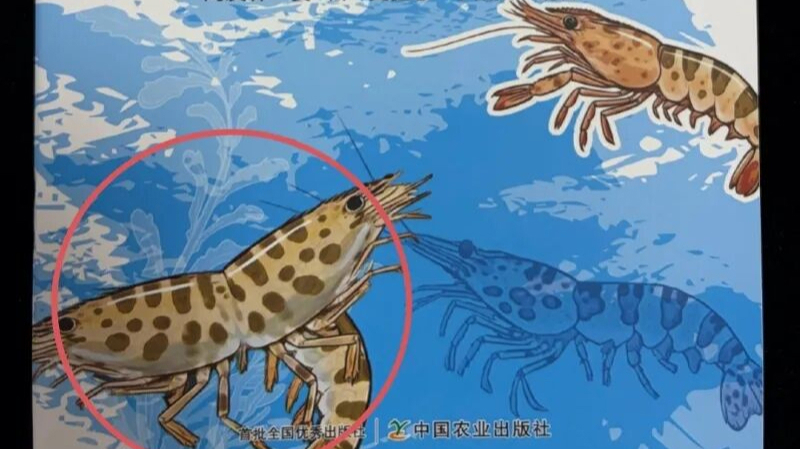
2026年,中国农业出版社的《南海海洋生物科普丛书》因为一张“双头虾”配图被全网下架召回。丛书序言写得很清楚:绝大多数图片由AI绘图工具生成。更刺眼的是,这套书入选了2026年全国优秀科普图书作品。
AI泔水已经穿过审校流程,拿到了“科普”的合法性印章。 斑节对虾蜕壳被画成双头虾,封面和内页都出现了同一处错误,出版社直到读者指出来才启动召回。审校链条里没有人发现。传统出版对AI生成内容存在系统性盲区,这是双头虾事件给出的直接证据。
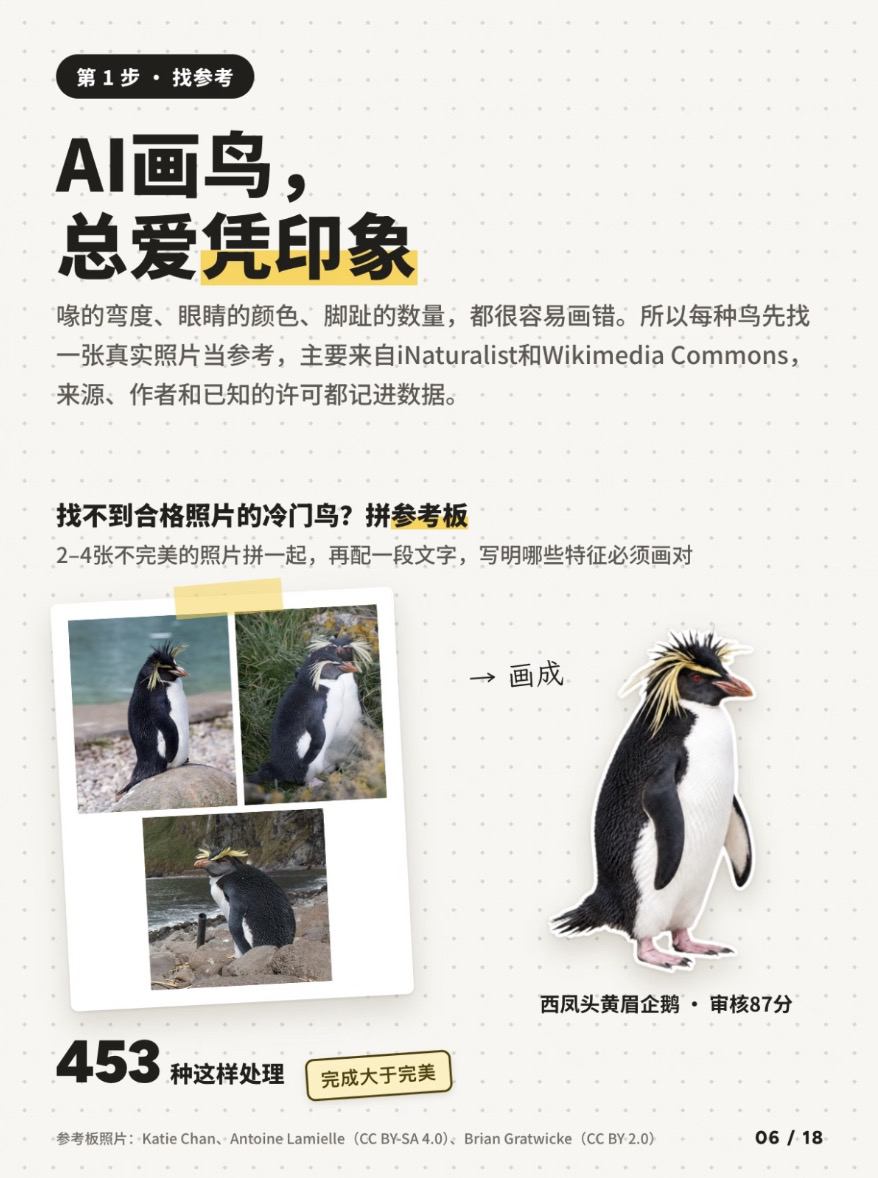
几乎同一时间,一位独立开发者用AI做了覆盖全球11064种鸟类的写实风格贴纸,免费开源、允许商用。观鸟社群提出了批评,但普通用户看到的是一套“看起来很专业”的鸟类图鉴。
把两个案例放在一起,规模差异就是成本差异。双头虾是一本书的编辑事故,一万多张鸟类贴纸则是用脚本批量生成的流水线产品。生成一张假鸟图的边际成本趋近于零,而人类画师画一张科学插画需要数小时核对标本。当边际成本相差几个数量级,垃圾内容就会以指数级速度淹没人工审校能力。
这正是AI泔水和普通网络垃圾内容的区别。过去的营销号洗稿至少需要人来拼贴改写,产量受限于人力。现在一个开发者加一套API,就能在几天内产出覆盖整个生物分类体系的内容。它们不追求精确,只追求“看起来像知识”。而平台算法和出版选题机制,恰恰奖励“看起来像知识”的东西。
个案背后是一条被成本优势驱动的生产链。下一章拆解谁在批量制造这些内容,为什么传统审核拦不住。
谁在批量制造AI泔水?一笔被压到接近零的边际成本账
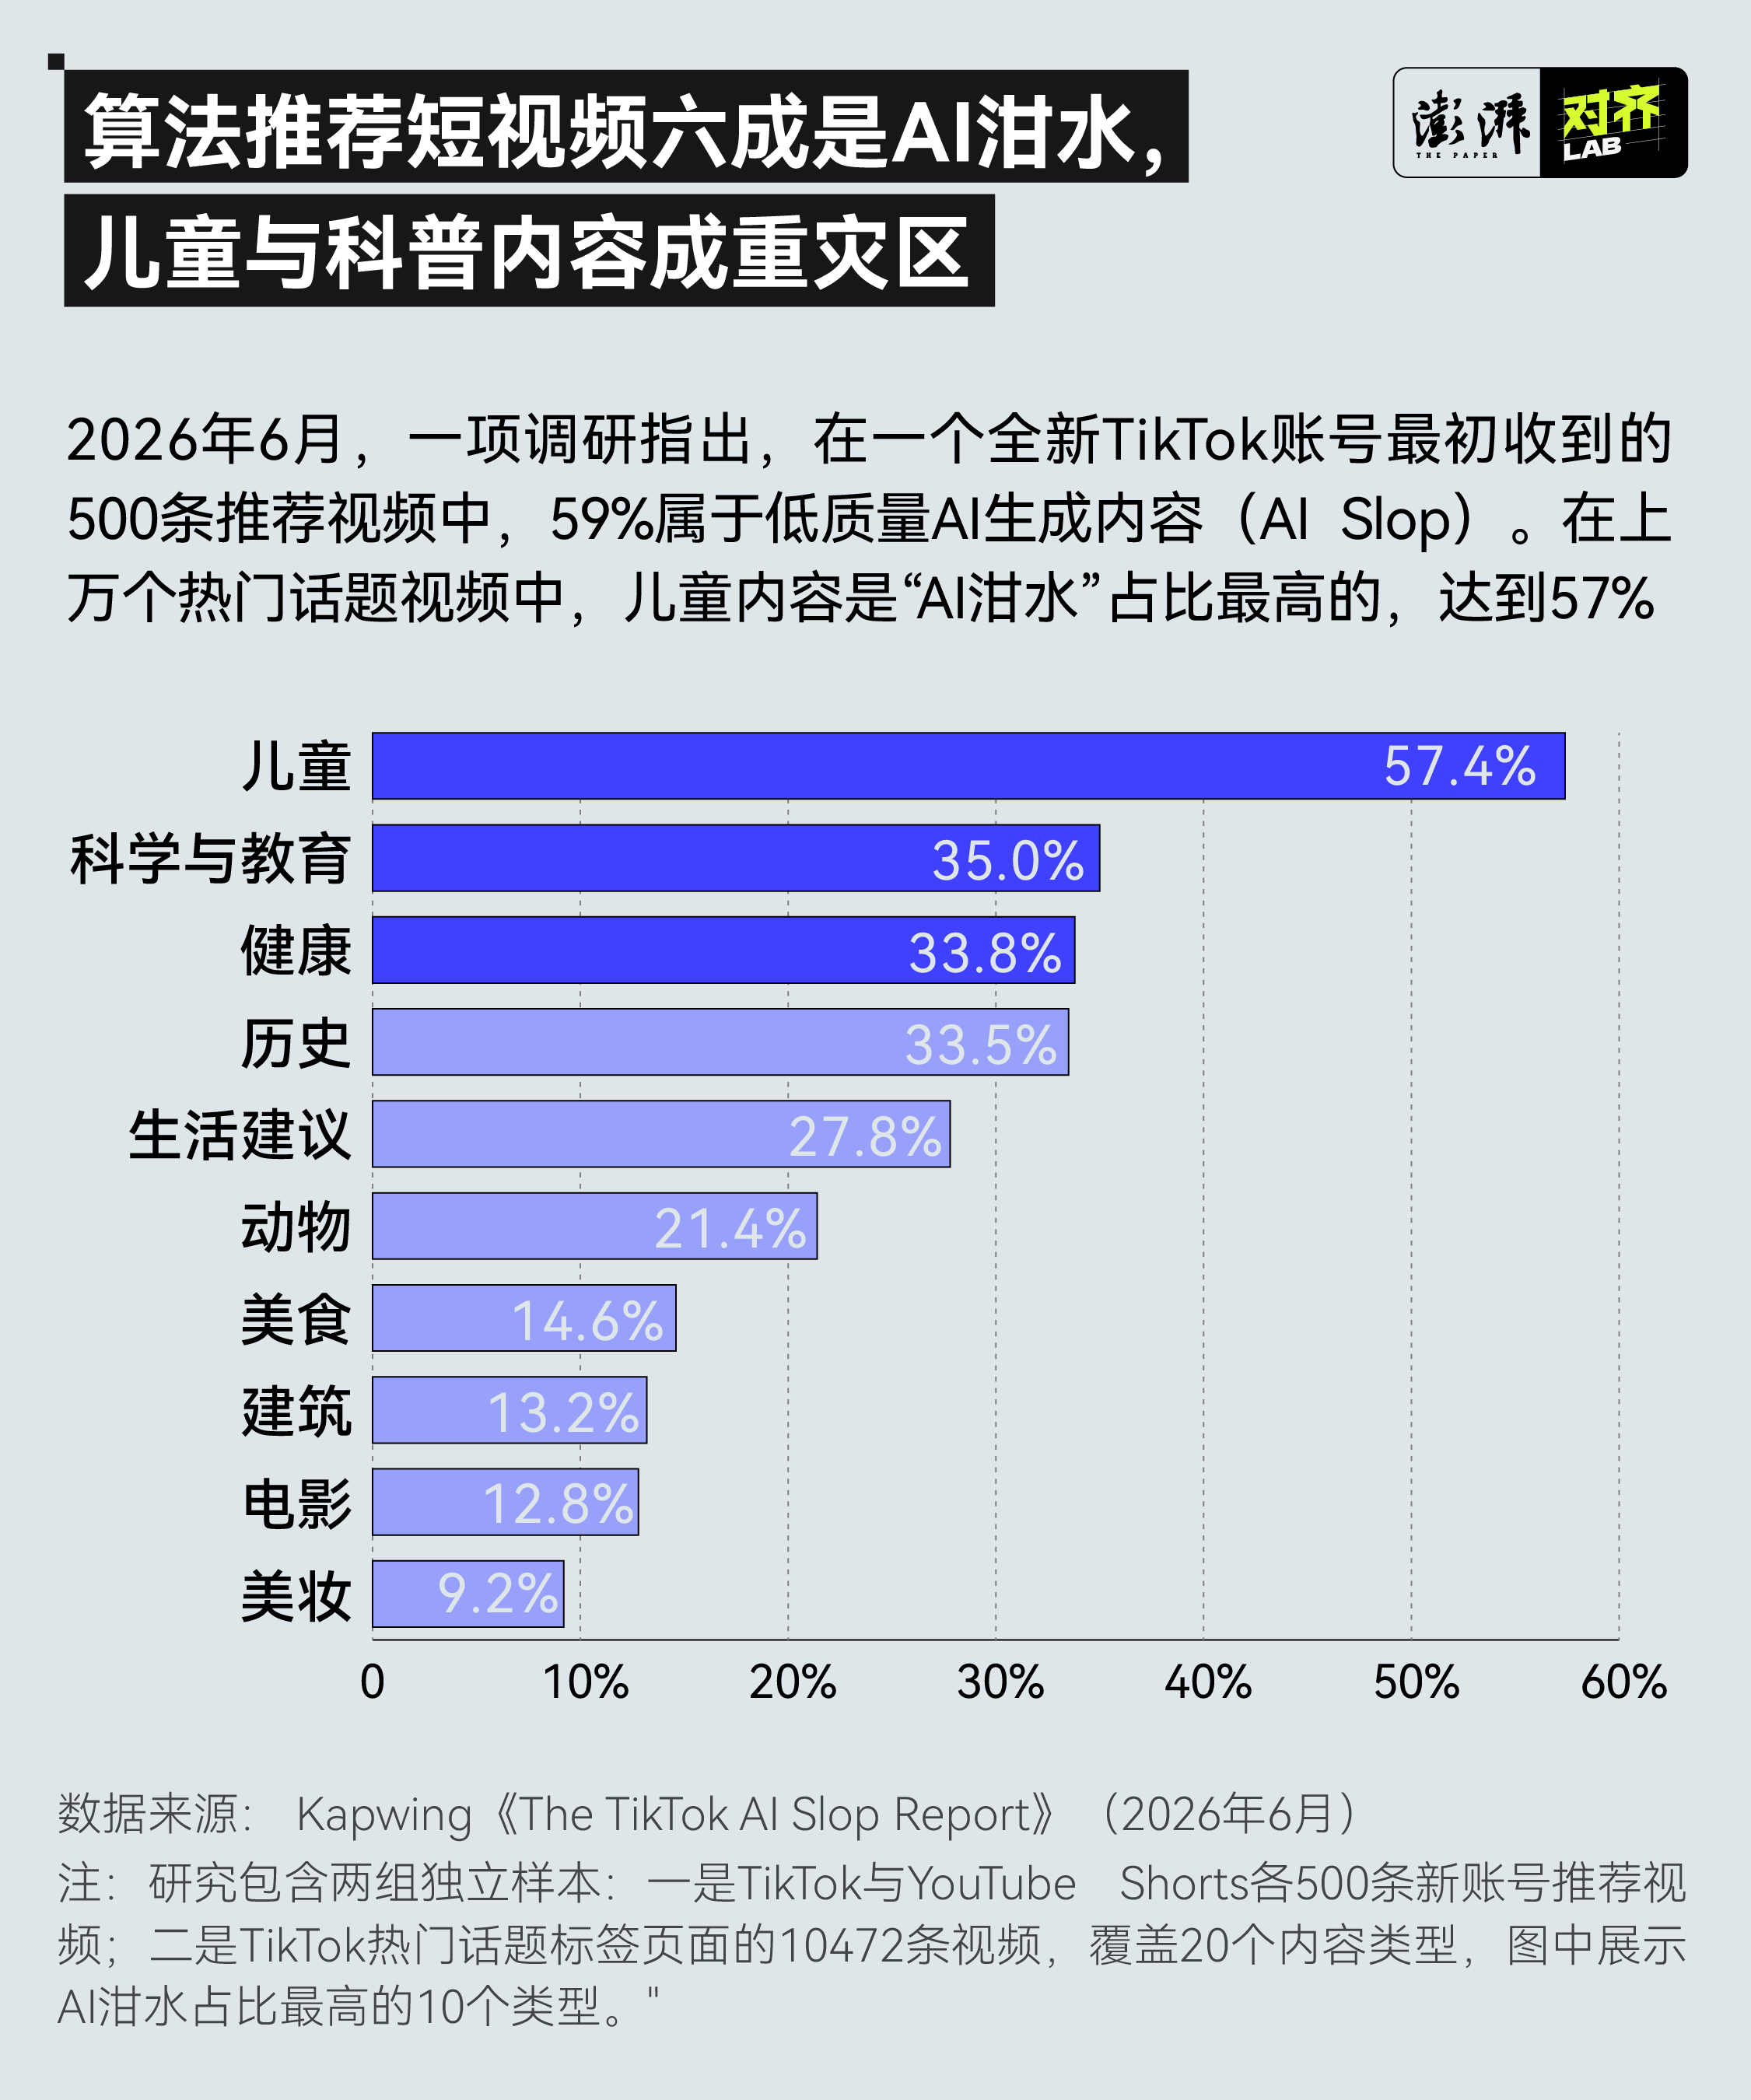
先看一组渗透率数据。视频编辑平台Kapwing在2026年6月抽查了TikTok上10472条热门标签视频。儿童类内容里57.4%被判定为AI泔水。科学与教育、健康、历史类内容也都超过三成。高知识密度领域反而成了重灾区。
生成成本趋近于零,审核成本没有同步下降。 一个开发者加一套API,几天内能产出覆盖整个生物分类体系的写实贴纸。生成一张假鸟图的边际成本几乎为零,而核验鸟类关键特征需要观鸟专家逐张比对。科普博主已经指出,AI可能画错鸟类的关键特征,写实风格图片一旦被用于识鸟和自然教育,传播的错误知识会直接变成数据污染。
出版机构的账本同样失衡。叶文芳的判断很直接:双头虾属于典型的知识性差错,理应在“三审三校”中被拦截。没拦住,说明审校环节对AI生成内容缺少有针对性的检查标准和操作流程。传统三审三校是为人类作者设计的,编辑默认作者会对事实负责。AI生成内容没有这个默认前提,现有流程自然失效。
| 内容类别 | AI泔水占比(Kapwing抽查) |
|---|---|
| 儿童类 | 57.4% |
| 科学与教育 | 超三成 |
| 健康 | 超三成 |
| 历史 | 超三成 |
供给端成本被打到地板,需求端审核能力原地踏步,垃圾内容自然从裂缝里涌出来。南方网评论提醒了一个关键分寸:出版机构在插图量大的丛书上引入AI本身无可厚非,问题出在生成后不审核。批评对象是流程缺失,不是技术本身。
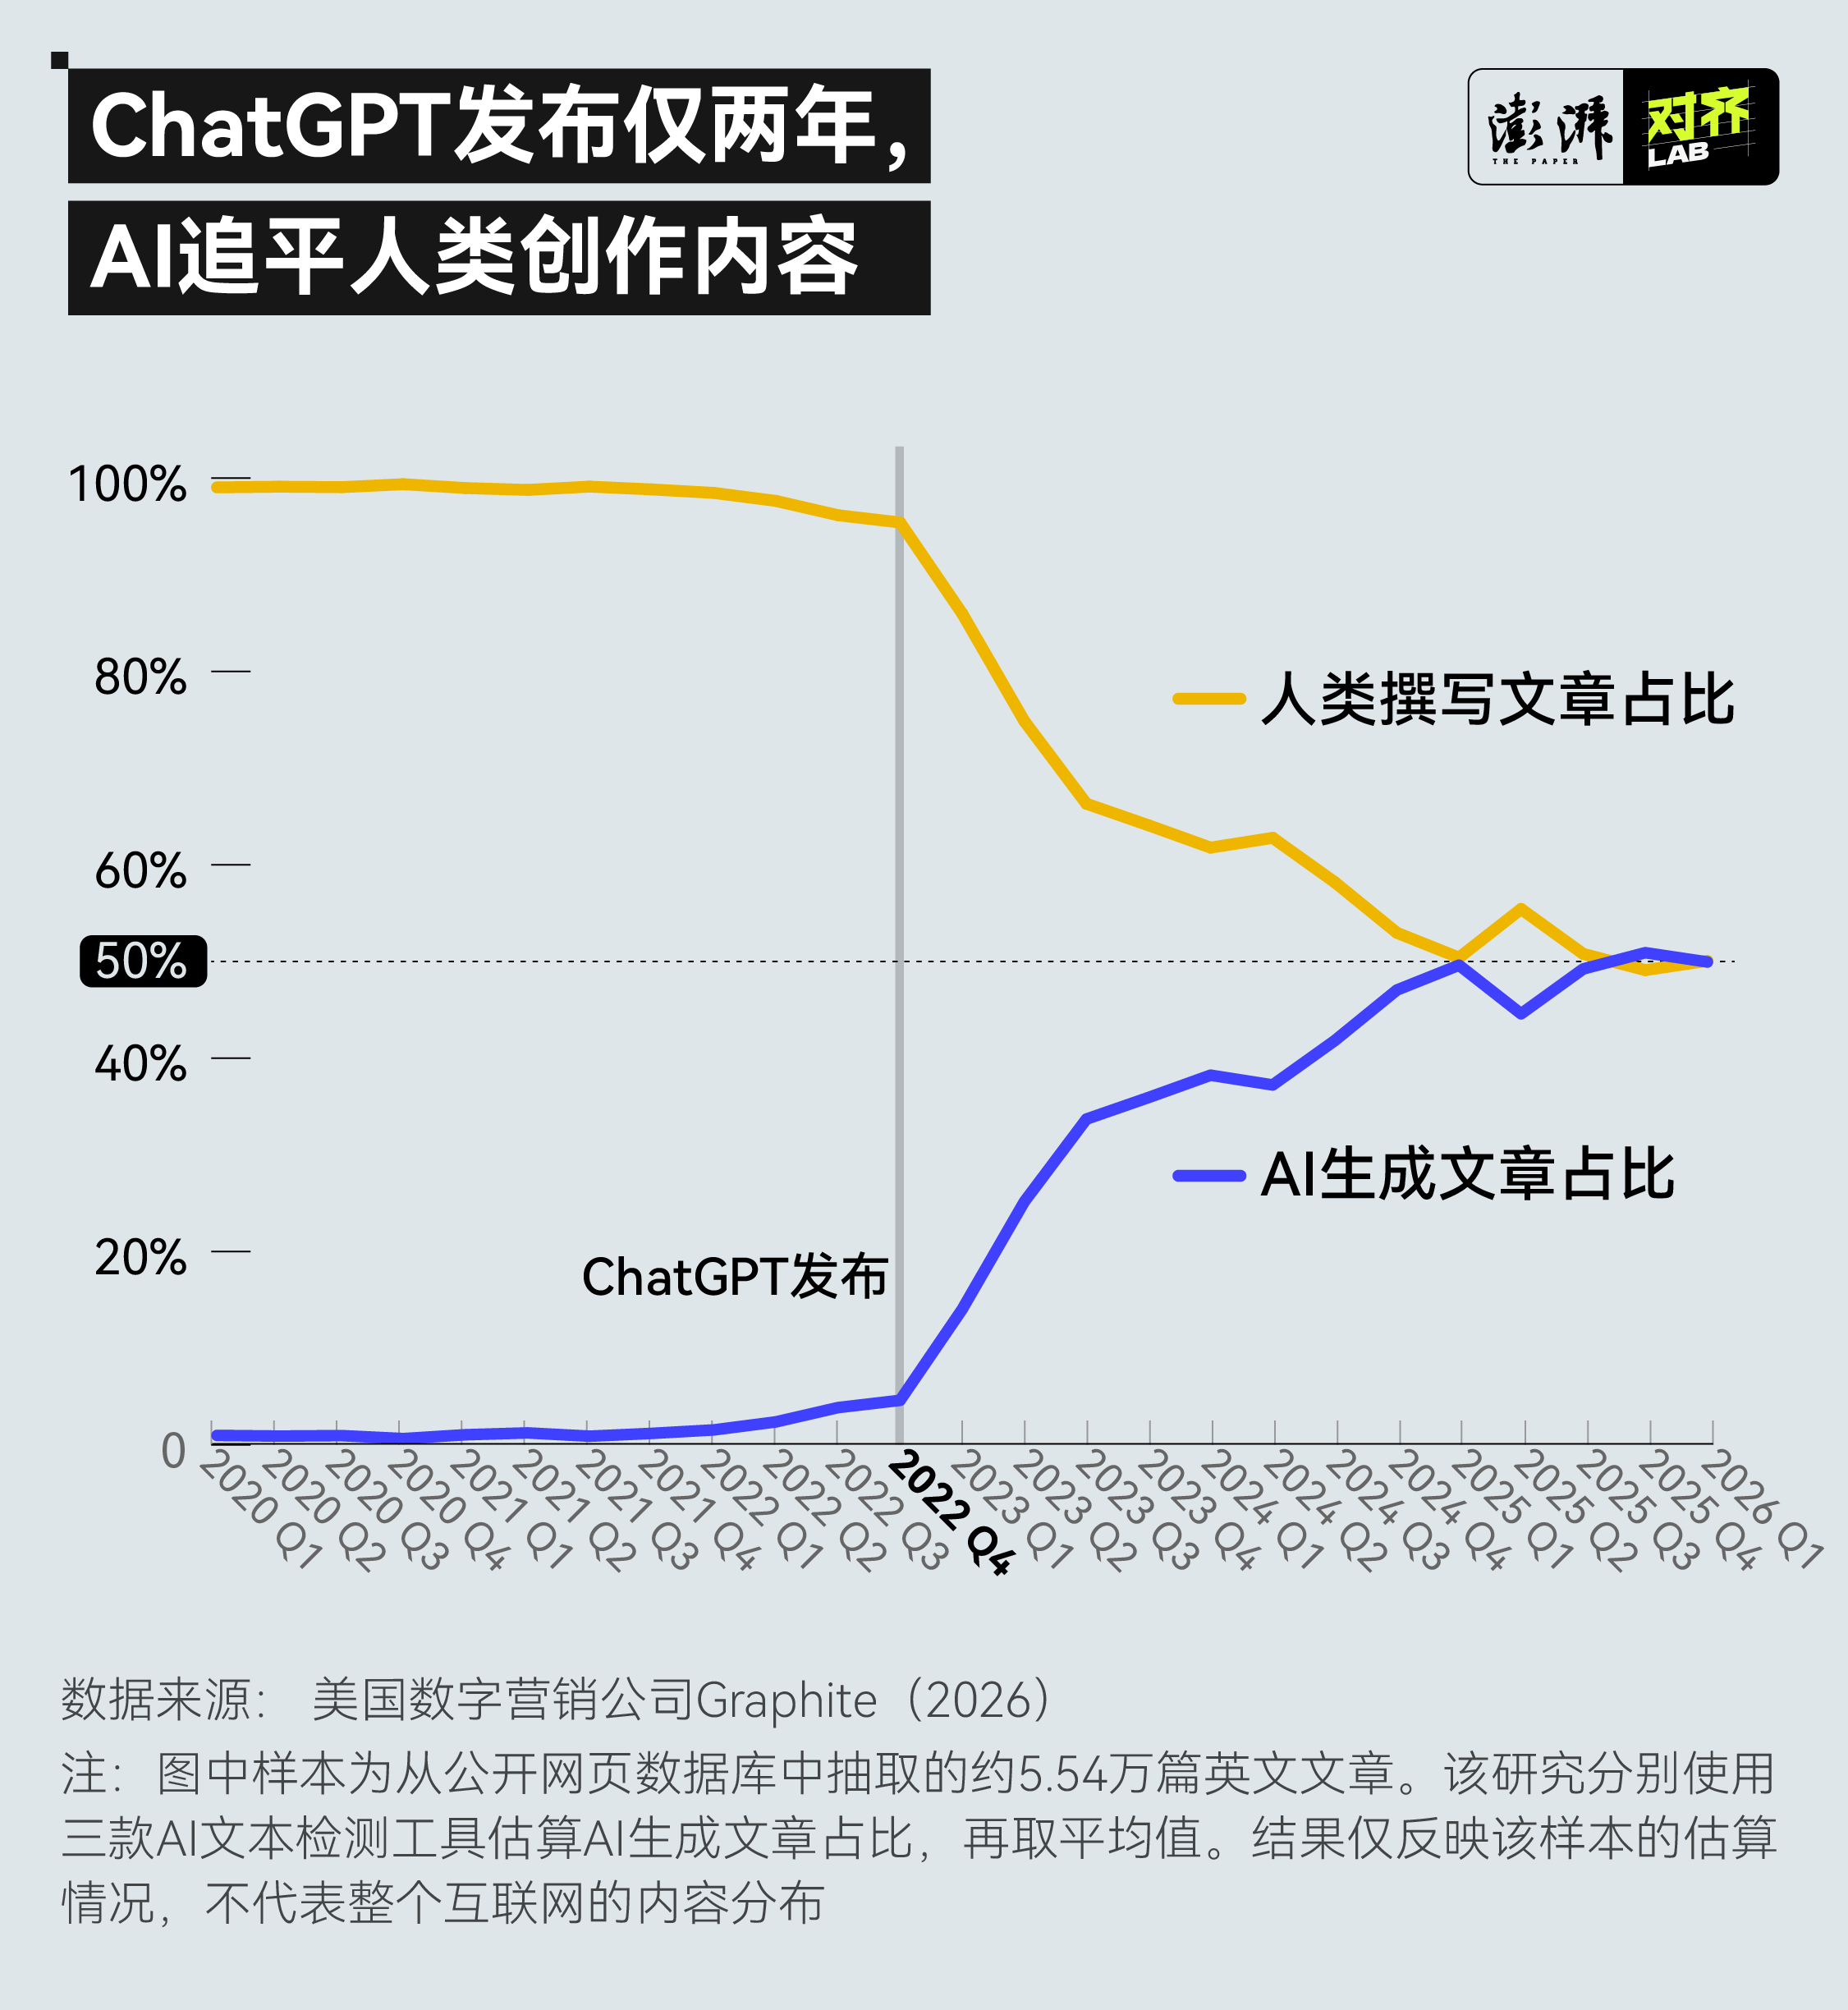
当这些错误内容被大量生产并留在网上,它们不会只停留在平台层面,而是会进入下一轮模型训练。
错误被训练进下一轮模型:知识污染的不可逆循环
错误内容不会停在平台页面上。下一轮大模型的训练语料,很大一部分就来自公开互联网抓取。AI生成的“双头虾”和假鸟类贴纸一旦留在网上,就可能被爬虫收进新的训练集。上一轮模型的错误输出,变成下一轮模型的训练输入。污染不是一次性的,它会自我复制。
叶文芳提出的三项前提,恰好标出了这个循环的三个断点。标识可识别,意味着AI生成内容能被训练管线自动过滤。内容可核验,意味着错误在进入语料库前有机会被拦截。责任可追溯,意味着污染发生后能找到源头并追偿。当前三项前提在出版流程里都未落地,在互联网内容生态里更接近空白。AI生成内容没有统一标识,平台审核不核验事实,训练数据抓取方也无力追溯每一条内容的生成方式。三个断点全部失守,错误内容就顺着“生成—发布—抓取—训练—再生成”的路径循环起来。
南方网评论把儿童看“双头虾”比作对尚未完善的世界观“投毒”。这个比喻放在训练数据上同样成立,而且更隐蔽。儿童至少还有家长和老师可以纠正,模型训练管线没有这种纠错机制。错误图片进入训练集后,可能被当成正常样本学习,模型在概率上更倾向于生成类似的错误。更麻烦的是,污染源无法定位。传统谣言可以找到首发账号,AI泔水经过多次抓取、混洗、再生成后,原始出处早就模糊了。
目前还没有直接证据证明“双头虾”或那批鸟类贴纸已经被用于模型训练。公开训练数据集的构建方通常不披露具体抓取清单,外界无法验证某一条错误内容是否进入了某一次训练。但AI训练语料普遍从公开网络抓取,缺乏标识的AI生成内容回流训练集是结构性风险。这个风险不依赖任何个案被证实,只要生成和抓取两个环节继续运转,污染循环就存在。
普通人怎么自保:把“默认存疑”变成信息消费习惯
叶文芳给AI辅助出版划的三条线,可以直接翻译成普通读者的三个检查动作。
| 检查项 | 要问的问题 | 不满足时怎么办 |
|---|---|---|
| 来源 | 有没有署名作者或承担编辑责任的机构? | 默认存疑,不转发 |
| 可核验性 | 图片或视频是否给出可交叉验证的原始依据? | 当作示意图看,不当作事实 |
| 责任追溯 | 出错后能不能找到负责的人或机构? | 不进入个人知识库 |
一张写实风格的科普图,没有署名、没有拍摄参数、没有标本编号,画得再精细也只配当装饰品。科普博主对那批鸟类贴纸的批评点很具体:AI可能画错鸟类的关键特征,写实风格图片一旦被用于识鸟和自然教育,传播的错误知识会直接变成误导。所以判断标准不是“像不像”,是“能不能查”。读者质疑双头虾时说的那句话更朴素:AI不是不能用,但总要遵守一下基本的法则。这个法则就是可识别、可核验、可追溯。
对普通读者来说,最有效的防线不是学会辨认AI图片的视觉破绽。生成模型迭代太快,今天记住的破绽明天就失效。真正可靠的是改变默认设置:无来源、无署名、无核验路径的写实科普内容,一律默认存疑。 这个习惯不需要任何专业知识,只需要在转发和收藏前多问一句:这张图是谁发的,原始依据在哪,出错了找谁。