纳德拉的2000万智能体,是一道认知测试
纳德拉在播客中提出的“20万员工+2000万智能体”被大量传播为AI替代人类的预言,但原话是一个假设性思维实验。文章拆解这个实验的三个层次:数字本身为何不可信,认知带宽为何成为真正的瓶颈,以及“写清楚目标”为何取代执行成为新的稀缺能力。读者能获得的是判断这个议题的关键变量,而不是一个确定性的结论。
纳德拉的2000万智能体,是一道认知测试
一个假设性数字,为何被当成预言传播
纳德拉在播客中提出的“2000万智能体”,原话是一个条件句。他对霍夫曼说的是:“假如我们未来拥有20万名员工,加上200万个、甚至2000万个智能体参与工作,究竟会变成什么样?”同一段表述在多个中文标题里被压缩成“纳德拉预言微软将有2000万AI智能体”,条件语气消失,假设变成了既成事实。
这种转化并非偶然。一个带“假如”的思维实验不会带来点击,但一个确定的数字可以。传播链条的每一步都在做同一件事:把纳德拉口中的开放问题改写成封闭结论。标题省略限定词,正文再把“设想”替换为“描绘”“引爆”“上岗”,读者最终接收到的信息与原始表述之间已经隔了两层转译。
被省略的恰恰是这个实验最关键的部分。纳德拉不是在宣布一个编制目标,而是在测试一个比例关系:当智能体的数量达到员工数量的一百倍时,管理方式、组织边界、人的角色会发生什么变化。把“2000万”当成预言传播,等于把一道思考题当成答案来读。
有理由认为纳德拉本人也在推动这种模糊化。同一期播客的后半段,他不再停留在“假如”,而是说“微软或许会拥有2000万个智能体”。“或许”仍然不是“将会”,但语气确实从纯粹假设滑向了更认真的表述。加上这个设想出现在微软向6万名员工提供自愿离职方案后不到两周,外界将其解读为某种信号,并非毫无依据。
不过,时间上的接近不等于因果关系的成立。没有任何证据表明那6万人的离职方案与智能体设想之间存在制度性关联。更谨慎的判断是:纳德拉在利用这个极端配比制造认知冲击,而传播者则利用这种冲击制造确定性。两者合谋的结果,是公众讨论的起点从“如果这样会怎样”变成了“已经这样了怎么办”。
真正的瓶颈不是智能体数量,是人的认知带宽
纳德拉在播客里提供了一个比“2000万”更值得拆解的细节:他自己试过同时跑100个智能体。具体做法是打开100个命令行会话,每个会话里运行一个独立智能体,有的在抓取欧盟AI法案原文生成合规清单,有的在协调Teams、Outlook和Power BI做销售复盘,还有一个守在Azure日志后台,提前37分钟预警微服务链路异常并附上三套回滚方案。

这个演示的真实性无法独立验证,任务类型、持续时间、失败率都没有披露。但纳德拉由此得出的判断值得认真对待。他说,管理100个智能体的认知负担,不亚于带一支小型创业团队。
这句话把问题从“AI能做什么”推到了“人能管多少”。当智能体并行运行时,管理者要同时完成三件事:理解每个智能体当前的任务状态,判断它的输出是否可信,以及在出现异常时决定是否干预、怎么干预。这三件事消耗的是同一种资源——注意力。
注意力的消耗不是线性的。管理10个智能体,只需要跟踪10条任务线;管理100个,不仅要跟踪100条任务线,还要跟踪它们之间的交互、依赖和潜在冲突。一个智能体的输出成为另一个智能体的输入,错误会在链条中被放大,而定位问题需要同时回溯多个并行进程。智能体数量线性增长,认知负担却可能以更快的速度上升。
这正是纳德拉实验中最有价值的信息。它说明当前人机协同的瓶颈不在AI的执行力,而在人类管理者的注意力与判断力带宽。一个智能体可以不知疲倦地运行,但监督它的人会累,会漏掉信号,会在信息过载时做出更差的干预决策。
这个结论需要限定边界。“100个智能体不亚于带创业团队”是纳德拉的个人自述,而且他的100个智能体任务差异很大——合规分析、销售复盘、系统监控混在一起,复杂度远高于同质化任务。如果100个智能体都在做同一类简单工作,管理负担可能远低于带一个创业团队。认知负担的严重程度高度依赖任务类型、异质性和耦合度,不能从一次个人测试推广为普遍规律。
但这个限定并不削弱核心发现。纳德拉的测试揭示了一个此前被“人机协同”口号遮蔽的问题:当智能体数量达到一定规模,最先撑不住的不是算力,不是模型能力,而是人的认知结构。企业如果只是增加智能体数量,而不改变管理方式,瓶颈会迅速从技术端转移到人的注意力端。
当执行被自动化,写清楚目标成了新的知识产权
纳德拉在播客里给出了一个更具体的判断:把真正在意的目标和评估标准想清楚、写清楚,就是新的知识产权。这句话指向一个正在发生的转移——当token变得充裕,执行本身不再构成壁垒,稀缺性会向上游移动。他同时提出,在token充裕的时代,谁能更高效地使用token达成有意义的结果,谁就会领先。两条判断放在一起,指向同一个结论:智能体承担执行之后,人类的核心价值从“做得好”转向“定义得准”和“判断得对”。

这个转移的因果链并不复杂。token充裕意味着调用模型能力的成本持续下降,执行环节的差异化空间被压缩。过去一个员工的价值可能体现在操作熟练度、处理速度和经验积累上,这些优势在智能体面前变得容易被复制。竞争于是向上游迁移到两个环节:一是定义目标,把真正要解决的问题和衡量标准写清楚;二是评估结果,判断智能体的输出是否可信、是否真的达成了目标。这两个环节的共同点在于,它们都需要人类对“意义”做出判断——什么值得做,什么算做好。智能体可以优化执行路径,但无法自行决定目标本身。
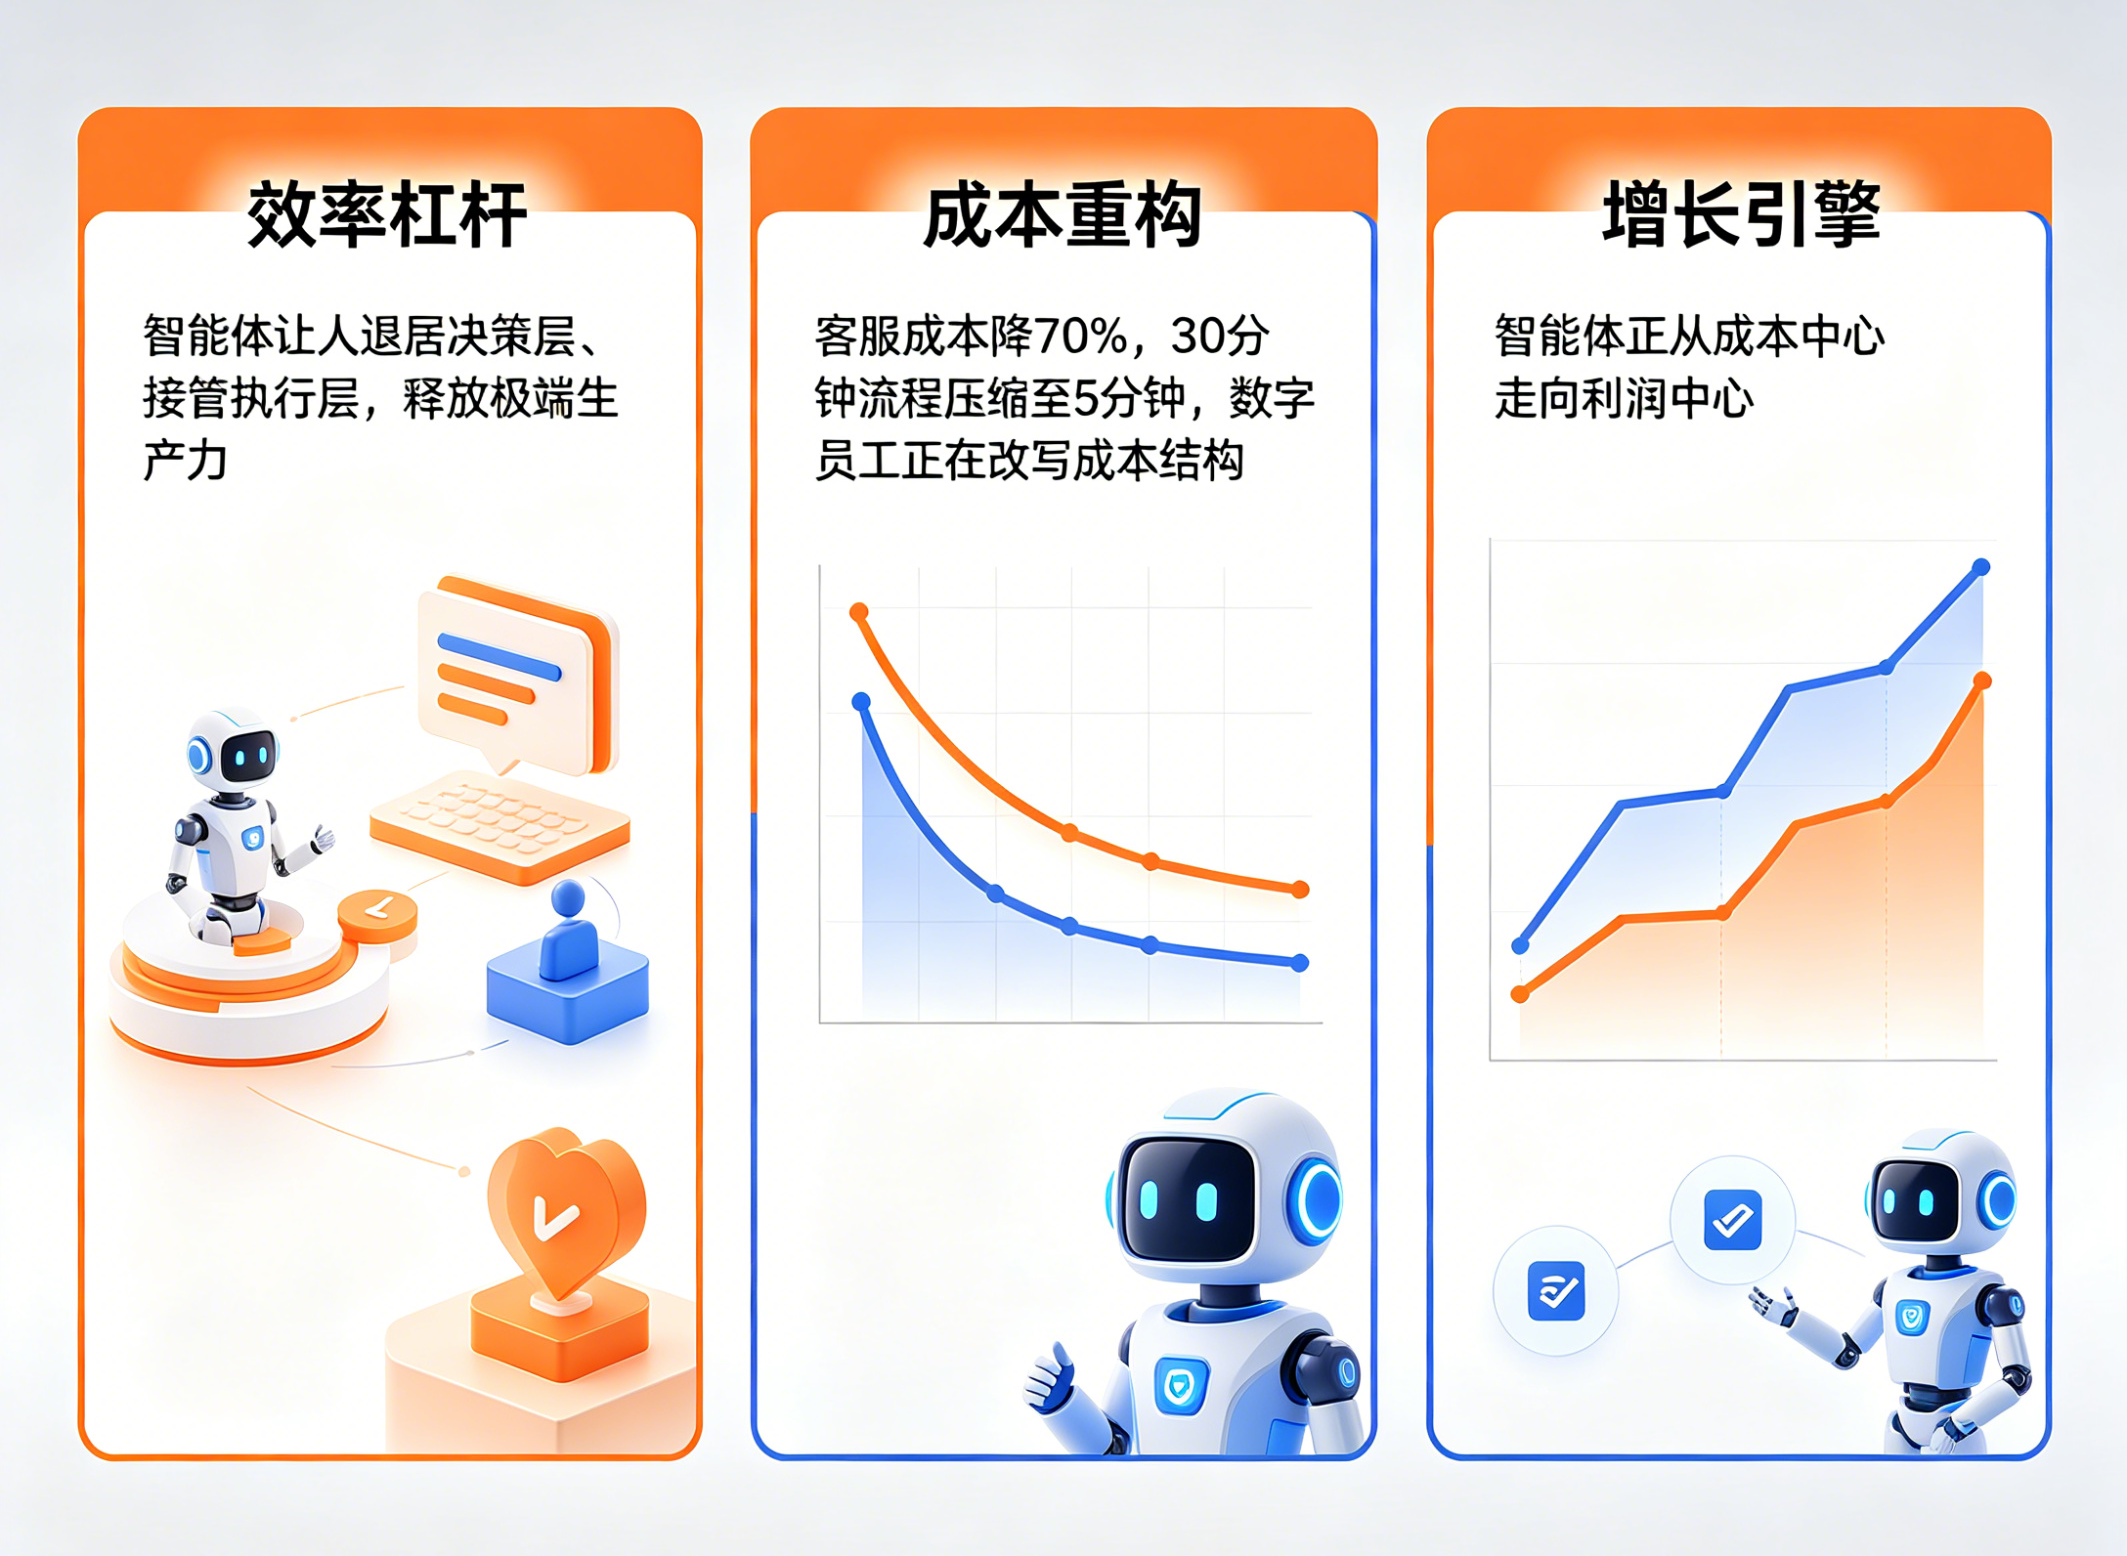
这个判断有一个隐含前提:智能体真的能可靠执行被清晰定义的任务。如果输出质量不稳定,需要大量人工修正,那么“写清楚目标”的投入产出比会大打折扣,执行能力仍然重要。纳德拉的表述建立在模型能力持续进步的基础上,而这一基础并非在所有场景下都成立。
另一个需要划清边界的地方是“意义锚点”这类概念。有评论文章将纳德拉的观点延伸为“企业竞争力=人类创造力×智能体执行力×协作熵减力”,并据此提出职场护城河取决于能否成为“意义锚点”。这个公式和概念来自文章作者的解读,并非纳德拉原话。它试图把“定义目标”和“判断结果”包装成一个更感性的角色标签,但这样做反而模糊了核心能力的可操作性。纳德拉所说的新知识产权,具体指的是目标和评估标准的清晰表达,而不是某种模糊的人格特质。
编程领域的演化被他用来佐证这个方向。纳德拉认为,编程领域的演化预示所有工作的未来方向。在软件开发中,需求定义和验收标准一直是比编码本身更接近价值源头的环节。如果这个模式向其他领域扩散,那么“写清楚要什么”和“判断做得对不对”确实可能成为比“亲手做”更稀缺的能力。但扩散的范围和速度取决于任务类型:对创造性、模糊性和价值判断要求越高的工作,上游能力越重要;对标准化程度越高、结果越容易验证的工作,执行环节的替代越彻底,上游定义的价值反而可能被流程本身吸收。
纳德拉真正在做的,是重新定义“公司”的边界
纳德拉真正想撬动的,不是微软的岗位数量,而是企业管理者对“公司”这个概念的默认理解。传统上,一家公司的边界由雇佣关系划定:谁在工资单上,谁就是组织的一部分;谁不在,谁就是外部供应商、外包商或工具。这条边界清晰、可审计,也是几乎所有管理制度——考核、晋升、预算、法律责任——的底座。
智能体打破了这条边界。它们不领工资,不占编制,不进入组织架构图,却可以承担实质性的工作产出。当纳德拉设想20万员工与2000万智能体协同时,他给出的不是一个更大的团队,而是一个在数量上完全失衡的混合系统。在这个系统里,如果继续用“员工集合”来定义公司,2000万这个数字就没有位置;如果承认智能体是组织的一部分,那么“公司”的含义就变了。
纳德拉自己给出了答案。他明确说过,AI不是一种技术,而是公司的未来。这个表述比“AI将改变组织结构”更进一步——后者仍然把AI当作外部力量,作用于一个既有的组织;前者则把AI本身视为组织的基础构成单元。按照这个逻辑,智能体不是公司买来的工具,而是公司的一部分,就像个人电脑普及后,键盘和文字处理软件不是打字员的外部设备,而是工作方式本身。

这个类比指向的命题相当激进。纳德拉用它来说明,上世纪80年代没有人相信未来每天会有40亿名“打字员”坐在办公室敲键盘,但个人电脑让每个人都在某种程度上承担了打字员的工作。岗位消失了,能力却没有消失,而是扩散到了所有员工身上。把同样的逻辑套到智能体上,结论不是“智能体取代员工”,而是“智能体成为每个员工工作方式的一部分”。公司因此不再是一个由人组成的集合,而是一个人类与智能体混合运行的系统。
但这个判断目前仍是纳德拉的个人观点,微软并未在官方层面将智能体定义为“组织成员”。而且“打字员消失”的类比存在一个明显缺口:打字员岗位消失后,人并未退出办公室,而是转向了更高阶的认知工作。智能体是否同样会创造出新的、尚未被定义的人类岗位,还是这次真的不同,目前没有可靠证据能给出答案。