25万页AI黎曼证明卡在哪:编译通过离证明成立还差两关
Anthropic数学家Levent Alpöge宣布与Claude合作证明黎曼猜想,但只发布4页说明和1740万行Lean代码,打印超25万页。MIT数学家确认代码编译通过,但这只满足逻辑自洽,离证明成立还差符号审计和内核验证两关。
25万页AI黎曼证明卡在哪:编译通过离证明成立还差两关
25万页证明只给了4页说明和14个压缩包
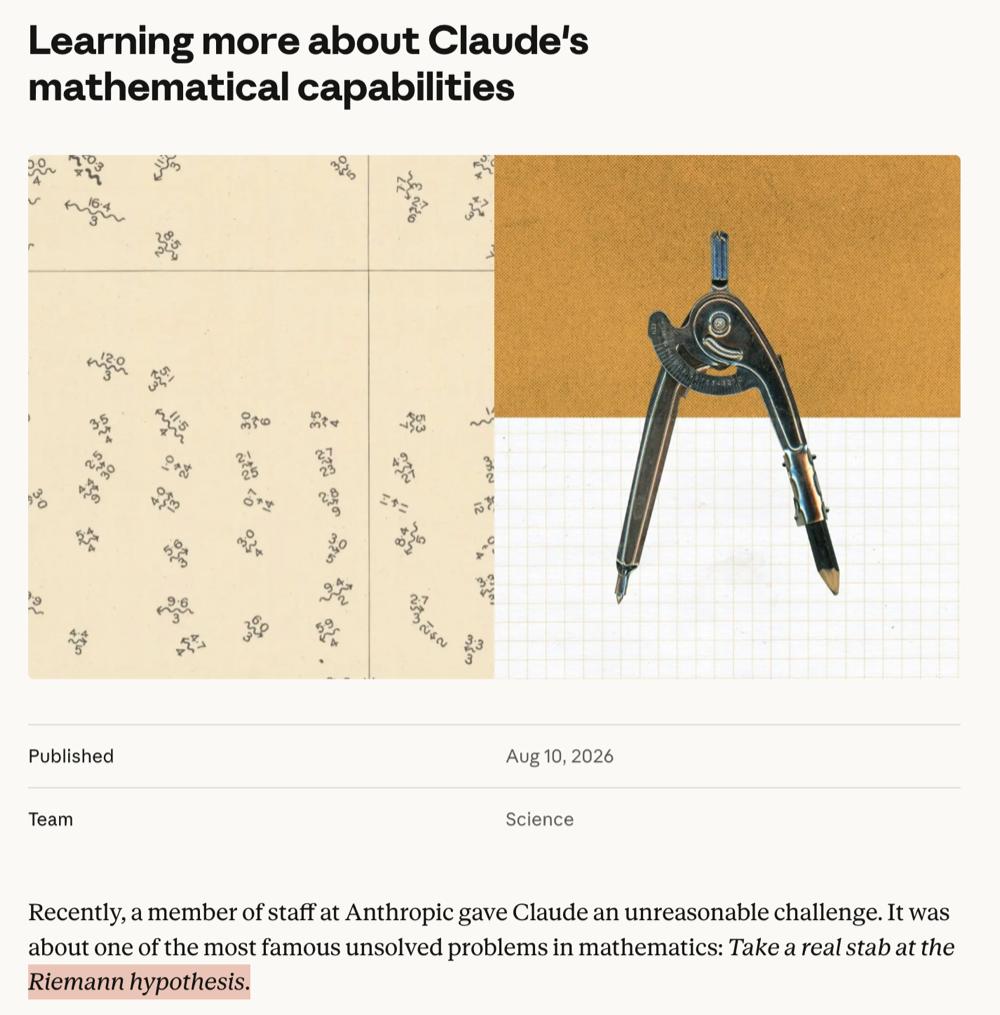
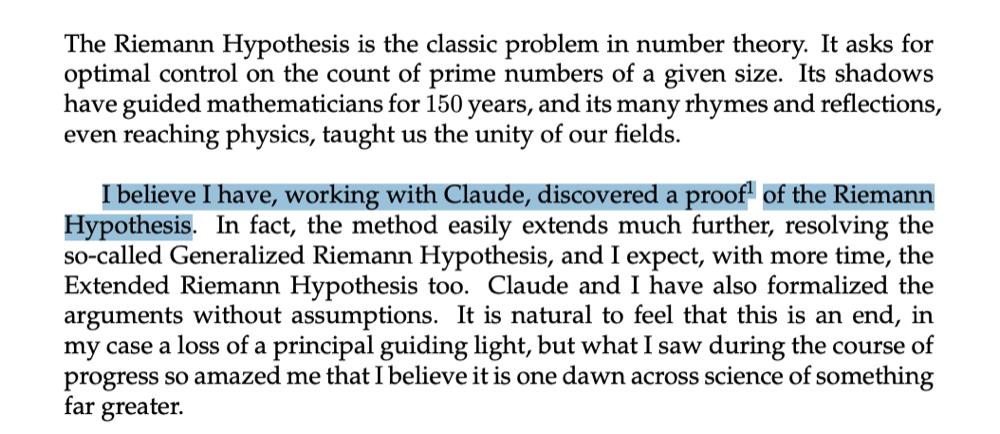
2026年11月,Anthropic数学家Levent Alpöge宣布与Claude合作证明了黎曼猜想。他没有投期刊,只放出4页PDF说明和14个压缩包,包里装着1740万行Lean代码。把代码打印成人类可读文本,超过25万页。
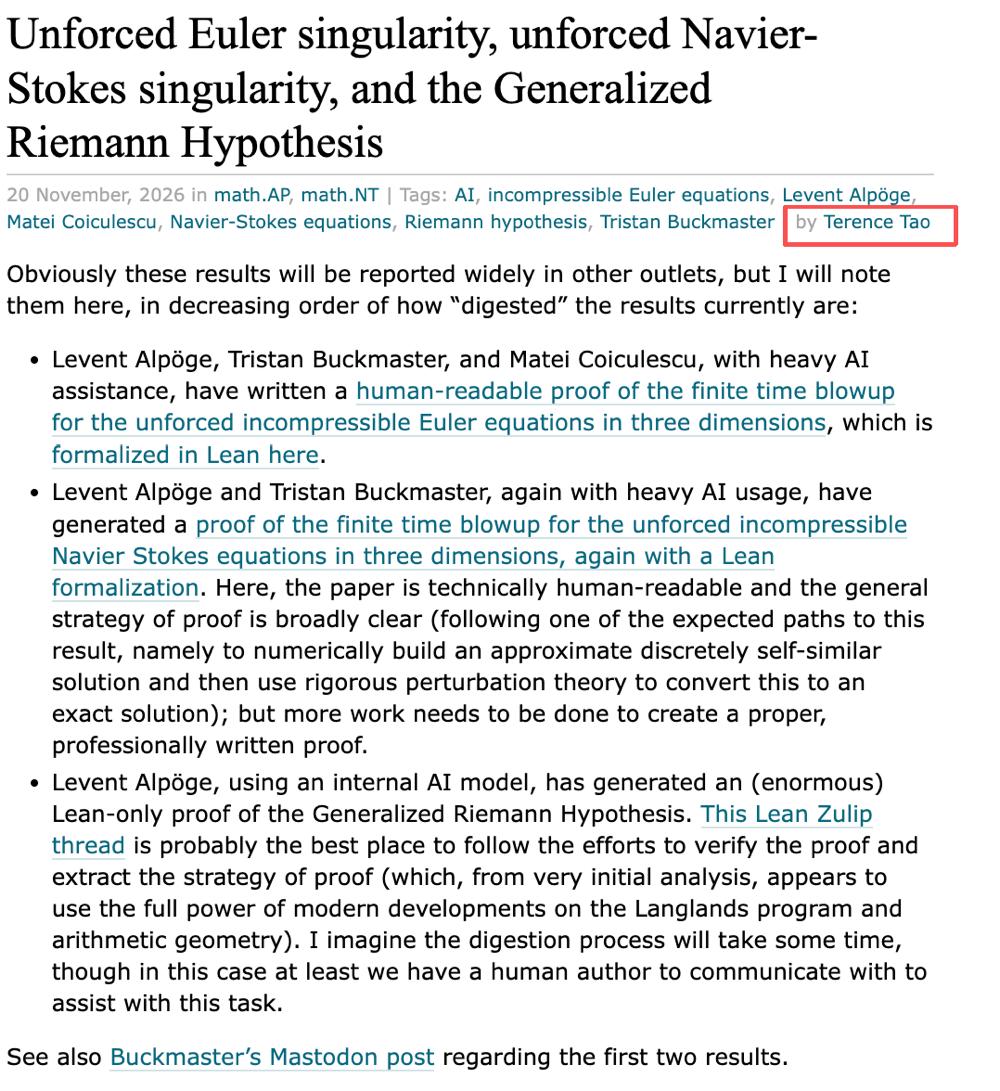
这套发布形式本身已经决定了核验路径异常。 传统数学证明靠同行通读论证,25万页意味着没有任何单个数学家能读完。核验只能依赖机器编译和分布式协作,而这恰恰是数学共同体尚未建立的信任机制。
先把数字摆齐:
| 对象 | 规模 | 可核验方式 |
|---|---|---|
| 人类可读文本 | 超25万页 | 无单个数学家能通读 |
| Lean代码 | 约1740万行 | 机器编译、逻辑检查 |
| 压缩包 | 14个分卷 | 下载后本地展开 |
| 说明文档 | 4页PDF | 仅概述思路 |
Alpöge自己称那25万页是“不可读的AI slop”,所以不发布。发布者主动放弃了让同行阅读证明路径的可能,只交付可编译代码。
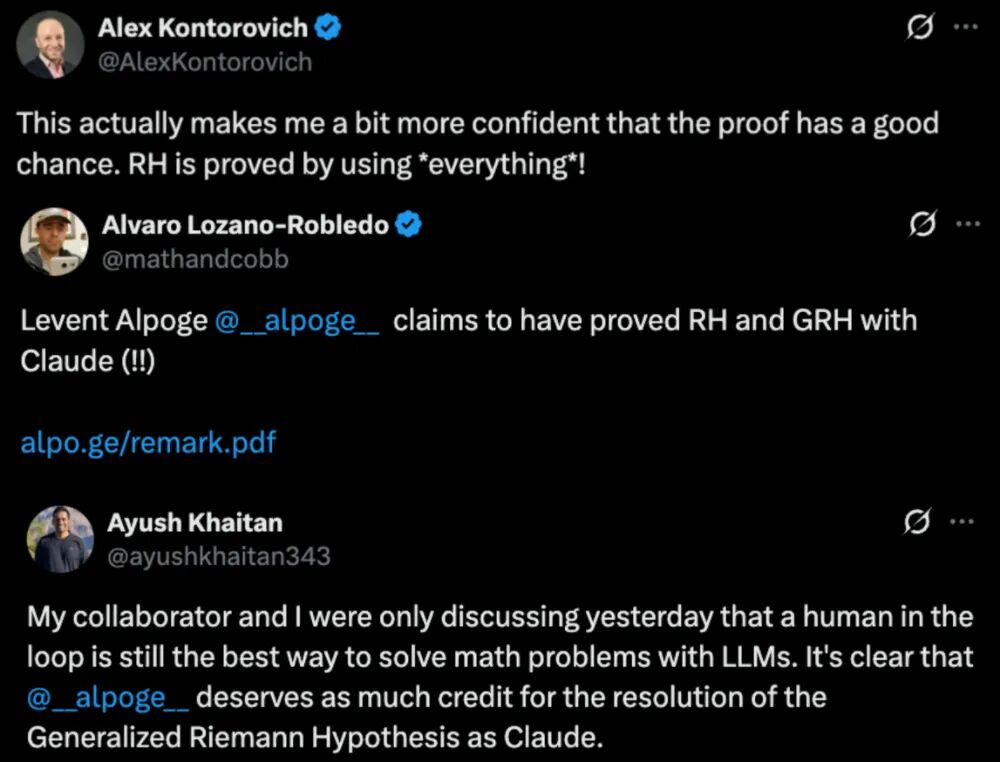
MIT数论学家Andrew Sutherland在声明当天就完成了编译,确认代码通过底层逻辑检查,只调用3条最基础的标准公理。Sutherland说“存在猫腻的可能性约等于零”。但他说的是代码逻辑自洽,黎曼猜想是否成立是另一回事。
代码能编译,只证明形式化过程的每一步都符合Lean的推理规则。它不回答两个更根本的问题:代码是否真的编码了黎曼猜想的完整证明,以及AI生成的证明路径是否被数学共同体接受为“证明”。
这里有一道此前数学界从未面对的门槛。传统证明的可接受性建立在两个支柱上:人类专家能理解关键思路,同行能在合理时间内核验论证。25万页的规模同时击穿了这两根支柱。
核验瓶颈不在代码能否编译,而在数学共同体尚未建立对超大规模AI生成证明的信任机制。
编译通过到证明成立之间,隔着的是整个数论界对“什么算被证明”的重新谈判。
代码编译通过,离证明成立还差三道关
代码能跑通,说明1740万行Lean代码在形式系统中每一步推理都自洽。但自洽和证明黎曼猜想,中间还隔着两道没人翻过的坎。
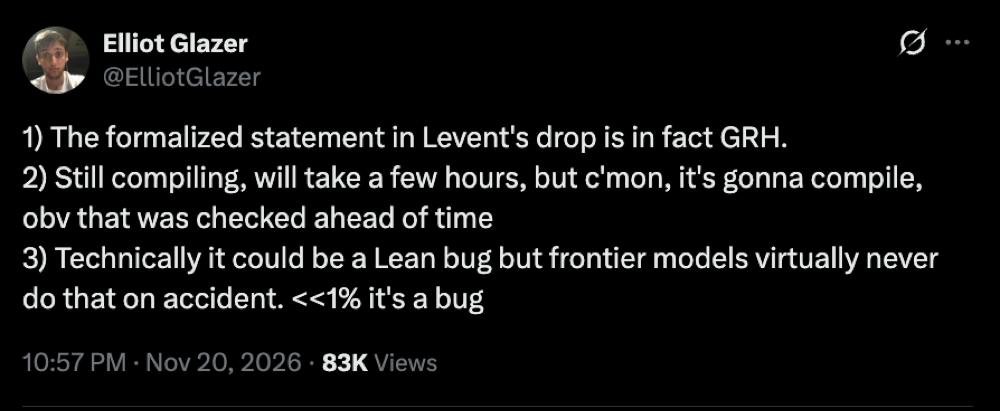
帝国理工的凯文·巴泽德把核验拆成三条标准:推理步骤在Lean中成立、证明的对象确实是黎曼猜想本身、排除符号定义被篡改和内核bug被利用。萨瑟兰确认的只是第一条。这条最容易,机器跑一遍就有答案。
第二条直接戳中要害。25万页证明的核心声明藏在哪里?代码开头声明的定理,和黎曼猜想的标准表述是否逐符号等价?Alpöge放出的4页说明不足以回答这个问题。数学家需要从1740万行代码里定位最终定理,再逐层回溯到黎曼猜想的经典定义。25万页的体量让“人读”变成奢望。
第三条同样棘手。Lean内核经过多年验证,但任何软件系统都可能存在未被发现的缺陷。一个专门针对黎曼猜想证明构造的代码,踩中内核bug的可能无法被“编译通过”排除。符号篡改的风险同样真实——改一个定义,整个证明可能滑向一个更弱的命题。
| 巴泽德的核验标准 | 当前状态 | 核验方式 |
|---|---|---|
| 推理步骤在Lean中自洽 | 已通过 | 编译+独立检查器 |
| 证明对象是黎曼猜想本身 | 未触及 | 需人工比对符号定义 |
| 排除符号篡改和内核bug | 未触及 | 需审计代码+内核 |
Jordan Ellenberg在3B1B播客里给过一个极端参照:如果黎曼猜想的Lean证明长达200亿token且没人看得懂,那它就不算证明,他也不在乎这种证明是否存在。25万页还没到200亿token,但方向一致——规模本身在摧毁人类可理解性。
形式化验证的支持者会反驳:如果Lean内核可信,机器检查比人类审稿更可靠。这个反驳在第一层成立,在第二、三层失效。机器检查的可靠性前提是内核无bug、符号未被篡改,这两个前提恰恰需要人类确认。形式化验证没有消灭信任问题,只是把信任从证明者转移到了内核和符号定义上。
萨瑟兰说的“存在猫腻的可能性约等于零”,限定在第一条标准内。巴泽德提醒的另外两条,目前没有任何人声称已经完成。编译通过是必要的第一步,离“黎曼猜想被证明”还差两关,而这两关没有现成的自动化工具可走。
6周AI证明与12年人工证明:核验路径的分叉
阿尔珀格的声明发布几小时后,美国数学学会主席瓦基尔紧急公告了第二套方案:马苏洛的广义黎曼猜想证明草稿,940页,纯人力,未用AI。两套证明同时浮出水面,核验路径却走向两个方向。
940页可以拆给多位专家分头审阅,25万页代码没有同样的拆解路径。 规模差异直接改变了核验的可行性。
| 维度 | 马苏洛人工证明 | 阿尔珀格AI证明 |
|---|---|---|
| 篇幅 | 940页论文草稿 | 25万页文本,1740万行Lean代码 |
| 工具 | 无AI | Claude |
| 时间投入 | 12年 | 不到6周 |
| 核验状态 | 康拉德持续反馈,原计划一年润色后再发布 | 代码编译通过,仅完成第一步 |
马苏洛的940页远超常规数学论文。但康拉德几个月来一直在提供详细反馈,瓦基尔转述的阶段性评价是“进展顺利”。这套核验路径依赖人类可读的数学推理,专家可以分章节认领、交叉检查、在研讨会上逐段过。慢,但每一步都落在共同体熟悉的协作框架里。
阿尔珀格的25万页代码没有这个选项。1740万行Lean代码无法拆给几十位数论专家分头审阅——读懂每一行需要的形式化验证训练,数论界里同时具备的人极少。核验的前提是先接受一套机器验证的信任框架:Lean内核可信、符号定义未被篡改、代码确实对应黎曼猜想本身。这三条没有一条是数论共同体现成的共识。
马苏洛的证明同样未经完整同行评审。康拉德的“进展顺利”只是阶段性判断,不能因为人工证明更符合传统路径就默认它更可靠。但两套证明的核验难度不在一个量级:940页的人工证明,数学界知道怎么组织审阅;25万页的代码证明,数学界还没想清楚该由谁、用什么流程、以什么标准来确认。
阿尔珀格用6周跑完了马苏洛12年的推导路程。但核验是共同体对证明的集体确认,前者可以靠算力加速,后者没有现成的自动化工具。
数学界缺的不是验证工具,是信任协议
2026年8月,Claude辅助数学家把临界线上零点比例下界从41.6%推到67.2%。数论界没人喊“AI滚出数学”。到了11月,阿尔珀格扔出25万页完整证明,阻力才真正出现。
问题不在AI,在“完整证明”四个字的重量变了。
零点比例的进展是增量成果,审稿人盯的是推导链上新增的那一段。67.2%的下界证明有明确的起点和终点,人类团队可以逐行检查Claude贡献的部分。完整证明要求整个数学共同体承认:从公理到黎曼猜想,中间1740万行Lean代码无懈可击。
Conrey说这是“人类历史上的一个里程碑式时刻”,但他只看过阿尔珀格的个人声明,没碰过那14个压缩包。Ellenberg在3B1B播客里的态度更硬:200亿token的证明如果没人看得懂,就不算证明。这两位对“什么算被证明”给出了完全不同的答案,共同体内部尚无共识。
数学界缺的不是验证工具,是信任协议。
Lean内核能跑通代码,Sutherland当天就确认了。但跑通只解决巴泽德三条标准里的第一条:推理步骤成立。另外两条——符号定义确实对应黎曼猜想、内核bug没有被利用——没有任何自动化工具能替代人类判断。
形式化验证把信任从证明者身上转移到了内核和符号定义上。内核是开源项目,理论上可审计,但审计本身需要顶尖形式化验证专家投入。符号定义审计同样棘手:1740万行代码里,一个关键定义被微妙改写,整个证明就可能证明的是另一个命题。
可操作的判断框架只有三个锚点。
| 锚点 | 当前状态 | 谁来做 |
|---|---|---|
| Lean内核独立审计 | 未启动 | 形式化验证专家团队 |
| 符号定义独立审计 | 未启动 | 数论+形式化交叉团队 |
| 人类可理解的核心引理摘要 | 未提供 | 阿尔珀格本人 |
三个锚点缺一个,单方声明就不构成“已解决”。阿尔珀格目前只满足了第一条锚点的部分条件——代码能编译。
Conrey的“里程碑”评价和Ellenberg的“不算证明”判断,中间隔着的是这套协议。没有协议,任何一方的表态都只是个人意见,不构成共同体裁决。
科学网那篇评论说,即使证明最后被找出漏洞,数学界也不亏,因为看到了新解法入口。这话对增量成果成立,对完整证明不成立。完整证明的失败成本更高:如果符号定义审计最终暴露出一个致命改写,浪费的是整个数论界的核验带宽。
后续跟踪只看两个指标: 阿尔珀格是否发布人类可读的核心引理摘要;是否有独立团队公开启动符号定义审计。两个都没有,25万页就只是25万页。