权重开放之后,架构师真正要买的是什么
Kimi K3开源、昇腾0Day适配、异构集群工具出现,让“权重开放”看起来像基础设施化的终点。但证据显示,开放权重只是把成本与风险从模型层转移到了算力与适配层:架构师真正买单的是适配速度、集群形态和生态锁定风险。本文用昇腾与Kimi的适配时间线、部署规格和市场份额数据,拆解这个转移过程,并指出它成立的条件与反例。
权重开放之后,架构师真正要买的是什么
结论先行:你买的不是模型,是适配链的兑现能力
权重开放没有让架构决策变简单,反而把决策重心从“选哪个模型”推向了“选哪条适配链”。模型权重公开只是起点,真正决定部署可行性和长期成本的是硬件厂商、框架团队与模型方的协同速度。Kimi K3权重发布当天,昇腾就完成了推理适配——这个“0Day”背后藏着的,正是架构师真正要判断的东西。
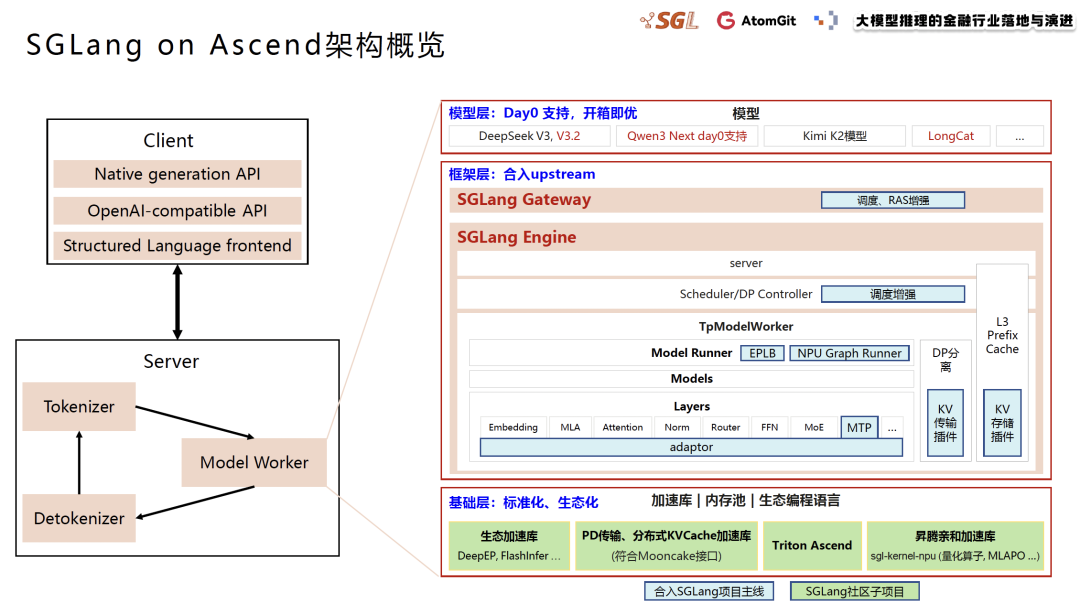
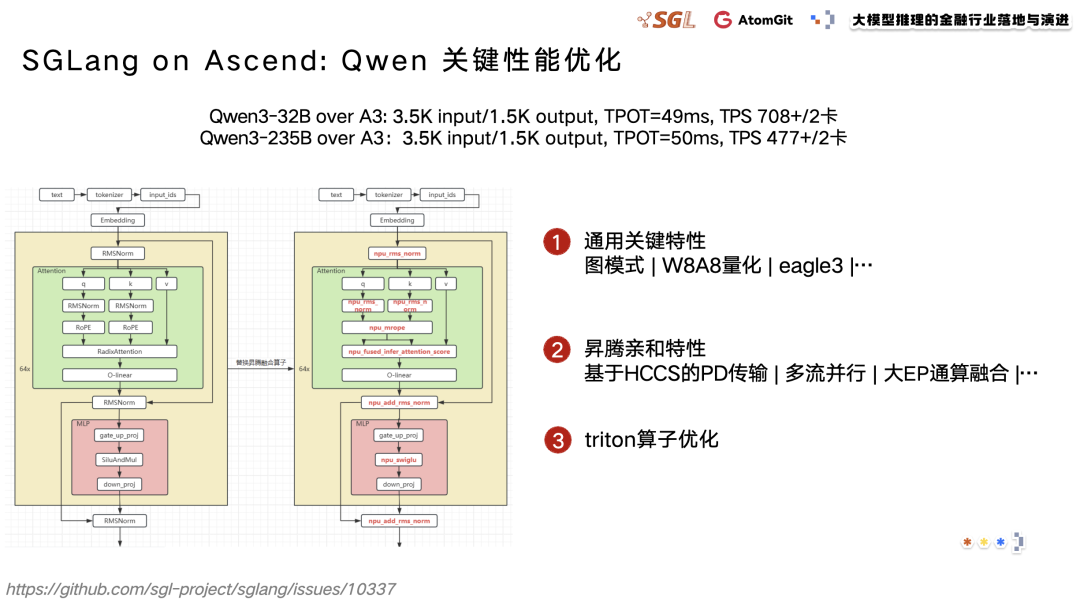
要理解这个判断,先看一个具体事实。2026年11月4日,月之暗面正式公布Kimi K3.1 Pro完整模型权重,昇腾基于vLLM Ascend和SGLang同步实现了0Day推理适配,支持Atlas 800 A3、Atlas 900 A3 SuperPod超节点以及昇腾950超节点系列产品进行推理部署。这不是孤例。更早的Kimi K3在7月27日发布权重时,华为昇腾CANN同样宣布昇腾950全系列和Atlas A3产品支持部署,趋境科技基于SGLang在Atlas A3上完成了Day0推理适配。
两次发布呈现的是同一种模式:模型方前脚公布权重,国产算力方后脚就给出可部署的适配方案。这种速度本身就是一个信号——权重开放之后,竞争的主战场已经从模型能力本身,转移到了“谁能更快让模型在特定硬件上跑起来”。
对架构师而言,这意味着一个微妙但关键的变化。过去选模型,主要看评测分数、上下文窗口、工具调用能力这些模型自身的指标。现在权重公开了,理论上可以自由部署到任何硬件上,但“理论上可以”和“实际上能稳定跑、成本可控”之间隔着一条适配链。这条链由三个环节组成:硬件本身的算力特性、推理框架对硬件的优化程度、模型结构在特定硬件上的映射效率。任何一个环节跟不上,权重开放就只是文件下载,不是可用的基础设施。
因此,架构师真正要评估的不再是“这个模型强不强”,而是“这条适配链能不能持续兑现”。昇腾对Kimi K3的0Day适配之所以值得关注,不是因为昇腾在某个瞬间超过了谁,而是因为它展示了硬件厂商与模型方之间已经形成了某种协同节奏。这种节奏一旦稳定下来,就会反过来影响后续模型的设计选择和部署路径。
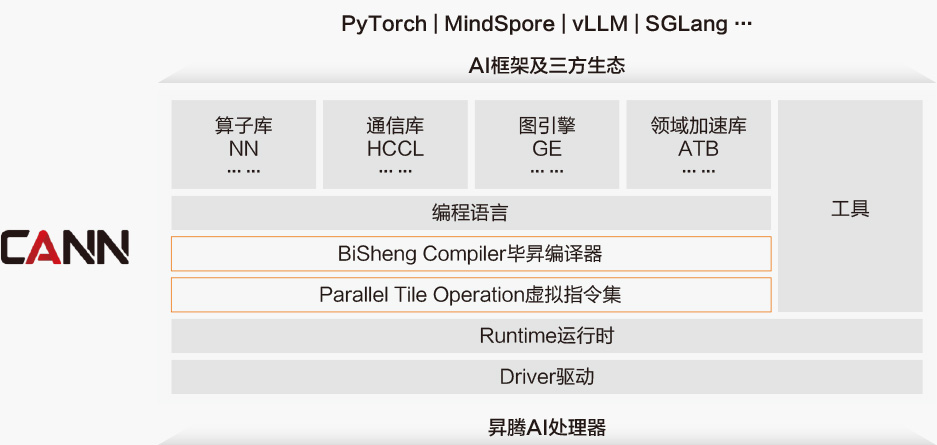
当然,这条判断有一个明确的边界。如果企业只用API、完全不碰私有化部署,适配链的权重会大幅下降——因为API把硬件、框架、模型之间的适配细节全部封装在了服务端,调用方只需要关心价格、延迟和吞吐。但API降价本身又受算力成本约束,而算力成本恰恰取决于底层硬件与模型的适配效率。换句话说,即使完全不碰私有化部署,适配链的影响也只是被推迟了,没有被消除。
0Day适配不是技术奇迹,是生态竞争的前置
昇腾为什么要在权重发布当天跑通Kimi?
0Day适配不是中立的工程服务,而是算力厂商争夺架构师心智的竞争行为。2026年11月4日,月之暗面公布Kimi K3.1 Pro完整模型权重,昇腾当天就基于vLLM Ascend和SGLang完成推理适配,支持Atlas 800 A3、Atlas 900 A3 SuperPod超节点以及昇腾950超节点系列产品部署。围绕Kimi K3.1 Pro新增的稀疏注意力、百万级上下文和推理服务需求,昇腾专门做了算子与框架协同优化。
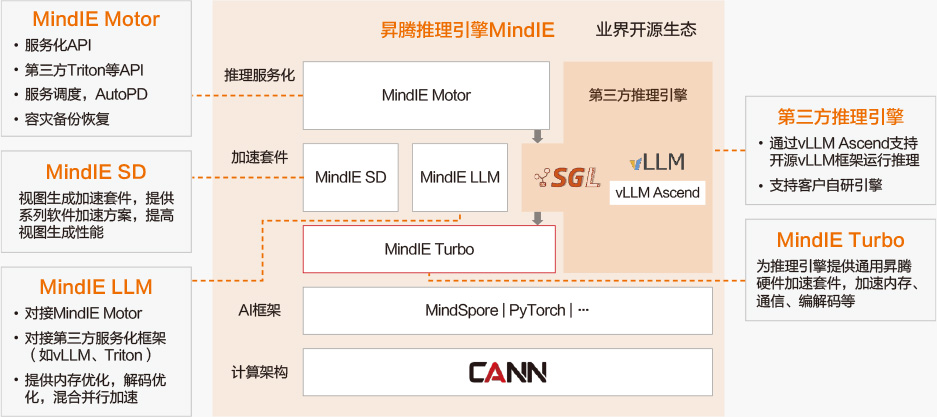
这组动作的受众不是模型方,而是正在做架构选型的人。英伟达生态里,新模型发布后CUDA适配通常由模型方或社区完成,硬件厂商不需要抢首发。昇腾投入工程资源把适配压缩到权重发布当天,是为了让Kimi在自家硬件上从“理论可行”变成“当天可用”。一旦架构师把昇腾纳入候选清单,后续的部署路径、集群规划、预算分配就有了被重新讨论的可能。
这种竞争逻辑在Kimi K3上更明显。昇腾CANN宣布昇腾950全系列和Atlas A3支持Kimi K3部署,特别强调Kimi K3的896专家大EP部署场景“能够充分发挥昇腾超节点架构优势”。这不是泛泛的兼容声明,而是针对Kimi架构特点的定向营销:MoE模型的大规模专家并行恰好需要高带宽域内互联,昇腾的超节点设计正好承接这个需求。适配速度本身成了产品能力的证据。
适配速度背后,架构师要承担什么?
0Day适配把迁移门槛降低了,但代价是适配风险的性质变了。过去架构师担心的是“模型能不能在国产卡上跑起来”,现在这个问题被厂商提前解决了,剩下的问题变成“跑得好不好、能跑多久”。昇腾对Kimi K3.1 Pro的优化集中在推理场景,包括稀疏注意力算子和百万级上下文的框架协同。这些优化是昇腾针对特定模型结构做的深度工程投入,不是通用的CUDA转译。架构师如果基于这些特定优化设计推理服务,比如把大EP部署作为核心架构,后续切换到其他硬件或模型时,这部分工作很难直接复用。
更关键的边界在训练侧。昇腾社区MindSpeed Bridge文档显示,当前支持的是GLM5-744B、Qwen3.5等模型,Kimi K3适配“正在开发”。也就是说,0Day适配覆盖的是推理部署,不覆盖训练和微调。对于只需要推理的企业,这条链路已经基本可用;对于需要基于Kimi做继续预训练或深度微调的团队,适配链的完整性要打折扣。推理适配和训练适配是两套不同的工程体系,前者解决的是算子覆盖和推理引擎兼容,后者涉及分布式训练框架、通信库、显存管理、混合精度策略等更复杂的协同。
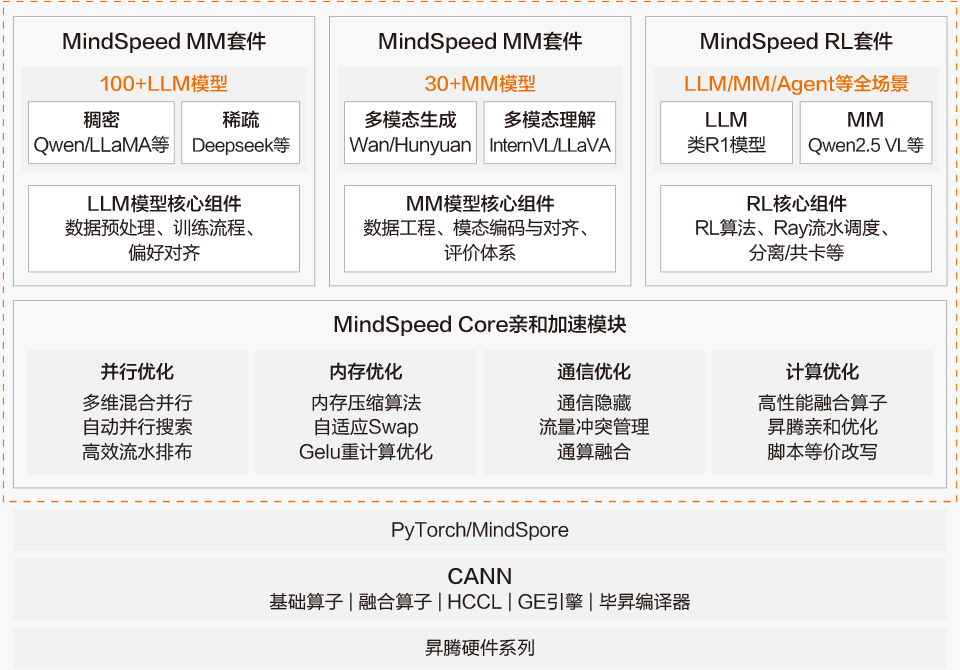
这意味着架构师面对的不是“要不要用昇腾”的二元选择,而是一组需要分别评估的约束:推理部署可以快速落地,训练微调则需要等待适配成熟或自行承担工程成本。0Day适配确实把入口打开了,但入口之后的路,长度和路况并不相同。
64卡起步的部署现实:开放权重不等于人人可部署
Kimi K3的硬件门槛到底有多高?
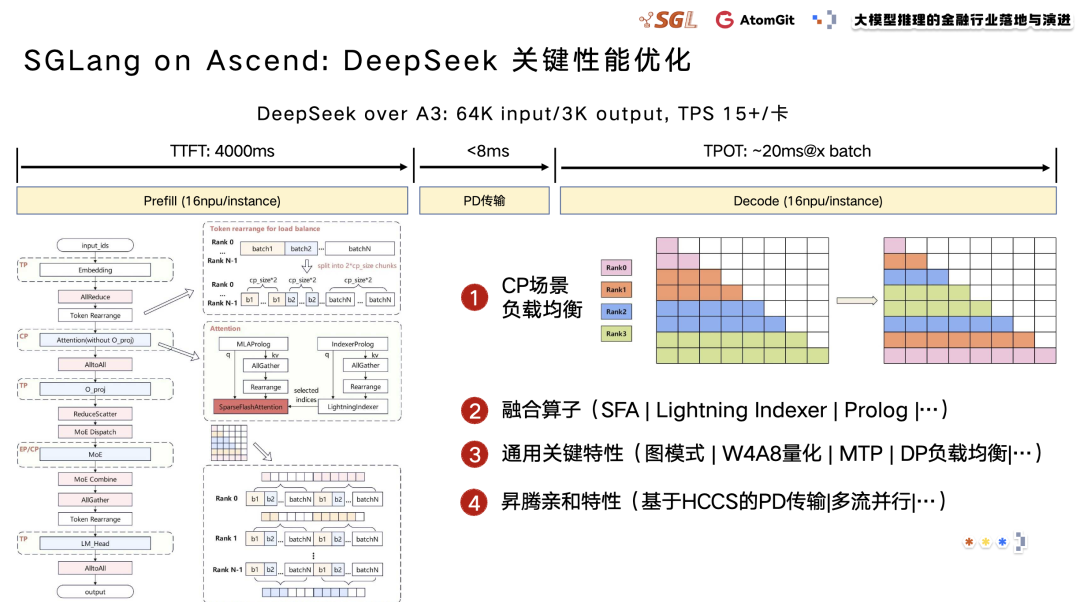
Kimi K3的权重确实公开了,但公开的是文件,不是部署能力。这个模型总参数量2.8万亿,采用混合专家架构,支持100万token上下文窗口。官方给出的高效推理要求是至少64卡集群。64卡不是一个小型团队顺手就能凑出来的规模,它对应的是一套完整的分布式推理体系:张量并行、专家并行、流水线并行要同时处理,显存分配和通信调度要针对MoE结构重新设计。月之暗面把权重放出来,解决的是“能不能拿到”的问题;64卡起步,才是“能不能跑起来”的真实边界。
2.8万亿参数意味着即使采用MoE架构、每次推理只激活部分专家,全量权重仍然需要分布在多节点上。单卡显存装不下,单机内存也装不下。架构师面对的不再是选一个推理框架、调几组超参数,而是先确认手头有没有一个足够大的异构集群,以及这个集群的卡间互联、节点间网络、存储带宽能否支撑MoE模型的专家路由开销。权重开放把软件层面的障碍拆掉了,硬件集群层面的障碍原封不动地留在了那里。
天翼云的部署方案说明了什么?
天翼云给出的Kimi K3部署方案提供了一个具体的参照。按照其文档,部署需要1台管理节点和7台计算节点,每节点搭载8×64GB昇腾910B NPU,使用HBM2e显存。总计64卡,正好卡在官方要求的下限。这个方案还建议把管理节点纳入Slurm计算调度队列,让它同时承担集群管理和算力计算双重角色,以扩充可用算力规模。连管理节点都要挤出来跑模型,说明这套部署对算力密度的要求已经紧到了什么程度。
这个方案的价值不在于它是最优解,而在于它把“开放权重”和“可部署性”之间的落差量化了。64卡昇腾910B集群不是随便哪个企业都有的存量资源。对于已经采购了昇腾集群的机构,这条部署路径相对清晰;对于只有少量GPU或者完全没有自建算力的团队,看到这个配置的第一反应应该是评估云上租用成本,而不是下载权重开始部署。架构决策的重心从“选哪个开源模型”转向了“我有没有与之匹配的集群形态”。
如果企业选择API而非私有化部署,这个门槛确实不直接构成约束。但API的单价和吞吐上限,最终仍由服务商底层的集群形态决定。服务商跑Kimi K3同样需要64卡级别的部署单元,这些成本会以定价和配额的形式传导给调用方。权重开放让私有化部署成为可能,但没有让私有化部署变得便宜。架构师真正要比较的,是租用API的长期成本与建设并维护64卡集群的固定投入之间,哪一条路径在自己的业务周期内更可持续。
异构集群是解药,还是新的复杂度来源?
GPUWorks想解决什么问题?
多硬件并存已经不是假设。GPUWorks的README明确写着,NVIDIA、AMD Instinct与Ryzen AI Max、华为昇腾、平头哥PPU、海光DCU和Apple Silicon可以在同一个集群里并存。这不是厂商宣传材料里的远景,而是一个开源工具当前声称具备的能力:调度器把每个部署放到其启动规格支持的硬件上,不同架构的节点接入同一套集群管理。
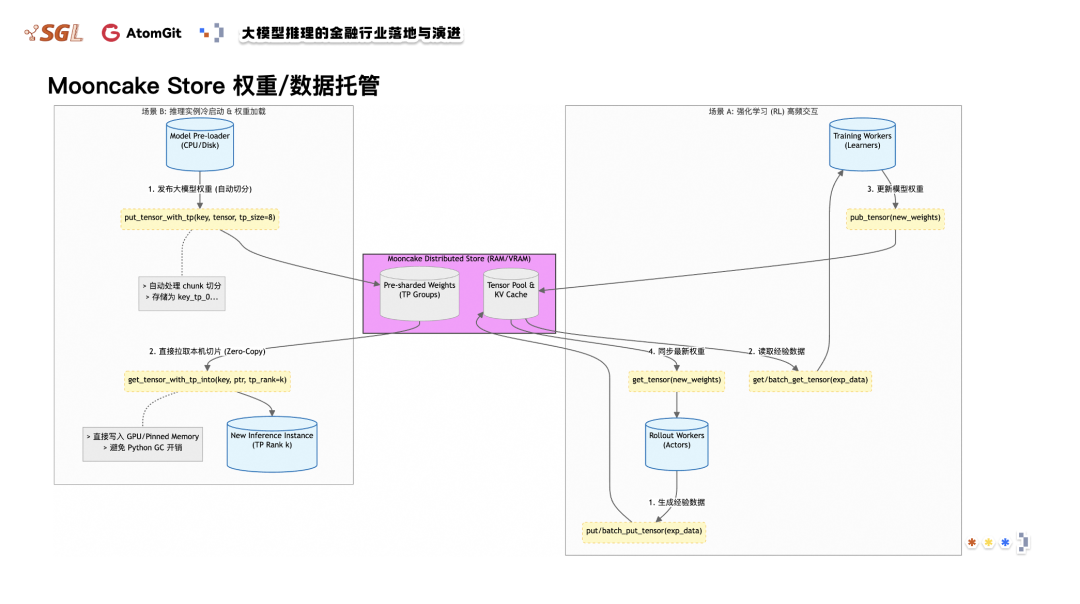
这个工具的内置目录为392个模型提供了1,235份启动规格——每种卡型对应的镜像、引擎、启动参数和固定的权重版本。这组数字说明了一个容易被忽略的事实:所谓“支持多硬件”,落到实处是海量的规格匹配工作。一个模型在NVIDIA上能跑,不代表它在昇腾或AMD上以同样方式启动;每个组合都需要有人验证、固定并维护。GPUWorks把这些工作从模型方转移到了工具方,但转移不等于消失。
显存切片机制最能说明问题。GPUWorks支持dGPU显存限额,让多个模型共用一张卡,但不同硬件走完全不同的路径:NVIDIA基于HAMi-core,昇腾基于vcann-rt,PPU基于ppu-slicing-shim,AMD基于rocm-slicing-shim,海光基于原生vdev。同一项功能,五套实现。这意味着集群里每增加一种硬件,维护面不是线性增加,而是每套切片机制都有独立的兼容性边界、故障模式和升级节奏。
多硬件并存对架构师意味着什么?
昇腾出货量的变化为这种复杂度提供了规模背景。IDC数据显示,2026年上半年华为昇腾在中国数据中心AI芯片市场的份额为28%,出货量约57.2万颗,而2025年上半年同期约为30万颗。英伟达同期份额34%,出货量约67.8万颗,同比下降超四成。两个数字放在一起,指向的不是谁取代谁,而是双轨并行的格局正在形成。架构师面对的不是“要不要用昇腾”的选择题,而是“英伟达和昇腾同时存在于我的供应链里,我该怎么管理”的运营题。
这正是异构集群的悖论所在:它降低了单一硬件锁定的风险,却把复杂度转移到了架构师身上。单一生态锁定的代价是议价权丧失和供应风险集中;异构集群的代价是,你需要理解每种硬件的切片机制、启动规格和适配状态,才能做出可靠的容量规划和故障排查。GPUWorks的1,235份启动规格说明,适配工作已经从模型方转移到了工具方和架构师方——工具方承担了规格的整理和分发,但架构师仍然需要判断哪份规格适用于自己的场景,以及在规格未覆盖的边界处自行兜底。
这个判断有一个明确的边界。如果企业规模足够大,可以组建专门的平台团队消化这种复杂度,异构集群提供的是真实的战略自由度。但对中小团队而言,维护两套硬件生态的成本可能超过单一生态锁定的成本。异构集群不是免费的保险,它的保费就是架构团队对多套硬件栈的持续理解能力。选择异构,意味着你买到的不是自由,而是一份需要自己续保的复杂度合约。
架构师的决策清单:三个问题比“哪个模型最强”更重要
问题一:你的工作负载是推理为主还是训练为主?
这是第一个需要回答的问题,因为它直接决定适配链的哪一段对你真正构成约束。如果负载以推理为主,当前国产算力对主流开源模型的覆盖已经相当具体。昇腾社区 MindSpeed 26.2.X 文档显示,GLM5-744B、Qwen3.5(9B/35B/122B/397B)等模型均已支持,Kimi K3 的适配则处于开发状态。这意味着选择推理部署时,可用的硬件选项比想象中多,但必须逐项核对模型版本与框架版本的匹配关系。
如果负载涉及继续预训练或深度微调,判断标准就完全不同。训练适配涉及分布式训练框架、通信库、显存管理和混合精度策略的协同,其工程复杂度远高于推理部署。围绕 Kimi K3.1 Pro 的稀疏注意力和百万级上下文需求,昇腾开展的是算子与框架协同优化,目标是推理服务,而非训练链路。推理适配的快速落地不能外推为训练适配的成熟。
问题二:你能承受多长的适配等待期?
适配等待期不是从“模型发布”到“可用”的单一时间差,而是从“你需要某个能力”到“该能力在你的硬件上稳定运行”的完整周期。Kimi K3.1 Pro 发布当天昇腾完成部署验证,说明头部模型与头部国产算力之间已经形成某种协同节奏,但这种节奏并不覆盖所有模型、所有版本、所有算子。
MindSpeed Bridge 对 Kimi K3 的适配状态标注为“正在开发”,这意味着即便官方文档明确列出支持范围,架构师仍需对未覆盖的边界保持清醒。等待期的可承受程度取决于业务节奏:如果模型更新频率高、业务依赖新能力,等待期就是硬成本;如果模型版本相对固定,等待期的影响会被摊薄。
问题三:你的团队能维护几套硬件规格?
异构集群的真实成本不在采购,而在持续维护。GPUWorks 的显存切片方案需要为不同硬件使用不同切片机制:NVIDIA 基于 HAMi-core,昇腾基于 vcann-rt,PPU 基于 ppu-slicing-shim,AMD 基于 rocm-slicing-shim,海光基于原生 vdev。同一功能在五套硬件栈上有五种实现路径,这意味着架构团队需要理解的不只是“能不能跑”,而是“每种实现各自的行为边界和故障模式”。
团队规模是这里的关键变量。有专门平台团队的企业可以消化这种复杂度,将其转化为真实的硬件议价能力和供应安全。中小团队若同时维护两套以上的硬件规格,排查一次显存分配异常就可能涉及完全不同的日志路径和工具链。维护能力不是抽象的人力问题,它直接决定异构策略是资产还是负债。
这三个问题之间没有统一的权重。推理为主、等待期容忍度高、团队维护能力强,三者同时满足时,异构国产算力路线是可行的。若任一条件不成立,API 优先或单生态锁定反而更接近理性选择。早期验证阶段确实可以绕开这些问题,但规模化部署会让它们以成本、排障时间和交付延期的形式重新出现。