豆包工作日活破800万、ARR超20亿:真正被验证的不是技术,而是付费意愿
豆包工作上线三个月工作日DAU破800万、企业客户ARR超20亿,与腾讯WorkBuddy的千亿token消耗共同表明,AI生产力工具已进入企业付费验证期。但付费意愿不等于架构就绪:多模型接入、额度倍率标注和企业数据边界,要求后端把计量、降级与隔离作为核心能力,而非单纯追求异步高并发。
豆包工作日活破800万、ARR超20亿:真正被验证的不是技术,而是付费意愿
三个月800万日活,真正被验证的不是技术,而是付费意愿
豆包工作室上线三个月,工作日日活跃用户突破800万,企业客户年度经常性收入(ARR)超过20亿元。这组数据里,真正值得拆解的不是用户规模,而是付费路径。DAU衡量的是流量,ARR衡量的是企业客户是否愿意持续付钱。对一个B端产品来说,后者才是命门。
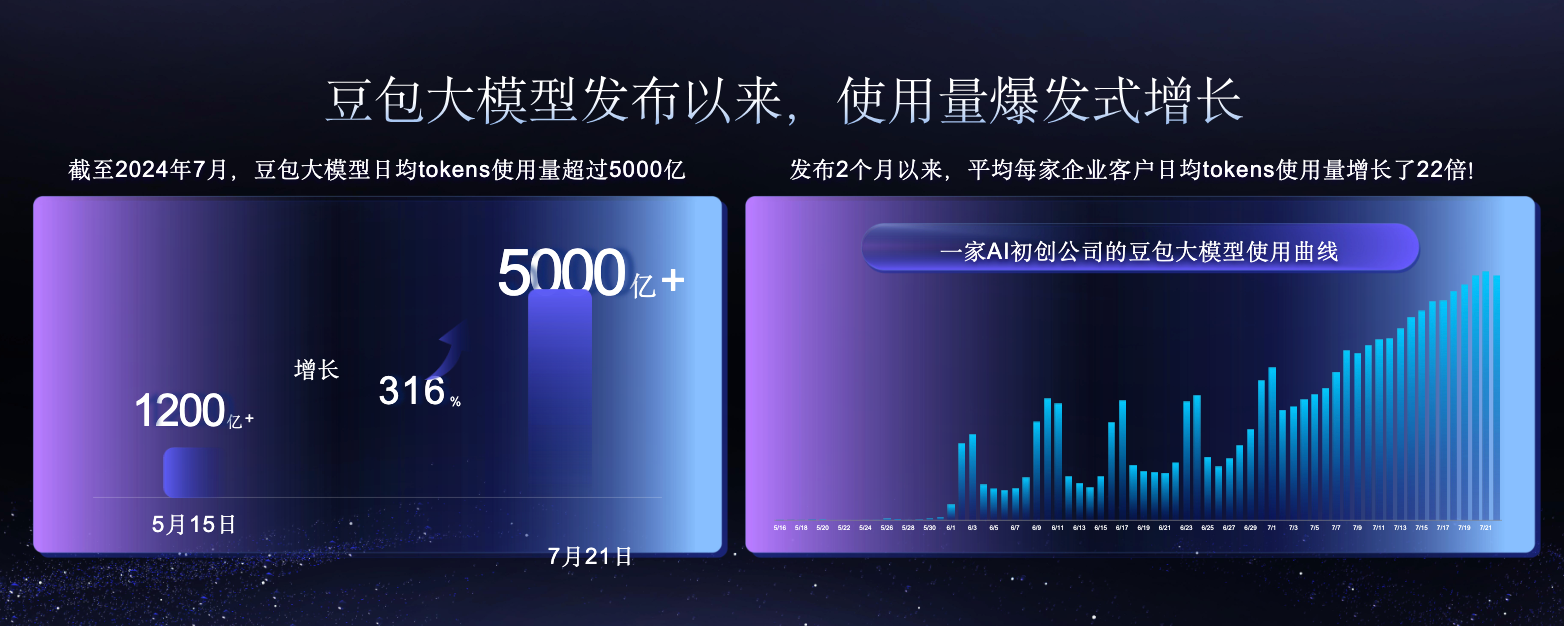
豆包工作披露的ARR达到20亿元,意味着它在极短时间内完成了从免费试用到付费订阅的转化。这个速度在传统SaaS行业里几乎不可想象。传统企业软件的销售周期以季度甚至年度计算,而AI生产力工具把试用、验证、采购压缩到了几周内。
同一时间披露的腾讯WorkBuddy数据提供了一个参照系。WorkBuddy的日活跃用户超过1000万,最近七天收入按年化折算超过5亿美元,是腾讯会议的两倍以上,三季度收入是第二季度的5倍以上。更关键的一个数字是:中国百强企业已有60%成为它的客户。
两个产品在同一周披露数据,且都指向同一结论:企业客户正在为AI生产力工具付费,而且付费意愿超出了此前大多数行业观察者的预期。这不是某个团队的偶然爆发,而是整个品类进入了商业化验证期。
需要留意的是口径差异。豆包工作披露的是工作日DAU,与自然日DAU不可直接比较;ARR是企业自行宣布的数字,公开资料未披露确认规则、去重方式和续费率。这些缺口意味着,20亿ARR证明的是付费意愿存在,而不是留存和续费已经稳定。付费意愿被验证之后,下一个问题自然浮现:企业为什么愿意付钱?答案藏在产品策略里。
多模型接入不是技术炫技,而是把模型变成可替换的成本组件
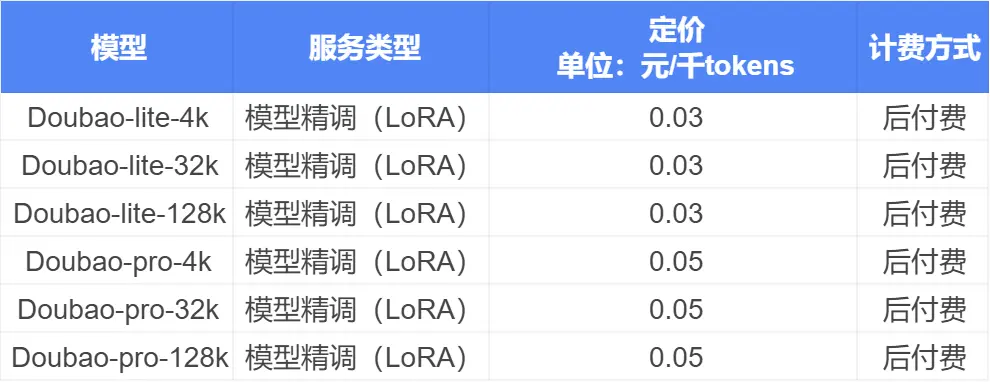
豆包工作接入Kimi、GLM、DeepSeek并标注额度消耗倍率,这个动作的实质是把模型从产品核心降格为可替换的能力组件。当多个模型都能完成相似任务时,模型本身不再构成护城河;用户真正比较的是同一任务在不同模型上的效果与成本之比。豆包工作把选择权交给用户,同时把成本结构摆到台面上,竞争焦点随之从“谁的模型更强”转向“谁的工作台更好用、计费更清楚”。
这一策略的前提是模型能力正在趋同。Kimi、GLM、DeepSeek各有侧重,但在文档处理、信息提取、内容生成等常见办公场景中,它们之间的差距已经缩小到普通用户难以稳定感知的程度。豆包工作没有试图在模型层做排他绑定,而是让用户按任务挑选模型,这等于承认:模型是可以随时替换的,产品体验和计费规则才是需要持续投入的部分。
对后端架构而言,这意味着模型层必须被抽象成统一的调度接口。调用不同模型不能各写一套逻辑,否则每接入一个新模型都要重做鉴权、流式响应、错误重试和用量记录。豆包工作的做法要求一个中间层把模型差异封装起来,让上层应用只面对“任务”和“成本”两个变量。额度消耗倍率的标注进一步要求这个中间层具备精确计量能力:同一任务在不同模型上的token消耗、响应延迟、失败率都要被记录,才能支撑用户做出合理选择。
公开资料没有披露具体的倍率数值和计费规则细节,因此无法判断这种透明化是否真正降低了用户成本。一种可能是,倍率标注让用户更直观地看到高价模型与低价模型的差异,从而主动选择性价比更高的方案;另一种可能是,倍率本身只是把复杂的计费逻辑简化成一个数字,用户仍然不清楚背后的token计价、上下文长度和输出质量差异。后一种情况下,透明化更多是一种体验设计,而非实质性的成本让渡。
豆包工作选择多模型接入而非自研模型独占,还透露出另一个判断:在B端场景中,客户要的是任务完成度,而不是对某个模型的忠诚。企业用户关心的是文档处理是否准确、协作流程是否顺畅、费用是否可预测。模型只是完成这些任务的引擎,引擎可以换,工作台上的流程和权限体系才是企业真正依赖的东西。
企业数据边界:架构能接住流量,但接不住合规风险
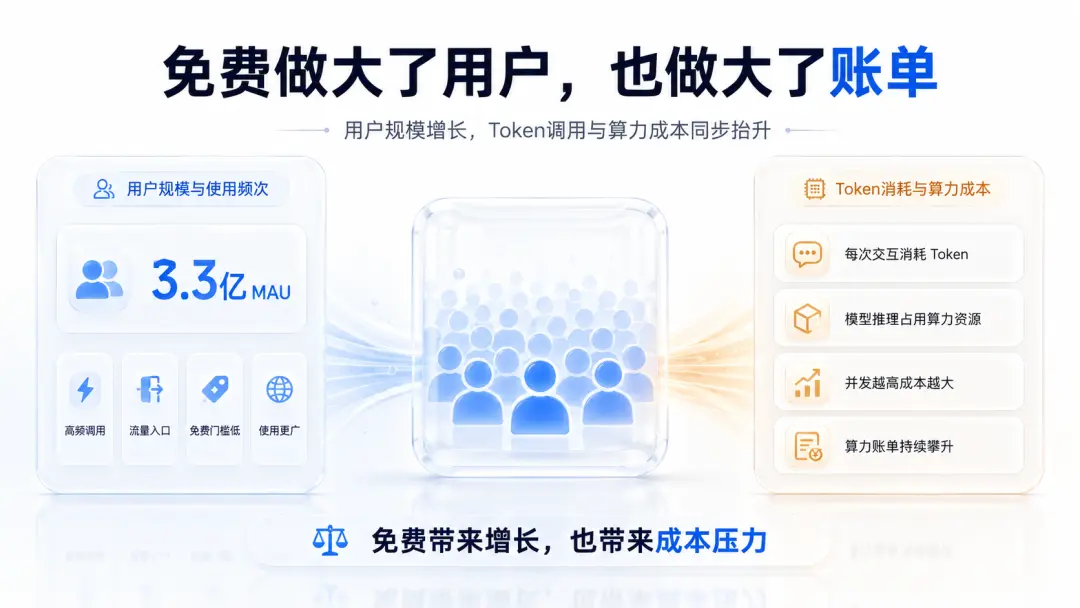
豆包工作接入Kimi、GLM、DeepSeek等第三方模型,意味着同一份企业文档可能依据任务类型被发送到不同的外部服务。每个模型服务商的数据使用约定、留存策略和审计能力并不一致,后端团队无法假定它们遵循同一套规则。公开资料未披露具体的技术实现路径,也未说明数据在模型之间的路由方式。
对后端架构而言,真正的约束出现在请求离开企业边界之前。敏感内容需要在进入第三方模型前完成脱敏,权限校验需要精确到字段或文档级别,每一次外部调用都应留下可审计的记录。来源对站长和建站从业者的风险提示也指向同一个方向:涉及企业数据与客户信息的任务,接入前应确认服务条款中的数据使用约定,数据边界仍要由使用者自己守住。
现有证据只提供了通用性风险提示,没有豆包工作数据合规性的具体结论,不能据此断言豆包工作存在数据安全问题。多模型架构客观上增加了数据治理的复杂度,但复杂度不等于已经发生泄露或违规。它意味着后端团队需要把脱敏、权限和审计作为架构设计的一部分,而不是等流量上来之后再补丁式修补。数据边界问题没有标准答案,但对后端团队而言,有一个设计原则是明确的:把不确定性隔离在可控层。
FastAPI服务接住这波流量的关键,不是异步,而是计量与降级
标题里的问题需要先拆开。FastAPI 的异步能力解决的是连接调度和 IO 等待,它让服务在等待模型响应时还能处理其他请求。但 AI 生产力工具的流量特征与传统的 CRUD 应用不同:单次请求的资源消耗高、成本与模型选择直接挂钩、失败模式更多样。豆包工作在界面中标注额度消耗倍率,供用户按任务自主选择模型,这一产品策略已经把压力传导到了后端。倍率不是展示层的标签,它要求每次请求发生时,系统都能实时识别模型、记录 token 消耗并折算成对应成本。没有这层计量,前端展示的倍率就只是静态文案。
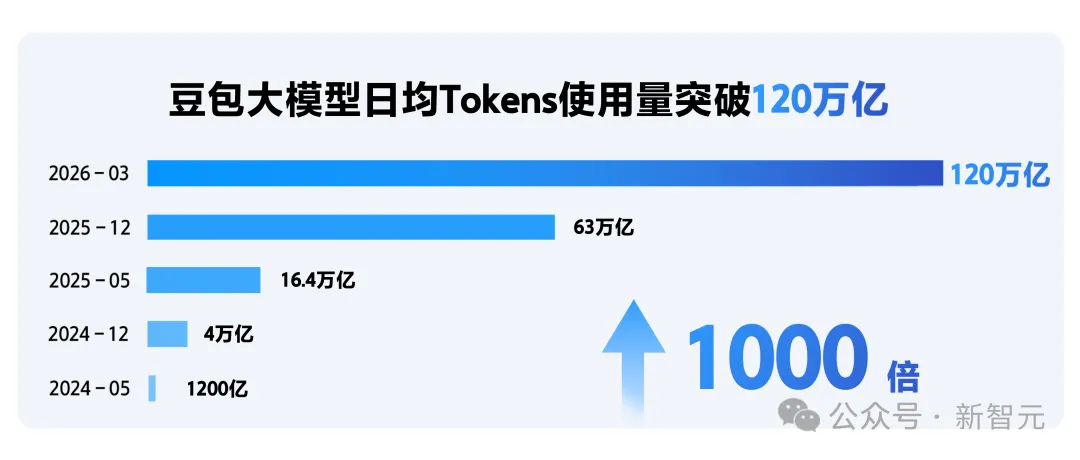
计量之所以优先于异步,是因为它决定了商业模型能否成立。一个 FastAPI 服务可以轻松扛住每秒数百个并发请求,但如果无法在请求级别回答“这次调用花了多少钱、消耗了多少额度、属于哪个客户”,流量越大,财务上的不可控性就越高。豆包工作接入 Kimi、GLM、DeepSeek 等第三方模型,意味着同一条业务链路背后可能对应完全不同的成本结构。后端需要在请求进入模型之前就确定计费规则,而不是事后从日志里估算。这要求把计量做成请求管道中的一个强制环节,而非可选的监控插件。
降级是第二个常被忽略的能力。多模型架构的好处是选择多,代价是故障面也变宽。某个模型服务超时、限流或返回异常时,用户不应该直接看到失败页面。合理的做法是降级到备用模型,或者转入排队策略,同时保留任务状态和已产生的费用记录。降级规则需要与计量联动:切换到更贵的模型时,是否要额外确认额度;切换到更便宜的模型时,输出质量差异是否可接受。这些决策不能靠开发者在代码里写死,而应作为可配置的策略层存在。
数据边界隔离是第三条原则。上一章已经讨论过,多模型接入增加了数据治理的复杂度。从架构角度看,这意味着不同敏感级别的任务不能走同一条默认链路。涉及企业数据与客户信息的请求,应在路由层就区分处理:哪些模型可以接收原始数据,哪些只能接收脱敏后的版本,哪些任务需要额外的人工确认。隔离不是简单地把数据分库,而是把权限判断前置到请求进入模型之前。
需要说明边界。公开资料未披露豆包工作或 WorkBuddy 的具体技术架构,以上判断是基于产品策略的合理推断,而非对实际系统的描述。不同规模的产品对计量精度的要求差异很大,小团队不必照搬完整的计费中台设计。但计量优先、降级兜底、边界隔离这三条原则,在 AI 生产力工具的流量爆发期,比单纯追求异步高并发更接近问题的本质。