微软USB4 RDMA对比35B端侧模型:低延迟与低内存的真实代价
微软在Windows 11启用USB4 RDMA,双机互联延迟降至28-50微秒,但集群规模受限于USB端口数量而非交换机;同时Edge0、Swiftlet、面壁MiniCPM-V 4.7等35B模型在手机端跑出可用速度,代价是权重访问从内存转移到SSD,生成速度高度依赖专家调度命中率。
微软USB4 RDMA对比35B端侧模型:低延迟与低内存的真实代价
微软USB4 RDMA实测28微秒,但端口数才是真正的天花板
微软在 Windows 11 上启用了 USB4 RDMA。双机互联实测延迟 28 至 50 微秒,同一 USB4 链路上 UDP 封包以太网方案是 116 至 194 微秒。四倍延迟差,微软自己公布的数据。
延迟怎么省下来的?USB4 单链路最高 80Gbps。每台 PC 构成独立 USB4 域,Windows 连接管理器在两者之间创建点对点隧道,数据在双方已注册的内存区域之间直接传输。RDMA 让一台机器直接读写另一台机器的内存,绕开双方操作系统协议栈,CPU 不必参与每一次搬运。省掉的是协议栈开销,不是带宽本身。
架构师看任何新互联方案,第一眼盯的是扩展性。USB4 RDMA 的约束写在物理层:集群规模受限于 USB 端口数量,而不是网络交换机。一台机器有几个 USB4 口,就能直连几台对端。要做三机、四机拓扑,要么串行级联,要么回到交换机。串行级联意味着中间节点转发,延迟账本立刻重算;回到交换机,这套方案的核心卖点就没了。
所以这条技术路线的真实边界很清晰:它适合小规模、低延迟敏感的边缘推理集群。两台到四台机器,共享内存池跑一个 35B 模型的张量并行,或者做低延迟的推理请求分发,USB4 RDMA 有账可算。把它当云端高并发架构的替代品,方向就错了。
USB4 RDMA 解决了边缘多机互联的延迟问题,但端侧单机跑 35B 模型的故事,揭示了另一条更激进的路径:把权重从内存搬到 SSD。
35B跑进手机:内存数字好看,因为压力转移到了SSD
手机跑 35B 模型,内存占用 1–2.5GB,这个数字本身没有造假。Edge0 官方开源帖写得很清楚:35B 参数模型,峰值内存 1–2.5GB,可在手机、电脑上本地推理。基于 Qwen3.6-35B-A3B 的 MoE 架构,每 token 激活约 3B 参数。Flash-iOS 在 iPhone 15 Pro 上把活跃 RAM 压到约 1.4GB,完整模型在 SSD 上占 13.4GB。Swiftlet 的 35B 档位磁盘占用 18GB,峰值内存 4.3GB。三条路线的数字摆在一起,结论一致:内存好看,是因为权重不常驻。
机制上,三条路线共享同一个核心动作:把权重访问从内存带宽转移到 SSD 随机读。Edge0 用流式推理,专家权重通过内存映射按路由结果从 SSD 读取,RAM 只保留活动权重。Swiftlet 把数万个路由专家重新打包成固定步长的块,取一个专家等于一次 pread 从本地固态硬盘读。Flash-iOS 更直接:每层 256 个专家子网络,每个 token 由路由器选 8 个专家加 1 个共享专家,40 层算下来,每生成一个 token 需要从 SSD 读取 320 个专家文件。
峰值内存数字掩盖了磁盘 I/O 的持续压力。8GB Mac 上有人实测,页缓存耗光之后,Edge0 的生成速度掉到 0.7 token/s。Edge0 官方声称流式方案不会像普通参数卸载那样停顿,但 0.7 tok/s 这个数字说明,“不停顿”依赖页缓存命中。缓存一失效,延迟立刻暴露。
三条路线的对比,用一张表看得更清楚:
| 路线 | 模型架构 | 权重读取方式 | 每 token 磁盘读取次数 | 峰值内存 | 磁盘占用 | 实测速度 |
|---|---|---|---|---|---|---|
| Edge0 | Qwen3.6-35B-A3B MoE | 内存映射按需读 SSD | 未披露 | 1–2.5GB | 未披露 | 0.7 tok/s(8GB Mac 页缓存耗光后) |
| Swiftlet | 35B 档位 | pread 块读取 | 未披露 | 4.3GB | 18GB | 未披露 |
| Flash-iOS | Qwen3.5-35B-A3B MoE | 按需专家流式加载 | 320 次 | 1.4GB | 13.4GB | 11 tok/s(iPhone 15 Pro) |
端侧 35B 的“可用”是一个缓存命中率游戏。路由器的专家选择越集中,重复读取越少,页缓存或块缓存越能扛住。一旦请求分布发散,专家选择随机化,磁盘随机读就会成为硬瓶颈。0.7 tok/s 不是极端情况下的异常值,它是缓存失效后的稳态表现。
把内存压到 1–2.5GB 的代价,是生成速度高度依赖专家调度的命中率和磁盘随机读性能。架构师若要把这套机制搬到边缘服务器,需要先测清楚三件事:专家选择的分布熵、SSD 随机读的 IOPS 上限、以及缓存策略在长尾请求下的表现。参数规模是 35B 还是 3B 激活,反而不是第一优先级的变量。
面壁LES的3GB内存锁与30 tok/s:专家调度命中率才是端侧命门
35B 模型在手机上跑出 30+ tok/s,这件事的账不能只算内存。先看硬约束:35B 权重即便做激进 Q4 量化仍有 15GB,主流 12GB 手机扣掉系统预留后最多剩 8GB,再给后台应用留出空间,大模型能用的合理内存只有 3GB 上下。15GB 权重塞进 3GB 内存,必须走 MoE 按需加载路线,每一次 token 生成都靠调度器从闪存里捞专家。
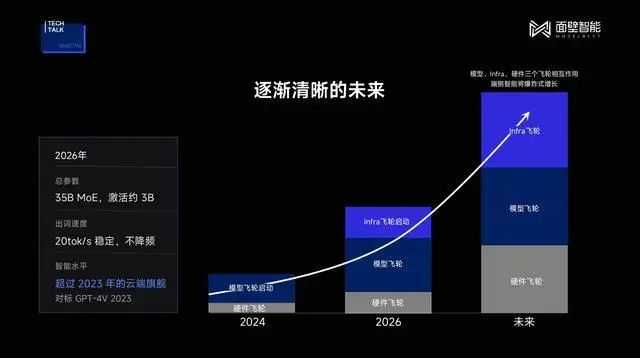
面壁的 LES 方案把这道题拆成两层。第一层,团队统计发现约 10% 的高频专家承接了过半计算任务,直接常驻在 3GB 缓存池里。热数据不挪窝,冷数据才走磁盘。第二层,前瞻专家调度利用相邻层特征相似性,在当前层计算期间预判后续可能用到的 8 个专家,并在约 50 毫秒内从闪存异步预取到内存。实际跑下来,8 个专家通常能猜中 6 到 7 个。
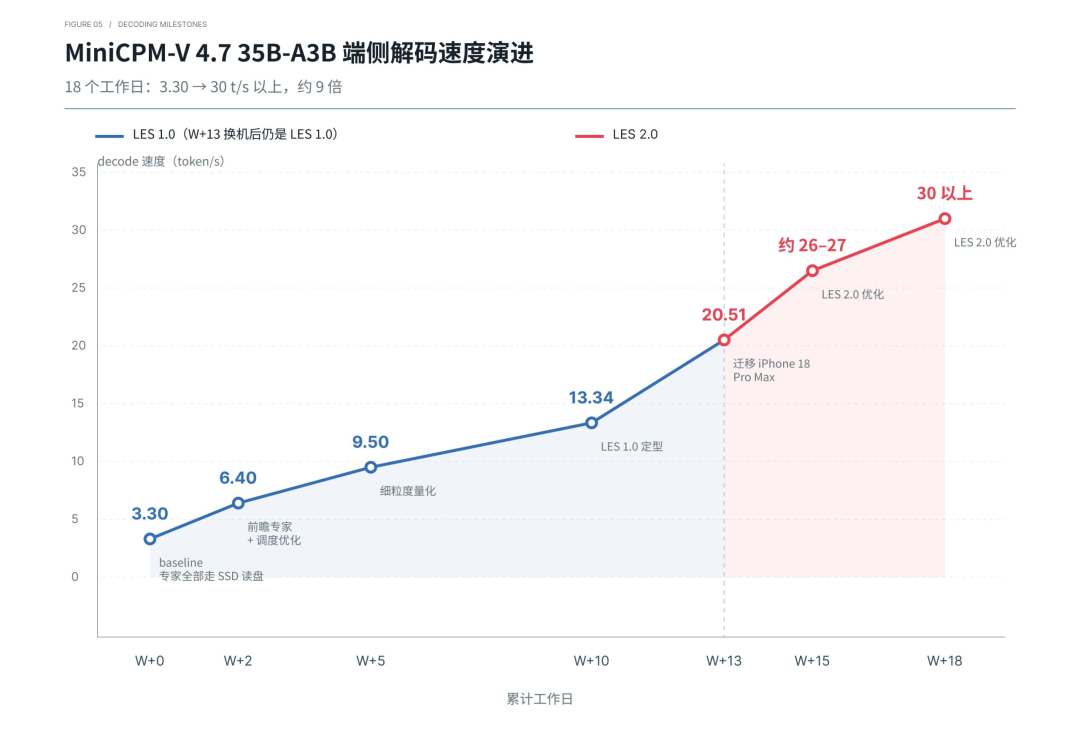
这两层配合,把 SSD 随机读从“等路由结果出来再读”变成“算当前层时提前读下一层”。磁盘延迟被计算时间掩盖,生成速度才从“能跑”拉到“流畅”。具体数字:iPhone 17 Pro Max 上 13+ tok/s,iPhone 18 Pro Max 上 20+ tok/s,LES 2.0 优化后同一台 iPhone 18 Pro Max 跑到 30+ tok/s。iPad Pro 11 英寸 M4(16GB)官方文档实测 17.39 tok/s。MiniCPM-V 4.7(35B-A3B)在 3GB 内存锁下,实测生成速度 30+ tok/s,精度几乎无损。
端侧推理的验收标准,面壁多模态实验室研究员给了一条线:15 tok/s 是“流畅”线,超过 30 tok/s 后人基本看不过来。这个判断值得架构师记住。端侧模型过了流畅线之后,继续堆速度的边际收益急剧下降。真正该盯的指标是调度命中率——预取 8 个专家命中 6 到 7 个,意味着 75% 到 87.5% 的磁盘读取被提前消化。命中率一旦明显低于这个区间,磁盘随机读就会从异步预取里漏出来,生成速度直接崩盘。
姚远点出了端侧与云端的根本差异:云端服务高并发时物理限制少,可以靠抬容量解决问题;端侧必须贴合终端硬件的物理极限设计,训得好云端模型未必擅长训端侧模型。这句话对后端架构师的翻译是:端侧 35B 的优化空间受限于具体设备的存储带宽和调度精度,不存在一套云端训练逻辑通吃端侧的路径。
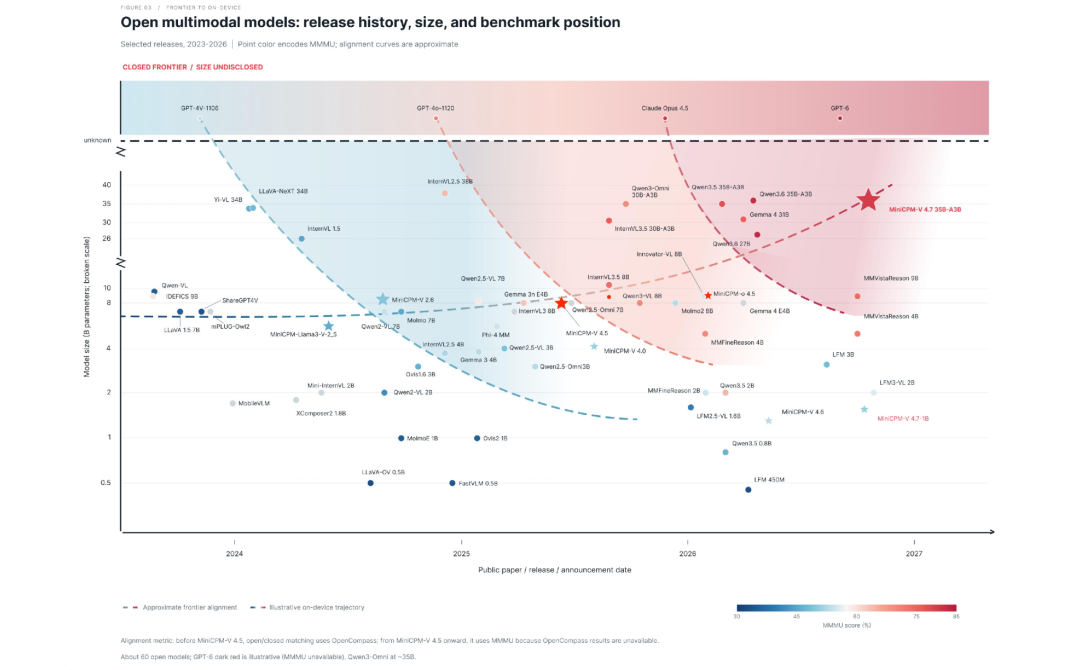
架构师的新账本:端口数、SSD随机读、调度命中率取代了显存和交换机
POCKET-35B 的对比数据把端侧优化的边界划得很清楚。Xeon 16 线程 CPU 上,生成速度 27.0 tok/s,Bonsai-27B 只有 10.1 tok/s,前者是后者的 2.69 倍。但换到 H100 服务器 GPU 上做 prefill,POCKET 只有 753 tok/s,Bonsai 是 1816 tok/s,POCKET 掉到后者的 0.41 倍。同一套 MoE 架构,在 CPU-only 环境里赢,在 GPU 上输。
原因藏在每 token 的内存传输量里。POCKET 每个 token 只搬约 0.66 GB,同等规模稠密模型要搬 3.5 GB。MoE 把参数总量做大,但每次只激活少数专家,低带宽环境下占尽便宜。GPU 的并行度一上来,稀疏激活反而成了短板——H100 的算力等不来足够多的活跃参数。
架构师选型时,三个变量决定方案取舍:
| 变量 | 端侧 35B(POCKET) | USB4 RDMA 边缘集群 | 关键约束 |
|---|---|---|---|
| 端口拓扑 | 单机,无网络依赖 | 双机直连,28–50 微秒 | 超过直连上限的延迟曲线无公开数据 |
| 存储带宽 | 每 token 0.66GB 内存传输 | 未披露 | SSD 随机读 IOPS 决定生成速度下限 |
| 调度命中率 | MoE 路由器选专家 | 未披露 | 命中率掉下去,生成速度直接崩 |
端侧 35B 是减法优化:牺牲 GPU 并行度,换低带宽环境下的可用性。USB4 RDMA 用端口直连换掉交换机,但端口数就是天花板。两条路线都不存在“通吃”的配置。
选型时先问部署环境:边缘 CPU 集群、手机端、GPU 服务器,答案完全不同。CPU-only 环境优先看每 token 内存传输量和专家调度命中率;GPU 服务器上 POCKET 这类 MoE 反而拖慢 prefill;多机互联先数清楚直连端口够不够用。
后续跟踪三个指标:USB4 RDMA 超过双机直连后的延迟衰减曲线、POCKET 类 MoE 在边缘 CPU 集群上的长尾请求命中率、以及标准 llama.cpp 生态对端侧模型的兼容性覆盖范围。