算力竞赛的记分卡,正在从峰值转向Token产出
浪潮信息在AICC2026发布元脑HC2000,单柜256张AIPU、全液冷、供电超300kW,并称同等投资Token产能提升10倍。本文拆解这个数字的成立条件与验证缺口,指出真正的变化是评估算力方案的标准从峰值算力转向单位投资的Token产出,而这一转向依赖推理需求持续放量。
算力竞赛的记分卡,正在从峰值转向Token产出

一个柜子装256张卡,难的不是装进去
供电300kW意味着什么
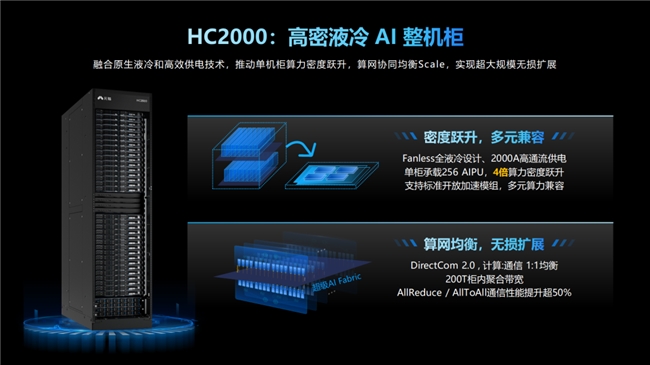
一个标准机柜的供电能力,传统数据中心通常在10kW到20kW之间。元脑HC2000把单柜供电做到300kW以上(E29、E40),这个数字本身就是一道物理门槛。风冷机柜的散热能力大约在每柜20kW到30kW量级,超过这个范围,空气已经带不走热量。300kW不是把数字做大,而是换了一种散热介质才能成立。
液冷从可选项变成必选项
全液冷设计(E21)在这个功耗密度下不是锦上添花。当单柜功率密度是传统风冷机柜的4倍(E40),风冷方案在物理上已经不可行。液冷从“可以选”变成“必须选”,连带的是机房改造、管路铺设、冷却液运维这一整套工程能力的跟进。厂商发布的是机柜,实际交付的是一套需要配套基础设施才能运转的系统。
200Tbps带宽在解决什么问题
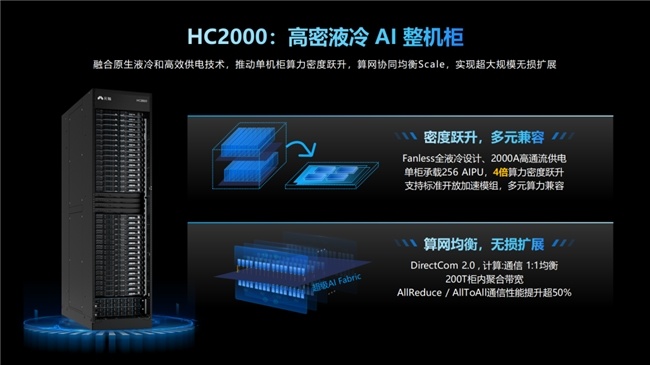
256张加速卡装进一个柜子,如果卡间通信跟不上,算力就是孤岛。柜内聚合带宽做到200Tbps,实现计算与通信1∶1的均衡配比(E12、E15),针对的是大模型推理中Prefill和Decode阶段的通信瓶颈。卡越多,通信压力越大,带宽不够,加卡反而可能降低整体效率。
“算力密度提升4倍”这个说法需要保留。厂商没有说明对比基准是哪种风冷机柜、何种配置(E40)。不同基准下,这个倍数可以差出很大空间。

容量型与能力型:两种算力需求的分野是否成立
能力型智算追求单机跑大模型
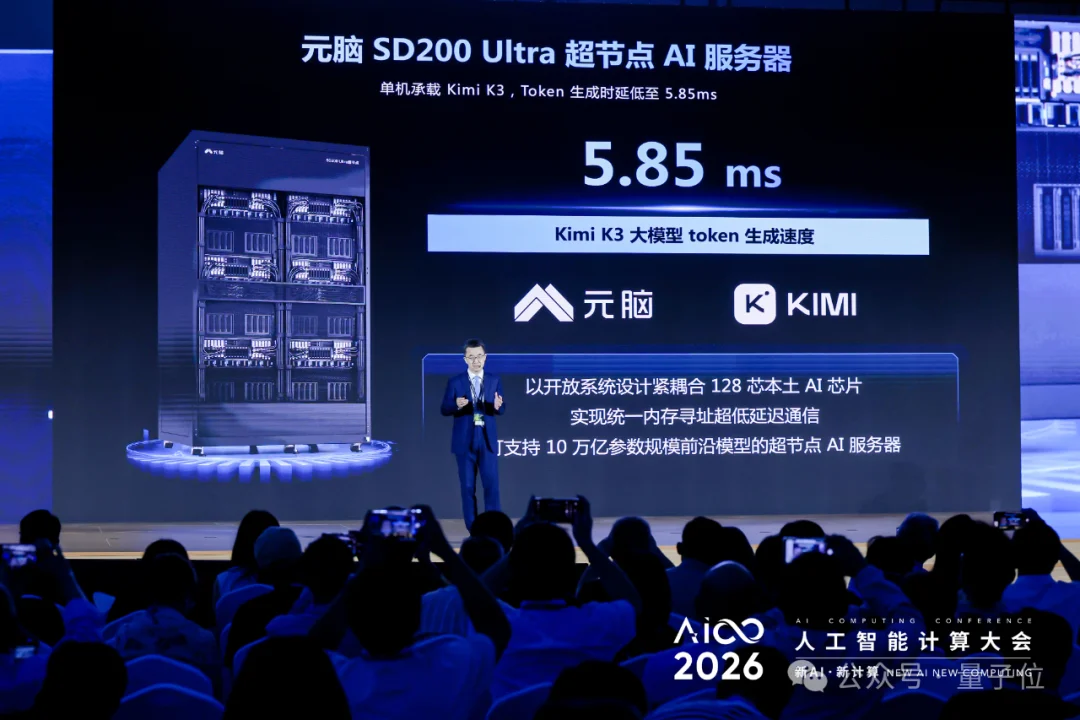
SD200 Ultra 的产品逻辑是把一台机器做成一个能独立承载最大模型的单元。它基于本土 AI 芯片,单机承载运行 2.8 万亿参数的 Kimi K3 大模型(E03),以开放系统设计紧耦合 128 芯本土 AI 芯片,提供 8TB 统一编址显存和 64TB 内存,支持 10 万亿参数规模的前沿模型单机运行(E07)。这些数字指向同一个目标:让一台设备尽可能装下更大的模型,减少跨机通信带来的损耗。
容量型智算追求单位投资产出 Token
HC2000 的优化方向不同。它面向的是推理请求持续涌入的场景,衡量标准是同等投资能产出多少 Token,而不是单机能跑多大的模型(E31)。当推理需求规模化之后,限制因素从“能不能跑”变成“跑得划不划算”,优化对象随之从峰值算力转向持续吞吐和资源利用率。
这个二分法是产品定位还是行业规律
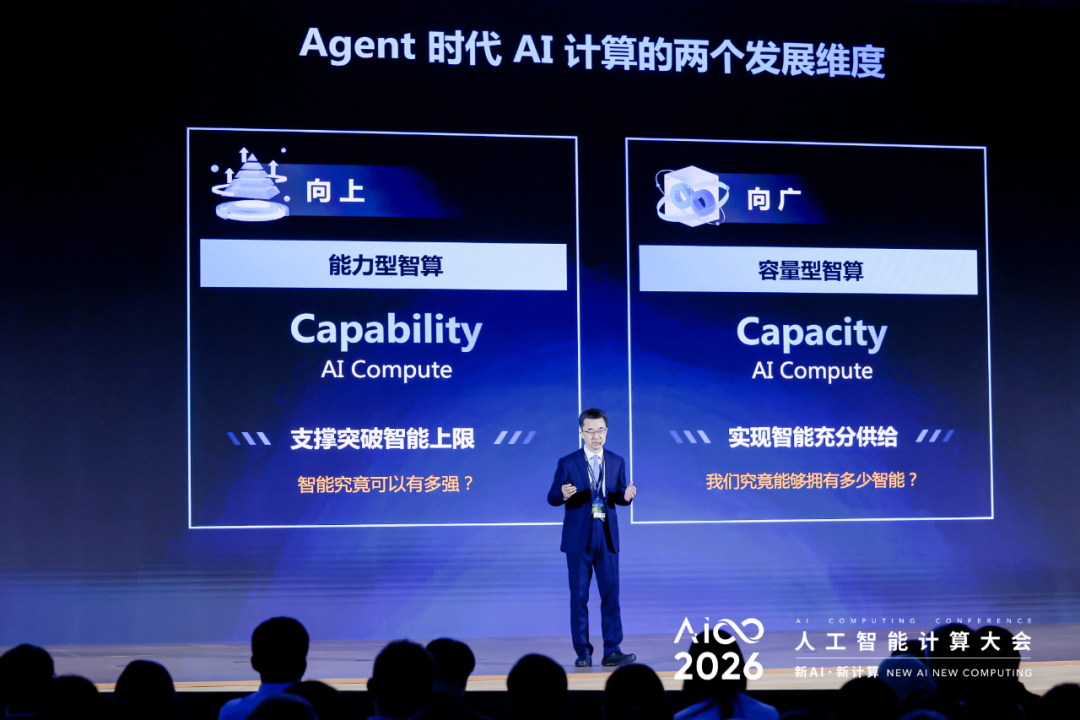
浪潮信息把 Agent 时代的 AI 计算划分为能力型智算与容量型智算两个方向,前者支撑突破智能上限,后者实现智能充分供给(E09)。需求侧的支撑来自其首席 AI 战略官刘军的判断:AI 正从回答问题走向解决问题,一个智能体接到任务后要理解目标、制订计划、调用工具、执行任务、检查结果,发现问题还要重新规划,跑起来就是几个小时甚至几天(E34)。任务时长从秒级变为小时甚至天级,Token 消耗量级随之跃升,推理侧需要的就不再是峰值算力,而是持续吞吐。
这个二分法有实际依据,但它是浪潮信息的企业观点(E09),不是行业共识。实际部署中,很多场景可能同时需要两种能力——既要求单机跑得动大模型,又要求单位成本足够低。硬性二分简化了真实需求的复杂度,把它当作产品定位比当作行业规律更稳妥。
10倍Token产能:一个需要拆开看的数字
同等投资这个前提有多重要
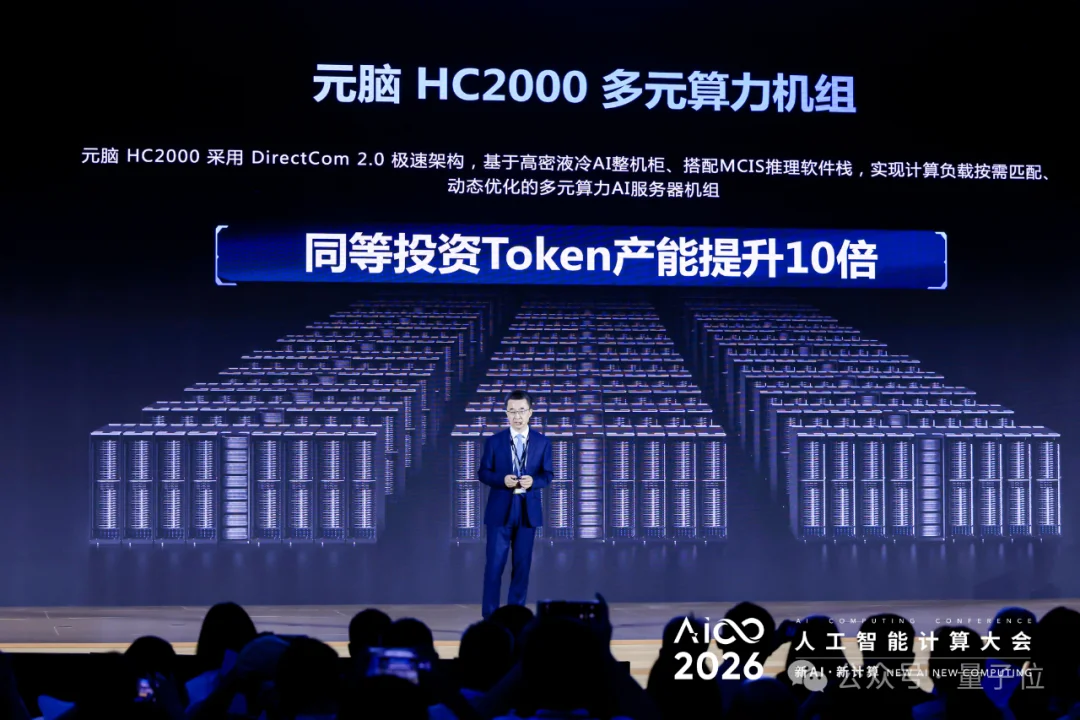
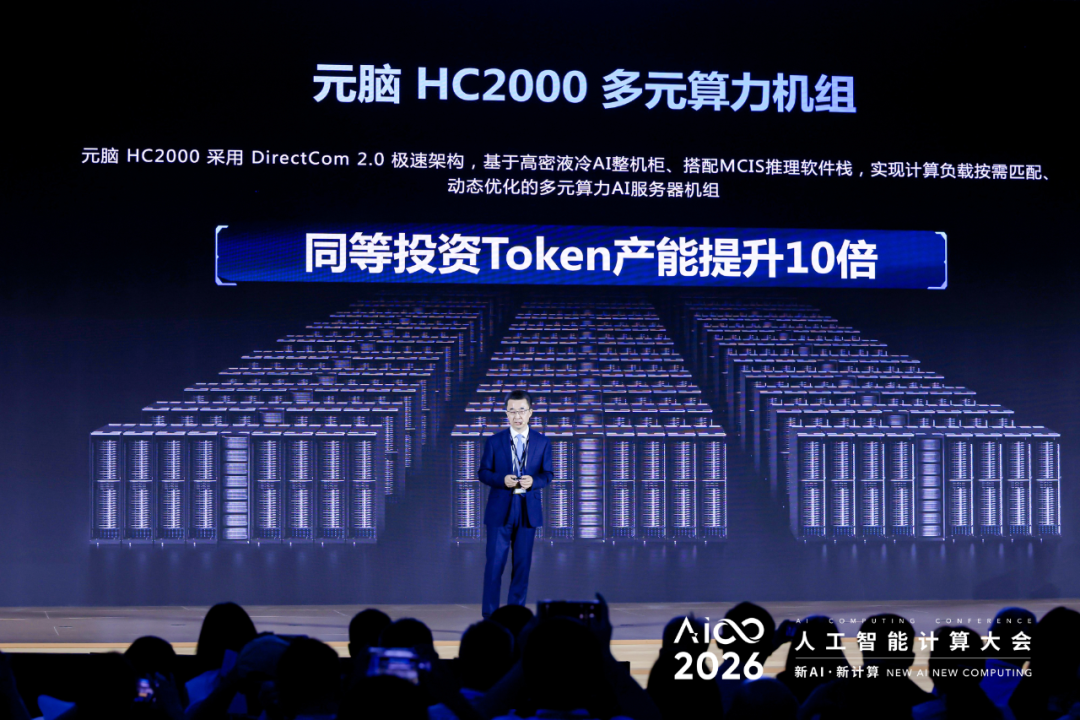
“同等投资Token产能提升10倍”这句话里,最容易被忽略的是前半句。同等投资意味着对比的锚点不是算力峰值,而是每单位资金能产出多少Token。这个口径本身比“算力提升几倍”更贴近用户的实际决策——企业买机器不是为了看跑分,是为了把推理服务跑起来、把成本摊薄。但“同等投资”的对比对象没有交代清楚:是跟上一代风冷产品比,还是跟同等预算的纯GPU方案比,还是跟不同配置的HC2000比?不同基线下的10倍,含义完全不同(E08、E13、E20)。
SLO约束下的对比意味着什么
限定条件里还有一条:“主流开源大模型推理服务”和“同样的SLO约束”(E30)。这两个前提把结论框在一个相当具体的场景里。SLO是服务等级目标,通常包括延迟上限、吞吐下限、可用性要求等。同样的SLO意味着对比双方在服务质量上是对齐的,不是拿一个跑得飞快但经常超时的方案去比一个稳定但慢的方案。这个约束让10倍这个数字有了可讨论的基础,但也意味着换一个模型、换一组SLO参数,结果可能大幅偏离。厂商没有披露具体是哪个模型、SLO数值是多少、测试方法是什么。
缺少第三方验证的厂商口径怎么用
MCIS软件栈的机制是清楚的:通过请求路由、P/D分离推理、算力动态调整和KV Cache管理,让不同类型芯片协同工作,减少闲置和等待(E22)。配套的传输优化数据——小数据量传输性能最高提升约5倍、节点内本地磁盘IO性能提升约32倍——为这个机制提供了一部分支撑(E16)。但这些数据同样是厂商测试口径,未披露测试环境和对比基线。
合理的做法是把10倍当作一个方向性信号,而不是一个可以直接写进采购报告的结论。它说明的是:在特定推理场景下,软硬协同优化有可能把Token产出效率拉高一个量级。至于这个量级在用户自己的业务负载下能兑现多少,取决于模型类型、请求模式、SLO要求和运维水平。在第三方基准测试出现之前,这个数字的参考价值大于决策价值。

对采购者和观察者来说,判断标准变了
从看峰值算力到看单位投资Token产出
采购者过去比的是单卡算力、互联带宽、显存容量。这些参数仍然重要,但它们回答的是“这台机器最快能跑多快”,而不是“这笔投资每年能产出多少可交付的Token”。当推理成为算力消耗主体,后一个问题才是预算审批时真正要回答的。HC2000把“同等投资Token产能”推到台前(E25),无论10倍这个具体数字是否可信,它指向的评估维度是成立的:分母是整柜的采购、供电、散热和运维成本,分子是在给定SLO下稳定输出的Token量。
这个标准要落地,软件栈的开放性是前提。MCIS兼容SGLang、vLLM等主流推理框架(E22),意味着用户不必被锁死在某一套调度工具上,也意味着单位投资Token产出可以跨框架比较,而不是只能在厂商自己的闭环里自说自话。
多元芯片支持是灵活性还是妥协
支持多种本土AI芯片,从采购角度看是议价空间和供应安全,从工程角度看则引入调度复杂度。不同芯片的算子覆盖、显存管理、通信原语不一致,混编部署时性能损耗和运维成本都会上升。MCIS声称能覆盖请求路由、P/D分离和KV Cache管理(E22),但这类协同的实际效率高度依赖具体芯片组合和模型结构,没有通用答案。多元支持是灵活性,代价是调优成本——这笔账要算进单位投资Token产出里,而不是只算硬件采购价。
这个转向在什么条件下会逆转
IDC与浪潮信息联合报告预测,全球活跃Agent从2026年约7940万个增至2030年22.16亿个,Token消耗量从0.026Peta增至152667Peta(E33、E38)。这组数字是容量型智算需求逻辑的基石。需要说明的是,该报告由IDC与浪潮信息联合发布,存在利益关联,预测值不等于实测值。
如果Agent规模化落地慢于预期,或者模型效率提升大幅降低单任务Token消耗,容量型智算的需求增速就会放缓,高密液冷机柜的高前期投入反而变成负担——液冷改造、机房承重、运维体系都需要提前投入,而这些投入只有在机柜长期高负载运行时才能摊薄。判断标准本身没有错,错的是把它当成无条件适用的公式。