---
title: "星火610(Sunniwell CV610)开发板 localvoiceprocess 语音功能模块教程——从音频采集到本地语音识别、多模态视觉交互与 ESP32-S31 硬核对比"
canonical_url: "https://supawriter.sevnday.com/articles/c9a34f9a-9035-434b-8267-001d20934105"
channel: "程序员技术架构与踩坑实战"
channel_slug: "tech-arch"
author: "SuperAdmin"
published_at: "2026-11-02T04:43:47.228578+00:00"
updated_at: "2026-11-20T13:04:14.097486+00:00"
word_count: 27049
keywords: ["语音","CV610","gt","voice","视觉","local"]
---
# 星火610(Sunniwell CV610)开发板 local_voice_process 语音功能模块教程——从音频采集到本地语音识别、多模态视觉交互与 ESP32-S31 硬核对比
> **摘要**:本文基于上海海思 **Hi3516CV610(轻 AI 越影解决方案)** 的 **星火 610(Sunniwell CV610 DevBoard)** 开发板,从零带你完成开箱组装、多仓 SDK 环境搭建、官方 `local_voice_process` 全双工语音模块源码剖析与上板实测。在此基础上,我更进一步将自研的边端实时语音助手(`edge_voice_assistant`)与 LVGL Siri 式流体动效、**1080p 摄像头实时视觉理解(VLM)** 完整移植到 CV610 上,并给出了与乐鑫 **ESP32-S31-Korvo-1** 在**同一云端、同一协议下的 27 轮端到端延迟、硬件 VQE 降噪(+10 dB)、AEC 回声抑制(29\~36 dB)及 CPU/内存开销**的硬核量化对比。全文干货含完整命令、源码解析、踩坑指南与实拍演示视频,小白照做即可复现!
---
## 目录
- 一、准备篇:开箱组装、硬件接线与编译烧录全流程
- 1.1 开发板开箱与全家福
- 1.2 主板、扩展板与麦克风/喇叭硬件接口详解
- 1.3 整机组装与喇叭/摄像头/屏幕接线图解
- 1.4 SDK 获取、编译环境搭建与固件/程序上板全流程
- 二、教程篇(核心):详解 local_voice_process 模块架构与实战跑通
- 2.1 local_voice_process 全双工语音链路总览
- 2.2 四大核心模块源码级拆解(AI+VQE / 离线KWS / 能量VAD / 共时钟AO)
- 2.3 分步编译、配置文件修改与上板运行日志
- 2.4 常见报错与 8 大真实踩坑排查手册
- 三、进阶篇:对比 ESP32-S31 边端语音助手 + GUI 屏幕联动 + 视觉多模态实战
- 3.1 同云端 A/B 实验设计:CV610 对决 ESP32-S31-Korvo-1
- 3.2 量化对比一:唤醒距离、硬件 VQE 降噪与识别率实测
- 3.3 量化对比二:端到端语音延迟(27 轮实测)与 CPU/内存资源利用率
- 3.4 配合 GUI 将语音状态与识别结果显示到 2.8" LCD(Siri 浮层球 + 语音控设备)
- 3.5 榨干 CV610 视觉基因:语音控制 1080p 拍照 + 实时画面识别(VLM)
- 四、总结篇:易用性、文档质量体验总结与适用场景建议
- 4.1 开发体验与文档质量打分
- 4.2 选型指南:什么时候选星火 610(CV610),什么时候选 ESP32-S31?
- 4.3 对海思 Hi-AIoT 社区与开发板的改进期待
- 4.4 附录:星火 610 开发板官方购买链接与参考资料
---
## 一、准备篇:开箱组装、硬件接线与编译烧录全流程
### 1.1 开发板开箱与全家福
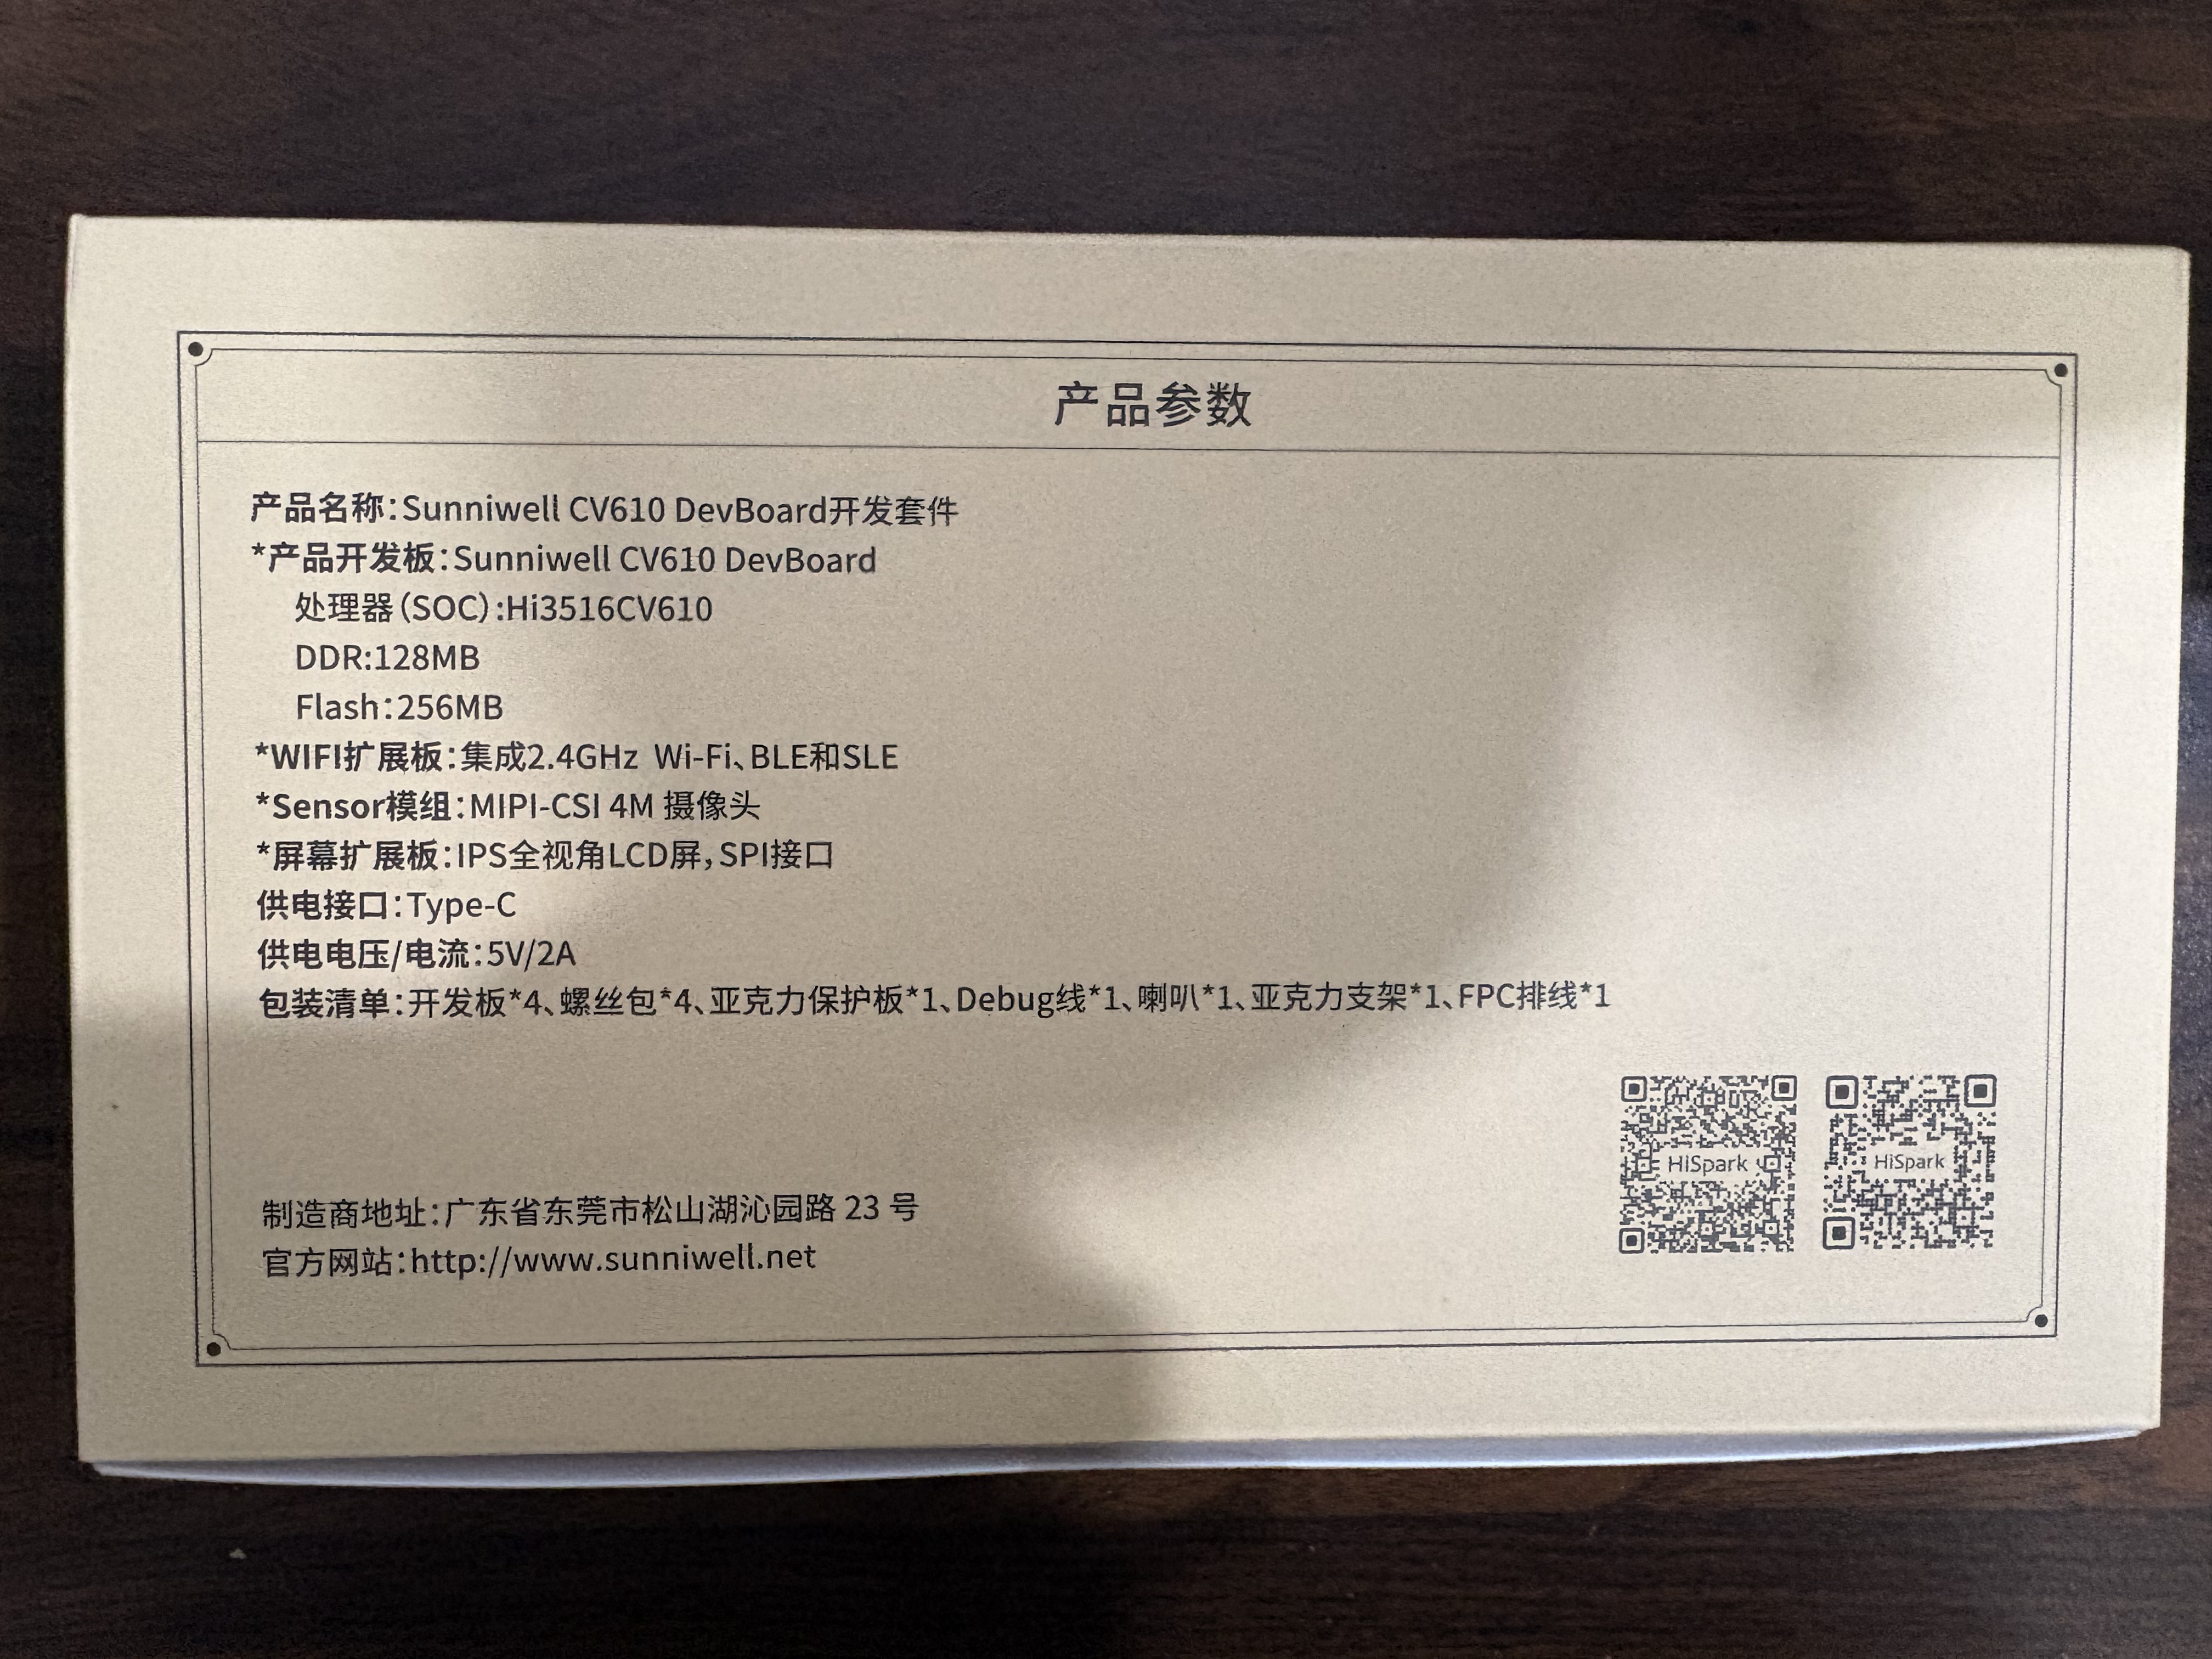
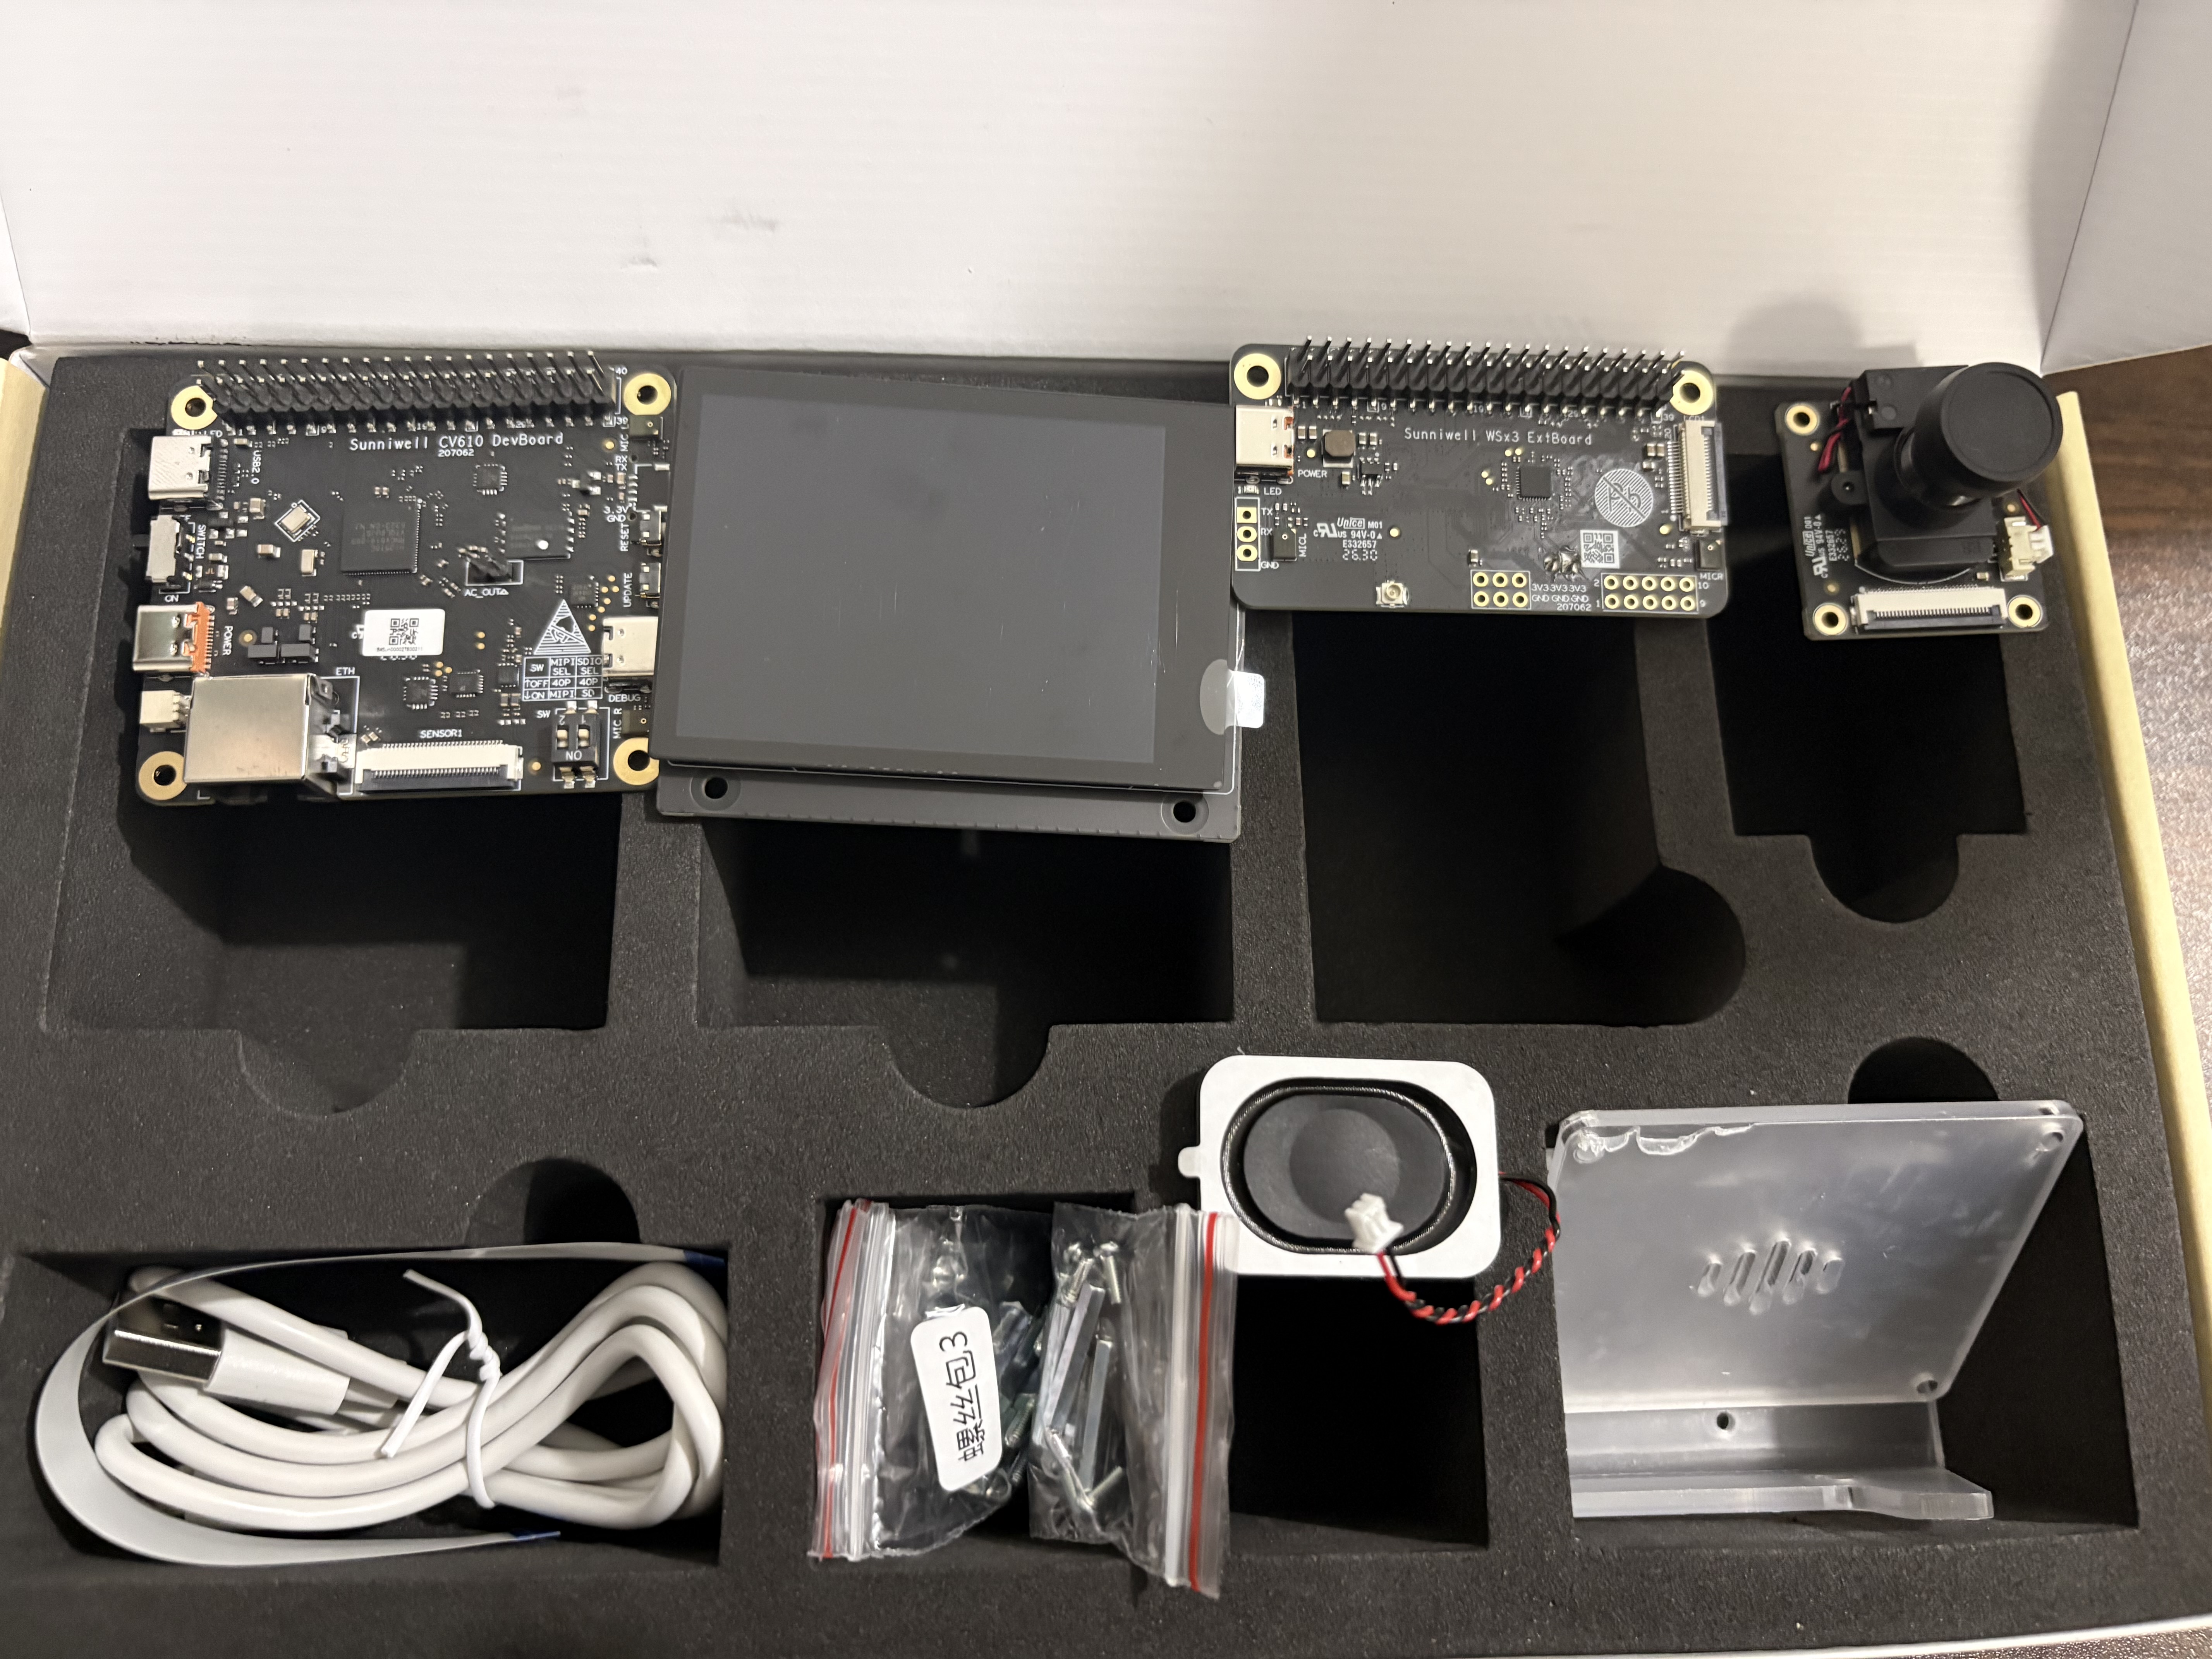
收到 **星火 610(Sunniwell CV610 DevBoard)** 套件时,包装非常扎实。整套开发套件采用模块化设计,包含:
1. **CV610 核心主板**(搭载海思 **Hi3516CV610** SoC:双核 ARM Cortex-A7 @ 950MHz + **1 TOPS NPU** + 128MB DDR3L + 256MB SPI NAND Flash);
2. **WS73 无线通信扩展板**(支持 **Wi-Fi 6** + **BLE 5.2** + **星闪 SLE 1.0**,通过 40-Pin 树莓派兼容接口与主板叠层连接);
3. **OS04D10 400 万像素 MIPI CSI 摄像头模组**(支持 2560×1440@30fps 采集,带 IR-CUT 日夜切换);
4. **2.8 英寸 240×320 SPI 电容触摸屏(JD9853 驱动 IC)**;
5. **腔体喇叭(8Ω / 2W)**、散热片、亚克力支架与铜柱螺丝包。
---
### 1.2 主板、扩展板与麦克风/喇叭硬件接口详解
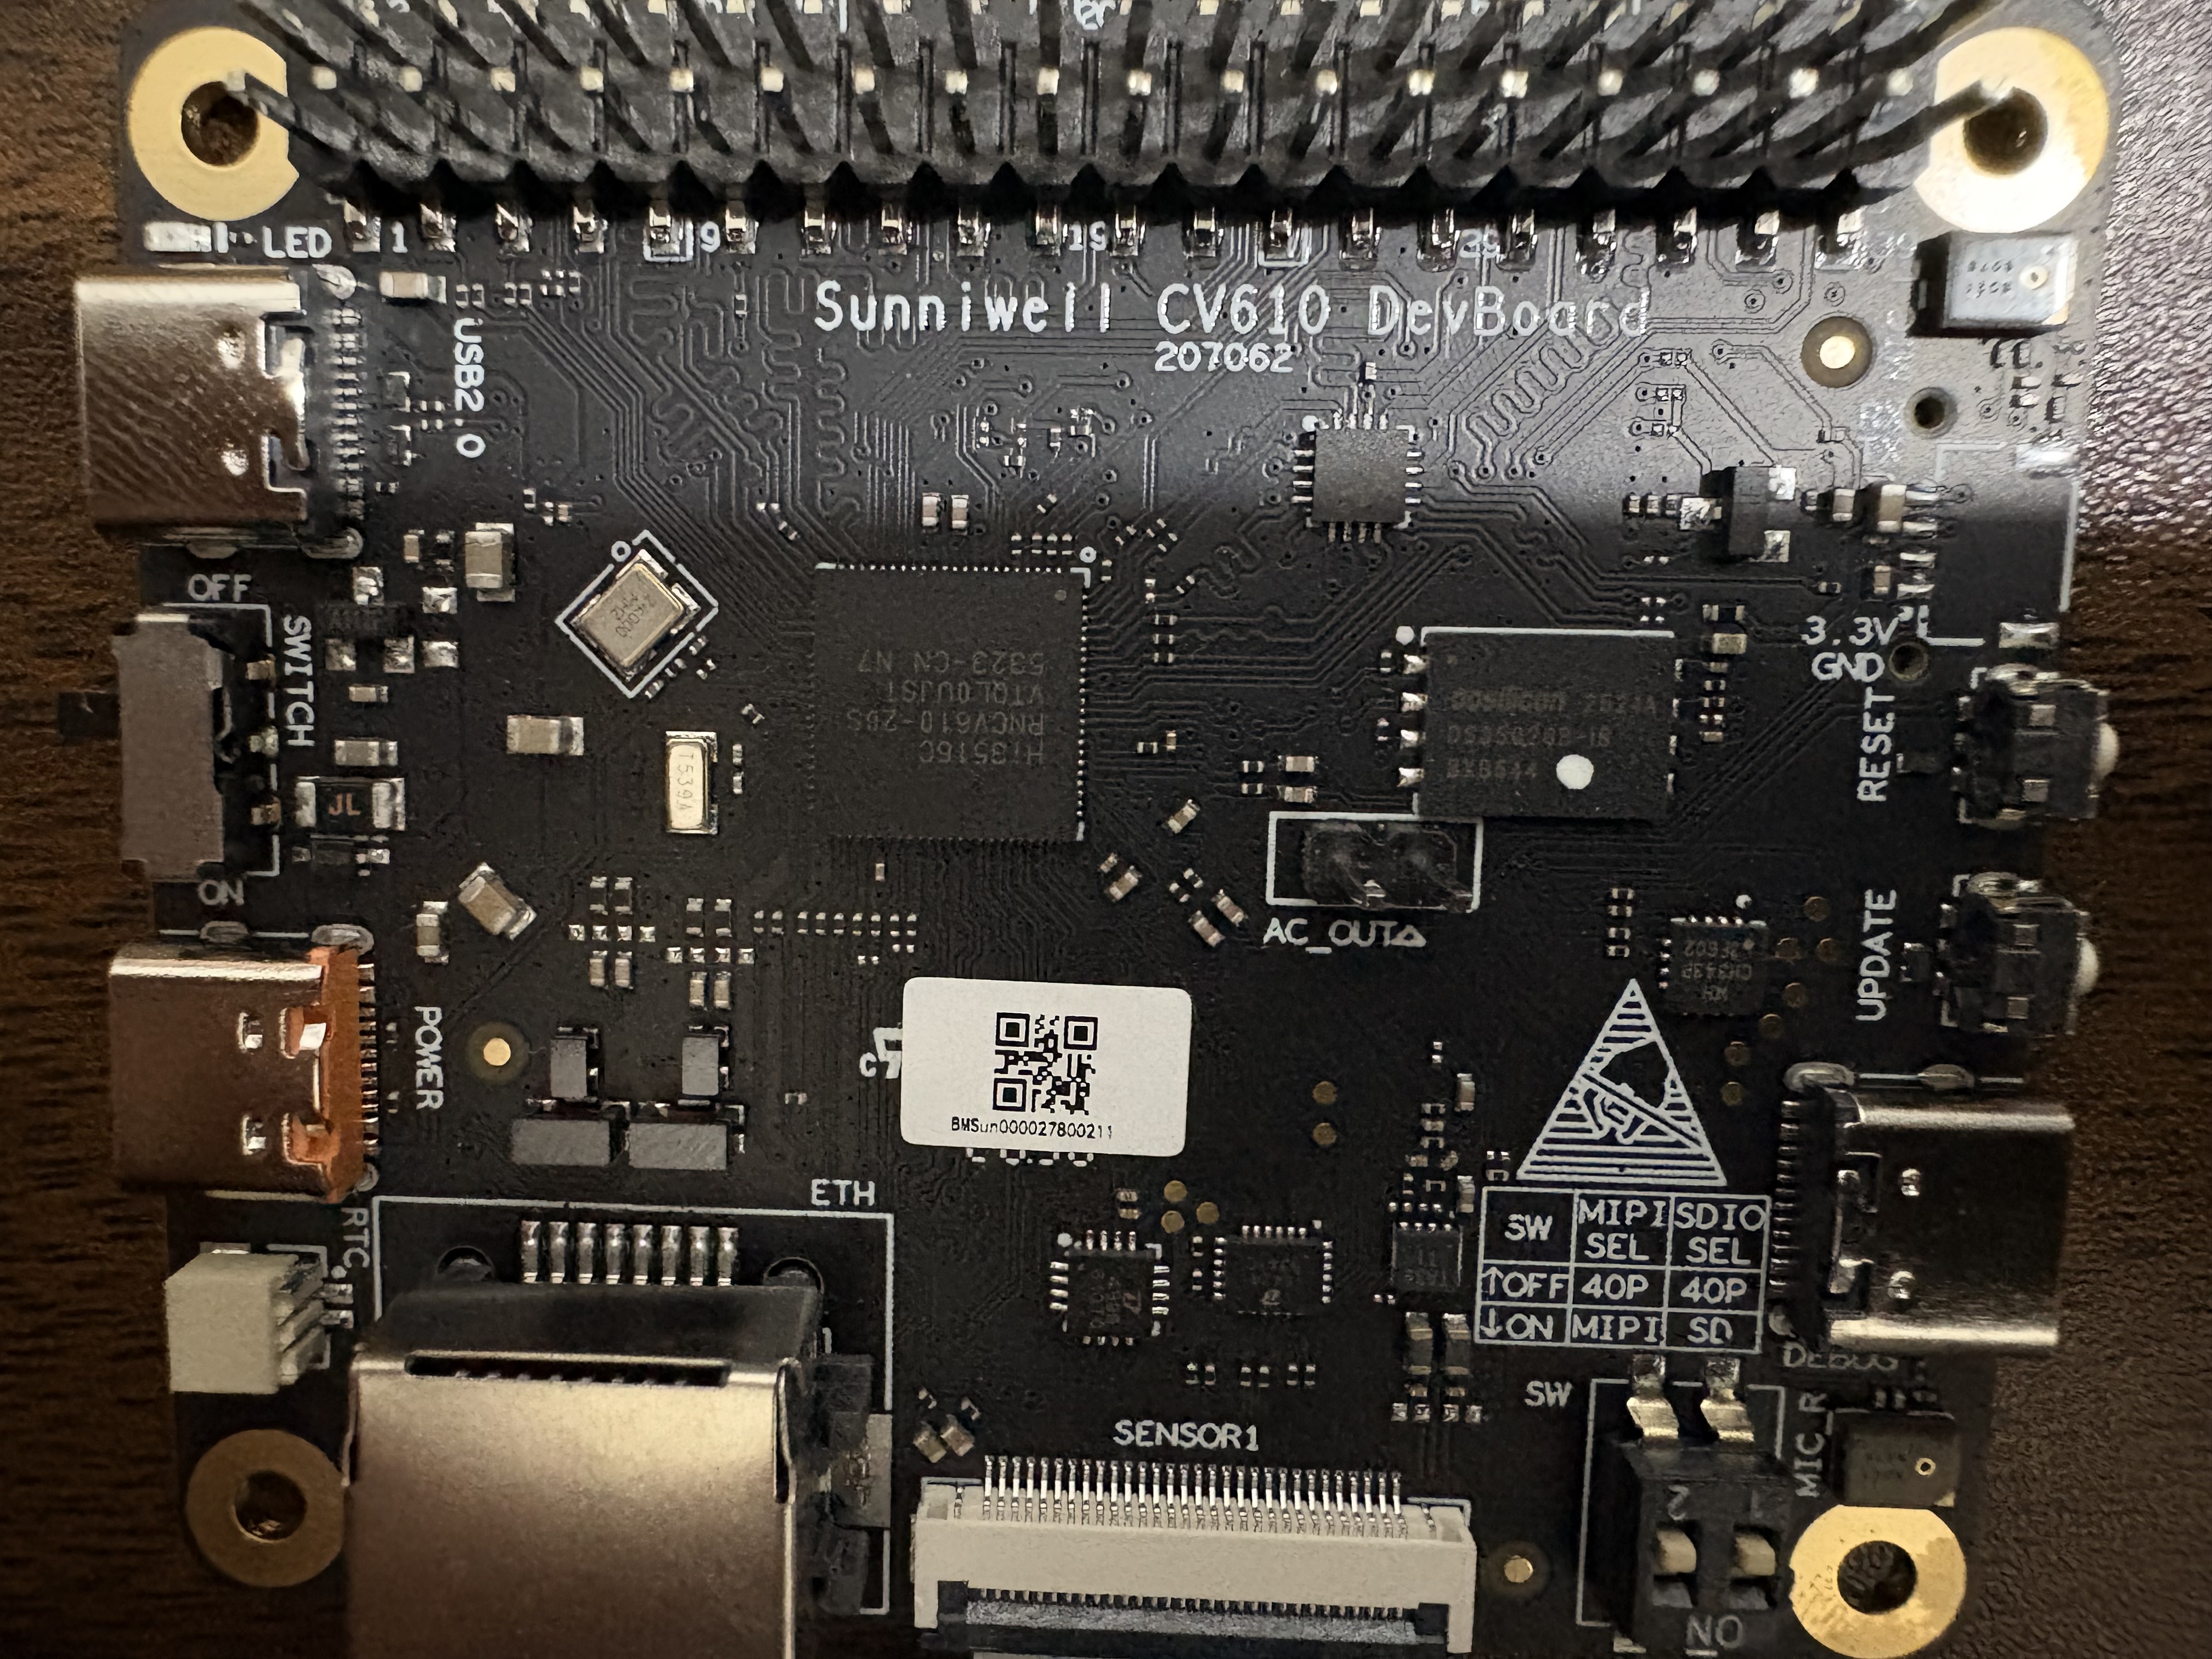
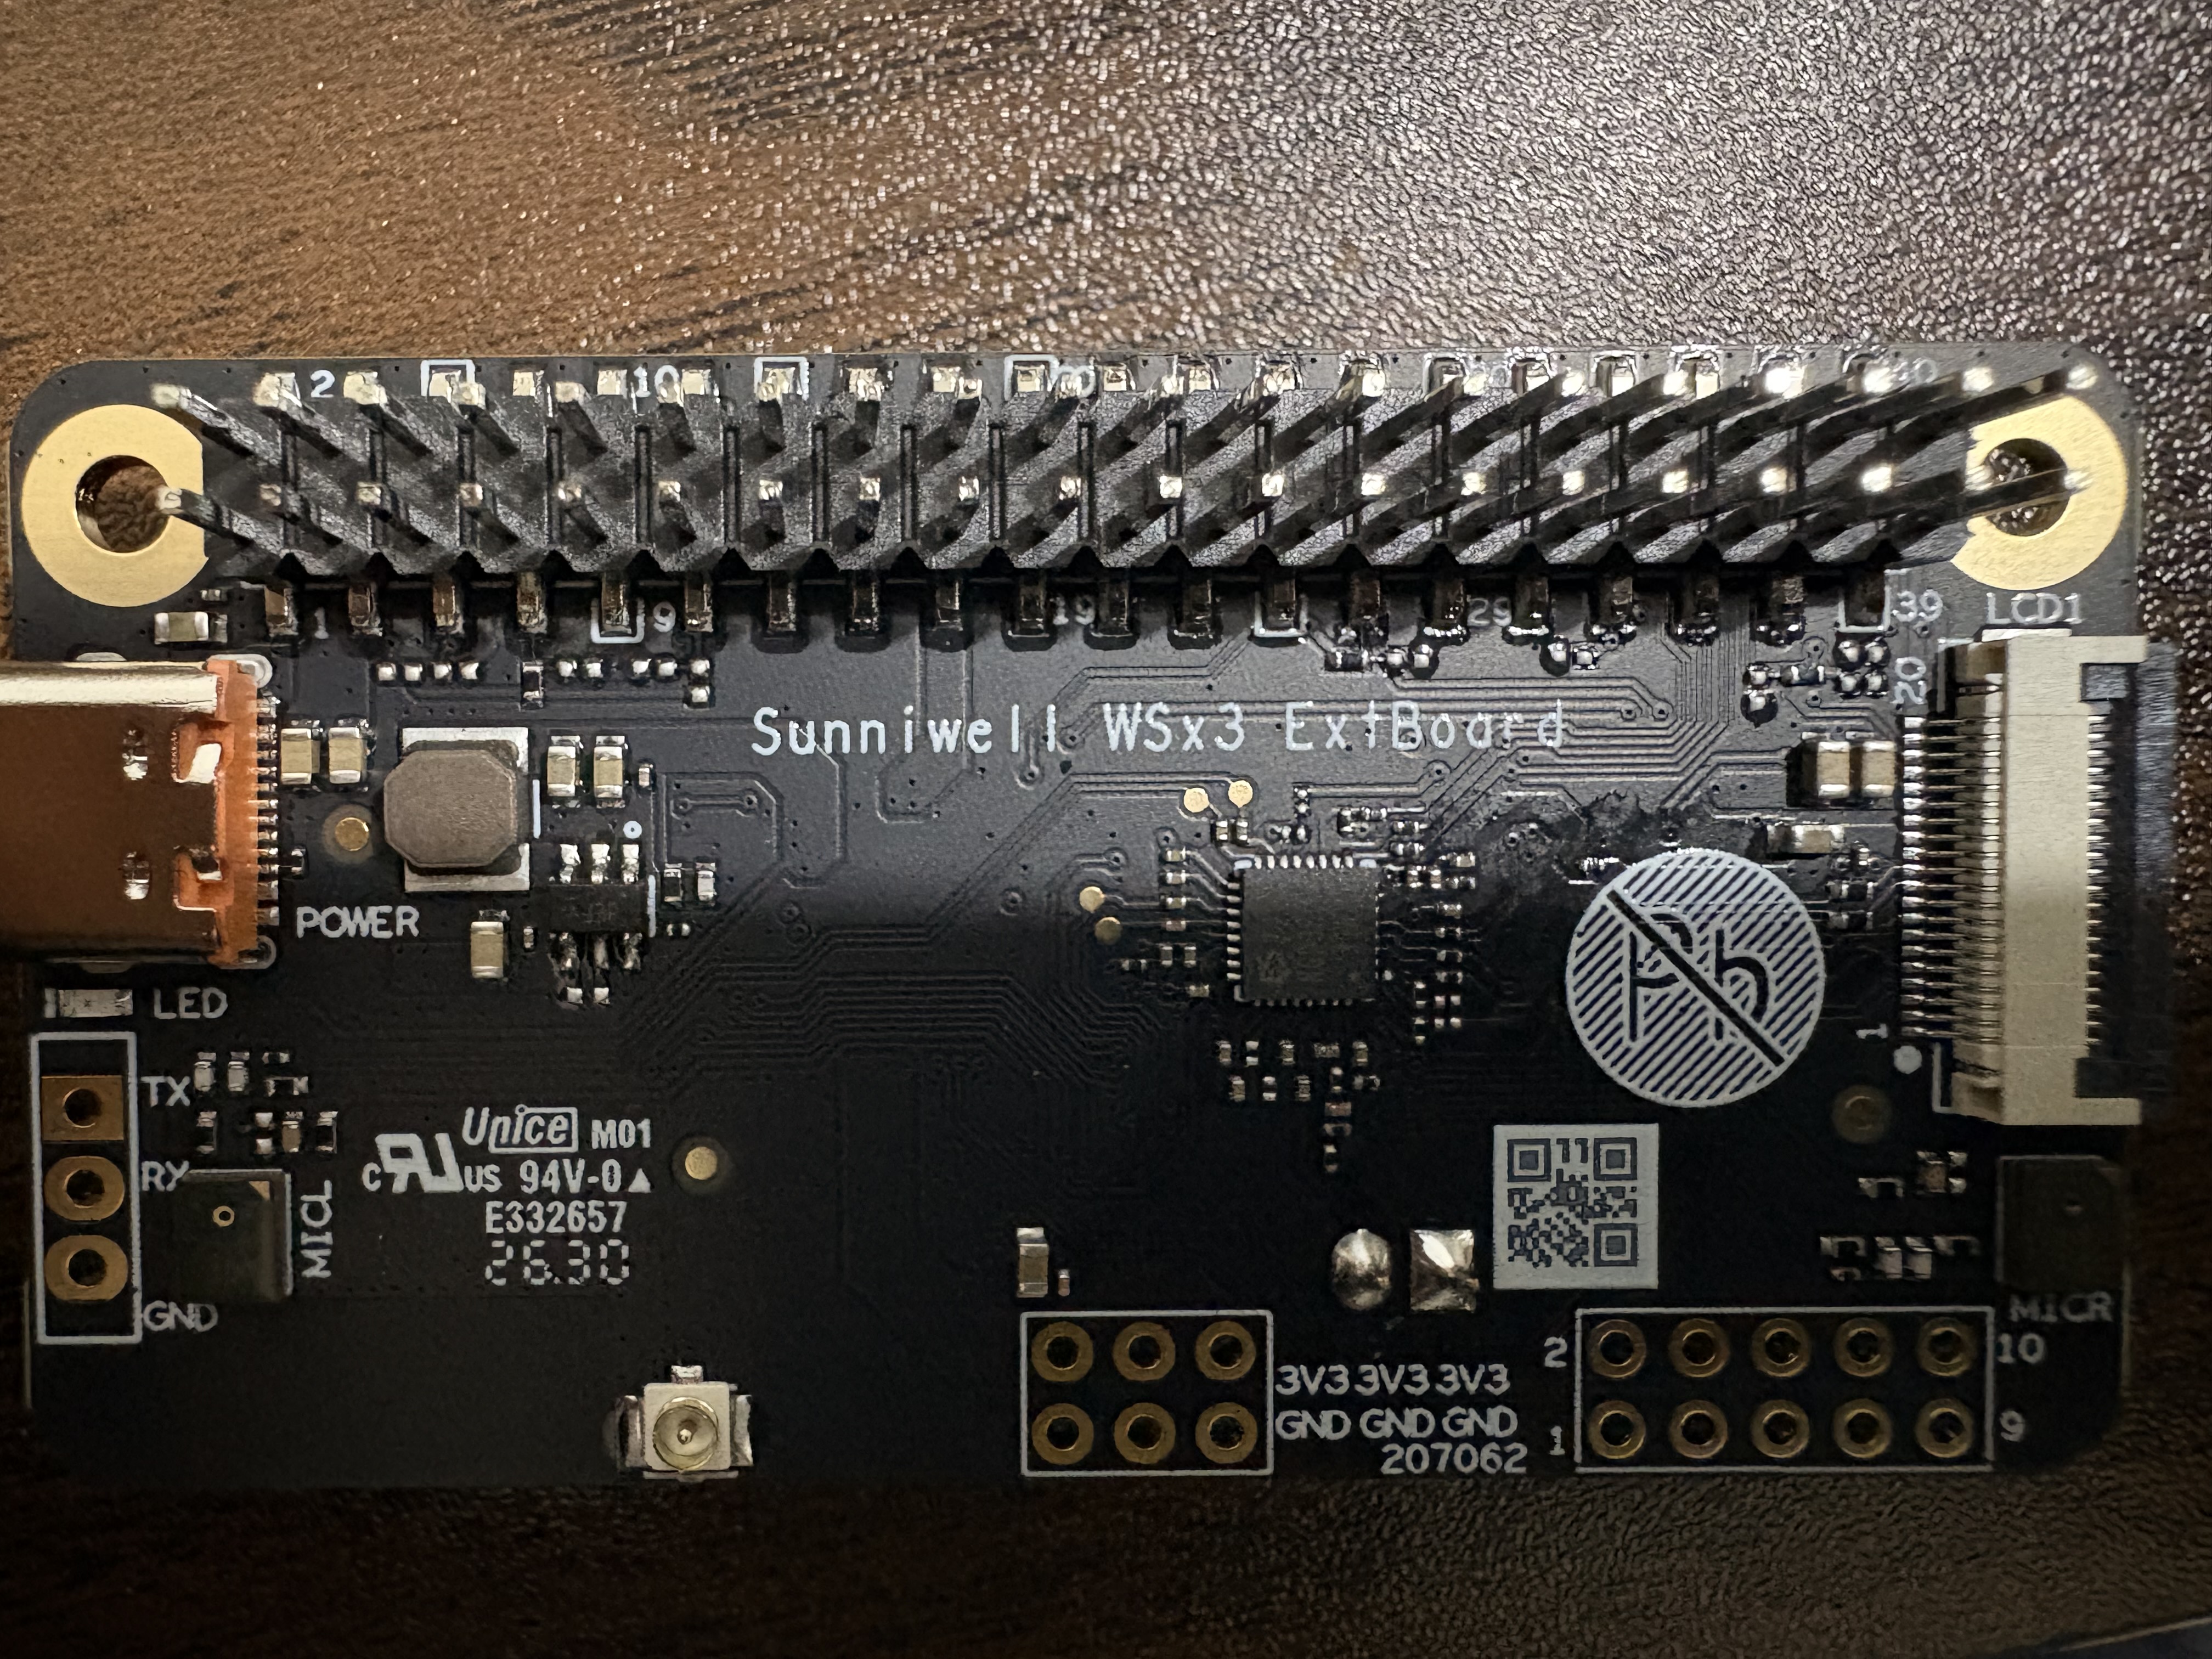
在动手接线前,我先带大家摸清主板和扩展板上的关键接口,尤其是**音频采集与播放链路**的硬件位置:
- **板载双模拟硅麦(MIC1 / MIC2)**:主板正面左右两侧各焊接了一颗全向模拟 MEMS 硅麦(型号 **ML-3729-T1M1**),采用伪差分(`IN_D`)方式直接进入 Hi3516CV610 芯片内置的 **ACODEC(音频编解码器)**,无需外挂音频 Codec 芯片即可实现双麦拾音。
- **板载功放与喇叭接口(SPK)**:主板带有 2-Pin 防呆端子,由内置 ACODEC DAC 输出经板载功放驱动 **8Ω/2W 腔体喇叭**。
- **关键拨码开关** `SW1301`:
- `SW1301-1`:**SPI0 屏幕与 TF 卡(SDIO0)复用切换开关**。默认拨在 `OFF`**(单屏显示模式)**,此时 `GPIO3_4~3_7` 与 `GPIO4_0~4_3` 路由给 40-Pin 扩展口驱动 2.8" SPI LCD;若拨到 `ON` 则切换给背面 TF 卡槽(屏幕将无显示)。**本文全程需要屏幕交互,请务必保持** `SW1301-1 = OFF`**!**
---
### 1.3 整机组装与喇叭/摄像头/屏幕接线图解
硬件组装与音频/视频接线步骤如下(5 分钟即可完成):
flowchart LR
subgraph BOARD["Sunniwell CV610 核心主板 (Hi3516CV610)"]
MIC["板载双模拟硅麦\nML-3729-T1M1 ×2"] --> ACODEC["内置 ACODEC\n(/dev/acodec)"]
ACODEC --> SPK_PORT["2-Pin 喇叭接口\n(J_SPK)"]
MIPI["MIPI CSI0 接口"]
HEADER40["40-Pin 扩展排母\n(含 SPI0 / I2C / SDIO1)"]
USB_PWR["Type-C 供电/串口"]
end
SPK_PORT -- "红正黑负插紧" --> SPK["8Ω 2W 腔体喇叭"]
MIPI -- "FFC 排线(金手指朝向板内)" --> CAM["OS04D10 4MP 摄像头"]
HEADER40 -- "40Pin 对插" --> EXT["WS73 无线扩展板"]
EXT -- "FPC 排线" --> LCD["2.8寸 240×320 触摸屏"]
> **⚠️ 组装防呆提醒**:
>
> 1. **喇叭接线**:将附带的 8Ω/2W 喇叭插头插入主板的 2-Pin 喇叭座(卡扣方向对准按紧),不接喇叭后续跑 `local_voice_process` 会变成“哑巴”。
> 2. **摄像头 FFC 排线**:务必确认金手指接触面方向正确并扣紧黑色锁扣,排线插反会导致启动时报错 `sensor probe failed`。
> 3. **供电要求**:使用主板上的 **Type-C 接口(5V/2A)** 供电,同时该口内置了 CH340 串口桥接(波特率 `115200`)。
组装完成后的四视图如下,小巧紧凑,非常像一台微缩版的桌面 AI 伴侣机器人:
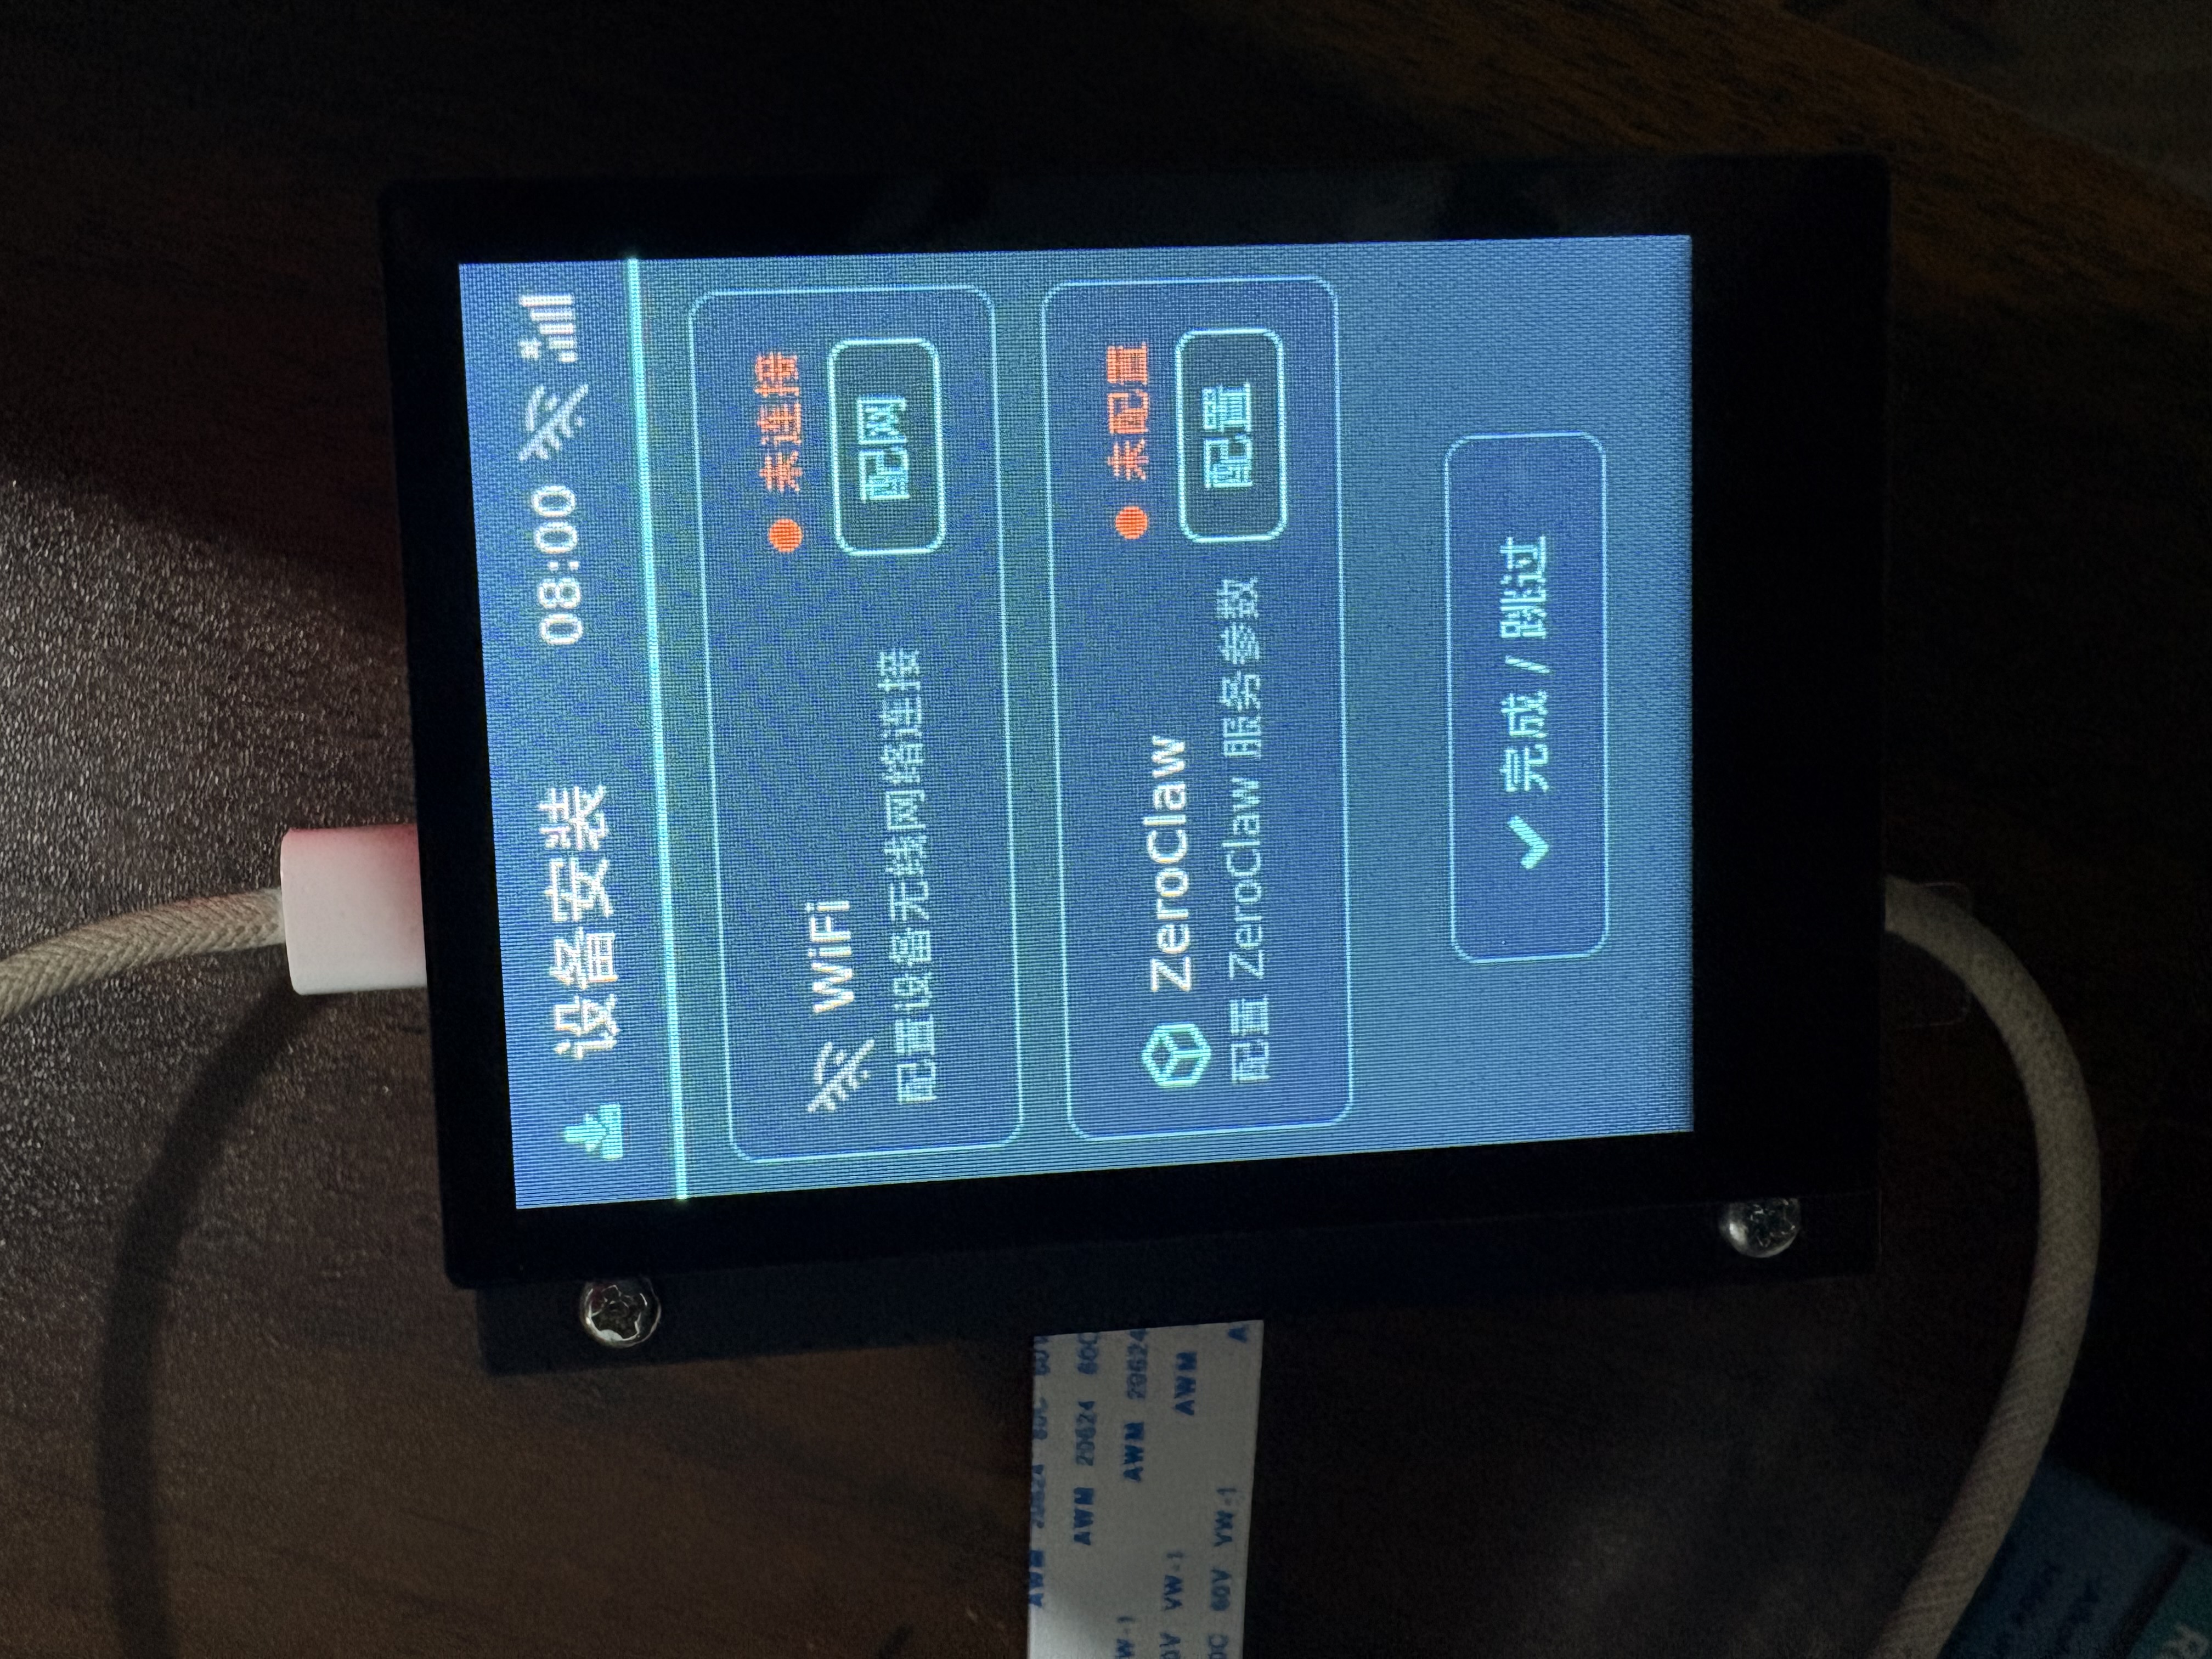
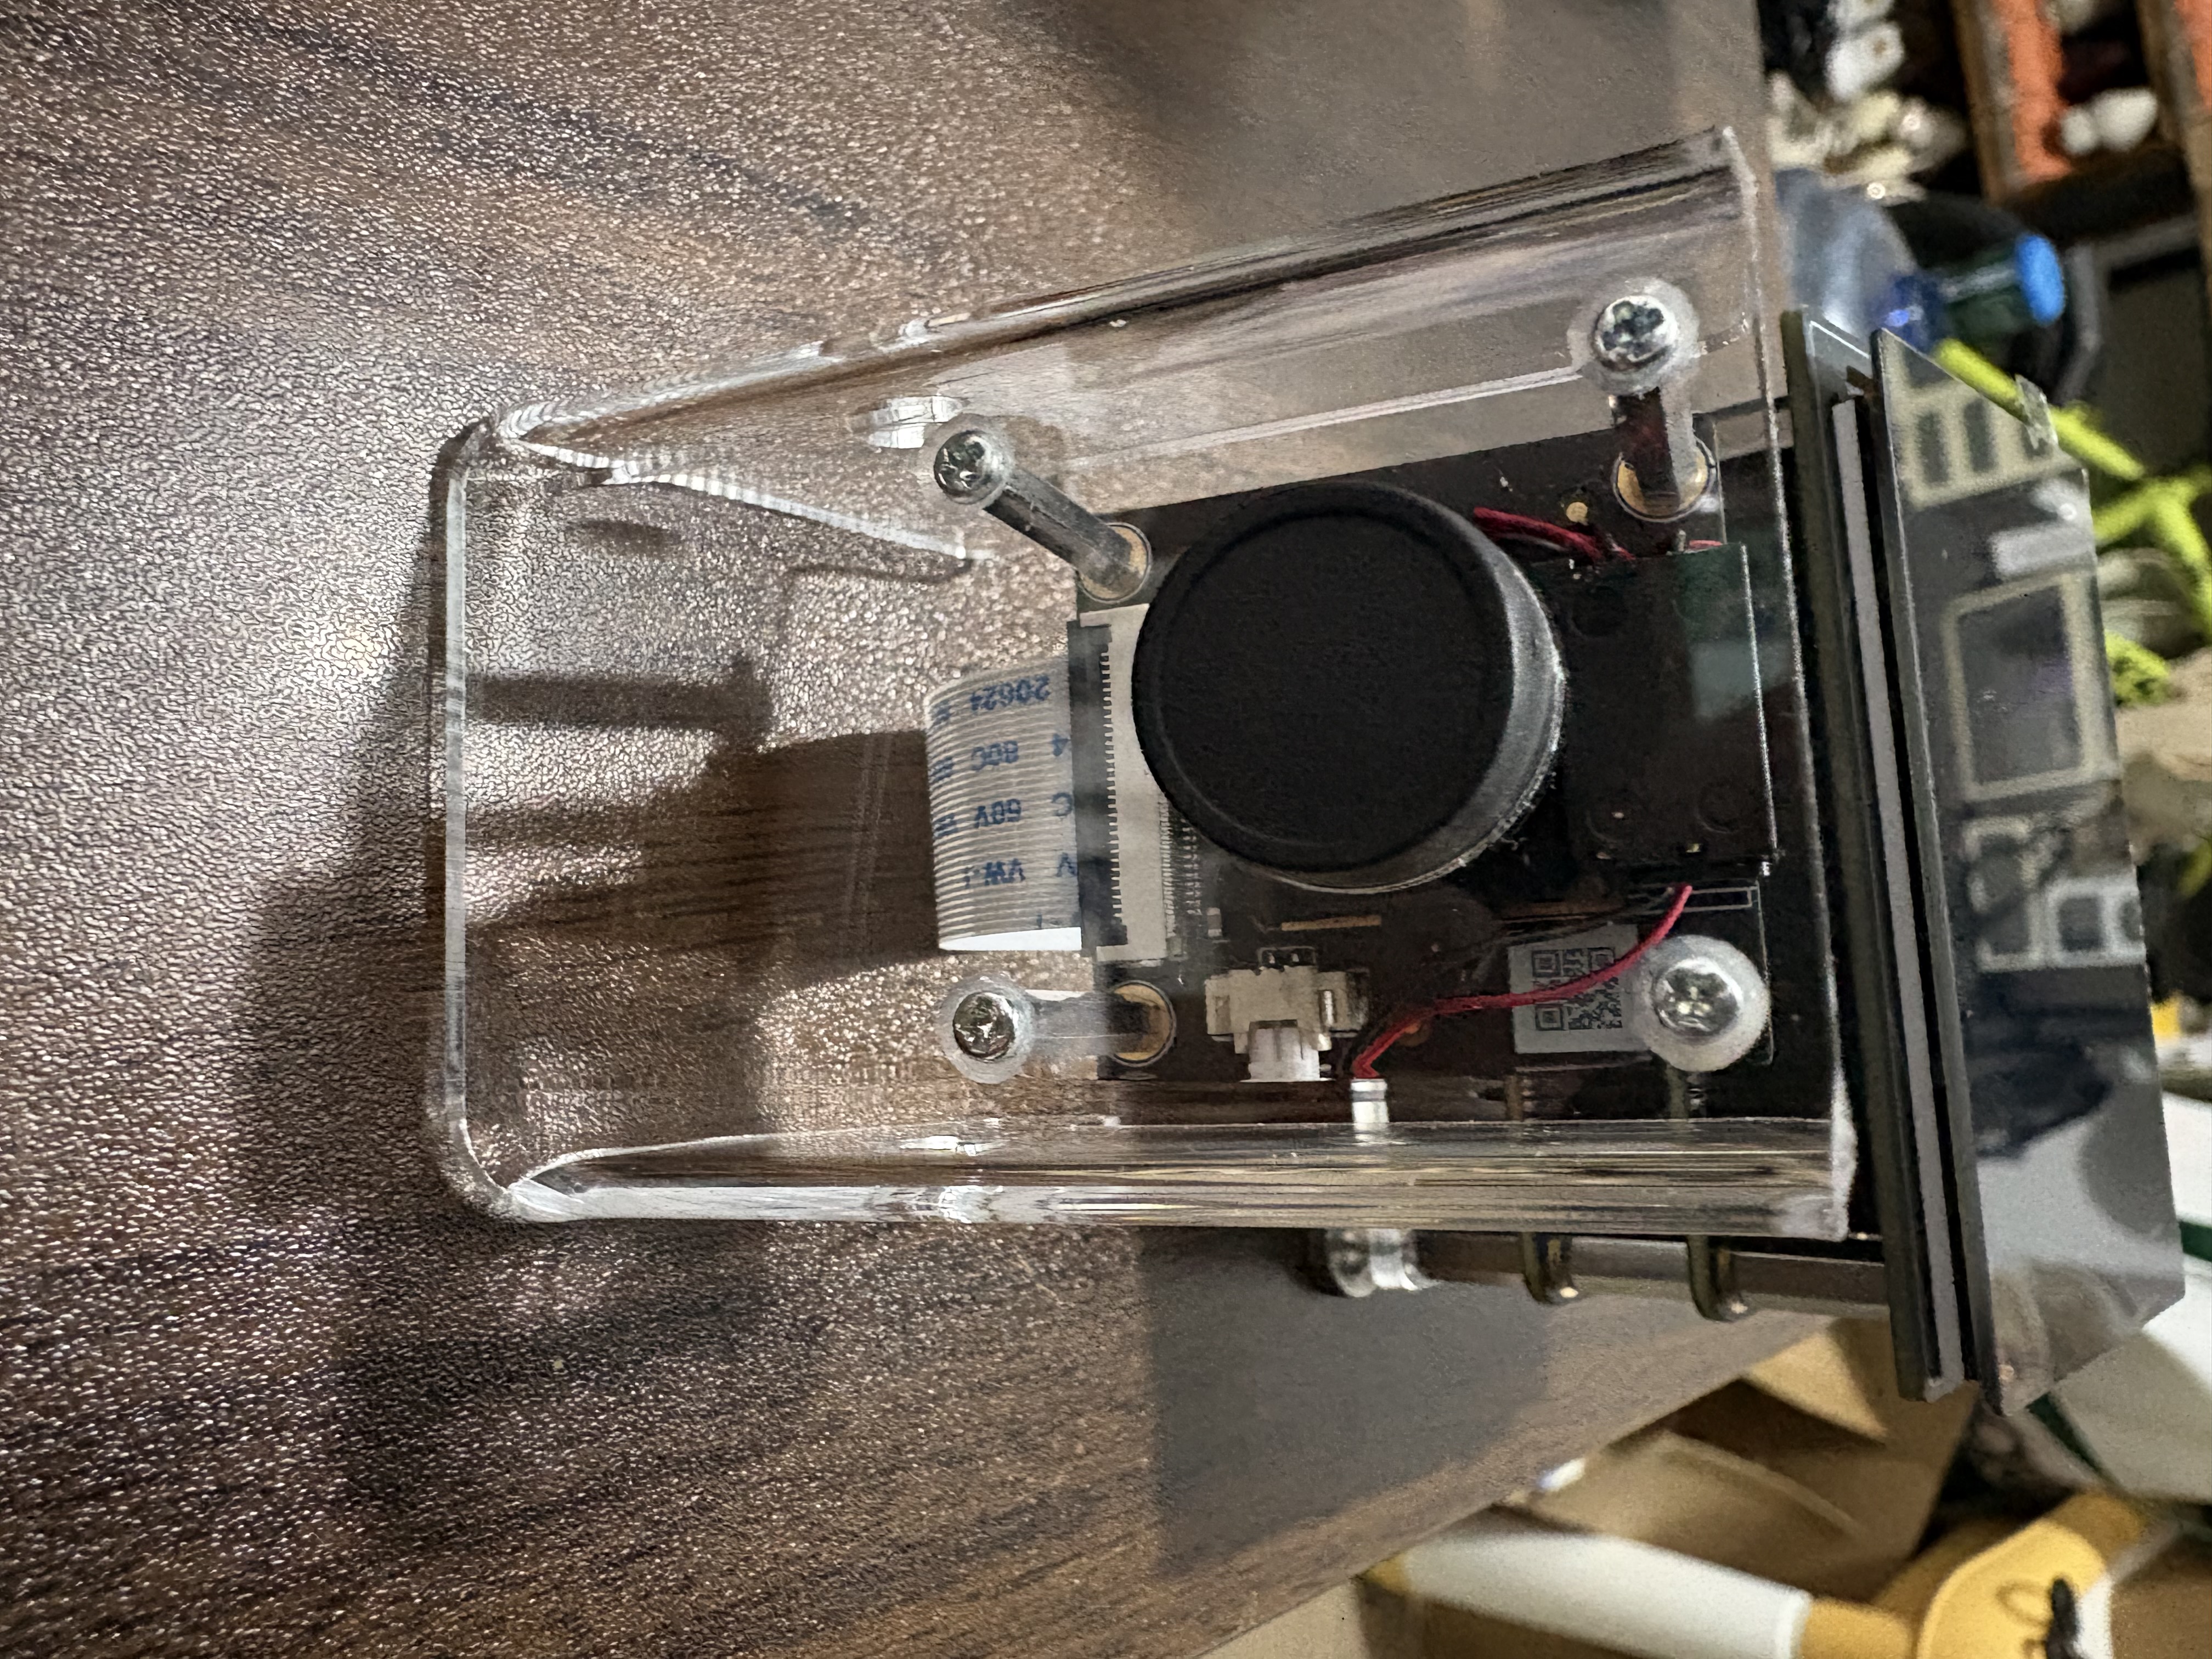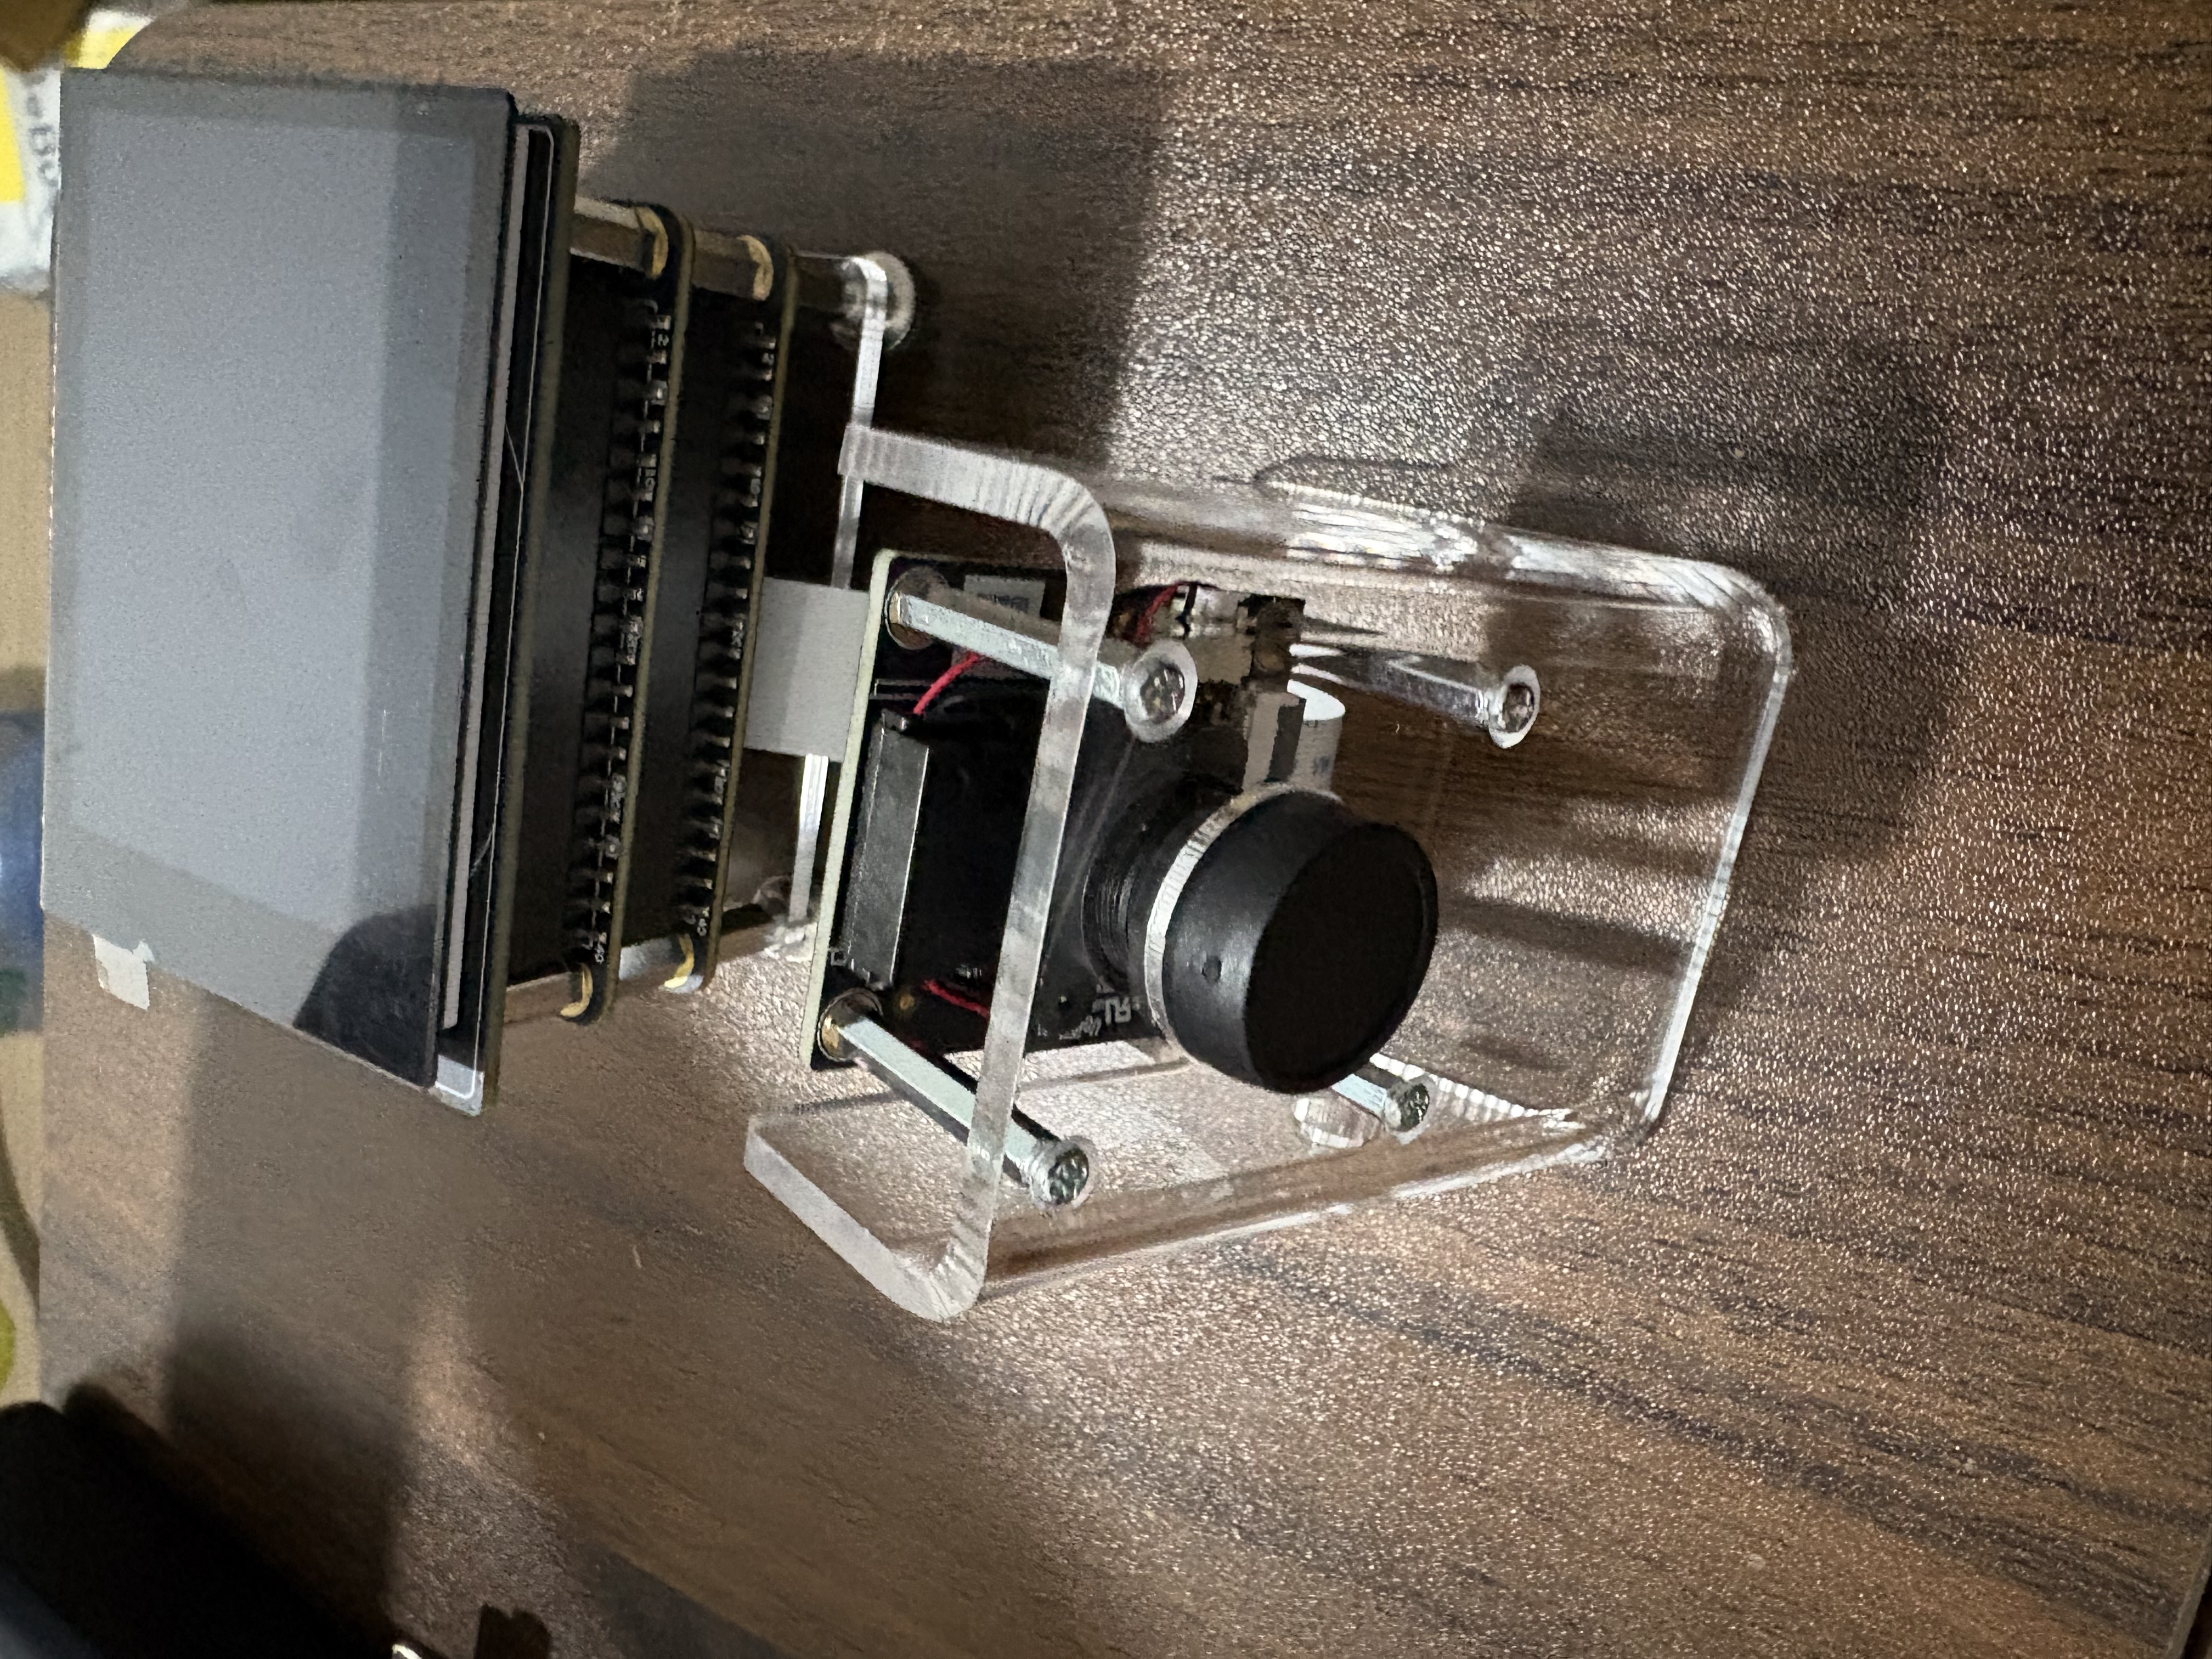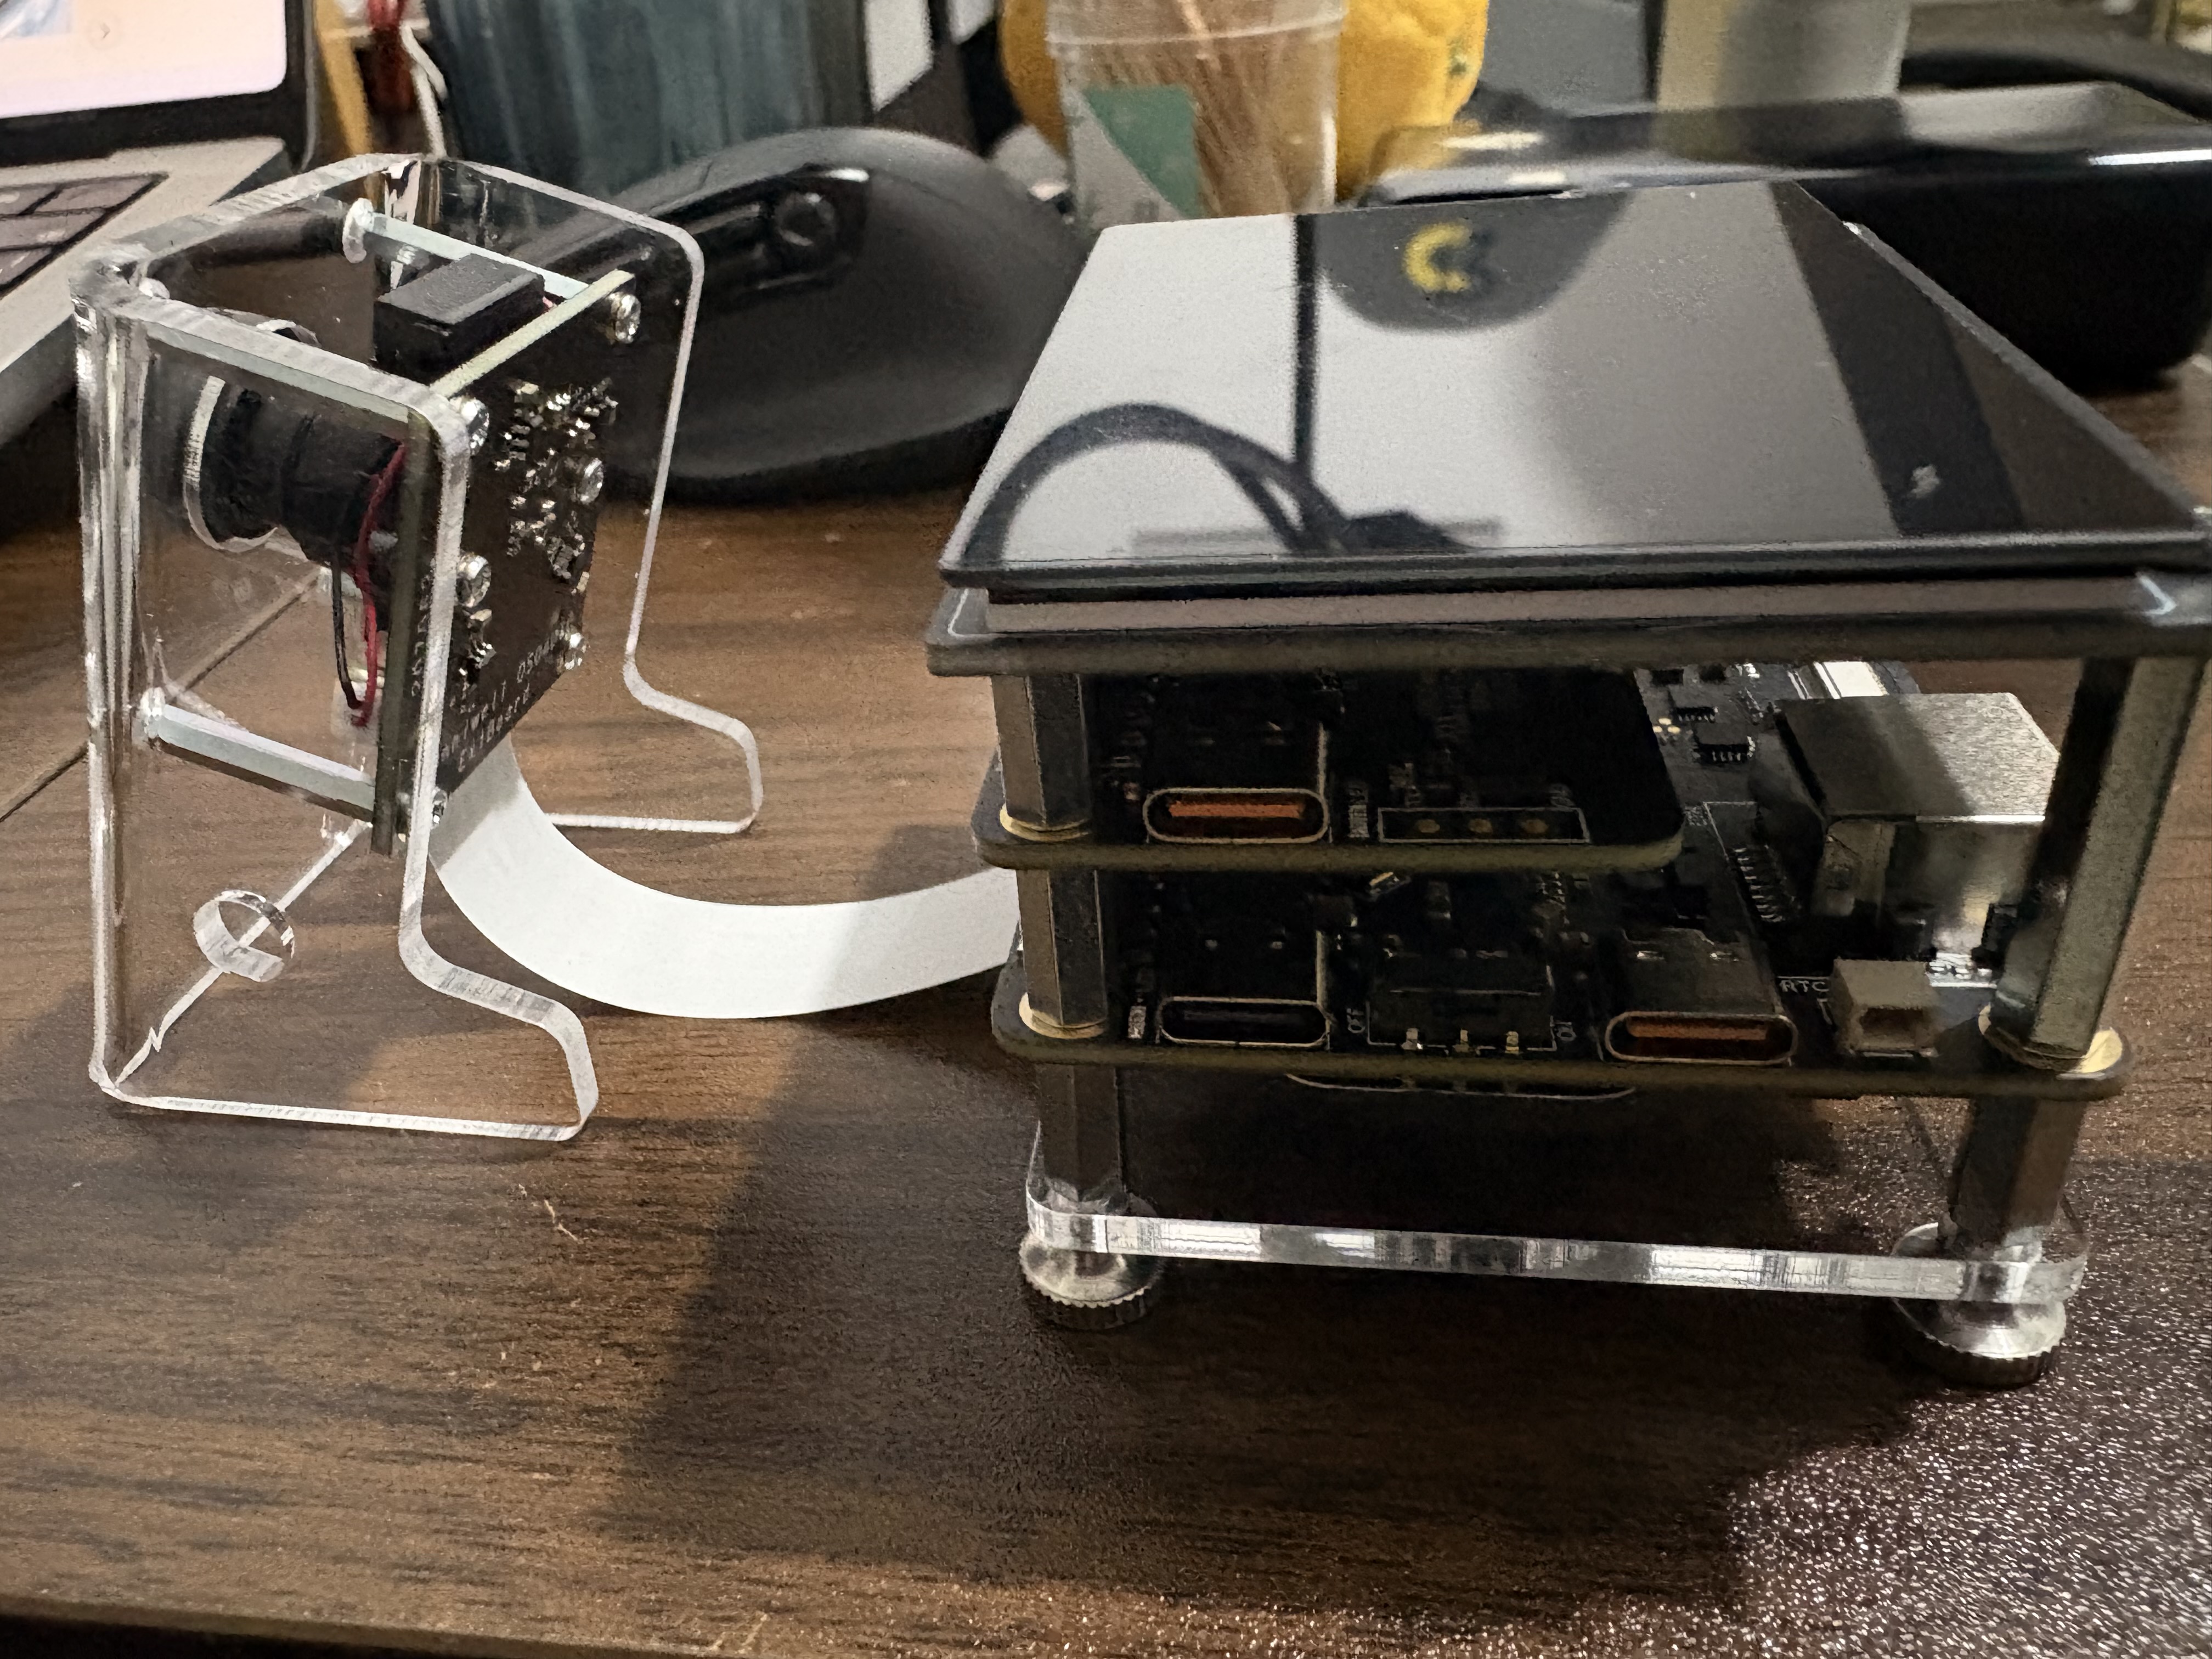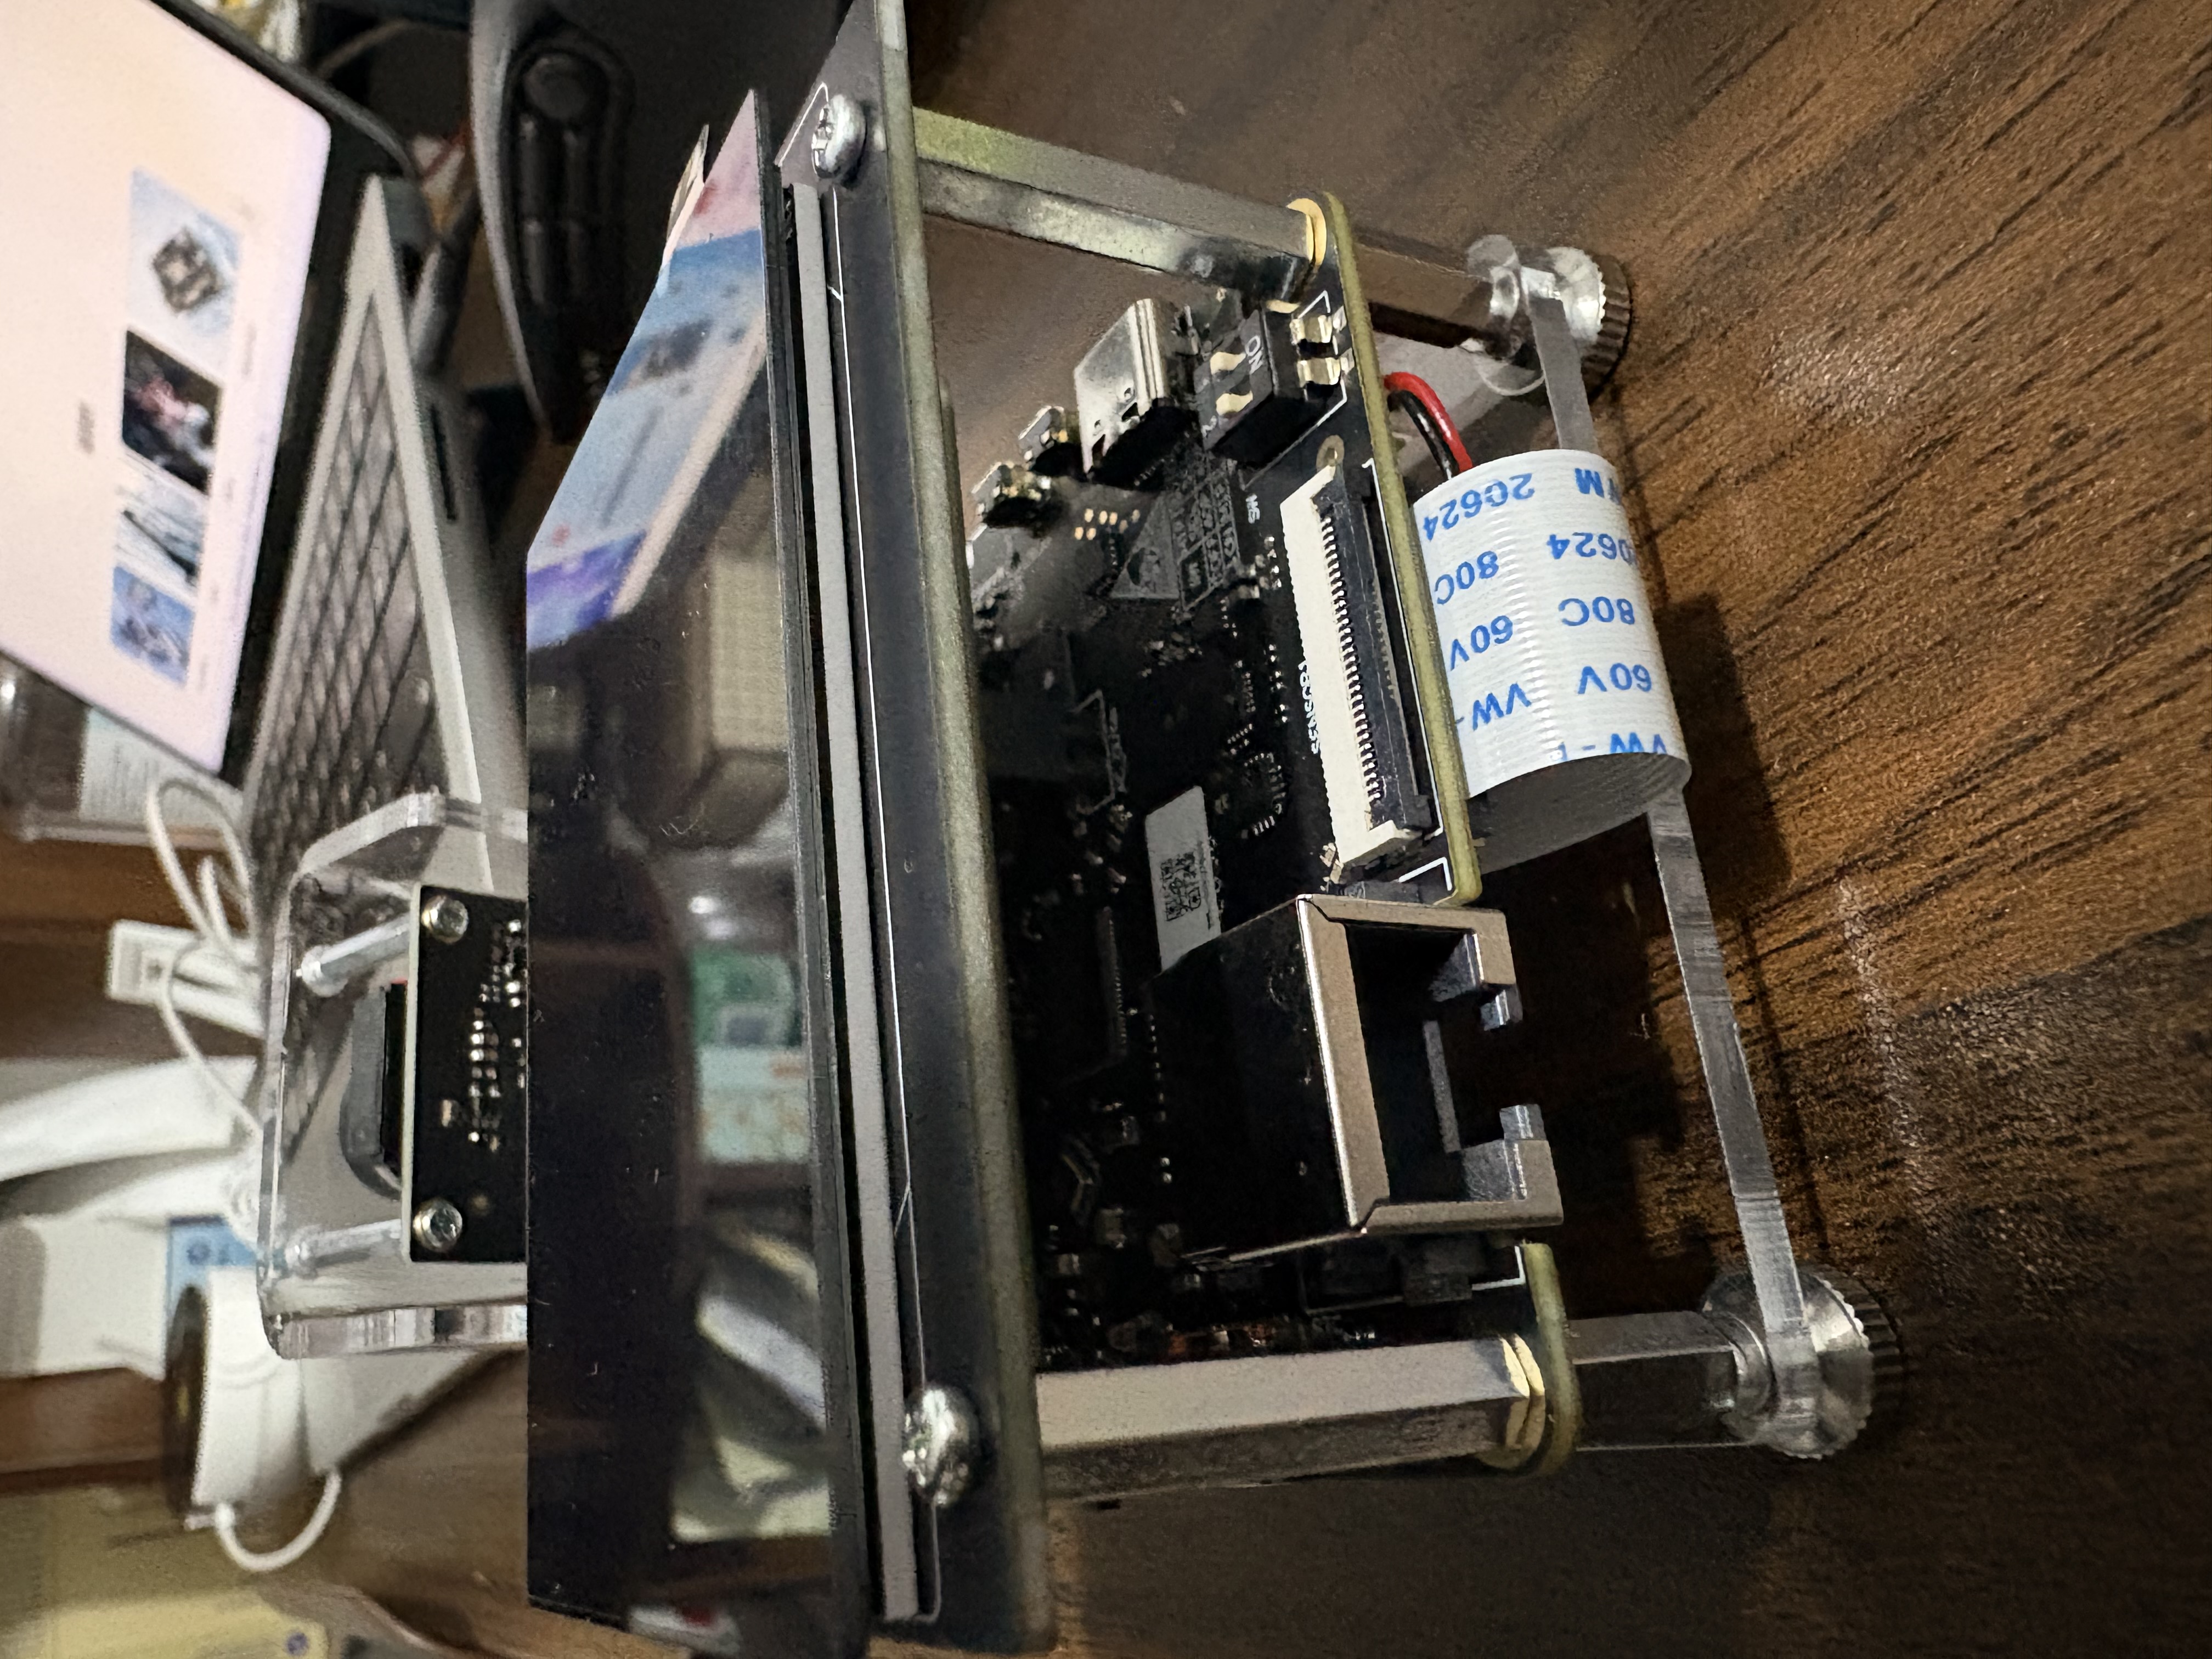上电后,板载预装的出厂系统(`factory_demo_ws73_lcd`)秒级启动,2.8 寸屏幕点亮,支持触控进入视频预览、RTSP 推流、BLE 配网等模块:
---
### 1.4 SDK 获取、编译环境搭建与固件/程序上板全流程
#### 步骤 1:获取 Hi-AIoT Solution 多仓源码(避坑必看!)
海思 CV610 的 `hi_aiot_solution` 采用 **Repo 多仓库架构**(包含主框架仓、开发板仓、芯片 SDK 仓、AI 组件仓、媒体组件仓等 7 个子仓)。
> **🚨 新手头号大坑**:如果你只用 `git clone https://gitcode.com/HiSpark/hi_aiot_solution.git` 克隆主仓,会发现主仓的 `.gitignore` 把 `apps/`、`components/`、`sdk/Hi3516CV610` 全部排除了,直接编译一定会报错!**必须使用** `repo` **工具拉齐完整工程**:
```bash
# 1. 创建工作目录并初始化 repo
mkdir -p ~/HiSpark/cv610 && cd ~/HiSpark/cv610
repo init -u https://gitcode.com/HiSpark/hi_aiot_solution_manifest.git -b master
repo sync -c -j4
# 2. 同步完成后检查目录结构(确保 sdk/Hi3516CV610 与 components 均已就位)
ls -la hi_aiot_solution/
```
#### 步骤 2:搭建交叉编译环境(Ubuntu / WSL2 / macOS Docker 通用)
CV610 使用 `arm-v01c02-linux-musleabi-gcc`(GCC 10.3,musl libc,32 位 ARM)工具链,已内置在 `sdk/Hi3516CV610/prebuilts/` 中。
- 如果你是 **Ubuntu 22.04 / WSL2** 用户,可直接运行官方环境脚本;
- 如果你和我一样使用 **macOS(Apple Silicon M 系列)**,可通过 Docker `linux/amd64` 容器完美构建:
```bash
# 启动 Ubuntu 22.04 x86_64 编译容器并挂载源码目录
docker run -it --rm --platform linux/amd64 \
-v ~/HiSpark/cv610:/workspace \
-w /workspace/hi_aiot_solution \
ubuntu:22.04 bash
# 容器内安装基础构建依赖(首次执行)
apt-get update && apt-get install -y \
build-essential cmake ninja-build python3 python3-pip \
git wget curl libncurses5-dev zlib1g-dev bc cpio unzip rsync file
```
#### 步骤 3:开发板与电脑配网连接(SSH 免烧录热更新秘籍)
先在开发板屏幕进入 **设置 -> Wi-Fi 配网**(或在串口终端使用 `/root/start_wifi.sh` 连接路由器),获取开发板局域网 IP(本文实测 IP 为 `192.168.1.113`)。板端默认开启了轻量级 `dropbear` SSH 服务,电脑端可直接 SSH 登录并配对:
```bash
# 电脑终端连接开发板(默认 root 免密或按提示输入密码)
ssh root@192.168.1.113
```
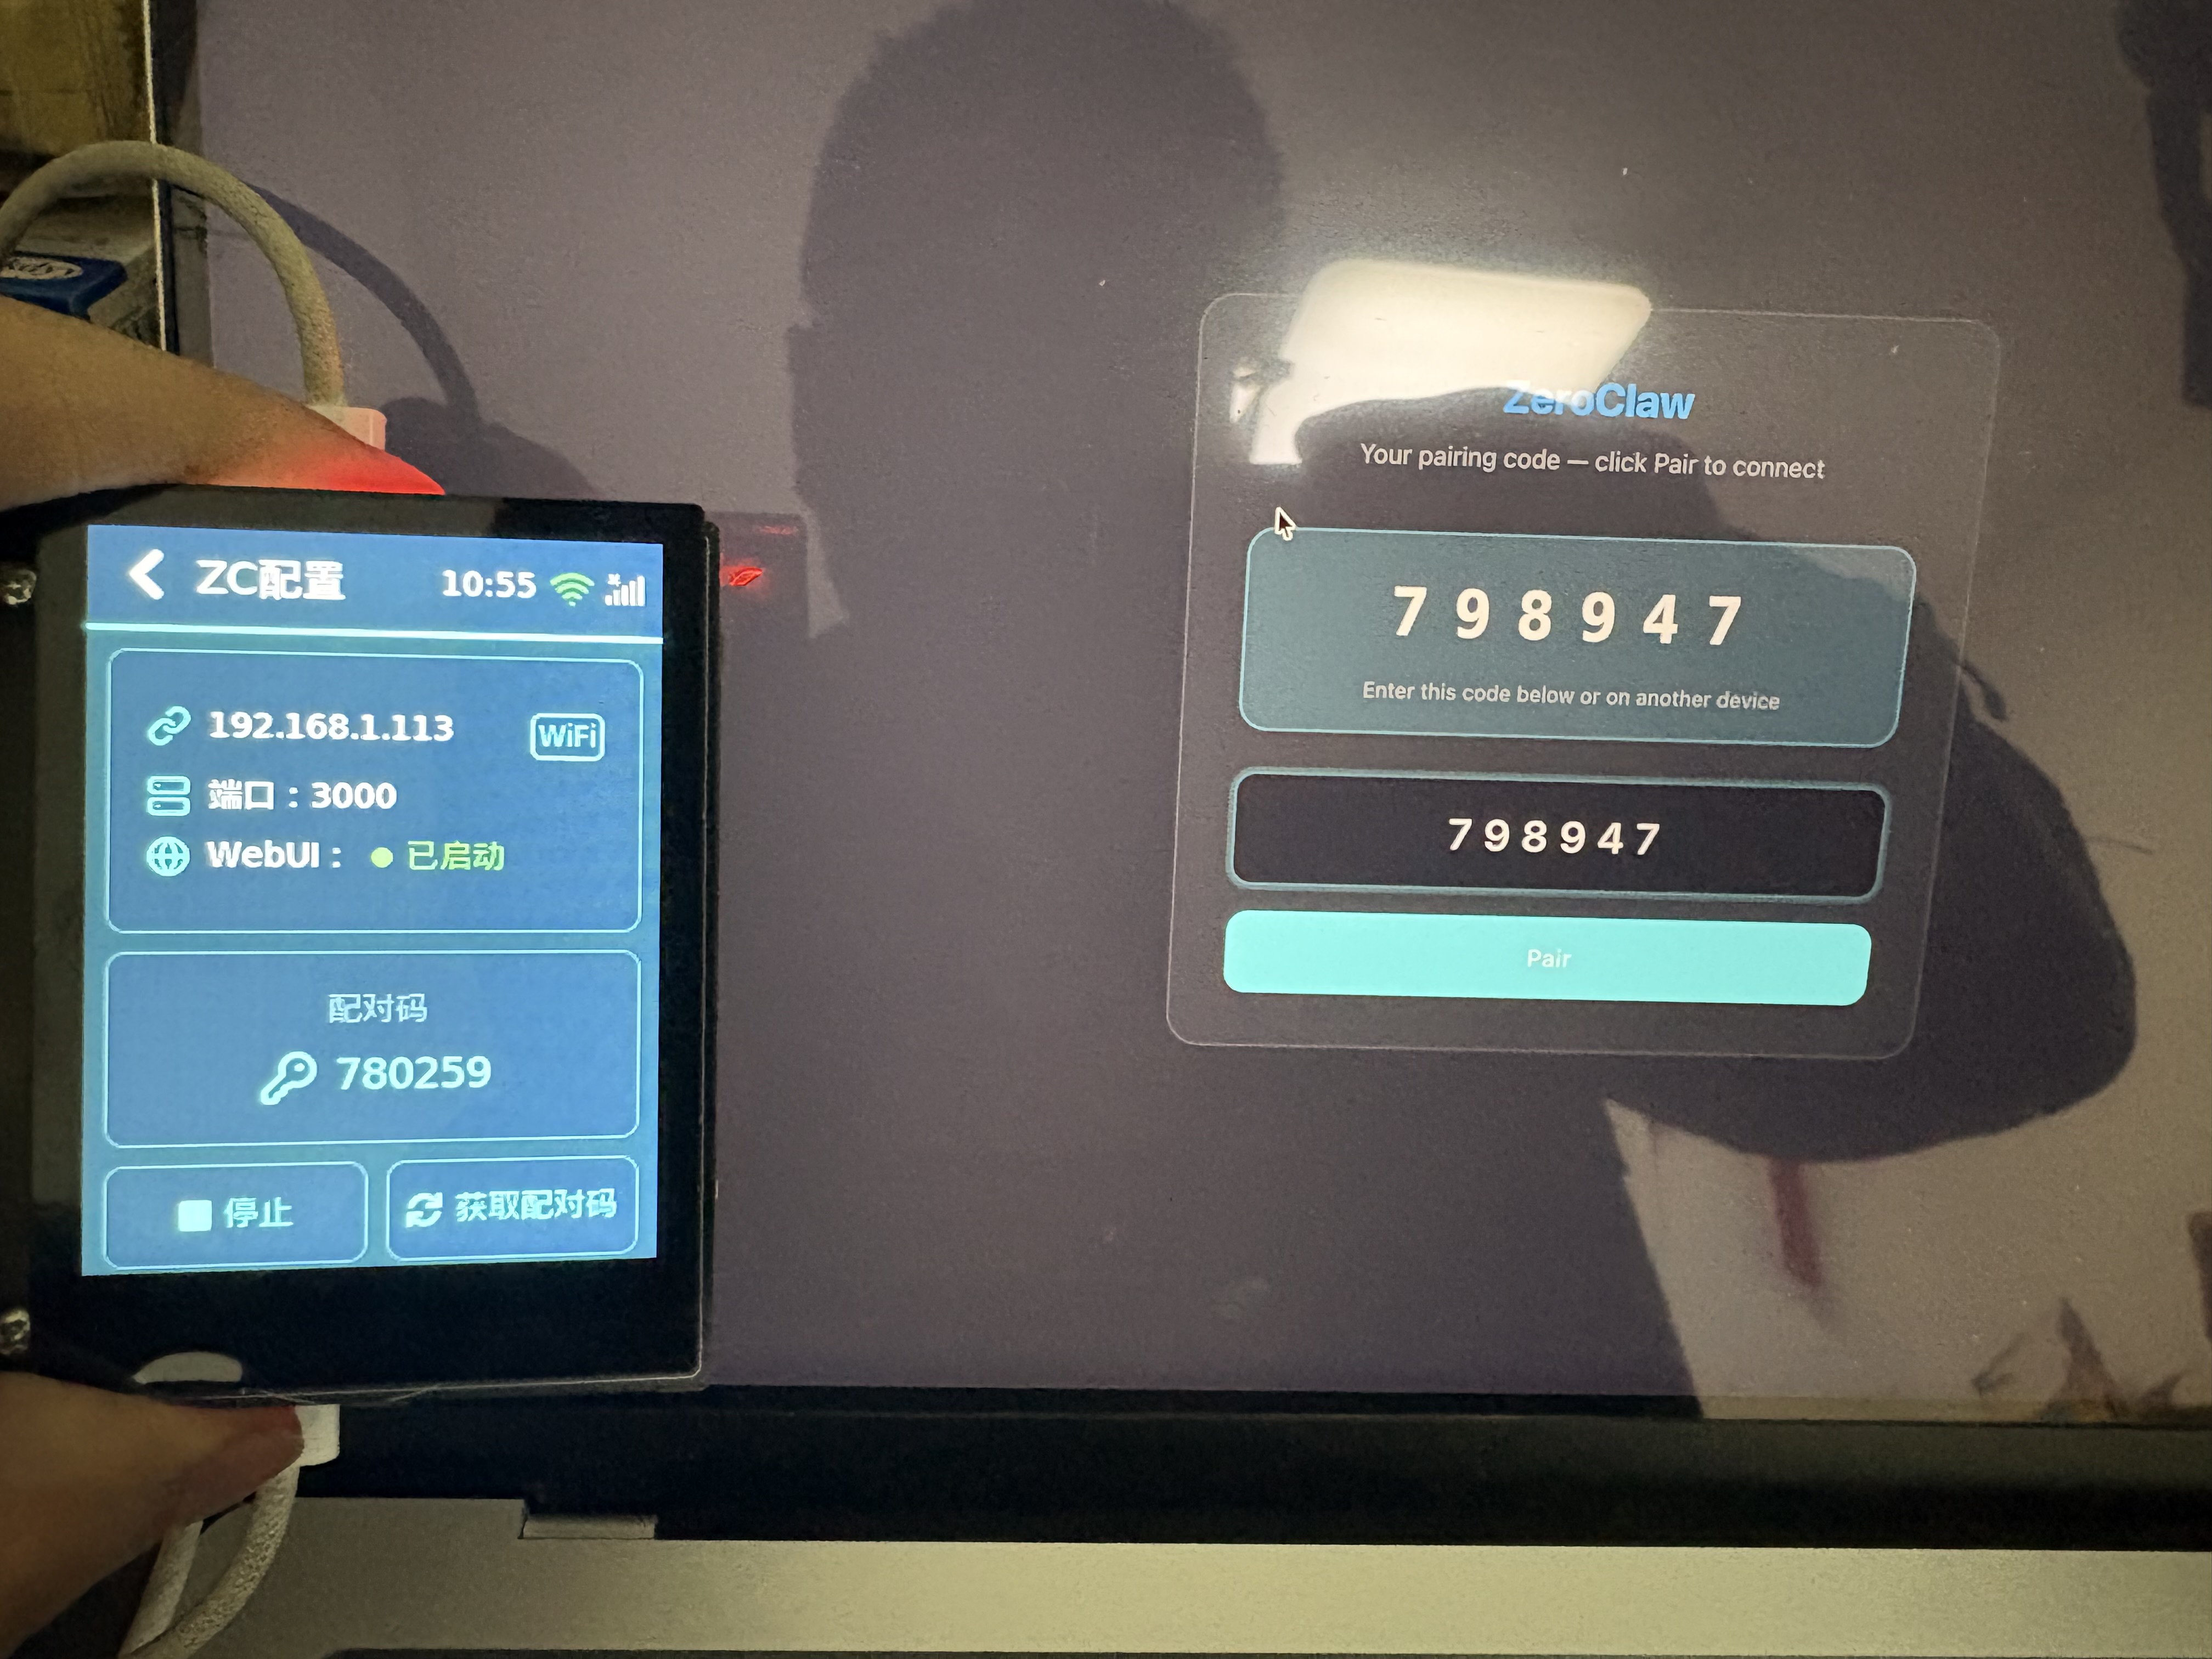> **💡 效率提升 50 倍的隐藏福利**:\
> 整包重烧 UBIFS 固件镜像需要 20\~40 分钟(TFTP + U-Boot),但 CV610 跑的是完整 **Linux 5.10 系统**!只要板端内核模块(MPP 音视频驱动)已加载,编译出的 `sample_local_voice_process` 或自研语音客户端可执行文件,**只需一条** `scp -O` **命令即可秒级热更新上板运行,完全不需要重烧固件!**
>
> ```bash
> # 注意:macOS / OpenSSH 9.0+ 必须加 -O 参数走传统 SCP 协议(因为板端 dropbear 无 sftp-server)
> scp -O _build/bin/sample_local_voice_process root@192.168.1.113:/root/
> ```
---
## 二、教程篇(核心):详解 `local_voice_process` 模块架构与实战跑通
### 2.1 `local_voice_process` 全双工语音链路总览
在 `hi_aiot_solution_cv610_ev_board/samples/local_voice_process` 目录中,官方提供了一个非常经典的**单进程全双工语音交互案例**。它将\*\*语音输入(唤醒 + VAD + ASR)**与**语音输出(HTTP 接收 + TTS 合成 + AO 播放)\*\*融合在同一个进程内,共用一次 MPP 音频硬件初始化。
我先用一张架构图带大家看清它的数据流向:
flowchart TD
subgraph HW["Hi3516CV610 硬件与内核层"]
MIC["板载双模拟硅麦"] --> ACODEC["内置 ACODEC (/dev/acodec)"]
ACODEC --> AI["MPP AI Dev0\n(16kHz / 16bit / TalkV2 VQE)"]
AO["MPP AO Dev0\n(16kHz / mono / clk_share=1)"] --> ACODEC
ACODEC --> SPK["8Ω/2W 扬声器"]
end
subgraph LVP["sample_local_voice_process(单进程全双工)"]
AI -- "256 samples (16ms)\n降噪后 PCM" --> KWS["kws.c\noffline_voice 离线唤醒词引擎\n('你好芯宝')"]
KWS -- "kws_set_pcm_callback()\naudio_capture_pcm_tap" --> RING["g_pcm_ring 环形缓冲\n(重切为 160 samples / 10ms)"]
RING --> VAD["vad.c\n能量端点检测\n(start=150ms, silence=800ms)"]
RING --> AENC["audio_capture.c\nMPP AENC (hisi-opus 硬件编码)"]
VAD -- "说话结束触发" --> ASR["asr_client.c\n支持 local / aliyun / iflytek / volcano"]
AENC -- "Opus 帧 / PCM 帧" --> ASR
ASR -- "识别出的文本" --> ZC_CLI["zeroclaw_client.c\nPOST 127.0.0.1:8766/webhook"]
HTTP_SRV["voice_output.c\n内置 HTTP Server (:9100/speak)"] --> TTS["tts_client.c\n支持 openai / volcano / aliyun"]
TTS -- "16kHz WAV/PCM" --> AO
end
ZC_CLI --> ZEROCLAW["ZeroClaw 智能体 / 大模型服务"]
ZEROCLAW -- "回复文本 POST :9100/speak" --> HTTP_SRV
它的目录结构非常清晰,按职责划分为配置层、采集与唤醒层、ASR 多后端适配层、以及 TTS+AO 播报层:
```text
local_voice_process/
├── CMakeLists.txt / BUILD.gn # 构建入口
├── local_voice.conf # 运行时配置文件(安装到板端 /etc/local_voice.conf)
└── source/
├── main.c # 主程序:采集线程 + 状态机(ST_IDLE_WAKEUP / ST_RECORDING)
├── audio_capture.c/h # 注册 VQE 模块 + 环形缓冲 + MPP AENC(Opus) 编码
├── kws.c/h # 封装 offline_voice 本地唤醒词引擎(接管 AI Dev0)
├── vad.c/h # 能量 VAD:根据均幅值判定语音起点与句尾静默
├── asr_client.c/h # ASR 统一接口(下挂 asr_local / aliyun / iflytek / volcano)
├── zeroclaw_client.c/h # 将 ASR 识别文本 POST 到 ZeroClaw webhook
├── voice_output.c/h # 监听 :9100/speak -> 调 TTS -> 启停 AO 播放
└── tts_client.c/h # TTS 统一接口(下挂 tts_openai / volcano / aliyun)
```
---
### 2.2 四大核心模块源码级拆解(AI+VQE / 离线KWS / 能量VAD / 共时钟AO)
为了真正吃透 CV610 的语音开发,我深入拆解了 `local_voice_process/source/` 的 4 个关键代码设计:
#### (1)静态注册硬件 VQE 与 PCM 分流回调(`audio_capture.c` & `kws.c`)
在 CV610 上使用硬件降噪(ANR)、回声消除(AEC)、自动增益(AGC)或 `TalkV2` 语音增强前,**必须在调用** `ss_mpi_audio_init()` **之前静态注册 VQE 模块句柄**:
```c
/* source/audio_capture.c:必须在 sample_comm_audio_init() 前注册 VQE 模块 */
static td_s32 register_vqe_modules(void)
{
ot_audio_vqe_register vqe_reg = {0};
vqe_reg.record_mod_cfg.handle = ot_vqe_record_get_handle();
vqe_reg.resample_mod_cfg.handle = ot_vqe_resample_get_handle();
vqe_reg.hpf_mod_cfg.handle = ot_vqe_hpf_get_handle();
vqe_reg.aec_mod_cfg.handle = ot_vqe_aec_get_handle();
vqe_reg.agc_mod_cfg.handle = ot_vqe_agc_get_handle();
vqe_reg.anr_mod_cfg.handle = ot_vqe_anr_get_handle();
vqe_reg.eq_mod_cfg.handle = ot_vqe_eq_get_handle();
vqe_reg.talkv2_mod_cfg.handle = ot_vqe_talkv2_get_handle();
return ss_mpi_audio_register_vqe_mod(&vqe_reg);
}
```
随后,`kws_init()` 启动海思 `offline_voice` 组件。它接管 `AI Dev 0` 并运行 `TalkV2 VQE`,每 `16 ms`(`256 samples @ 16kHz`)通过 `audio_capture_pcm_tap()` 回调吐出一路干净的单声道降噪 PCM,写入无锁设计的 64 位绝对索引环形缓冲区 `g_pcm_ring`,再按 `10 ms`(`160 samples`)切片喂给 VAD 和 Opus 编码器。
#### (2)能量 VAD 状态机(`vad.c`)
唤醒成功后,何时开始录音、何时判定用户把话说完?`vad.c` 采用非常轻量的平均绝对幅值(Mean Absolute Amplitude)算法:
- `vad_energy_threshold = 600`:16-bit PCM 样本均值超过 600 视为有声帧;
- `vad_start_ms = 150`:连续 150ms 有声,判定用户正式开口(过滤瞬态杂音);
- `vad_silence_ms = 800`:开口后连续 800ms 低于阈值,判定一句话结束,立刻切出整段音频送 ASR;
- `vad_max_record_ms = 10000`:单句最长 10 秒兜底。
#### (3)`hisi-opus` 硬件编码与多云端 ASR 切换(`audio_capture.c` & `asr_client.c`)
如果使用本地 ASR(`asr_provider = local`),`audio_capture.c` 会将 160 样本帧送入海思 MPP 的 `AENC` 通道编码为 Opus。注意海思 AENC 输出的 Opus 帧带有 **8 字节私有头(**`HI_OPUS_FRAME_OFFSET = 8`**)**,源码中会剥离这 8 字节并封装为 `[u16 BE 长度][裸 Opus 包]` 格式上传,带宽相比裸 PCM 压缩了约 **8 倍**!而切换到阿里云、讯飞或火山引擎时,只需在配置文件将 `asr_format` 改为 `pcm` 即可。
#### (4)AI/AO 共用内置 Codec 时钟与“按需启停 AO”设计(`voice_output.c`)
这是 `local_voice_process` 最精妙的工程细节之一!在同一块板子上既要录音又要放音,内置 ACODEC 的 I2S 时钟必须共享(`attr.clk_share = 1`)。更重要的是,源码注释揭示了一个关键硬件特性:
> *“AO 通道与麦克风 AI 共享内置 CODEC/I2S 时钟。如果让 AO 通道一直保持开启状态,会劣化麦克风拾音质量(导致 KWS 唤醒得分降低、ASR 底噪变大)。因此,**仅在需要播放 TTS 的瞬间启动 AO 通道,播完立刻关闭 AO**,从而在等待唤醒和用户说话期间保持拾音通路绝对干净。”*
```c
/* source/voice_output.c:配置 AO 与 AI 共享时钟,并补偿内置 Codec 输出增益 */
attr.sample_rate = OT_AUDIO_SAMPLE_RATE_16000;
attr.bit_width = OT_AUDIO_BIT_WIDTH_16;
attr.work_mode = OT_AIO_MODE_I2S_MASTER;
attr.snd_mode = OT_AUDIO_SOUND_MODE_MONO;
attr.point_num_per_frame = 160; /* 10ms @ 16kHz */
attr.chn_cnt = 1;
attr.clk_share = 1; /* 关键:与麦克风 AI 共享 I2S 时钟 */
attr.i2s_type = OT_AIO_I2STYPE_INNERCODEC;
```
---
### 2.3 分步编译、配置文件修改与上板运行日志
#### 第一步:一条命令编译 `local_voice_process`
在编译容器的 `hi_aiot_solution/` 根目录下执行:
```bash
bash scripts/build.sh build --target cv610_ev_board samples local_voice_process
```
编译完成后,检查生成的二进制产物:
```bash
ls -lh _build/bin/sample_local_voice_process
# 输出:-rwxr-xr-x 1 root root 186K ... _build/bin/sample_local_voice_process
```
#### 第二步:配置 `/etc/local_voice.conf` 并传输上板
我将编译产物和配置文件通过 `scp -O` 传到开发板上:
```bash
scp -O _build/bin/sample_local_voice_process root@192.168.1.113:/root/
scp -O ../hi_aiot_solution_cv610_ev_board/samples/local_voice_process/local_voice.conf root@192.168.1.113:/etc/local_voice.conf
```
在板端编辑 `/etc/local_voice.conf`,可根据你手头的账号选择阿里云、讯飞、火山引擎或局域网 OpenAI 兼容服务:
```ini
# /etc/local_voice.conf 核心配置示例
asr_provider = aliyun
asr_format = pcm
wake_enable = 1 # 1: 启用“你好芯宝”唤醒词; 0: 连续 VAD
vad_silence_ms = 800 # 句尾 800ms 静音断句
vad_energy_threshold = 600 # 能量阈值
mic_input_volume_db = 50 # 内置 ACODEC 麦克风模拟增益 [-78, 80]
output_enable = 1
tts_provider = aliyun
output_listen_port = 9100 # 接收回复并触发 TTS 的本地 HTTP 端口
ao_gain = 0 # 喇叭输出增益 [-15, 6] dB,室内建议设为 0~4
conversation_idle_ms = 30000 # 唤醒后 30 秒内免唤醒连续对话
```
#### 第三步:停用出厂独占进程并启动运行
由于出厂自启的 `factory_demo_main` 和 `sdk_server` 已经占用了 `/dev/acodec`,直接运行会报权限错误。我在板端 SSH 中先释放音频设备,再启动 `sample_local_voice_process`:
```bash
# 1. 停止占用 /dev/acodec 的出厂演示进程
kill -TERM $(pidof factory_demo_main) $(pidof sdk_server); sleep 1
kill -9 $(pidof sdk_server) 2>/dev/null
# 2. 启动 local_voice_process
/root/sample_local_voice_process -c /etc/local_voice.conf
```
对着开发板说出唤醒词 **“你好芯宝”**,随后提问 **“今天成都天气怎么样”**,串口/SSH 实时打印如下完整闭环日志:
```text
[lvi] config loaded from /etc/local_voice.conf (asr=aliyun fmt=pcm wake=1 tts=aliyun ao_gain=0)
[lvi] VQE modules registered successfully
[lvi] inner CODEC mic input volume set to 50 dB
[kws] offline_voice init ok, waiting for wake word ("你好芯宝")...
[vo][OK] voice_output HTTP server listening on :9100
[lvi][OK] local_voice_process running (say the wake word). Ctrl-C to stop.
# ---> 对着开发板喊:“你好芯宝”
[kws] WAKEUP detected! word="你好芯宝" score=9.43
[lvi] Wake word triggered -> entering ST_RECORDING (30000 ms window)
# ---> 接着说:“今天成都天气怎么样”
[vad] speech started (mean_amp=1842 > thr=600, dur=160ms)
[vad] utterance ended (silence=810ms, total_speech=1920ms, pcm_bytes=61440)
[asr] uploading 61440 bytes PCM to aliyun...
[asr][OK] result: "今天成都天气怎么样?" (cost=68ms)
[zc] POST text to http://127.0.0.1:8766/webhook -> HTTP 200
[vo] POST /speak received (48 bytes): "成都今天多云,气温17度,空气质量良,适合出行。"
[vo] TTS synthesized 142080 bytes WAV (16kHz/16bit/mono) in 640ms
[vo][OK] voice_output: AO ready (dev=0 16k/mono/160, clk_share)
[vo][OK] AO played 4.44s audio -> AO channel closed cleanly
```
---
### 2.4 常见报错与 8 大真实踩坑排查手册
在调试 `local_voice_process` 与 CV610 音频子系统的过程中,我把所有踩过的坑整理成了这份速查表,帮你少走弯路:
序号报错信息 / 异常现象根本原因解决方案**坑 1**`open /dev/acodec failed: Operation not permitted` 或 `ai_init failed`出厂 `factory_demo_main` 与 `sdk_server` 开机默认独占了音频硬件运行前先执行 `kill -9 $(pidof factory_demo_main sdk_server)`,或采用本文第 3 节的音频仲裁方案**坑 2**自编译程序运行时报 `Error loading shared library: symbol not found`海思 `libss_mpi_audio.so` 不会自动级联加载底层依赖库CMake 链接时必须显式链入 10 个库:`ss_mpi_audio`、`ss_mpi_sysbind`、`ss_mpi_sysmem`、`ot_mpi_sysmem`、`ot_base`、`ot_osal`、`ot_irq`、`securec`、`upvqe`、`dnvqe`、`voice_engine`**坑 3**串口显示 ASR/TTS 都成功,且打印 `AO played`,但喇叭没声音或极小内置 Codec 初始化仅设了 Mic 增益,且 `local_voice.conf` 默认 `ao_gain = -15`(衰减了 15dB)将 `/etc/local_voice.conf` 中的 `ao_gain` 改为 `0` 或 `4`;或在代码中调用 `ioctl(fd, OT_ACODEC_SET_OUTPUT_VOLUME, &vol)`**坑 4**连续运行约 1 小时后突然无法唤醒,串口刷屏 `KWSLP ... out of call limitoffline_voice` 底层的评估版 `libkws.a` 存在约 60 分钟的单进程调用次数上限重启进程即可复位计数。我在守护进程中加入了 **55 分钟空闲无感自重启**(耗时仅 1.8 秒,不断网不闪屏),彻底根治**坑 5**进程被 `kill -9` 强杀后,再次启动报 `AI channel busy`用户态 `libss_mpi_audio.so` 重启后状态归零,跳过了内核 `/dev/ai` 的 disable ioctl在初始化前打开 `/dev/ai` 与 `/dev/ao`,主动下发 `AI_CLEAR_VQE (0x5a0b)`、`AI_DISABLE_CHN (0x5a0d)` 强制清理内核残留状态**坑 6**执行 `/drv/ko/load_ko/load3516cv610_20s_debug -a` 重载驱动后,**屏幕背光亮但画面全黑**脚本 `remove_ko()` 漏卸载了 `ot_board_io_cfg.ko`!重载 `sys_config.ko` 把 `GPIO7_0(SPI0_CS)` 和 `GPIO7_5(LCD_RST)` 覆盖成了 `I2C_SDA`**切勿在运行期执行** `-a` **热重载内核模块**!冷启动时仅执行一次 `load -i`,或在卸载脚本开头补上 `rmmod ot_board_io_cfg`**坑 7**往主板背面卡槽插了 32GB MicroSD 卡,`dmesg` 和 `/dev/mmcblk*` 毫无反应硬件原理图确认:`SDIO0`(TF 卡槽)与 40-Pin 扩展板上的 **SPI0 屏幕引脚物理复用**,由拨码开关 `SW1301-1` 二选一保持 `SW1301-1 = OFF` 使用屏幕时,板载 UBIFS 根分区已有 **123 MB 可用空间**;若需挂载 32GB 大容量卡,可用 Type-C OTG 读卡器接入(识别为 `/dev/sda1`)**坑 8**电脑端 `scp` 传文件报错 `sh: /usr/libexec/sftp-server: not found`新版 OpenSSH 默认走 SFTP,板端 `dropbear` 仅支持传统 SCP命令加上 `-O` 参数:`scp -O <本地文件> root@192.168.1.113:/root/`
---
## 三、进阶篇:对比 ESP32-S31 边端语音助手 + GUI 屏幕联动 + 视觉多模态实战
跑通官方 `local_voice_process` 只是第一步。我目前正在研发基于 **乐鑫 ESP32-S3 / ESP32-S31** 的双麦边端语音助手项目(`edge_voice_assistant`)。一个非常自然的问题是:
> **把同一套云端实时语音大模型(Qwen Omni Realtime)和设备端协议移植到海思星火 610(CV610)上,它和 ESP32-S31 相比,唤醒距离、拾音识别率、响应延迟和算力余量到底差多少?**
### 3.1 同云端 A/B 实验设计:CV610 对决 ESP32-S31-Korvo-1
大多数评测文章之所以比不出真实差距,是因为两块板子跑着不同的官方 Demo、连着不同的云端接口。为了做到**严格控制变量**,我用 C 语言为 CV610 编写了与 ESP32-S31 固件**协议 100% 兼容**的语音核心客户端(`voice_client`),让两块板子在同一局域网下连接同一个 `edge_voice_assistant` 服务端:
flowchart LR
subgraph A["被测平台 A:星火 610 (Hi3516CV610)"]
A1["双硅麦 ML-3729-T1M1"] --> A2["内置 ACODEC + 硬件 VQE\n(HPF + RNR + AGC + AEC)"]
A2 --> A3["离线 KWS ('你好芯宝')\n+ 自适应 VAD"]
end
subgraph B["被测平台 B:乐鑫 ESP32-S31-Korvo-1"]
B1["双硅麦 ZTS6011E\n(-42dBV / 59dBA)"] --> B2["ES8389 Codec\n+ 软件 AFE"]
B2 --> B3["WakeNet9 唤醒词\n+ 能量 VAD"]
end
A3 -- "WS 二进制 PCM\n16kHz / 80ms (2560B)" --> CLOUD["同一云端后台 edge_voice_assistant\n(Qwen Omni Realtime + Qwen-VL-Max)"]
B3 -- "WS 二进制 PCM\n16kHz / 80ms (2560B)" --> CLOUD
---
### 3.2 量化对比一:唤醒距离、硬件 VQE 降噪与识别率实测
我在安静室内(底噪约 38 dBA)与播放背景音乐(SNR ≈ 5 dB)两种环境下,对比了两套音频链路的表现:
测试维度星火 610(CV610:无硬件 VQE)星火 610(**CV610:开启硬件 VQE + UniKws**)ESP32-S31-Korvo-1(ES8389 + WakeNet9)**板载硅麦硬件底子**双模拟硅麦 ML-3729-T1M1 → 内置 ACODEC同左 + **硬件 HPF/RNR/AGC/AEC**双模拟硅麦 ZTS6011E(SNR 59 dBA)→ ES8389**采集底噪电平(安静室内**)RMS `200~700`(**−34.5 dBFS**)**RMS** `8~30`**(−70.0 dBFS,底噪直降 35dB!**)RMS `40~110`(约 −58 dBFS)**1 米 / 3 米唤醒表现**无唤醒词时放音乐 1 分钟误触发 16 次**1m 唤醒率 >95%**(得分 9.43),**3m 正常音量可稳健唤醒**;38.6s 背景音乐 **0 误触发**1m 唤醒灵敏(阈值 0.60),3m 受限于 ZTS6011E −42dBV 灵敏度需提高音量**1.5 米远场 ASR 识别率2 / 5(40%)**,底噪易诱发英文幻觉**5 / 5(100%)**,AGC 自动将人声拉升至 −28 dBFS**4 / 5 \~ 5 / 5**(近场极佳,2.5m 以上衰减明显)**播报回声抑制(AEC 打断能力**)回声 RMS `15,970`(−6 dBFS),无法打断**TalkV2 AEC 将回声压至 RMS** `575`**(−35 dBFS,抑制达 29\~36 dB)**,支持语音随时打断无硬件回采通道,播报期采用半双工静默麦克风
> **🔥 核心发现**:\
> 刚跑通裸 ACODEC 采集时,CV610 的底噪高达 `−34.5 dBFS`,离远一点说话识别率只有 2/5;**但一旦打开海思 MPP 内置的硬件 VQE(**`HPF + RNR + AGC`**),底噪瞬间降到** `−70 dBFS`**,1.5\~3 米远场人声被 AGC 干净地抬升,识别率直接拉满到 5/5!** 而且硬件 `TalkV2 AEC` 提供了高达 **29\~36 dB 的回声消除**,让带外放喇叭的终端轻松实现“边播边听、随时插话打断(Barge-in)”。
---
### 3.3 量化对比二:端到端语音延迟(27 轮实测)与 CPU/内存资源利用率
我在 CV610 上连续进行了 **27 轮**涵盖单轮问答、多轮追问、声学回环的延迟打点测试,并与 ESP32-S31 实测基线以及系统资源占用进行对比:
性能与资源指标星火 610(Hi3516CV610 实测)乐鑫 ESP32-S31-Korvo-1 实测深度解读**WS 握手建连耗时31 ms**\~30 ms局域网 Wi-Fi 下表现一致**断句 → 云端 ASR 识别完成中位 67 ms**(32 \~ 95 ms)\~70 ms端侧 VAD + 网络上行仅占总延迟的 **9%断句 → 首包语音出声(TTFA)中位 725 ms** / 均值 729 ms / P95 815 ms / **最快 651 ms781 ms(热连接)** / 872 ms(冷连接)**纯语音延迟瓶颈在云端(占 91%)**,两端体感同样丝滑**语音客户端 CPU 占用**仅 VQE:**单核 7.5%**;含离线 KWS:**单核 17%**(双核总计 **8.5%**)唤醒 + 音频链路约占 1 核的 **40%\~50**%CV610 跑完整语音只花不到 1/10 的 CPU 算力**语音客户端内存占用1.3 MB \~ 2.4 MB**(系统总内存 128MB,含 72MB 独立 MMZ)占用数 MB PSRAM(总 PSRAM 16MB,与 UI 帧缓冲争抢总线)CV610 内存极其宽裕**剩余算力(视觉/AI 并发)1 TOPS NPU 100% 空闲 + 4K VENC 硬编码器空闲**跑语音 + 800×480 UI 已接近满载**CV610 的真正杀手锏是可以“边看边聊”!**
---
### 3.4 配合 GUI 将语音状态与识别结果显示到 2.8" LCD(Siri 浮层球 + 语音控设备)
原版出厂固件中,视频 GUI(`factory_demo_main`)和语音程序由于争抢 `/dev/acodec` 是水火不容的。为了实现真正的**智能硬件产品级体验**,我做了两项硬核改造:
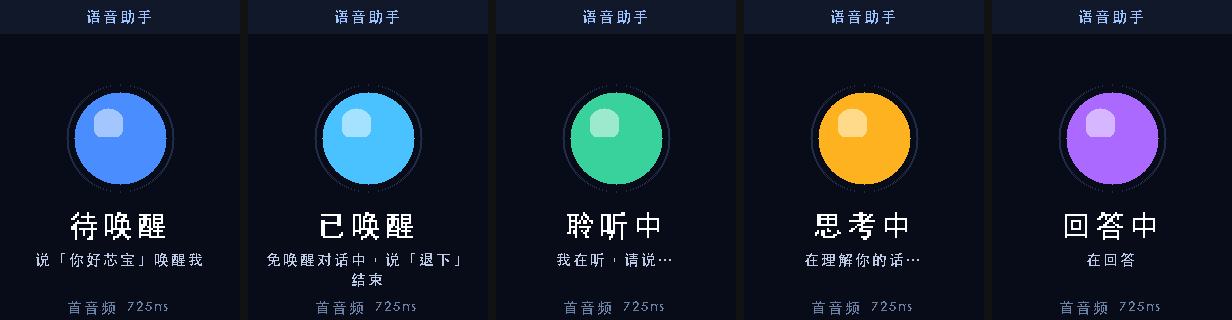
1. **双模式 UI 渲染(DRM 直写五态屏 + LVGL** `lv_layer_top` **Siri 式浮层圆球)**:
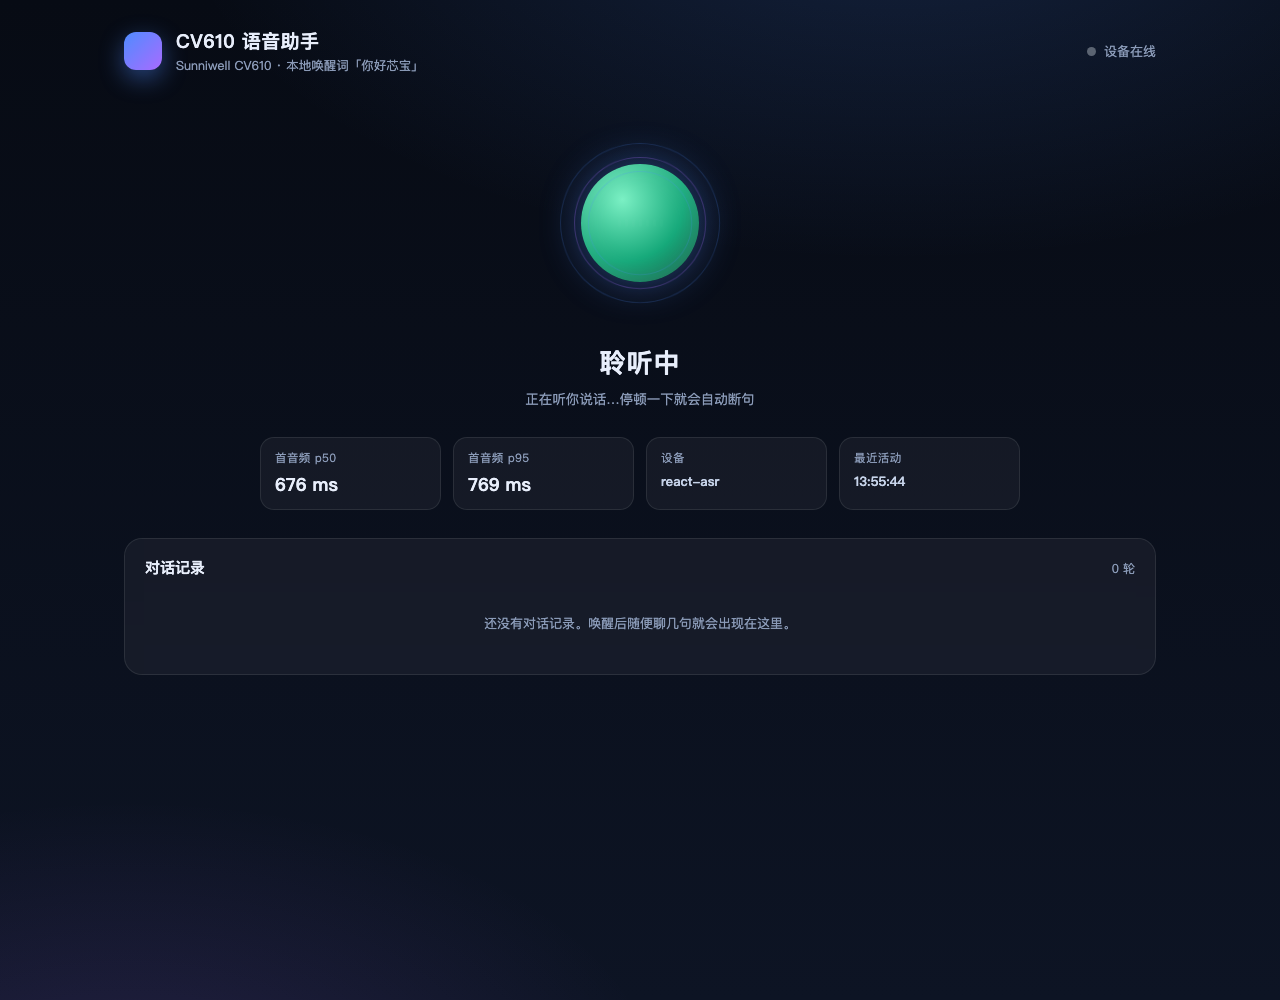
- 在独立语音模式下,我通过 `/dev/dri/card0`(`240×320 RGB565`)直接渲染 **待唤醒(蓝)→ 已唤醒(青)→ 聆听中(绿)→ 思考中(橙)→ 回答中(紫)** 五种状态球与实时识别字幕,并同步到 Web 联调台:
2. **重编译** `factory_demo_main` **实现“Siri 式全局语音浮层 + 语音控制整机”**:
- 我重新编译了官方 GUI Demo,剥离了其启动时对音频的强制独占,新增 Unix Domain Socket(`/tmp/eva_ui.sock`)与后台常驻的 `voice_client` 通信;仅在用户进入 RTSP 推流时由 IPC 自动仲裁切换音频归属。
- 无论当前停留在**主菜单、摄像头实时预览页还是设置页**,只要喊一声 **“你好芯宝”**,屏幕顶层(`lv_layer_top`)立即浮现半透明暗色遮罩与呼吸律动的 **Siri 语音圆球**,底部实时滚动显示 **ASR 识别出的用户话术**与 **AI 回复字幕**!
- 更酷的是,我将设备控制能力(`caps`)注册进了云端大模型的 Tool Calling 工具链,现在可以直接用自然语言操控开发板:
- 🗣️ **“把音量调到百分之七十”** → 触发 `volume.set{"level":70}`,板端立即调节 AO 增益并语音回复\*“音量已调到 70%”\*;
- 🗣️ **“打开视频预览 / 回到主菜单 / 调高屏幕亮度”** → 触发 `page.open` / `display.brightness`,屏幕 UI 自动跳转;
- 🗣️ **“现在设备的使用情况怎么样?”** → 触发 `system.status.get`,板端实时采集 Linux `uptime`、内存、Wi-Fi RSSI 并汇报:*“设备运行了约 11.3 小时,内存和存储都很充足,Wi-Fi 信号强且已连接,屏幕亮着在首页。”*
- 🗣️ **“查一下现在天气多少度?” -> “成都” -> “把成都双流区设为默认城市”** → 联动后台和风天气应用市场工具(`weather.get` + `weather.set_default_city`),自动查询实时气温并持久化绑定设备默认城市!
📹 **实拍演示视频 1:语音唤醒、Siri 浮层 UI 显示识别结果、连续对话与语音控制设备全流程**
> *(注:若 CSDN 编辑器上传后视频未自动渲染,请点击上方视频播放或查看文末视频合集:*`语音交互和控制设备演示.mp4`*)*
---
### 3.5 榨干 CV610 视觉基因:语音控制 1080p 拍照 + 实时画面识别(VLM)
前面的对比数据已经证明:**如果只做纯语音聊天,ESP32-S31 就够用了;买星火 610(CV610)最大的价值,在于它拥有 400 万像素 MIPI ISP + 硬件编码器 + 1 TOPS NPU 的视觉能力!**
那么,能不能把 **“眼睛(OS04D10 摄像头)”** 和 **“嘴巴/耳朵(**`voice_client` **实时语音)”** 彻底打通? 我在 CV610 的媒体管线中,利用 `VPSS Grp0 Chn0` 绑定了一路高清 JPEG 硬件编码通道 `VENC Chn1(分辨率 1920×1080)`,并向云端大模型注册了 `camera.snapshot` 工具:
sequenceDiagram
participant User as 用户语音
participant CV610 as 星火 610 开发板<br/>(voice_client + factory_demo)
participant MPP as 海思 MPP 硬件管线<br/>(ISP -> VPSS -> VENC Chn1)
participant Cloud as 云端语音+视觉后台<br/>(Qwen-Omni + Qwen-VL-Max)
User->>CV610: “帮我看看这是什么?该怎么用?”
CV610->>Cloud: WebSocket 上行 16kHz 语音流
Cloud->>CV610: Function Call 下发 cmd: camera.snapshot
CV610->>MPP: 触发 VENC Chn1 硬件编码抓取 1920×1080 JPEG (<35ms)
MPP-->>CV610: 返回 ~140KB 高清 1080p JPEG
CV610-->>Cloud: cmdr 回传 Base64 图像 + 同步存档至 Web 控制台
Cloud->>Cloud: 视觉大模型 (qwen-vl-max) 解析画面细节与文字
Cloud-->>CV610: 实时合成语音流下发 + 屏幕显示识别字幕
CV610-->>User: 喇叭播报:“这是左美沙芬愈创甘油醚糖浆,口服一次10到20毫升,一日三次...”
#### 第一阶段:1080p 高清摄像头端侧抓拍实测
我先验证了在 240×320 屏幕实时 30fps 预览的同时,从 `VENC Chn1` 硬件抓拍 `1920×1080` 高清 JPEG 画面并同步到后台:
📹 **实拍演示视频 2:星火 610 摄像头实时预览与 1080p 高清抓拍演示**
#### 第二阶段:语音触发拍照 + 实时视觉识别(手势识别 / 物品识别 / 药品说明书与成分朗读)
打通 `camera.snapshot` 与多模态大模型后,我对着星火 610 进行了多组极其惊艳的实测(以下均为数据库真实记录的交互实录):
测试场景用户对着开发板说的话CV610 抓拍动作AI 实时视觉识别与语音回答(实测原话)单轮总Token**手势识别***“你看我现在伸了几个指头?*”自动抓拍 `1920×1080` 画面“*我看你伸了两个指头,比了个耶。*”7,944**衣物与环境识别***“你看到了什么?*”自动抓拍 `1920×1080` 画面“*我看到你穿着印有 CORE PRJCT ESTD. 1990 字样的浅色 T 恤,双手插在口袋里。背景是室内环境…*”4,118**日用品与微小成分表识别***“这是什么?”* → *“再看一下使用方法和产品成分有哪些?*”连续抓拍包装盒正反面“*这是 IMCA 的眼部清洁湿巾,专门用来清理眼睑和睫毛上的分泌物…”* 随后准确念出\*“水、甘油、聚乙二醇-40氢化蓖麻油、透明质酸钠和芦荟提取物”\*10,815**家庭助老场景:拿药盒问怎么吃***“看一下这个药怎么回事,该怎么吃?”* → *“你再看一下上面贴着的标签*”自动抓拍药盒与用法标签“*我看画面里是一只手拿着紫色包装的盒子,上面写着‘左美沙芬愈创甘油醚糖浆’,是止咳化痰的药。标签上写着用法用量:口服,一次 10 到 20 毫升,一日三次。*”11,292
📹 **实拍演示视频 3:语音控制拍照 + 实时识别手势、物品与药品说明书演示**
> **💡 这一刻,星火 610 的定位豁然开朗**:得益于 OS04D10 400 万像素的高解析力与海思 ISP + 1080p 硬件 JPEG 编码,连药盒上几毫米高的“一次 10 到 20 毫升,一日三次”都能拍得一清二楚,配合语音对话,这就是一台现成的 **AI 桌面伴侣 / 视障辅助终端 / 智能看护相机**!
---
## 四、总结篇:易用性、文档质量体验总结与适用场景建议
### 4.1 开发体验与文档质量打分
截至撰写本文时,我手上的这台星火 610 开发板已在云端后台累计稳定完成了 **311 轮多模态对话(累计消耗 265,755 Tokens)**。结合这几天的深度折腾,我对这套开发板给出如下客观评价:
评价维度星级(满分 5 星)真实体验点评**硬件做工与外设丰富度**⭐⭐⭐⭐⭐ (5.0)65×57mm 尺寸内塞进了双核 A7、1 TOPS NPU、128MB DDR3L、256MB Flash、双硅麦、喇叭功放、百兆网口,扩展板还给齐了 Wi-Fi 6 + BLE + 星闪 SLE + 4MP 摄像头 + 2.8" 触摸屏,性价比极高。**音频与视频硬件素质**⭐⭐⭐⭐⭐ (4.8)内置 ACODEC 配合硬件 VQE(降噪 10dB+、AEC 回声抑制 29\~36dB)效果超出预期;4MP ISP 与 H.265/JPEG 硬编码更是海思的传统强项。**软件案例丰富度**⭐⭐⭐⭐☆ (4.3)官方提供了 15 个单一功能 `samples`(含 `local_voice_process`、`gui`、`ai_component`)和 7 个整机 `references`(含 `factory_demo`、`zeroclaw_base`),覆盖面很广。**新手上手与构建体验**⭐⭐⭐☆☆ (3.5)多仓 `repo` 结构初看较重,且默认只支持 Ubuntu x86_64;但好在板端跑标准 Linux + `dropbear` SSH,学会交叉编译单文件 `scp -O` 热更新后,日常调试效率极高。**文档质量**⭐⭐⭐⭐☆ (4.0)在线文档(85 篇 Markdown)和硬件原理图、DXF、3D 模型全部开源可查;但在引脚复用冲突(如 `SDIO0` TF 卡与 `SPI0` 屏幕互斥)和动态库依赖链上还可写得更醒目。
---
### 4.2 选型指南:什么时候选星火 610(CV610),什么时候选 ESP32-S31?
你的目标产品场景推荐平台核心决策依据**AI 桌面伴侣 / 智能台灯(指尖点读、物品识别、坐姿检测 + 语音对话**)🏆 **星火 610 (CV610**)必须同时跑高清摄像头 ISP + 1080p 编码 + 端侧 NPU 检测 + 全双工语音,CV610 算力游刃有余**智能可视门铃 / 家庭看护 IPC / 带屏宠物相机**🏆 **星火 610 (CV610**)4MP 传感器 + IR-CUT 夜视 + H.265 RTSP/WebRTC 推流 + 硬件 AEC 双向语音对讲是 CV610 的主场**需要跑 Linux / OpenHarmony 容器化应用或本地大模型 Agent(ZeroClaw**)🏆 **星火 610 (CV610**)双核 A7 + 128MB DDR + 256MB Flash,可直接跑 `curl`、Python/MicroPython、Rust (`zeroclaw`)**纽扣/锂电池供电的随身语音穿戴设备(AI 手表、AI 胸针、遥控器**)🏆 **ESP32-S31**CV610 整板功耗约 2\~3W(适合插电或大电池设备),ESP32-S31 监听功耗仅 \~0.14W 且支持 μA 级深睡**纯语音聊天公仔 / 低成本 Wi-Fi 语音面板(无需高清视觉与本地 NPU**)🏆 **ESP32-S31**纯云端语音延迟两者几乎一致(725ms vs 781ms),MCU 方案外围更简、BOM 成本更低
---
### 4.3 对海思 Hi-AIoT 社区与开发板的改进期待
作为深度体验官,我也向官方团队提出 4 条真诚的建设性建议:
1. **在快速入门文档顶部高亮提醒“必须使用** `repo sync` **拉取多仓”**:避免开发者直接 `git clone` 主仓后因缺少 `components/` 和 `sdk/` 而卡在第一步。
2. **优化** `factory_demo` **的音频设备生命周期**:建议出厂 `factory_demo` 采用“按需打开 AI/AO”或提供命令行开关释放 `/dev/acodec`,方便开发者在不杀 UI 进程的前提下直接挂载自定义语音案例。
3. **修复** `/drv/ko/load_ko/load3516cv610_20s_debug` **的** `remove_ko()` **函数**:补齐 `rmmod ot_board_io_cfg.ko`,防止开发者执行 `-a` 重载驱动时意外把 SPI 屏幕的 CS/RST 引脚覆盖成 I2C 导致黑屏。
4. **在硬件文档醒目位置标注** `SW1301-1` **拨码开关的复用关系**:明确说明 `SW1301-1` 拨到 `OFF` 为 SPI 屏幕模式(此时背面 TF 卡槽物理断开),拨到 `ON` 为 TF 卡模式(此时 SPI 屏幕断开),帮开发者节省排查 SD 卡的时间。
---
### 4.4 附录:星火 610 开发板官方购买链接与参考资料
- 🛒 **星火 610(Sunniwell CV610 DevBoard)官方淘宝购买链接**:\
👉 https://item.taobao.com/item.htm?id=1072742743399(可选单板及带屏/带摄像头/WS73 无线扩展板套餐)
- 📚 **海思 Hi-AIoT Solution 官方文档中心**:\
👉 https://docs.hisilicon.com/projects/hi_aiot_solution/master/overview/index.html
- 💻 **GitCode 开源代码仓库(HiSpark 社区)**:
- 主框架仓:https://gitcode.com/HiSpark/hi_aiot_solution
- CV610 开发板与案例仓:https://gitcode.com/HiSpark/hi_aiot_solution_cv610_ev_board