AI降本的第一笔账,为什么先算到中间层头上
文章从裁员顺序的反常现象切入,指出中间层因任务可拆解、可标准化而最先承压;企业真正做的是重组任务而非按人头替换,而AI用量成本上升后,额度管控又落回同一批人身上。读者可据此判断:冲击的本质是任务定价权转移,而非岗位净消失,关键变量是自己工作中有多少可被拆成步骤。
AI降本的第一笔账,为什么先算到中间层头上
被AI先盯上的,不是一线工人
一个反直觉的裁员顺序
关于AI替代岗位,最流行的想象是流水线和收银台。但2026年上半年国内大厂传出的裁员案例里,出现了一个更别扭的顺序:被裁掉的人当中,有不少是当初负责推动AI落地的中层管理者。有一则被反复转述的个案是,最先被优化的不是一线开发,而是提出“引入AI降本”方案的PMO负责人本人——他帮公司搭好了AI系统,随后发现自己的岗位没了。
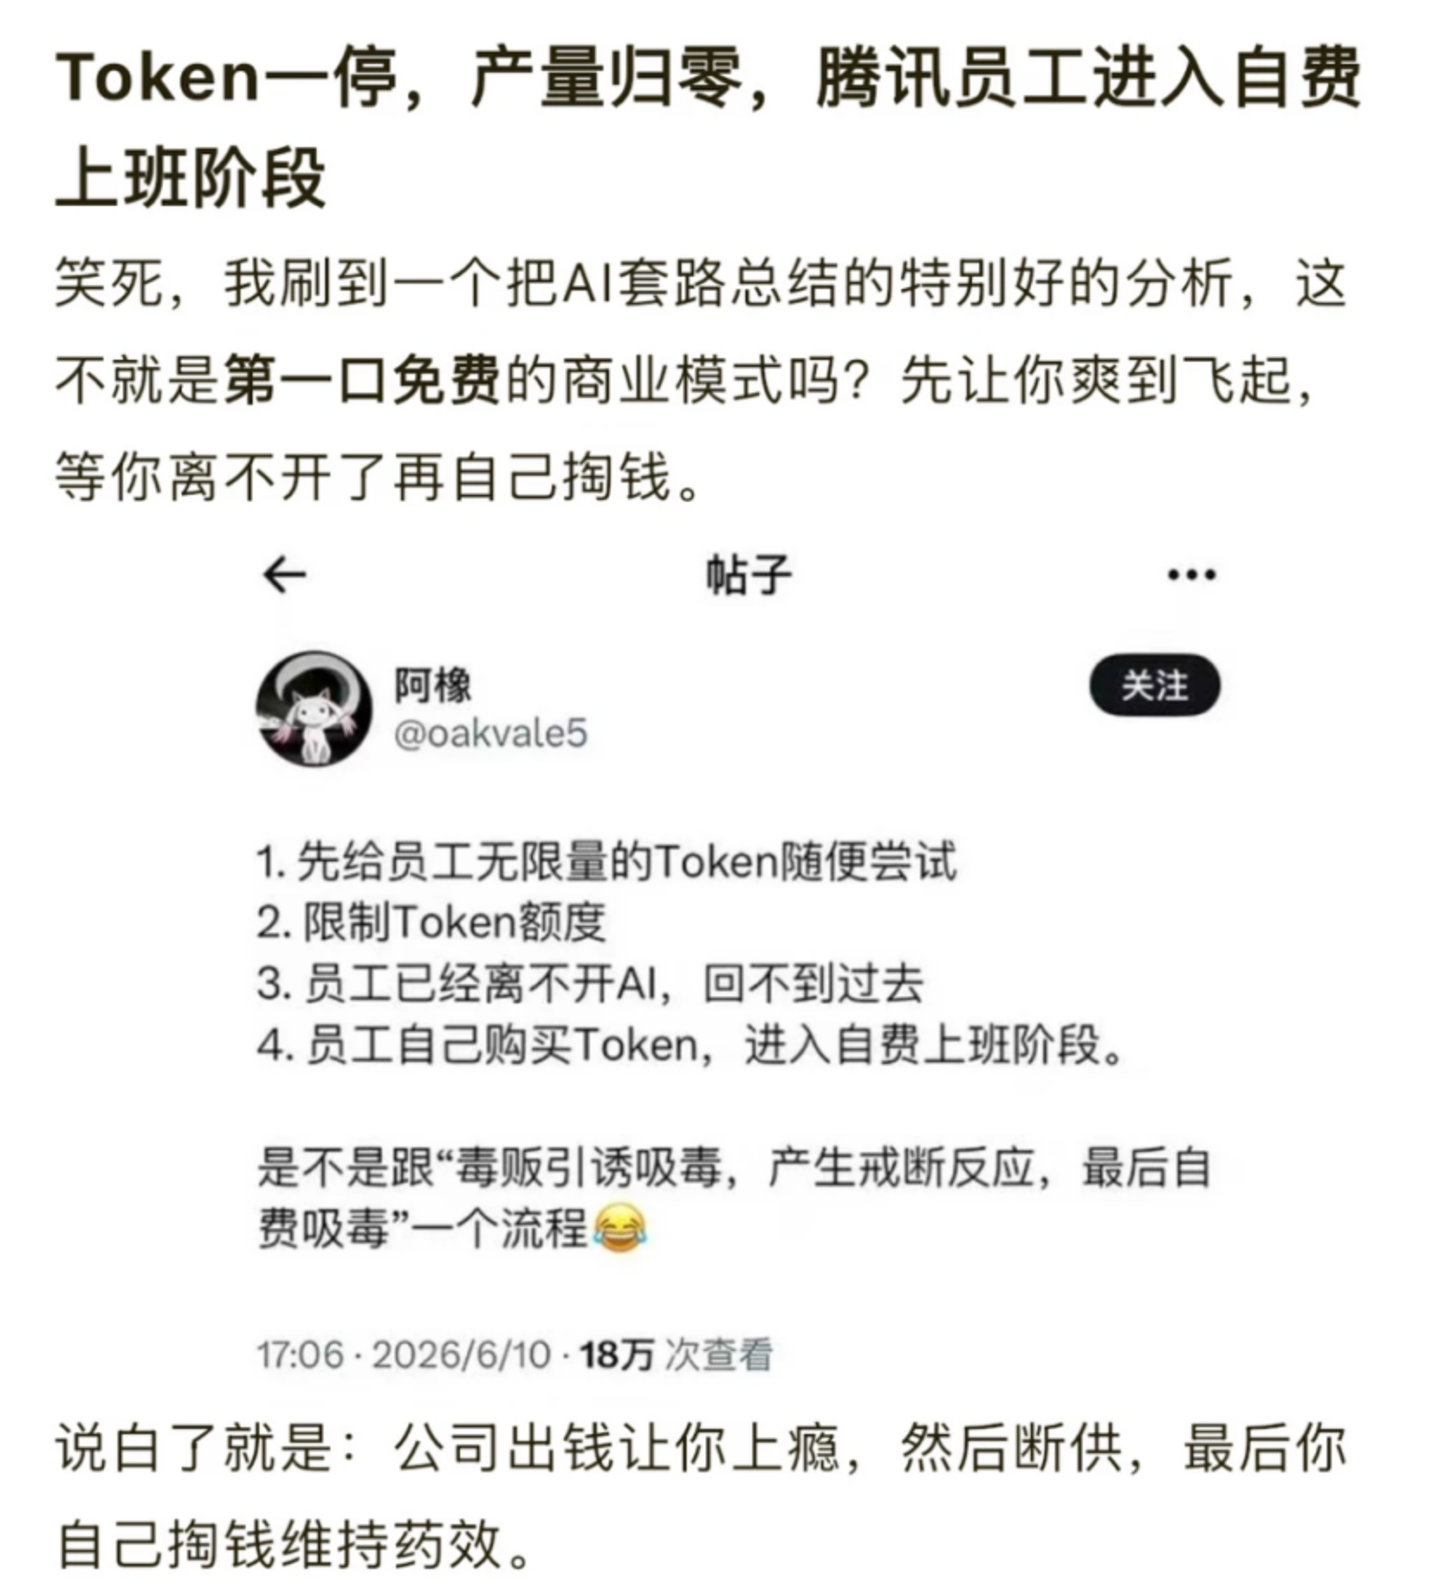 这类叙述来自个人观察,没有统计口径,也没有样本说明,因此不能当作行业数据使用。但它指向的方向,与“AI先替代蓝领”的直觉正好相反,值得追问原因。
中间层的任务长什么样
要解释这个顺序,得先看中间层每天在做什么。企业里的中间层,很大一部分工作并不是决策,也不是生产,而是信息中转:把上面的意图拆成任务,把下面的进展汇总成汇报,在部门之间对齐口径、催进度、写材料。这些动作有一个共同点——输入和输出都是文本与流程,规则相对稳定,判断空间有限。
这正是当前AI能力最成熟的区间。生成会议纪要、整理周报、起草方案初稿、在系统间搬运字段,这类任务可以被拆解、被标准化、被自动流转,替代成本低,验证效果也快。提出这一观察的作者把这类角色称为“胶水层”,认为2025到2026年间真正被大规模替代的,是那些本质上在做信息搬运、流程串联、报告撰写的岗位,而非一线工人。
一线操作中难以标准化的手感、现场应变,以及高层决策中需要承担责任的价值判断,暂时都不在这个区间内。替代顺序由任务结构决定,不由职级高低决定——中间层恰好站在两者之间,做的是最容易被写成流程说明书的那部分工作。
不过,仅凭个案顺序和一位作者的个人观察,还不足以说明企业到底在为什么样的任务付费、又为什么先对这部分付费动手。这需要看成本结构。
企业算的不是“替代谁”,是“哪些任务可以重组”
一个年轻工程师与98%的遗留代码
思科总裁兼首席产品官帕特尔的做法提供了一个极端样本:他指派一位27岁工程师,目标是在24个月内用AI重构或重写公司98%的遗留代码,并给这个人配了无上限的Token预算。这位工程师克里希那穆提2023年联合创办过实时翻译初创公司EzDubs,2025年思科收购EzDubs后他加入思科;帕特尔说他此前“被埋没在组织深处,做着无关大局的边缘事务”。
这个安排的重点不在“一个年轻人替代了多少人”,而在企业如何拆任务。遗留代码重构原本是典型的需要多人协作、层层评审、跨团队沟通的工作,现在被压缩成“一个人加模型批量生成、批量验证”的流水线。写代码被拆成可批量生成的任务单元,协调和转述的环节随之被抽掉。
需要克制地看这个案例。98%是既定目标,不是落地成果,报道没有披露当前的代码修改体量和试验成效。它说明的是企业愿意为什么样的任务结构下注,不能证明AI重写已经产生了实际降本结果。
降本账本里的真实科目
企业算AI这笔账时,科目不是“一个员工多少钱”,而是“一项任务拆到多细、由谁承接更便宜”。协调、汇总、转述、在系统间搬运信息,这类任务边界清晰、输入输出可定义,正好是模型擅长处理的部分。把它们剥离出去,剩下的工作重新分配给更少的人,账面人力成本就下来了。
 一个被广泛转引的匿名案例给出了这种账本的量级:AI的API调用费加上新增4人AI工程组,年增成本不到80万,净省320万。这个数字来自单一案例的估算,计算口径没有说明,不能当作行业平均值。但它指向的逻辑是清楚的——企业先为“可拆解的任务”付费,再对比重组前后的人力开支。
中间层之所以首当其冲,不是因为职级本身,而是因为这一层的任务可拆解性最高。拆完之后,企业未必减少总工作量,但一定减少了承接这些任务的岗位数量。这也是为什么“替代谁”是个容易问错的问题:企业做的动作是重组任务,岗位消失只是重组的结果之一。
然而,当AI本身开始产生账单,这套重组逻辑会反噬到推动重组的人身上。
AI的账单本身,也开始寄给中间层
从“随便用”到“按任务分配额度”
上一节算的是人力账:拆解任务、重组流程、减少承接岗位。这套账能成立,前提是AI这一侧的成本足够低,低到可以忽略不计。推广期的定价策略恰好制造了这种错觉——工具几乎免费,鼓励全员使用,甚至用排行榜统计哪个团队用得最多。
用量爬上去之后,账单也跟着爬上来。Uber的CTO公开承认,公司仅用4个月就花光了2026年全年的AI编程工具预算;而在预算爆掉之前,Uber还在办内部排行榜鼓励多用。这个案例来自自媒体转述,没有给出原始出处,数字不宜当作行业基准,但它呈现的曲线有代表性:先鼓励多用,再发现超支。微软的版本更直接——半年前给数千名员工开通Claude Code,用得太猛后大面积取消授权,把人赶回自家的GitHub Copilot。同样缺少官方确认,只能作为旁证。
成本量级可以参考一个更具体的说法。英伟达应用深度学习副总裁Bryan Catanzaro称,对他所在的团队来说,算力成本已经远高于员工工资成本。这句话只适用于他所述的团队,不能推广到英伟达整体,更不能代表全行业。但它点出了一个方向:当AI从辅助工具变成生产流程的一部分,算力开支可能不再是人力开支的零头,而是与之同一量级、甚至更高的科目。
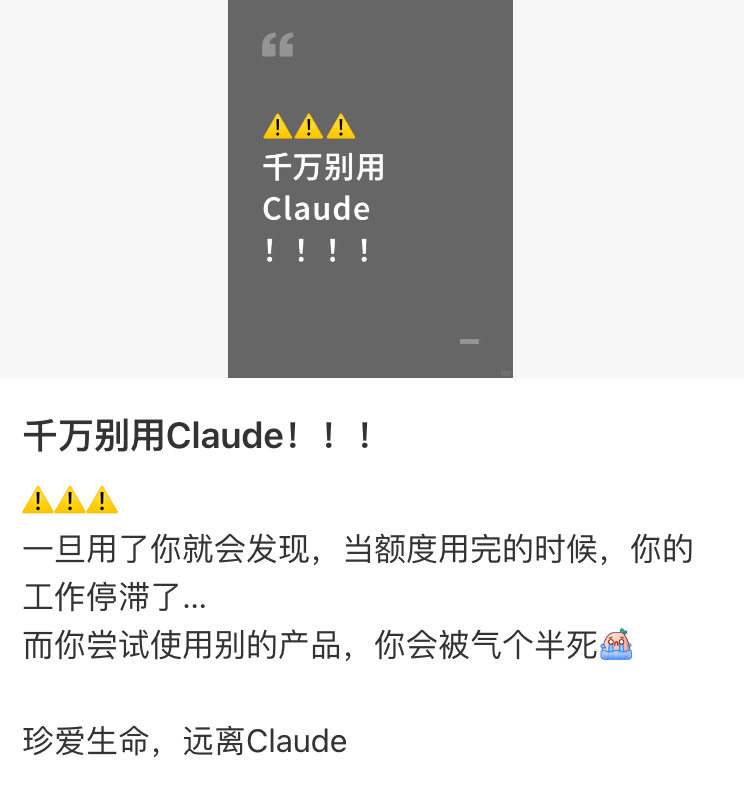 企业的反应随之从“鼓励多用”转向“按任务分配”。2026年6月起,网上流传腾讯把全员统一AI额度改为按任务动态分配;同一时期,微软、Meta等公司也被指开始监控、限制和动态调配员工用量。腾讯部分未获证实,大厂限制的说法也是文章概括,证据强度有限。能确认的是方向:额度从普惠制变成配给制,用量从自由使用变成被观测的指标。
谁最先感受到这种收紧?是那些日常工作中AI渗透率最高、调用最频繁的岗位——写报告、整理会议纪要、串联跨部门信息的人。中间层既是AI替代的对象,又是AI成本的主要制造者。替代逻辑要求减少这类岗位,成本逻辑又要求对仍在岗的人收紧工具权限。两头挤压落在同一批人身上。
省下来的钱去了哪里
一个自然的疑问是:AI降本省下的钱,为什么没有变成更宽裕的资源,反而变成了更严格的管控?
 部分原因在于,省下来的钱未必留在员工工具预算里。有评论指出,打工人自掏的几十上百元月费对大厂只是零头,真正能赚钱的是企业客户在调用量、部署、培训上的后续支出。这是作者观点,没有数据验证,但它提示了一个分配结构:AI供应商的营收重心在企业侧,企业的AI支出重心也在企业侧,个人层面的额度只是这个大盘子里被压缩的部分。
供给端的定价也在配合这种收紧。OpenAI的ChatGPT Pro月费200美元,价格不变而可用量缩水,同时新增500美元/月档位。这是单一产品的定价调整,不能直接推导企业采购成本,但它说明“用量增长、单价不变、实际可用量下降”是一种被采用的商业策略。企业面对的是同一类算术:预算固定,用量上涨,只能靠分配规则来控制。
于是出现一个不太直观的结果:AI越是被证明能干活,使用它的权限就越不像福利,越像需要审批的资源。中间层在这个循环里完成了第二次承压——第一次是任务被拆解,第二次是工具被限额。两次承压的机制不同,指向的却是同一层人。
这个判断有明确边界。它描述的是资源调配的方向,不是岗位净消失的结论;腾讯削减额度一事未经证实,Uber和微软的案例来自转述,Catanzaro的说法仅限其团队。证据能支撑的是“企业在用量失控后会收紧中间层的AI资源”这一机制,不能支撑“所有企业都在这么做”或“中间层必然被清空”。
成本侧的反噬说明,AI降本不是单向箭头。当工具本身变成需要算账的支出,企业会向使用最密集的地方收回资源。中间层恰好站在那个位置上。但这并不意味着中间层注定消失——哪些条件下这个判断不成立,需要单独看清楚。
 ## 这不是“中间层消失”,是任务定价权在转移
2100万岗位由任务重组而生
把“中间层消失”当作结论,会看漏一半事实。上海科技大学在2026年世界人工智能大会发布的报告称,自ChatGPT问世以来,约2100万个岗位由任务重组而生,占总招聘岗位的18.6%。这个数字不能读成岗位净增,报告统计的是招聘岗位的口径,也没交代新增与消失如何相抵。但它至少说明,企业拆掉旧任务的同时也在组装新任务,组装过程本身需要人。
 即刻App后端负责人夏俊晨的说法更直接:AI对其团队从纸面上看是“增本增效”,公司还在招更多人,并为每人配AI福利。这是十人创新团队的自述,不能外推到全行业,却足以打破“用了AI必然减人”的单向想象。降本增效是一句有条件的话——用对场景、控制用量、算清含隐形成本的总账,降本才成立。条件不满足时,AI先带来的是支出。
读者该盯住哪个变量
游戏行业的状况提供了一个中间态:使用AI早已普遍,人人手里养着一两个,但个人开销因岗位、用量和公司配备制度不同而差异很大。同一项技术,在不同岗位上被定价的方式并不一样。
所以真正该评估的不是“我这个岗位会不会被裁”,而是“我每天的工作里,有多少能被写成步骤、交给模型跑完”。比例高的部分正在被重新定价,比例低的部分——需要担责的判断、跨方的协调、模糊情境下的取舍——反而因为稀缺而升值。任务定价权转移时,恐慌和乐观都太粗,先数清自己手里的任务结构更实际。
账单寄到中间层,不是因为这一层没有价值,而是因为其价值形态最容易被拆开、逐项重新报价。